

DataHub med åbent kildekode: metadata søge- og opdagelsesplatform fra LinkedIn
Hurtig søgning efter de nødvendige data er essentiel for enhver virksomhed, der er afhængig af store mængder data til at træffe beslutninger baseret på disse data. Dette påvirker ikke kun produktiviteten for data-brugere (herunder analytikere, maskinlæringsudviklere, databehandlere og dataingeniører), men har også direkte indflydelse på de endelige produkter, der afhænger af et kvalitets maskinlæringspipeline (ML). Derudover rejser tendensen til at implementere eller opbygge maskinlæringsplatforme naturligvis spørgsmålet: hvad er din metode til intern opdagelse af funktioner, modeller, metrikker, datasæt osv.
I denne artikel vil vi fortælle om, hvordan vi offentliggjorde datakilden under en åben licens på vores platform for søgning og opdagelse af metadata, som vi har gjort siden de tidlige dage af projektet . LinkedIn understøtter sin egen version af DataHub separat fra den open source-version. Vi vil starte med at forklare, hvorfor vi har brug for to separate udviklingsmiljøer, hvorefter vi vil diskutere de første tilgange til at bruge WhereHows med open source og sammenligne vores interne (produktions) version af DataHub med versionen på . Vi vil også dele detaljer om vores nye automatiserede løsning til at sende og modtage opdateringer fra open source for at synkronisere begge repositoryer. Endelig vil vi give instrukser om, hvordan man kommer i gang med at bruge DataHub med open source, og kort diskutere dets arkitektur.
WhereHows er nu DataHub!
LinkedIns metadata-team præsenterede tidligere (efterfølgeren til WhereHows), LinkedIns platform for søgning og opdagelse af metadata, og delte planer om at åbne den. Kort efter denne meddelelse udgav vi alfa-versionen af DataHub og delte den med samfundet. Siden da har vi konstant bidraget til repositoryet og arbejdet med interesserede brugere for at tilføje de mest efterspurgte funktioner og løsne problemer. Nu er vi glade for at kunne annoncere den officielle udgivelse .
Åbne kilde tilgange
WhereHows, det oprindelige LinkedIn-portal til datadetektering og -oprindelse, blev åbnet som et internt projekt; metadata-teamet åbnede det . Siden da har teamet altid understøttet to forskellige kodebaser - en til open source og en til intern brug hos LinkedIn, da ikke alle produktfunktioner udviklet til LinkedIn's brugervenlighed generelt var anvendelige for en bredere offentlighed. Desuden har WhereHows nogle interne afhængigheder (infrastruktur, biblioteker osv.), hvis kildekode ikke er offentlig. I de efterfølgende år har WhereHows gennemgået mange iterationer og udviklingscykler, hvilket har gjort synkroniseringen af de to kodebaser til en stor udfordring. Metadata-teamet har i løbet af årene forsøgt at anvende forskellige tilgange for at synkronisere intern udvikling og open source-udvikling.
Første forsøg: "Først open source"
Oprindeligt fulgte vi en "først open source" udviklingsmodel, hvor den primære udvikling fandt sted i et open source-repositorium, og ændringer blev lavet til intern udrulning. Problemet med denne tilgang er, at koden altid først sendes til GitHub, før den er fuldt godkendt internt. Indtil der er lavet ændringer fra open source-repositoriet og en ny intern udrulning er gennemført, opdager vi ingen produktionsproblemer. I tilfælde af en dårlig udrulning var det også meget vanskeligt at bestemme synderen, da ændringerne blev lavet i partier.
Desuden reducerede denne model teamets produktivitet ved udviklingen af nye funktioner, som krævede hurtige iterationer, da den fik os til at placere alle ændringer i open source-repositoriet først, og derefter overføre dem til det interne repositorium. For at forkorte den nødvendige behandlingstid kunne nødvendige rettelser eller ændringer først laves i det interne repositorium, men det blev et kæmpe problem, når det kom til at fusionere disse ændringer tilbage i open source-repositoriet, da de to repositories var ude af synk.
Denne model er meget lettere at implementere til fælles platforme, biblioteker eller infrastrukturelle projekter end til fuldfunktionelle brugerwebapplikationer. Desuden er denne model ideel til projekter, der starter med open source fra dag ét, men WhereHows blev udviklet som en helt intern webapplikation. Det var virkelig svært at abstrahere fuldstændigt fra alle interne afhængigheder, så vi var nødt til at bevare den interne gaffel, men det at bevare den interne gaffel og lave primært med open source fungerede ikke helt.
Andet forsøg: "Først internt"
** Som andet forsøg gik vi over til en "først internt" udviklingsmodel, hvor den primære udvikling foregår internt i virksomheden, og ændringerne regelmæssigt integreres i open source. Selvom denne model passer bedst til vores brugssituation, har den sine problemer. At sende alle forskelle direkte til open source-repositoriet og derefter forsøge at løse sammenfletningskonflikter senere er en mulighed, men det tager meget tid. Udviklere forsøger i de fleste tilfælde at undgå dette ved hver kodegennemgang. Som et resultat vil dette ske meget sjældnere, i partier, og derved vanskeliggøre efterfølgende løsning af sammenfletningskonflikter.
Tredje gang lykkedes det!
De to nævnte mislykkede forsøg førte til, at WhereHows GitHub-repositoriet forblev forældet i lang tid. Teamet fortsatte med at forbedre funktioner og arkitektur i produktet, så den interne version af WhereHows til LinkedIn blev mere og mere avanceret end den open source-version. Den fik endda et nyt navn — DataHub. Baseret på de tidligere mislykkede forsøg besluttede teamet at udvikle en skalerbar langsigtet løsning.
For ethvert nyt open source-projekt rådgiver og støtter LinkedIn open source-udviklerteamet en udviklingsmodel, hvor projektmodulerne helt udvikles med open source. Versionsunderstøttede artefakter implementeres i et offentligt repository og returneres derefter til LinkedIn's interne artefakt ved hjælp af At følge denne udviklingsmodel er ikke kun gavnligt for dem, der bruger open source, men fører også til udviklingen af en mere modulær, udvidelig og tilslutningsvenlig arkitektur.
Men for at opnå denne tilstand for en moden intern applikation som DataHub vil det kræve betydelig tid. Dette udelukker også muligheden for en fuldt fungerende open source-implementering, før alle interne afhængigheder er fuldt abstraheret. Derfor har vi udviklet værktøjer, der hjælper os med at bidrage til open source hurtigere og langt mindre smertefuldt. Denne løsning er til gavn for både metadata-teamet (udvikler af DataHub) og open source-samfundet. I de følgende afsnit vil denne nye tilgang blive diskuteret.
Automatisering af open source-publicering
Den seneste tilgang fra metadata-teamet til DataHub med open source indebærer udviklingen af et værktøj, der automatisk synkroniserer den interne kodebase og det open source-repository. Højniveaufunktionerne i dette værktøj inkluderer:
- Synkronisering af LinkedIns kode med / fra open source, tilsvarende .
- Generering af licenstoftes, tilsvarende .
- Automatisk oprettelse af logs over commits i open source fra interne commit-logs.
- Forebyggelse af interne ændringer, der bryder byggeriet med open source, ved .
I de følgende underafsnit vil de ovennævnte funktioner blive udforsket mere detaljeret med interessante udfordringer.
Synkronisering af kildekode
I modsætning til den open source-version af DataHub, som er et enkelt GitHub-repository, er DataHub-versionen for LinkedIn en kombination af flere repositories (intern kendt som ). DataHub-grænsefladen, metadata-modelbiblioteket, den bagvedliggende metadata-lagringstjeneste og stream-arbejdsopgaverne ligger i forskellige repositories i LinkedIn. For at lette arbejdet for brugerne med open source har vi dog et enkelt repository til den open source-version af DataHub.
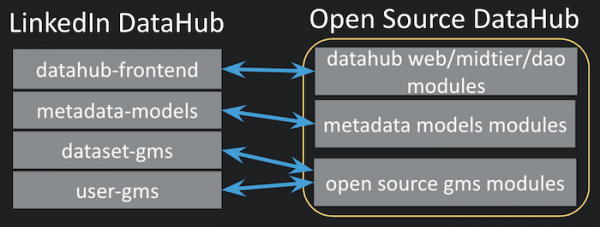
Figur 1: Synkronisering mellem repositories LinkedIn DataHub og det enkle repository DataHub med open source
For supporting automated assembly, dispatch, and extraction workflows, our new tool automatically creates file-level mappings corresponding to each source file. However, the toolkit requires initial configuration, and users must provide a high-level mapping of modules as shown below.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
Module-level mapping is a simple JSON, where the keys are the target modules in the open-source repository, and the values are a list of source modules in LinkedIn repositories. Any target module in the open-source repository can take input from any number of source modules. To denote internal repository names in source modules, in Bash style. By using the module-level mapping file, the tools create file-level mappings by scanning all files in the associated directories.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
File-level mappings are automatically created by the tools; however, they can also be manually updated by the user. This mapping is a 1:1 link of the LinkedIn source file to the file in the open-source repository. There are a few rules associated with this automatic file mapping creation:
- In the case of multiple source modules for a target module in the open source, conflicts may arise, such as the same , existing in more than one source module. As a conflict resolution strategy, our tools default to a 'last wins' option.
- "null" indicates that the source file is not part of the open-source repository.
- Efter hver forhåndsvisning af kildekoden eller udtræk fra den bliver denne mapping automatisk opdateret og skaber et øjebliksbillede. Dette er nødvendigt for at bestemme tilføjelser og fjernelser i kildekoden siden den sidste handling.
Oprettelse af commitlogfiler
Commitlogs for commits med åbent kildekode oprettes også automatisk ved at kombinere commitlogfilerne fra interne repository. Nedenfor er et eksempel på en commitlog for at vise strukturen af commitloggen, der er oprettet af vores værktøj. Committen angiver tydeligt, hvilke versioner af kilde-repositoryder er pakket ind i denne commit, og giver en opsummering af commitloggen. Tjek denne på et reelt eksempel på en commitlog, der er oprettet af vores værktøj.
metadata-models 29.0.0 -> 30.0.0
    Tilføjet aspektmodel foo
    Rettet problem bar

dataset-gms 2.3.0 -> 2.3.4
    Tilføjet rest.li API til at servere foo aspekt

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Test af afhængigheder
LinkedIn har , som hjælper med at sikre, at ændringer i det interne multiprodukt ikke ødelægger bygningen af de afhængige multiprodukter. DataHub-repositoryet med åben kildekode er ikke multiprodukt og kan ikke være en direkte afhængighed af et multiprodukt, men ved hjælp af en multiprodukt-omslag, der udtrækker kildekoden fra DataHub med åben kildekode, kan vi stadig bruge dette testafhængighedssystem. Således udløser enhver ændring (som eventuelt vil blive åbnet senere) i et af multiprodukterne, der fodrer DataHub repositoryet med åben kildekode, en byggebegivenhed i multiproduktomslaget. Derfor bliver enhver ændring, der ikke tillader bygningen af multiproduktomslaget, ikke bestået tests før committet af det interne multiprodukt og returneres.
Dette er en nyttig mekanisme, der hjælper med at forhindre et hvilket som helst internt commit, der ødelægger bygningen med den åbne kildekode, og opdager det under commit-processen. Uden dette ville det være ret vanskeligt at bestemme, hvilket internt commit der førte til fejlen i bygningen af repositoryet med åben kildekode, fordi vi placerer interne ændringer i batchen i DataHub repositoryet med åben kildekode.
Forskellene mellem DataHub med åbent kildekode og vores produktionsversion
Indtil nu har vi diskuteret vores løsning til at synkronisere de to versioner af DataHub-repositorier, men vi har endnu ikke angivet årsagerne til, at vi overhovedet har brug for to forskellige udviklingsstrømme. I dette afsnit vil vi liste forskellene mellem den offentligt tilgængelige version af DataHub og produktionsversionen på LinkedIn-serverne og forklare årsagerne til disse forskelle.
En af kilderne til uoverensstemmelser stammer fra det faktum, at vores produktionsversion har afhængigheder af kode, der ikke er åbent kildet, såsom LinkedIn’s Offspring (den interne struktur for afhængighedsintegration hos LinkedIn). Offspring bruges bredt i den interne kodebase, da det er den foretrukne metode til at håndtere dynamisk konfiguration. Men dette er ikke åbent kildet; derfor har vi været nødt til at finde alternativer med åbent kildet til DataHub med åbent kildekode.
Der er også andre årsager. Efterhånden som vi opretter udvidelser af metadata-modellen til LinkedIns behov, er disse udvidelser typisk meget specifikke for LinkedIn og kan ikke anvendes direkte i andre miljøer. For eksempel har vi meget specifikke etiketter til deltager-ID'er og andre typer metadata-tilpasning. Derfor har vi i øjeblikket udelukket disse udvidelser fra metadata-modellen for DataHub med åbent kildekode. Efterhånden som vi interagerer med fællesskabet og forstår deres behov, vil vi arbejde på fælles versioner af disse udvidelser med åbent kildekode, hvor det er nødvendigt.
Brugervenlighed og lettere tilpasning til fællesskabet med åbent kildekode har også inspireret nogle forskelle mellem de to versioner af DataHub. Forskelle i infrastrukturen for streamingbehandling er et godt eksempel på dette. Selvom vores interne version bruger infrastruktur til styret streamingbehandling, har vi valgt at bruge indbygget (standalone) streamingbehandling til versionen med åbent kildekode, da det gør det muligt at undgå at oprette endnu en infrastrukturafhængighed.
Et andet eksempel på forskellen er tilstedeværelsen af en enkelt GMS (Generelt Metadatastore) i implementeringen med åben kildekode, snarere end flere GMS'er. GMA (Generel Metadataarkitektur) er navnet på den interne arkitektur for DataHub, mens GMS er metadatabutikken i konteksten af GMA. GMA er en meget fleksibel arkitektur, der giver dig mulighed for at distribuere hver datakonstruktion (f.eks. datasæt, brugere osv.) til sin egen metadatastore, eller opbevare flere datakonstruktioner i én metadatastore, så længe registret, der indeholder kortlægningen af datakonstruktionen i GMS, opdateres. For at gøre det nemmere at bruge valgte vi en enkelt GMS-instans, der gemmer alle de forskellige datakonstruktioner i DataHub med åben kildekode.
Den komplette liste over forskelle mellem de to implementeringer findes i tabellen nedenfor.
Produktfunktioner
LinkedIn DataHub
Open Source DataHub
Understøttede datakonstruktioner
1) Datasæt 2) Brugere 3) Metrics 4) ML-funktioner 5) Diagrammer 6) Dashboards
1) Datasæt 2) Brugere
Understøttede metadatakilder for datasæt
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Streambehandling
Managed
Indlejret (standalone)
Dependency Injection & Dynamisk konfiguration
LinkedIn Offspring
Byggeværktøjer
Ligradle (LinkedIn's interne Gradle-wrapper)
CI/CD
CRT (LinkedIn's interne CI/CD)
og
Metadatabutikker
Fordelt flere GMS'er: 1) Datasæt GMS 2) Bruger GMS 3) Metric GMS 4) Feature GMS 5) Diagram/Dashboard GMS
Enkel GMS for: 1) Datasæt 2) Brugere
Mikrotjenester i Docker-containere
fremmer implementeringen og distributionen af applikationer ved hjælp af Hver del af tjenesten i DataHub med åben kildekode, inklusive infrastrukturelementer som Kafka, , og , har sit eget Docker-billede. Til orkestrering af Docker-containere har vi brugt .
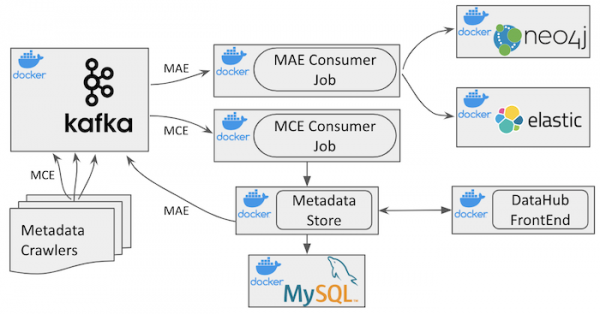
Figur 2: Arkitektur DataHub *med åben kildekode**
Du kan se den overordnede arkitektur af DataHub på billedet ovenfor. Udover infrastrukturkomponenter har den fire forskellige Docker-containere:
datahub-gms: metadataopbevaringstjeneste
datahub-frontend: applikation , der betjener DataHub-grænsefladen.
datahub-mce-consumer: applikation , der bruger streamen af metadatændringsbegivenheder (MCE) og opdaterer metadatabutikken.
datahub-mae-consumer: applikation , der bruger streamen af metadata revisionsbegivenheder (MAE) og opretter en søgeindekseringsdatabase og graf.
Dokumentation til det åbne kildekode-repository og indeholder mere detaljerede oplysninger om funktionerne i forskellige tjenester.
CI / CD i DataHub med åbent kildekode
DataHub's åbne kildekode-repository bruger til kontinuerlig integration og til kontinuerlig implementering. Begge har god integration med GitHub og er lette at konfigurere. For det meste af den åbne kildekode infrastruktur, der er udviklet af fællesskabet eller private virksomheder (f.eks., ), er der skabt Docker-billeder, som er implementeret i Docker Hub for at lette brugen af fællesskabet. Ethvert Docker-billede, der findes i Docker Hub, kan let anvendes med en simpel kommando .
Ved hver commit i DataHub's åbne kildekode-repository bliver alle Docker-billeder automatisk oprettet og implementeret i Docker Hub med tagget "latest". Hvis der er konfigureret nogle , bliver alle tags i det åbne kildekode-repository også udgivet med de tilsvarende tag-navne i Docker Hub.
Brug af DataHub
er meget enkel og består af tre enkle trin:
- Klon det åbne kildekode-repository og kør alle Docker-containere ved hjælp af docker-compose med det medfølgende docker-compose-script for hurtig opstart.
- Download de eksempler på data, der findes i repository'et, ved hjælp af kommandolinjeværktøjet, som også leveres.
- Se DataHub i din browser.
Aktivt overvåget er også opsat til hurtige spørgsmål. Brugere kan også oprette problemer direkte i GitHub-repository'et. Det vigtigste er, at vi byder alle feedback og forslag velkommen og værdsætter dem!
Fremtidige planer
I øjeblikket er hver infrastruktur eller mikrotjeneste for DataHub med åbent kildekode bygget som en Docker-container, og hele systemet orkestreres med . Givet populariteten og den udbredte anvendelse , ønsker vi også at tilbyde en Kubernetes-baseret løsning i den nærmeste fremtid.
Vi planlægger også at tilbyde en klar løsning til implementering af DataHub i en offentlig cloud-tjeneste som , eller . I lyset af den nylige meddelelse om LinkedIns migration til Azure, vil dette matche de interne prioriteter i metadata-gruppen.
Og til sidst, men ikke mindst: tak til alle de første brugere af DataHub i open source-fællesskabet, som har værdsat DataHub's alpha-versioner og hjulpet os med at identificere problemer og forbedre dokumentationen.
Kilde: habr.com
