

Ved kompleks behandling af store datasæt (forskellige : importer, konverteringer og synkronisering med eksterne kilder) opstår der ofte behov for at midlertidigt "huske", og hurtigt behandle noget voluminøst.
En typisk opgave af denne art lyder som regel nogenlunde sådan her: "Her har de senest modtagne betalinger, de skal hurtigt overføres til hjemmesiden og knyttes til regnskaberne"
Men når volumen af dette "noget" begynder at måles i hundrede megabyte, og tjenesten samtidig skal fortsætte med at arbejde med databasen 24×7, opstår der mange bivirkninger, der vil forstyrre dig.
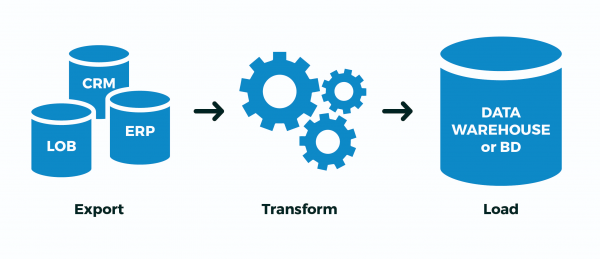
For at håndtere dem i PostgreSQL (og ikke kun der) kan man anvende nogle optimeringsmuligheder, som muliggør hurtigere behandling med færre ressourceforbrug.
1. Hvor skal vi lægge det?
Lad os først bestemme, hvor vi kan indlæse de data, vi ønsker at "behandle".
1.1. Midlertidige tabeller (TEMPORARY TABLE)
I princippet er midlertidige tabeller i PostgreSQL de samme som alle andre tabeller. Derfor er overtroen om, "der gemmes kun i hukommelsen, og den kan løbe tør"forkert. Men der er også nogle væsentlige forskelle.
En "navnerum" for hver forbindelse til DB
Hvis to forbindelser forsøger at udføre CREATE TABLE x, vil nogen uundgåeligt få fejl på grund af ikke-unikhed af DB-objekter.
Men hvis begge forsøger at udføre CREATE MIDLTID TABEL x, så vil begge gøre det uden problemer, og hver vil få sin egen instans af tabellen. Og der vil ikke være noget fælles mellem dem.
"Selvdestruktion" ved frakobling
Ved lukning af forbindelsen slettes alle midlertidige tabeller automatisk, så der er ingen mening i at udføre DROP TABLE x udover…
Hvis du arbejder via pgbouncer i transaktionsmode, så tror databasen stadig, at denne forbindelse stadig er aktiv, og at denne midlertidige tabel stadig eksisterer i den.
Derfor vil et forsøg på at oprette den igen, allerede fra en anden forbindelse til pgbouncer, føre til en fejl. Men dette kan omgås ved at bruge OPRET MIDLERTIDIG TABEL HVIS IKKE DER FINDES x.
Men det er bedst ikke at gøre det, fordi man så pludselig kan opdage data tilbage fra "den tidligere ejer". I stedet er det meget bedre at læse manualen nøje og se, at der ved oprettelse af tabellen er mulighed for at tilføje PÅ COMMIT DROP — det vil sige, at når transaktionen er færdig, vil tabellen automatisk blive slettet.
Ikke-replikation
På grund af tilknytning kun til en bestemt forbindelse, replikeres midlertidige tabeller ikke. Til gengæld fjerner dette behovet for dobbelt dataregistrering i heap + WAL, så INSERT/UPDATE/DELETE i den er betydeligt hurtigere.
Men da en midlertidig tabel stadig er en "næsten almindelig" tabel, kan den heller ikke oprettes på replika. I det mindste ikke endnu, selvom en passende patch har været tilgængelig i lang tid.
1.2. Uregistrerede tabeller (UNLOGGED TABLE)
Men hvad gør man, hvis man har en tung ETL-proces, som ikke kan implementeres i en enkelt transaktion, og man har stadig pgbouncer i transaktionsmode?..
Eller hvis datastreamen er så stor, at kapaciteten af én forbindelse til DB (læs: én proces på CPU) ikke er tilstrækkelig? ..
Eller hvis nogle operationer foregår asynkront i forskellige forbindelser? ..
Her er der kun én mulighed — tilfældig oprettelse af en ikke-midlertidig tabel. Spøg, ikke? Det vil sige:
- oprettede "mine" tabeller med maksimalt tilfældige navne, så jeg ikke krydser med nogen
- Udvind: indlæste data i dem fra en ekstern kilde
- Transformere: omformede, udfyldte nøgleforbindelsesfelter
- Belastning: overførte de færdige data til mål tabeller
- slettede "mine" tabeller
Men nu — en teskefuld bitterhed. I princippet er hele registreringen i PostgreSQL faktisk to gange — , derefter i tabeller/indeksens krop. Alt dette er gjort for at understøtte ACID og korrekt synlighed af data mellem COMMIT'indviklede og ROLLBACK'indviklede transaktioner.
Men vi har ikke brug for det! Hele vores proces er enten fuldført med succes, eller også ikke.. Det er ligegyldigt, hvor mange mellemtransaktioner der vil være — vi er ikke interesserede i at "fortsætte processen fra midten", især når det er uklart, hvor den var.
Til dette formål introducerede PostgreSQL-udviklerne allerede i version 9.1 sådan en funktion som :
Med denne indikation oprettes tabellen som uregistreret. Data, der skrives til uregistrerede tabeller, går ikke gennem pre-write-journalen (se Kap. 29), hvilket resulterer i, at sådanne tabeller arbejder meget hurtigere end almindelige.Men de er ikke beskyttet mod fejl; ved fejl eller nødafbrydelse af serveren bliver den uregistrerede tabel automatisk beskåret.Desuden replikeres indholdet af den uregistrerede tabel ikke. til styrede servere. Enhver indeks, der oprettes for en ikke-journaleret tabel, bliver automatisk ikke-journaleret.
Kort sagt, vil det være meget hurtigere, men hvis databaseserveren "går ned" — vil det være ubehageligt. Men hvor ofte sker det, og kan din ETL-proces korrekt bearbejde det "fra midten", efter "genoplivning" af databasen?..
Hvis ikke, og dit tilfælde ligner det ovenstående — brug UNLOGGED, men aldrig aktiver denne egenskab på rigtige tabeller, hvis dataene er vigtige for dig.
1.3. ON COMMIT { DELETE ROWS | DROP }
Denne konstruktion giver mulighed for, at der kan angives automatisk opførsel ved afslutningen af en transaktion ved oprettelse af en tabel.
Om PÅ COMMIT DROP jeg har allerede skrevet ovenfor, den genererer DROP TABLE, men her med PÅ COMMIT SLET RADER situationen er mere interessant — her genereres TRUNCATE TABLE.
Da hele infrastrukturen til opbevaring af metabeskrivelserne for den midlertidige tabel er præcis den samme som for en normal, fører konstant oprettelse og sletning af midlertidige tabeller til kraftig "oppustning" af systemtabellerne pg_class, pg_attribute, pg_attrdef, pg_depend,…
Forestil dig nu, at du har en worker med en direkte forbindelse til databasen, der hver sekund åbner en ny transaktion, opretter, fylder, behandler og sletter en midlertidig tabel… Der vil hobe sig affald op i systemtabellerne, hvilket medfører unødvendige forsinkelser ved hver operation.
Generelt, lad være med det! I dette tilfælde er det langt mere effektivt at placere CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS uden for transaktionscyklussen — så vil tabellerne allerede være eksisteret ved starten af hver ny transaktion (vi sparer et kald CREATE), men vil være tom, takket være TRUNCATE (vi har også sparet dette kald) ved afslutningen af den tidligere transaktion.
1.4. LIKE… INCLUDING …
Jeg nævnte indledningsvis, at en af de typiske anvendelser for midlertidige tabeller er forskellige former for importer — og udvikleren kopierer træt listen over felterne fra den målrettede tabel til sin midlertidige erklæring…
Men dovenskab er fremdriftens driver! Derfor kan man oprette en ny tabel "efter skabelon" meget lettere:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Da der kan genereres mange data i denne tabel, vil søgning i den ikke være hurtig. Men der er en traditionel løsning mod dette — indekser! Og ja, kan midlertidige tabeller også have indekser.
Da de nødvendige indekser ofte er identiske med indekserne fra den målrettede tabel, kan man blot skrive LIKE mål_tabel INDBEFATTER INDICES.
Hvis du også har brug for DEFAULT-værdier (for eksempel til udfyldelse af primærnøgleværdier), kan du benytte LIKE mål_tabel INDEHOLDENDE STANDARDINDSTILLINGER. Eller bare — LIKE mål_tabel INDSLUTTEN ALT — kopierer standarder, indekser, begrænsninger,…
Men her skal man forstå, at hvis du har oprettet import-tabellen med indeks fra starten, så vil indtastningen være langsommere, end hvis du først indlæser alt og derefter tilføjer indekserne — se hvordan det gør .
Generelt, !
2. Hvordan skriver man?
Jeg vil sige det klart — brug -strøm i stedet for "bunker" INSERT, . Du kan endda gøre det direkte fra en foruddefineret fil.
3. Hvordan behandler man?
Lad os sige, at vores input ser nogenlunde således ud:
- du har en tabel med klientdata i databasen 1M poster
- hver dag sender kunden dig en ny fuld "billede"
- efter erfaring ved du, at der fra gang til gang ændres ikke mere end 10K poster
Et klassisk eksempel på en sådan situation er — der er mange adresser i alt, men i hver ugentlig eksport med ændringer (ændringer af bynavne, sammenslåinger af gader, optrædener af nye bygninger) er der ganske få selv på landsplan.
3.1. Algoritme for fuld synkronisering
For enkelhedens skyld antag, at du ikke engang behøver at restrukturere data — bare bring tabellen i den ønskede form, det vil sige:
- at slette alt, hvad der allerede ikke er
- Muligheder for processorerne «Elbrus» er tilgængelige efter alt, hvad der allerede har været, og som skal opdateres
- indsætte alt, hvad der endnu ikke har været
Hvorfor skal man gøre operationer i denne rækkefølge? Fordi det på denne måde vil minimere størrelsen af tabellen ().
DELETE FROM dst
Nej, selvfølgelig kan man klare sig med kun to operationer:
- at slette (
DELETE) faktisk alt - indsætte alt fra det nye billede
Men takket være MVCC, vil størrelsen af tabellen stige præcist til det dobbelte! At få +1M billeder af poster i tabellen på grund af at opdatere 10K — ikke særlig god overflødighed…
TRUNCATE dst
En mere erfaren udvikler ved, at man ret billigt kan rense hele tabellen:
- ryd (
TRUNCATE) hele tabellen - indsætte alt fra det nye billede
En effektiv metode, , men der er en udfordring… At indlæse 1M poster vil tage lang tid, så vi kan ikke tillade os at lade tabellen være tom i denne periode (som vil ske uden at indgå i en samlet transaktion).
Det betyder:
- vi starter en langvarig transaktion
TRUNCATEpåvirker AccessExclusive-låser- vi bruger lang tid på at indsætte, og alle andre kan ikke engang Noget her er ikke godt…
SELECT
ALTER TABLE… RENAME… / DROP TABLE …
ALTER TABLE… RENAME… / DROP TABLE …
En mulighed er at uploade alt til en ny separat tabel og derefter blot omdøbe den til den gamle. Der er et par irriterende småting:
- det samme AccessExclusive, selvom det tager betydeligt mindre tid
- alle forespørgselsplaner/statistik for denne tabel nulstilles,
- alle fremmednøgler brydes (FK) på tabellen
Der var en WIP-patch fra Simon Riggs, der foreslog at lave ALTER-en operation for at erstatte tabelens krop på filniveau uden at røre statistikken og FK, men der blev ikke samlet quorum.
DELETE, UPDATE, INSERT
Så vi stopper ved en ikke-blokerende mulighed bestående af tre operationer. Næsten tre... Hvordan kan vi gøre dette mest effektivt?
-- vi gør alt inden for en transaktion, så ingen ser de "intermittente" tilstande
BEGIN;

-- opretter en midlertidig tabel med de importerede data
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- som skabelon, inklusive indekser
) ON COMMIT DROP; -- vi har ikke brug for den uden for transaktionen

-- hurtigt indsætter vi det nye billede via COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- sletter de manglende
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- felterne for primærnøgle
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "anti join"

-- opdaterer de resterende
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- der er ingen grund til at opdatere matchende

-- indsætter de manglende
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Postbehandling af import
I den samme KLADe skal alle ændrede poster desuden gennemgå postbehandling — normalisere, udtrække søgeord, bringe dem til de ønskede strukturer. Men hvordan ved man — hvad præcist der blev ændret, uden at komplicere synkroniseringskoden, ideelt set uden at røre ved den overhovedet?
Hvis skriveadgangen under synkroniseringen kun er tilgængelig for din proces, kan man anvende en trigger, der indsamler alle ændringer for os:
-- mål tabeller
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabeller med ændringshistorik
CREATE TABLE kladr$log(
  ro kladr, -- her ligger hele billeder af gamle/ny registreringer
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- generel funktion til logføring af ændringer
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- tjekker nødvendigheden af logging ved opdatering af registrering
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- opretter en logpost
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Nu kan vi, før synkroniseringen, anvende (eller aktivere via ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Og derefter kan vi roligt hente de nødvendige ændringer fra log-tabellerne og viderebehandle dem.
3.3. Import af relaterede datasæt
Ovenfor har vi set tilfælde, hvor datakstruktur i kilden og modtageren stemmer overens. Men hvad gør vi, hvis eksporten fra et eksternt system har et format, der adskiller sig fra strukturen i vores database?
Lad os tage opbevaring af kunder og deres fakturaer som eksempel, et klassisk eksempel på "mange-til-en":
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Og her kommer eksporten fra den eksterne kilde som en "alt-i-én":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Det er åbenlyst, at kundedata kan duplikere i denne variant, og hovedposten er "fakturaen":
0123456789;Vasya;A-01;2020-03-16;1000.00
9876543210;Petya;A-02;2020-03-16;666.00
0123456789;Vasya;B-03;2020-03-16;9999.00
For modellen vil vi blot indsætte vores testdata, men husk — COPY mere effektivt!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasya', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petya', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasya', 'B-03', '2020-03-16', 9999.00);
Først udpeger vi de "skiver", som vores "fakta" henviser til. I vores tilfælde henviser fakturaer til kunder:
OPRET EN MIDLERTIDIG TABEL client_import AS
VÆLG DISTINKTE PÅ(client_inn)
-- man kan blot VÆLG DISTINKT, hvis dataene er åbenlyst konsistente
  client_inn inn
, client_name "name"
FRA
  invoice_import;
For korrekt at knytte regninger til kunde-IDs, skal vi først finde eller generere disse identifikatorer. Vi tilføjer felter til dem:
ALTER TABLE invoice_import TILFØJ KOLONNE client_id integer;
ALTER TABLE client_import TILFØJ KOLONNE client_id integer;
Vi vil bruge den ovenfor beskrevne metode til synkronisering af tabellerne med en lille tilpasning — vi opdaterer og sletter ikke noget i måltabellen, da importen af kunder er "append-only":
-- sætter ID'er for allerede eksisterende poster i importtabel
OPDATER
  client_import T
SET
  client_id = D.client_id
FRA
  client D
HVOR
  T.inn = D.inn; -- unik nøgle

-- indsætter manglende poster og sætter deres ID'er
MED ins AS (
  INDSÆT I client(
    inn
  , name
  )
  VÆLG
    inn
  , name
  FRA
    client_import
  HVOR
    client_id ER NULL -- hvis ID ikke blev sat
  RETURNING *
)
OPDATER
  client_import T
SET
  client_id = D.client_id
FRA
  ins D
HVOR
  T.inn = D.inn; -- unik nøgle

-- sætter klient-ID'er på regningsposterne
OPDATER
  invoice_import T
SET
  client_id = D.client_id
FRA
  client_import D
HVOR
  T.client_inn = D.inn; -- anvendelig nøgle
Faktisk, det er alt — i invoice_import har vi nu udfyldt forbindelsesfeltet client_id, som vi vil bruge til at indsætte regningen.
Kilde: habr.com
