

Variti udvikler beskyttelse mod bots og DDoS-angreb samt udfører stresstest og belastningstest. På konferencen HighLoad++ 2018 fortalte vi, hvordan man sikrer ressourcer mod forskellige typer angreb. Kort sagt: isoler dele af systemet, brug cloud-tjenester og CDN, og opdater regelmæssigt. Men uden specialiserede selskaber med beskyttelse vil du stadig ikke klare det 🙂
Før du læser teksten, kan du se de korte punkter .
Og hvis du ikke kan lide at læse eller blot vil se videoen, er optagelsen af vores foredrag nedenfor i spoilerlugen.
Videooptagelse af foredraget
Mange virksomheder kan allerede udføre belastningstest, men ikke alle udfører stresstest. Nogle af vores kunder tror, at deres website er uigennemtrængeligt, fordi de har en highload-løsning, og den beskytter godt mod angreb. Vi viser dog, at det ikke helt er sandt.
Selvfølgelig får vi tilladelse fra kunden, med underskrift og stempel, før vi udfører testene, og med vores hjælp kan der ikke udføres DDoS-angreb på nogen. Testen udføres på det tidspunkt, kunden har valgt, når besøgstrafikken til deres ressource er minimal, og problemer med adgang ikke vil påvirke kunderne. Desuden, da der altid kan ske noget uventet under testningen, har vi konstant kontakt med kunden. Dette gør det muligt ikke kun at rapportere om opnåede resultater, men også at foretage ændringer undervejs i testen. Ved afslutning af testen udarbejder vi altid en rapport, hvor vi angiver de opdagede mangler og giver anbefalinger til at afhjælpe svage punkter på hjemmesiden.
Hvordan vi arbejder
Under testningen emulerer vi et botnet. Da vi arbejder med kunder, som ikke befinder sig i vores netværk, skal vi for at undgå, at testen slutter på det første minut på grund af udløbsgrænser eller beskyttelse, anmelde belastningen ikke fra én IP, men fra vores eget subnet. Desuden har vi en ret kraftig testserver til at skabe betydelig belastning.
Postulater
Mere betyder ikke nødvendigvis bedre
Jo mindre belastning vi kan bringe resurserne til at fejle, jo bedre. Hvis vi kan få en hjemmeside til at stoppe med at fungere ved blot én forespørgsel pr. sekund eller endda ved én forespørgsel pr. minut, ville det være fantastisk. Fordi loven om uheldighed siger, at brugere eller ondsindede aktører tilfældigt vil ramme denne sårbarhed.
Delvis fejl er bedre end total fejl
Vi råder altid til at gøre systemerne heterogene. Og de skal opdeles på det fysiske niveau, ikke kun ved containerisering. Med fysisk adskillelse, selv hvis noget svigter på siden, er der en stor sandsynlighed for, at den ikke stopper helt, og brugerne stadig har adgang til i det mindste en del af funktionaliteten.
Den rigtige arkitektur er grundlaget for modstandsdygtighed
Fejltolerance af ressourcen og dens evne til at modstå angreb og belastninger bør lægges under designfasen, faktisk fra de første blokdiagrammer i notebogen. For hvis fatale fejl sniger sig ind, er det muligt at rette dem senere, men det er meget besværligt.
Både koden og konfigurationen skal være gode
Mange tror, at et godt udviklingsteam er en garanti for fejltolerancen af tjenesten. Et godt udviklingsteam er bestemt nødvendigt, men der skal også være god drift, god DevOps. Det kræver specialister, der korrekt konfigurerer Linux og netværket, skriver de rigtige konfigurationer i nginx, sætter grænser og så videre. Ellers vil ressourcen kun fungere godt i testen, men i produktionen vil alt bryde sammen på et tidspunkt.
Forskelle mellem belastningstest og stresstest
Belastningstest afslører systemets funktionsgrænser. Stresstest sigter mod at finde svagheder i systemet og bruges til at bryde systemet og se, hvordan det reagerer på fejl i visse dele. Ofte forbliver belastningens karakter ukendt for kunden indtil starten af stresstesten.
Kendetegn ved L7 angreb
Vi opdeler typer af belastning i L7 og L3&4 niveauer. L7 refererer til belastning på applikationsniveau, som oftest kun forstås som HTTP, men vi henviser til enhver belastning på TCP-protokolniveau.
L7 angreb har nogle særlige kendetegn. For det første kommer de direkte til applikationen, hvilket gør det vanskeligt at afvise dem med netværksmiddel. Disse angreb udnytter logik og bruger derfor meget effektivt CPU, hukommelse, disk, database og andre ressourcer, selv ved lav trafik.
HTTP Flood
I tilfælde af ethvert angreb er det lettere at skabe belastning end at håndtere det, og dette gælder også for L7. Angrebstrafik er ikke altid let at skelne fra legitim trafik, og det er oftest muligt at gøre det baseret på hyppighed, men hvis alt er planlagt korrekt, er det umuligt at forstå fra loggene, hvor angrebet er, og hvor de legitime anmodninger er.
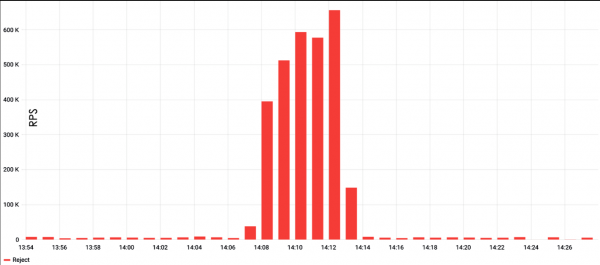
Som et første eksempel vil vi se på HTTP Flood angrebet. Grafen viser, at sådanne angreb normalt er meget kraftfulde; i eksemplet nedenfor oversteg det maksimale antal anmodninger 600.000 pr. minut.
HTTP Flood er den enkleste måde at skabe belastning på. Normalt anvendes et værktøj til belastningstest, såsom ApacheBench, hvor anmodningen og målet defineres. Med en så simpel tilgang er der stor sandsynlighed for at støde på serverens cache, men det er let at omgå. For eksempel ved at tilføje tilfældige strenge til anmodningen, hvilket tvinger serveren til konstant at returnere en frisk side.
Man skal heller ikke glemme user-agent i processen med at skabe belastning. Mange user-agents fra populære testværktøjer filtreres af systemadministratorer, og i sådanne tilfælde kan belastningen simpelthen ikke nå backend. Resultatet kan forbedres betydeligt ved at indsætte en mere eller mindre gyldig header fra en browser i anmodningen.
På trods af simpliciteten har HTTP Flood angrebene også deres ulemper. For det første kræver det store ressourcer for at skabe belastning. For det andet er sådanne angreb meget lette at opdage, især hvis de stammer fra én adresse. Som et resultat begynder anmodninger straks at blive filtreret, enten af systemadministratorer eller endda på udbyderens niveau.
Hvad skal man se efter
For reducing the number of requests per second while maintaining efficiency, a bit of creativity and exploration of the website is necessary. You can load not only the channel or server, but also individual parts of an application, such as databases or file systems. You can also search for areas on the site that perform heavy computations: calculators, product selection pages, and so on. Finally, it often happens that there is a PHP script on the site that generates a page from several hundred thousand lines. Such a script can significantly load the server and become a target for attacks.
Where to look
When we scan a resource before testing, we first look at the site itself. We search for all kinds of input fields, heavy files — basically anything that could cause issues for the resource and slow down its performance. This is where basic developer tools in Google Chrome and Firefox help, showing page response times.
We also scan subdomains. For example, there is an online store, abc.com, and it has a subdomain admin.abc.com. This is likely an admin panel with authorization, but if you apply load to it, it may create problems for the main resource.
The site may have a subdomain api.abc.com. This is likely a resource for mobile applications. The app can be found in the App Store or Google Play, a special access point can be set up, the API can be dissected, and test accounts can be registered. The problem is that often people think that anything protected by authorization is invulnerable to denial of service attacks. It’s believed that authorization is the best CAPTCHA, but that’s not true. Creating 10-20 test accounts is easy, and by doing so, we gain access to complex and unprotected functionality.
Naturally, we look at the history, robots.txt, and WebArchive, ViewDNS, searching for old versions of the resource. Sometimes developers roll out, for example, mail2.yandex.net, while the old version, mail.yandex.net, remains. This mail.yandex.net ceases to be supported, and no development resources are allocated for it, but it continues to consume the database. Accordingly, using the old version, we can effectively leverage the backend resources and everything that lies behind the layout. Of course, this doesn’t happen all the time, but we encounter something similar fairly often.
Selvfølgelig analyserer vi alle forespørgselsparametre og cookie-strukturen. Man kan for eksempel indsætte en værdi i et JSON-array inden for en cookie, skabe en stor indlejring og få ressourcen til at fungere urimeligt længe.
Belastning i søgningen
Det første, der kommer i tankerne ved undersøgelse af en hjemmeside, er at belaste databasen, da næsten alle har en søgefunktion, og desværre er den dårligt beskyttet i næsten alle tilfælde. Af en eller anden grund giver udviklerne ikke søgningen tilstrækkelig opmærksomhed. Men der er et råd — undgå at lave ensartede forespørgsler, da man kan støde på caching, ligesom ved HTTP-flood.
At lave tilfældige forespørgsler i databasen er heller ikke altid effektivt. Det er meget bedre at lave en liste over nøgleord, som relaterer til søgningen. Hvis vi vender tilbage til eksemplet med en webshop: lad os sige, at hjemmesiden sælger bildæk og tillader at angive dækkets radius, biltype og andre parametre. Kombinationsmuligheder af relevante ord vil få databasen til at arbejde under meget mere komplekse forhold.
Derudover bør man bruge paginering: det er meget sværere for søgningen at give den næstsidste side af resultaterne end den første. Med paginering kan man derfor variere belastningen en smule.
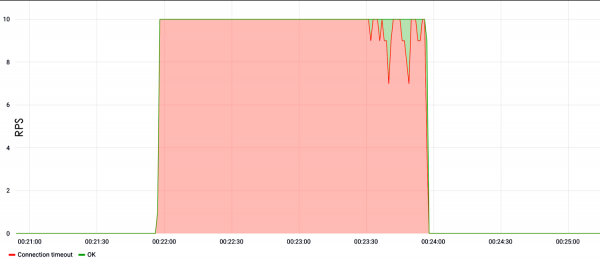
I eksemplet nedenfor viser vi belastningen i søgningen. Det ses, at fra det første sekund af testen med ti forespørgsler pr. sekund gik hjemmesiden ned og svarede ikke.
Hvis der ikke er nogen søgning?
Hvis der ikke er nogen søgning, betyder det ikke, at hjemmesiden ikke indeholder andre sårbare indtastningsfelter. Et sådant felt kunne være autorisation. I dag elsker udviklere at lave komplekse hashes for at beskytte login-databasen mod angreb ved hjælp af regnbue-tabeller. Det er godt, men sådanne hashes kræver store CPU-ressourcer. Et stort antal falske login-forsøg fører til overbelastning af processoren, og som følge heraf stopper hjemmesiden med at fungere.
Tilstedeværelsen af alle former for kommentar- og feedbackformularer på hjemmesiden er en grund til at sende meget store tekstmængder eller blot skabe massiv spam. Nogle gange accepterer hjemmesider indlejringer, også i gzip-format. I dette tilfælde tager vi en fil på 1 TB, komprimerer den med gzip til nogle få bytes eller kilobyte og sender den til hjemmesiden. Derefter bliver den udpakket, og der opnås en meget interessant effekt.
Rest API
Det er vigtigt at fokusere på populære tjenester som Rest API. At beskytte Rest API er meget sværere end at beskytte en almindelig hjemmeside. Selv grundlæggende metoder til at beskytte mod brute-force angreb og anden uautoriseret aktivitet fungerer ikke for Rest API.
Rest API er meget nemt at bryde ind i, fordi det har direkte adgang til databasen. Nedbrud af en sådan tjeneste kan have alvorlige konsekvenser for virksomheden. Problemet er, at Rest API ofte er knyttet til ikke bare hovedwebsitet, men også mobilapplikationen og interne forretningsressourcer. Hvis alt dette går ned, vil effekten være meget stærkere end ved nedbrud af en almindelig hjemmeside.
Belastning af tungt indhold
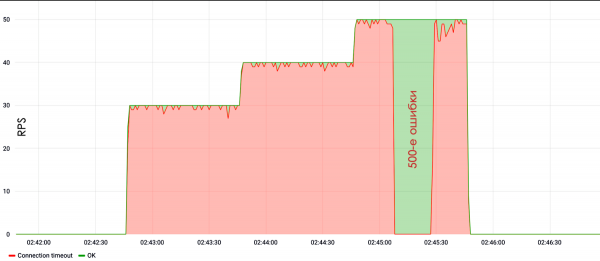
Når vi bliver bedt om at teste en almindelig landside, et enkelt side-applikation eller en visitkort hjemmeside uden komplekse funktioner, søger vi efter tungt indhold. For eksempel store billeder, som serveren leverer, binære filer eller pdf-dokumentation - vi prøver at downloade alt dette. Sådanne tests belaster filsystemet effektivt og fylder kanalerne, hvilket gør dem effektive. Det betyder, at selvom du ikke bringer serveren ned ved at downloade en stor fil med lave hastigheder, så fylder du blot det målrettede servers kanal, hvilket resulterer i serviceafvisning.
I dette eksempel ses det, at ved 30 RPS stoppede siden med at svare, eller gav 500 serverfejl.
Man må heller ikke glemme serverindstillingerne. Ofte ser man, at en person har købt en virtuel maskine, installeret Apache, konfigureret alt til standard, placeret en php-applikation, og nedenfor kan man se resultatet.
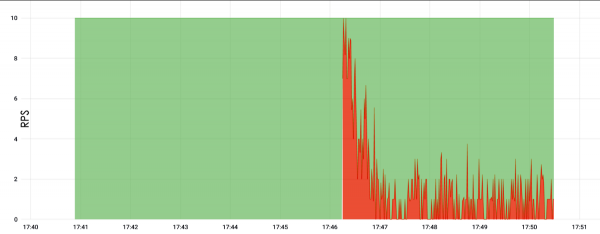
Her gik belastningen til roden og var kun 10 RPS. Vi ventede 5 minutter, og serveren gik ned. Det er dog uklart, hvorfor den gik ned, men der er en formodning om, at den simpelthen har brugt for meget hukommelse, hvilket resulterede i, at den ikke længere kunne svare.
Bølgebaseret
I de sidste år eller to er bølgeangreb blevet ret populære. Dette skyldes, at mange organisationer køber de forskellige enheder til beskyttelse mod DDoS, som kræver en vis tid til at opsamle statistik for at begynde at filtrere angrebet. Det vil sige, at de ikke filtrerer angrebet i de første 30-40 sekunder, fordi de opsamler data og lærer. I disse 30-40 sekunder kan der derfor sendes så mange anmodninger til siden, at ressourcen vil være utilgængelig i lang tid, indtil alle anmodninger er behandlet.
I tilfælde af angrebet nedenfor var der et interval på 10 minutter, hvorefter en ny, ændret portion af angrebet kom.
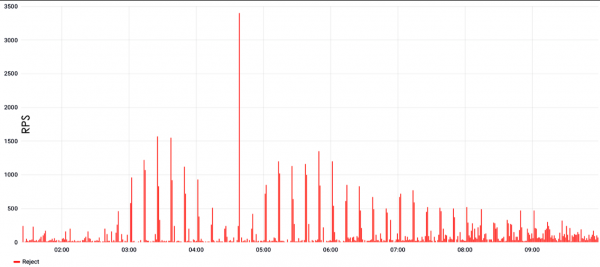
Så beskyttelsen blev trænet, indledte filtreringen, men en ny, helt anderledes portion af angrebet kom, og beskyttelsen begyndte igen at lære. Faktisk stopper filtreringen med at virke, beskyttelsen bliver ineffektiv, og siden er utilgængelig.
Bølgeangreb er kendetegnet ved meget høje værdier på toppen; det kan nå op på hundrede tusinde eller en million anmodninger pr. sekund, i tilfælde af L7. Hvis vi taler om L3&4, kan der være hundredvis af gigabit trafik, eller hundredvis af mpps, hvis vi ser på pakker.
Problemet med sådanne angreb er synkroniseringen. Angrebene kommer fra botnet, og for at skabe et meget stort spidsbelastning er der behov for en høj grad af synkronisering. Og denne koordination lykkes ikke altid: nogle gange resulterer det i en eller anden parabolisk spids, som ser temmelig ynkelig ud.
Ikke kun HTTP
Udover HTTP på L7-niveauet elsker vi også at udnytte andre protokoller. Som regel er der for en almindelig hjemmeside, især en almindelig hosting, også mailprotokoller og MySQL, der stikker ud. Mailprotokoller er mindre udsatte for belastninger end databaser, men de kan også belastet effektivt, hvilket kan medføre overbelastning af CPU'en på serveren.
Vi har med succes udnyttet en sårbarhed i SSH fra 2016. Nu er denne sårbarhed næsten udbedret hos alle, men det betyder ikke, at man ikke kan påføre belastning via SSH. Det kan man. Der kan simpelthen sendes en enorm belastning af godkendelser, SSH bruger næsten al CPU'en på serveren, og derefter falder websiden allerede ved en til to anmodninger pr. sekund. Disse en til to anmodninger kan ikke adskilles fra legitim belastning i loggene.
Der er stadig mange forbindelser, som vi åbner på serverne. Tidligere havde Apache ofte dette problem, og nu har nginx faktisk også det, da det ofte konfigureres som standard. Antallet af forbindelser, som nginx kan holde åbne, er begrænset, så når vi når dette antal forbindelser, accepterer nginx ikke nye forbindelser, og derfor fungerer hjemmesiden ikke.
Vores testklynge har tilstrækkelig CPU til at angribe SSL-handshake. Som praksis viser, kan botnets også nogle gange lide at gøre dette. På den ene side er det klart, at uden SSL kan man ikke klare sig, da det påvirker Google's resultater, rangering og sikkerhed. På den anden side har SSL desværre et problem med CPU.
L3&4
Når vi taler om angreb på niveauerne L3&4, taler vi typisk om angreb på kanalniveau. Sådan belastning kan næsten altid skelnes fra legitim, medmindre det er et SYN-flood angreb. Problemet med SYN-flood angreb for beskyttelsesmidler skyldes den store mængde. Den maksimale størrelse for L3&4 var 1,5-2 Tbit/s. Sådan trafik er meget svær at håndtere selv for store virksomheder, herunder Oracle og Google.
SYN og SYN-ACK er pakker, der bruges ved etablering af forbindelsen. Derfor er det svært at skelne SYN-flood fra legitim belastning: det er uklart, om det er SYN, der kom for at etablere forbindelsen, eller en del af floden.
UDP-flood
Normalt har angriberne ikke den samme kapacitet som os, derfor kan de bruge amplification for at udføre angreb. Det vil sige, at angriberen scanner internettet og finder enten sårbare eller forkert konfigurerede servere, som for eksempel svarer med tre SYN-ACK på en enkelt SYN-pakke. Ved at forfalske kildeadressen med adressen på den målserver kan man med én pakke øge styrken, så at sige, tre gange og omdirigere trafikken til offeret.
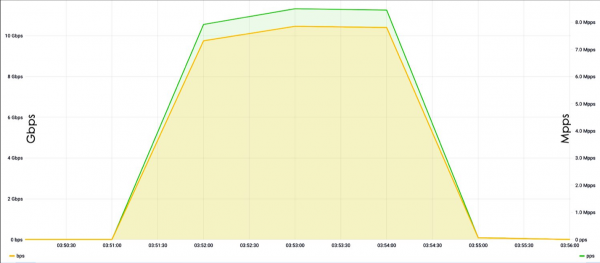
Problemet med amplification er deres vanskelige opdagelse. Et af de mest kendte tilfælde er det sårbare memcached. Desuden er der nu mange IoT-enheder, IP-kameraer, der også primært er konfigureret som standard, og som også er forkert konfigureret som standard, hvilket er grunden til, at angriberne oftest gennem sådanne enheder udfører angreb.
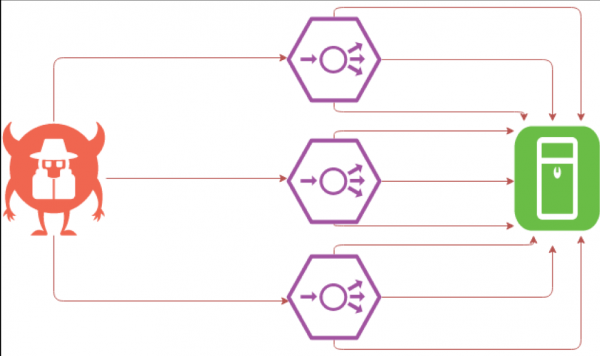
SYN-flood er ikke enkelt
SYN-flood er sandsynligvis den mest interessante type angreb set fra en udviklers synspunkt. Problemet er, at systemadministratorer ofte bruger IP-blokering til beskyttelse. Desværre er det ikke kun administratorer, der følger skripter, der lider under IP-blokering, men også nogle sikkerhedssystemer, som koster mange penge.
Denne metode kan ende i katastrofe, for hvis angriberne ændrer IP-adresser, vil virksomheden blokere sit eget subnet. Når firewall'en blokerer sit eget cluster, vil eksterne interaktioner bryde sammen, og ressourcen vil gå i stykker.
Det er desuden ikke svært at blokere sit eget netværk. Hvis kunden har et Wi-Fi-netværk på kontoret, eller hvis ressourcernes funktionalitet måles med diverse overvågningsværktøjer, tager vi IP-adressen fra disse overvågningssystemer eller det kontor-Wi-Fi, og bruger den som kilde. Resultatet er, at ressourcen ser ud til at være tilgængelig, men de målrettede IP-adresser er blokeret. På denne måde kan Wi-Fi-netværket ved HighLoad-konferencen, hvor virksomhedens nye produkt præsenteres, blive blokeret—og dette medfører visse forretnings- og økonomiske omkostninger.
Under testningen kan vi ikke bruge amplification via memcached fra eksterne ressourcer, fordi der er aftaler om, at trafik kun må ledes til tilladte IP-adresser. Derfor bruger vi amplification via SYN og SYN-ACK, når sendingen af én SYN resulterer i to-tre SYN-ACK svar, hvilket dermed multiplicerer angrebet med to-tre gange.
Værktøjer
Et af de vigtigste værktøjer, vi bruger til belastning på L7-niveau, er Yandex-tank. Især bruges en phantom som kanon, plus der er nogle scripts til at generere patroner og til at analysere resultaterne.
Til analyse af netværkstrafik bruges Tcpdump, til serveranalyse — Nmap. Til at skabe belastning på L3&4-niveau bruges OpenSSL og lidt egen magi med DPDK-biblioteket. DPDK er et bibliotek fra Intel, der muliggør direktetilgang til netværksinterfacet uden om Linux-stakken, hvilket øger effektiviteten. Selvfølgelig bruger vi DPDK ikke kun på L3&4-niveau, men også på L7-niveau, da det tillader os at skabe en meget høj belastning, op til flere millioner forespørgsler per sekund fra én maskine.
Vi bruger også specifikke trafikgeneratorer og særlige værktøjer, som vi skriver til specifikke tests. Hvis vi husker sårbarheden under SSH, så kan den nævnte sammensætning ikke udnyttes. Hvis vi angriber mailprotokollen, bruger vi mailværktøjer eller skriver blot scripts til dem.
Konklusioner
Som konklusion vil jeg gerne sige:
- Ud over klassisk belastningstestning er det vigtigt også at udføre stresstestning. Vi har et reelt eksempel, hvor en underleverandør fra en partner kun udførte belastningstest. Det viste, at ressourcen kan håndtere den normale belastning. Men da der opstod en unormal belastning, begyndte besøgende at bruge ressourcen på en lidt anden måde, og til sidst faldt underleverandøren. Derfor er det værd at lede efter sårbarheder, selvom du allerede er beskyttet mod DDoS-angreb.
- Det er nødvendigt at isolere visse dele af systemet fra andre. Hvis du har søgefunktionalitet, skal den placeres på separate maskiner, dvs. ikke engang i Docker. Fordi hvis søgningen eller godkendelsen fejler, vil i det mindste noget fortsætte med at fungere. I tilfælde af en webshop vil brugerne fortsætte med at finde varer i kataloget, komme fra aggregatoren, købe hvis de allerede er godkendt, eller godkende via OAuth2.
- Man skal ikke undervurdere alle mulige cloud-tjenester.
- Brug CDN ikke kun til at optimere netværksforsinkelser, men også som et middel til beskyttelse mod angreb, der udtømmer båndbredde og bare floder mod statisk indhold.
- Det er nødvendigt at anvende specialiserede beskyttelsestjenester. Du kan ikke selv beskytte dig mod L3&4 angreb på kanalniveau, fordi du sandsynligvis ikke har en tilstrækkelig kanal. L7-angreb vil du også have svært ved at afværge, da de kan være meget store. Desuden er det at finde små angreb stadig specialiserede tjenesters, specialiserede algoritmers prerogativ.
- Opdater regelmæssigt. Dette gælder ikke kun kernen, men også SSH daemon, især hvis de er åbne mod omverdenen. Generelt skal alt opdateres, for du vil næppe kunne følge med de forskellige sårbarheder selv.
Kilde: habr.com
