

Oversigt over foredraget fra 2015 af Alexey Lesovsky "Deep dive into PostgreSQL internal statistics"
Ansvarsfraskrivelse fra forfatteren af foredraget: Jeg vil bemærke, at dette foredrag er dateret til november 2015 — der er gået mere end 4 år, og der har været meget tid. Den version, der behandles i foredraget, 9.4, understøttes ikke længere. Der er udgivet 5 nye versioner i løbet af de sidste 4 år, hvor mange nyheder, forbedringer og ændringer er blevet introduceret med hensyn til statistik, og noget af materialet er forældet og ikke relevant. Under gennemgangen har jeg forsøgt at notere disse steder for ikke at føre dig, læser, på vilspor. Jeg valgte ikke at omskrive disse steder, da der er så mange, at det i sidste ende ville resultere i et helt andet foredrag.
PostgreSQL-databasen er en kæmpe mekanisme, der består af mange undersystemer, hvis velfungerende samarbejde direkte påvirker databaseydelsen. I løbet af driftsperioden indsamles statistik og information om komponenternes arbejde, hvilket giver os mulighed for at vurdere effektiviteten af PostgreSQL og træffe foranstaltninger til at forbedre ydeevnen. Men der er meget information, og den præsenteres i en ret forenklet form. Behandling og fortolkning af denne information kan til tider være en overordentligt kompleks opgave, og "zooen" af værktøjer og hjælpemidler kan nemt forvirre selv en erfaren DBA.
Goddag! Mit navn er Alexey. Som Ilya sagde, vil jeg tale om PostgreSQL-statistik.
Statistik over PostgreSQL-aktivitet. PostgreSQL har to statistikker. Aktivitetens statistik, som jeg vil tale om. Og statistik fra planlæggeren om datadistribution. Jeg vil fokusere på aktiviteten i PostgreSQL, som giver os mulighed for at bedømme ydeevnen og finde måder til at forbedre den.
Jeg vil fortælle, hvordan man effektivt bruger statistikken til at løse forskellige problemer, som du står over for, eller som kan opstå.
Hvad vil ikke blive dækket i foredraget? I foredraget vil jeg ikke berøre planlæggerens statistik, da det er et separat emne til et andet foredrag om, hvordan data opbevares i databasen, og hvordan planlæggeren får indsigt i de kvalitative og kvantitative egenskaber ved disse data.
Og der vil ikke være nogle værktøjsanmeldelser, jeg vil ikke sammenligne ét produkt med et andet. Der vil ikke være nogen reklame. Lad os lægge det til side.
Jeg vil vise dig, at det er nyttigt at bruge statistik. Det er nødvendigt. Det er ikke skræmmende at bruge det. Vi behøver kun almindelig SQL og grundlæggende SQL-viden.
Og vi vil tale om, hvilken statistik man skal vælge for at løse problemer.
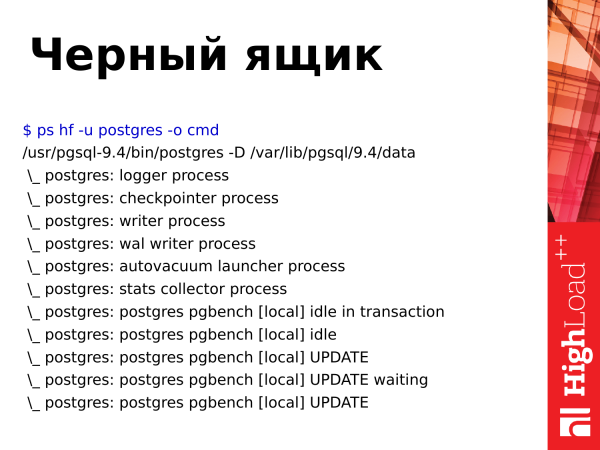
Hvis vi ser på PostgreSQL og kører en kommando i operativsystemet for at se processerne, vil vi se en "sort boks". Vi vil se nogle processer, som laver noget, og ud fra navnet kan vi omtrent forestille os, hvad de laver, hvad de beskæftiger sig med. Men i realiteten er det en sort boks, vi kan ikke se ind i den.
Vi kan se belastningen på CPU'en i top, vi kan se hukommelsesudnyttelse med nogle systemværktøjer, men vi kan ikke kigge ind i PostgreSQL. Til det har vi brug for andre værktøjer.
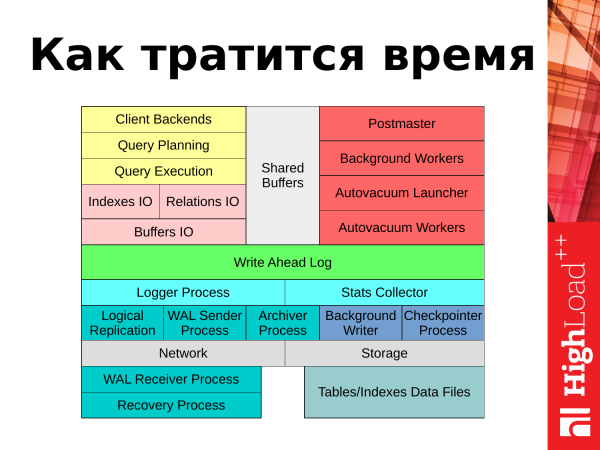
Og videre vil jeg fortælle, hvor tiden bliver brugt. Hvis vi forestiller os PostgreSQL som et diagram, kan vi svare på, hvor tiden bliver brugt. Det er to ting: det er behandling af klientanmodninger fra applikationer og baggrundsopgaver, som PostgreSQL udfører for at opretholde sin funktionalitet.
Hvis vi begynder at se fra øverste venstre hjørne, kan vi spore, hvordan klientanmodningerne behandles. Anmodningen kommer fra applikationen, og for at arbejde videre åbnes en klientsession. Anmodningen sendes til planlæggeren. Planlæggeren opretter en anmodningsplan. Den sender den videre til udførelse. Der sker en eller anden blokering af dataind- og uddata relateret til tabellerne og indeksene. De nødvendige data læses fra disken ind i hukommelsen i et specielt område kaldet "shared buffers". Resultaterne af anmodningen, hvis det er opdateringer, sletninger, bliver registreret i transaktionsloggen i WAL. Nogle statistiske oplysninger går til loggen eller i en statistikindsamler. Og resultatet af anmodningen returneres til klienten. Herefter kan klienten gentage det hele med en ny anmodning.
Hvad med baggrundsopgaver og baggrundsprocesser? Vi har flere processer, der sikrer funktionaliteten og holder databasen i normal driftstilstand. Disse processer vil også blive berørt i præsentationen: det er autovacuum, checkpointer, processer relateret til replikation, background writer. Jeg vil berøre hver af dem, som præsentationen skrider frem.
Hvilke problemer er der med statistikken?
- Der er meget information. PostgreSQL 9.4 tilbyder 109 metrikker til at se statistikdata. Men hvis der er mange tabeller, skemaer og databaser gemt i databasen, skal alle disse metrikker multipliceres med det relevante antal tabeller og databaser. Det vil sige, at informationen bliver endnu mere omfattende, og det er meget let at drukne i den.
- Det næste problem er, at statistikken præsenteres som tællere. Hvis vi ser på denne statistik, vil vi se, at tællerne konstant stiger. Og hvis der er gået lang tid siden nulstillingen af statistikken, vil vi se milliardbeløb. Og de siger os intet.
- Der er ingen historik. Hvis du har haft en fejl, og noget gik ned for 15-30 minutter siden, kan du ikke bruge statistikken til at se, hvad der skete 15-30 minutter før. Det er et problem.
- Manglen på et indbygget værktøj i PostgreSQL er et problem. Kernenudviklerne tilbyder ingen nyttig software. De giver blot statistikken i databasen. Brug den, lav forespørgsler, hvad du vil, gør hvad du vil.
- Da der ikke er noget indbygget værktøj i PostgreSQL, er det årsagen til et andet problem. Mange tredjepartsværktøjer. Hver virksomhed, der har en nogenlunde dygtig medarbejder, prøver at skrive sit eget program. Og i sidste ende er der mange værktøjer i fællesskabet, som kan bruges til at arbejde med statistikken. Nogle værktøjer har nogle funktioner, andre mangler disse funktioner, eller har nogle nye muligheder. Og situationen opstår, at man skal bruge to, tre eller fire værktøjer, som overlapper hinanden og har forskellige funktioner. Det er meget ubehageligt.
Hvad følger der af dette? Det er vigtigt at kunne hente statistik direkte, så man ikke er afhængig af programmer, eller selv forbedre disse programmer: tilføje nogle funktioner for at få sin fordel.
Og der er behov for grundlæggende SQL-viden. For at få nogle data fra statistikken skal du danne SQL-forespørgsler, det vil sige, du skal vide, hvordan man opretter select- og join-forespørgsler.
Statistikken tilbyder os flere ting. De kan opdeles i kategorier.
- Den første kategori er hændelser, der finder sted i databasen. Det er når en hændelse finder sted i databasen: en forespørgsel, adgang til en tabel, autovacuum, commits; det er alle hændelser. De tilhørende tællere inkrementeres. Vi kan spore disse hændelser.
- Den anden kategori er egenskaber ved objekter såsom tabeller og databaser. De har egenskaber. Det er størrelsen på tabellerne. Vi kan spore væksten af tabellerne, væksten af indekser. Vi kan se ændringer over tid.
- Og den tredje kategori er den tid, der bruges på en hændelse. En forespørgsel er en hændelse. Den har en konkret måleenhed for varighed. Her er den startet, her er den sluttet. Vi kan spore dette. Enten tiden det tager at læse en blok fra disken eller at skrive. Sådanne ting spores også.
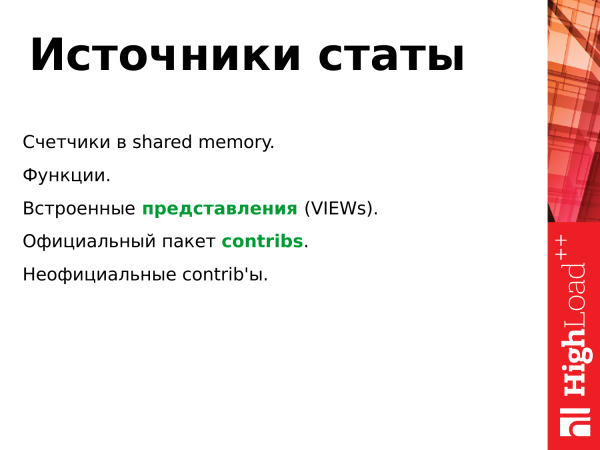
Kilderne til statistikken præsenteres som følger:
- I den delte hukommelse (shared buffers) er der et segment til placering af statiske data, hvor der også findes de tællere, der konstant inkrementeres, når forskellige hændelser opstår, eller når der opstår visse situationer i databasens drift.
- Alle disse tællere er ikke tilgængelige for brugeren og endda ikke tilgængelige for administratoren. Det er lavniveau-elementer. For at få adgang til dem giver PostgreSQL et interface i form af SQL-funktioner. Vi kan lave SELECT-udtræk ved hjælp af disse funktioner og få en eller anden måling (eller et sæt af målinger).
- Men det er ikke altid praktisk at bruge disse funktioner, så funktionerne danner basis for visninger (VIEWs). Det er virtuelle tabeller, der leverer statistik for et bestemt subsystem eller for en bestemt samling hændelser i databasen.
- Disse indbyggede visninger (VIEWs) er den primære brugergrænseflade til arbejde med statistisk information. De er tilgængelige som standard uden nogen yderligere konfiguration; du kan straks bruge dem, se, hente information derfra. Derudover findes der contribs. Der er officielle contribs. Du kan installere pakken postgresql-contrib (for eksempel postgresql94-contrib), indlæse den nødvendige modul i konfigurationen, angive parametre for det og genstarte PostgreSQL, så kan du bruge det. (Bemærk. Afhængig af distributionen er contrib-pakken i de seneste versioner en del af hovedpakken.).
- Og der findes ikke-officielle contrib. De leveres ikke i den standardpakke, der følger med PostgreSQL. De skal enten kompileres eller installeres som et bibliotek. Mulighederne kan variere afhængigt af, hvad udvikleren af denne ikke-officielle contrib har fundet på.
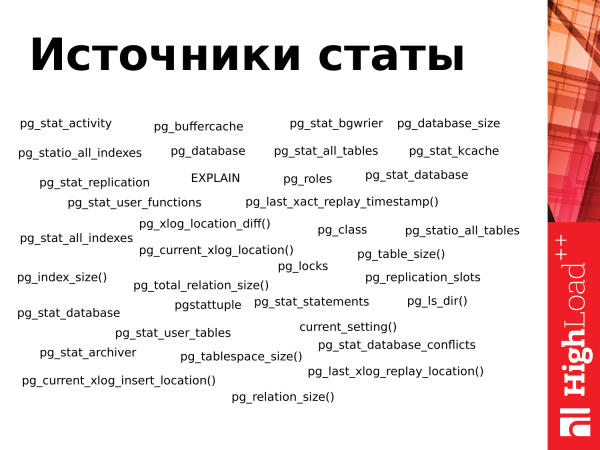
På dette slide præsenteres alle de views og en del af de funktioner, der er tilgængelige i PostgreSQL 9.4. Som vi kan se, er der rigtig mange. Det kan være ret nemt at blive forvirret, hvis man støder på dette for første gang.
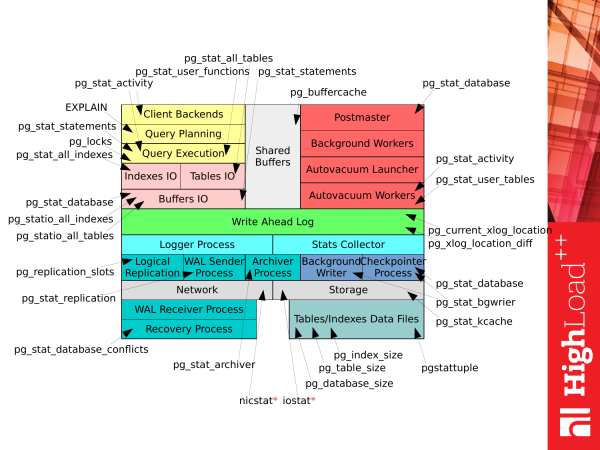
Men hvis vi tager det tidligere billede Hvordan tiden bruges på PostgreSQL og sammenligner det med denne liste, får vi et sådant billede. Hvert view eller hver funktion kan vi bruge til forskellige formål for at få den relevante statistik, når vi arbejder med PostgreSQL. Og vi kan allerede få en vis information om, hvad der sker i subsystemet.
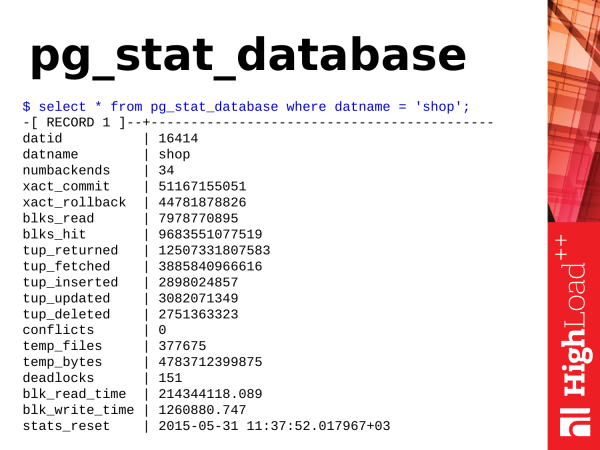
Det første, vi vil se på, er pg_stat_database. Som vi kan se, er dette et view. Der er rigtig meget information i det. Meget forskelligartet information. Og det giver os meget nyttig viden om, hvad der sker i databasen.
Hvad kan vi nyttigt tage derfra? Lad os starte med de mest grundlæggende ting.
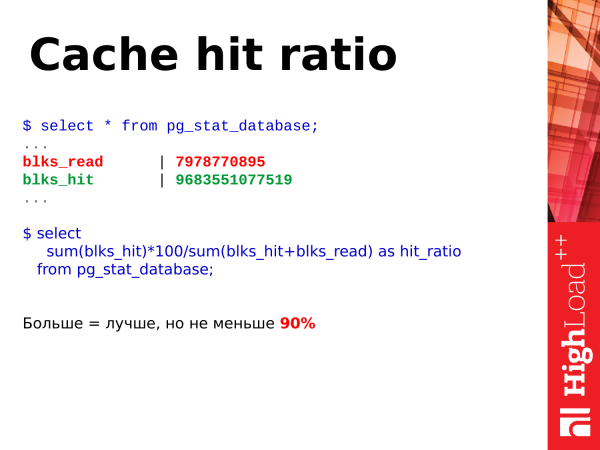
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Det første, vi kan se på – er procentdelen af cache hits. Procentdelen af cache hits er en nyttig metric. Den giver os mulighed for at vurdere, hvilken mængde data der hentes fra cache shared buffers, og hvilken mængde der læses fra disken.
Det er klart, at jo højere vores cache hit procent er, desto bedre. Vi vurderer denne metric som en procent. Og for eksempel, hvis vi har en procentvis andel af disse cache hits, der er over 90 %, så er det godt. Hvis den falder under 90 %, betyder det, at vi ikke har nok hukommelse til at holde de 'varme' data i hukommelsen. Og for at bruge disse data er PostgreSQL nødt til at tilgå disken, og det er langsommere end hvis data blev læst fra hukommelsen. Og vi skal begynde at overveje at øge hukommelsen: enten ved at øge shared buffers eller ved at tilføje mere RAM.
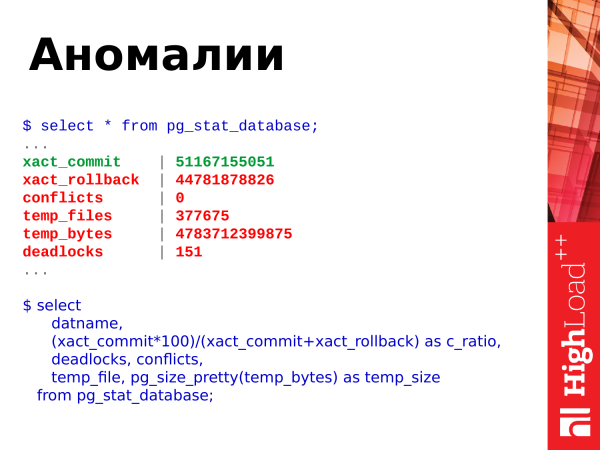
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Hvad kan vi ellers hente fra dette view? Vi kan se på anomalier, der sker i databasen. Hvad er der vist her? Her er commits, rollbacks, oprettelse af midlertidige filer, deres størrelse, deadlocks og konflikter.
Vi kan bruge denne forespørgsel. Denne SQL er ganske enkel. Og vi kan se disse oplysninger hos os selv.
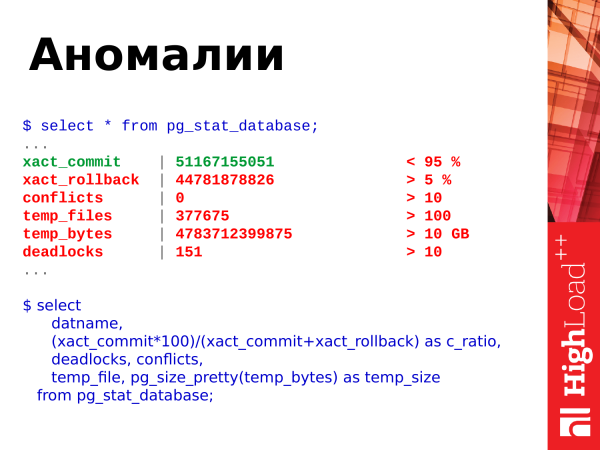
Og her er tærskelværdierne straks. Vi ser på forholdet mellem commits og rollbacks. Commits er den succesfulde bekræftelse af en transaktion. Rollbacks er tilbageskydninger, dvs. transaktionen udførte noget arbejde, belastede databasen, udførte beregninger, og derefter opstod der en fejl, og resultaterne af transaktionen blev forkastet. Dvs. et stigende antal rollbacks er dårligt. Og man bør finde måder at undgå dem på og rette koden, så sådanne situationer ikke opstår.
Konflikter (conflicts) er relateret til replikering. Og de bør også undgås. Hvis du har nogle forespørgsler, der kører på en replika og der opstår konflikter, skal du undersøge disse konflikter og se, hvad der foregår. Detaljer kan findes i loggene. Og du skal løse konfliktsituationer, så applikationsforespørgsler fungerer uden fejl.
Deadlocks er også en dårlig situation. Når forespørgsler kæmper om ressourcer, har den ene forespørgsel fået lås på én ressource, mens den anden forespørgsel har fået lås på en anden ressource, og så henvendte begge forespørgsler sig til hinandens ressourcer og blev låst i forventning om, at den anden ville frigive låsen. Dette er også et problematisk scenarie. De skal løses på applikationsniveau ved at omstrukturere koden og serialisere adgangen til ressourcerne. Og hvis du ser, at dine deadlocks konstant stiger, skal du se nærmere på detaljerne i loggene, undersøge de opståede situationer og finde ud af, hvad problemet er.
Temporære filer (temp_files) er også dårlige. Når en brugers forespørgsel mangler hukommelse til at gemme midlertidige data, opretter den en fil på disken. Og alle operationer, som den kunne have udført i det midlertidige buffer i hukommelsen, begynder den nu at udføre på disken. Dette er langsomt. Dette øger udførelsestiden for forespørgslen. Og klienten, der har sendt forespørgslen til PostgreSQL, vil modtage et svar lidt senere. Hvis alle disse operationer blev udført i hukommelsen, ville Postgres svare meget hurtigere, og klienten ville skulle vente mindre.
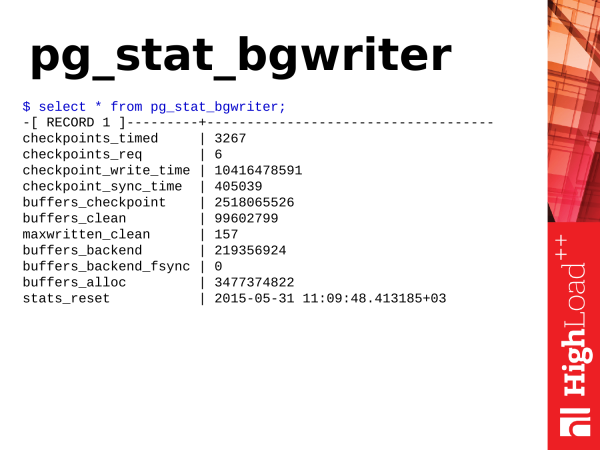
Pg_stat_bgwriter er en visning, der beskriver arbejdet af to baggrundsunderkaster i PostgreSQL: det er checkpointer og background writer.
Lad os først se på kontrolpunkterne, de såkaldte checkpoints. Hvad er kontrolpunkter? Et kontrolpunkt er en position i transaktionsloggen, der angiver, at alle datamodifikationer, der er registreret i loggen, er blevet succesfuldt synkroniseret med dataene på disken. Processen kan afhængigt af arbejdsbelastningen og indstillingerne være langvarig og består hovedsageligt i at synkronisere beskidte sider i shared buffers med datarfilerne på disken. Hvorfor er dette nødvendigt? Hvis PostgreSQL konstant skulle tilgå disken for at hente data og skrive data ved hver adgang, ville det være langsomt. Derfor har PostgreSQL et hukommelsessegment, hvis størrelse afhænger af konfigurationens parametre. Postgres placerer de operationelle data i denne hukommelse til senere behandling eller udlevering ved forespørgsler. Ved forespørgsler om at ændre data sker ændringen. Og vi får to versioner af dataene. Den ene har vi i hukommelsen, den anden på disken. Og lejlighedsvis er det nødvendigt at synkronisere disse data. Vi skal synkronisere det, der er ændret i hukommelsen, med disken. For dette bruges checkpoint.
Checkpointet gennemgår shared buffers, mærker de beskidte sider, som er nødvendige til checkpoint. Derefter foretager det et andet passager gennem shared buffers. De sider, der er markeret til checkpoint, bliver derefter synkroniseret. På denne måde udføres datasykroniseringen med disken.
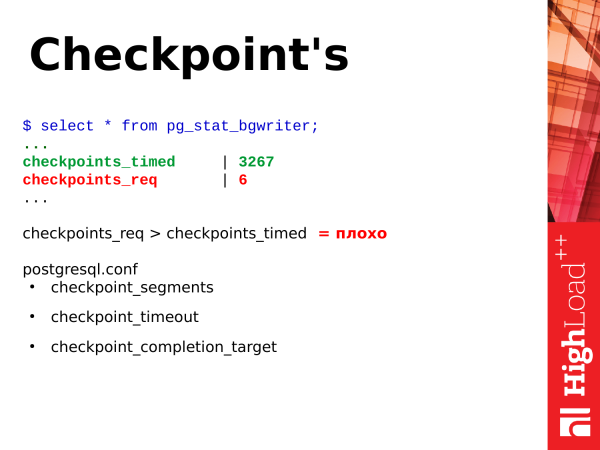
Der er to typer kontrolpunkter. Et kontrolpunkt udføres ved et tidsinterval. Dette kontrolpunkt er nyttigt og godt – checkpoint_timed. Og der er kontrolpunkter efter behov – checkpoint required. Et sådant kontrolpunkt opstår, når vi har en meget stor dataskrivning. Vi har skrevet en masse transaktionslogger. Og PostgreSQL vurderer, at det er nødvendigt at synkronisere alt så hurtigt som muligt, lave et kontrolpunkt og fortsætte.
Og hvis du har kigget på statistikken pg_stat_bgwriter og set, at du har checkpoint_req langt flere end checkpoint_timed, så er det dårligt. Hvorfor er det dårligt? Det betyder, at PostgreSQL er i en konstant stress-situation, hvor det skal skrive data til disken. Checkpoint ved tidsinterval er mindre stressende og udføres i henhold til en intern tidsplan og strækkes over tid. PostgreSQL har mulighed for at tage pauser i arbejdet og ikke belaste disk-systemet. Dette er gavnligt for PostgreSQL. Og forespørgsler, der udføres under checkpoint, vil ikke opleve stress ved, at disksystemet er optaget.
Og der er tre parametre til regulering af checkpoint:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Disse parametre gør det muligt at regulere arbejdet med kontrolpunkter. Men jeg vil ikke dvæle ved dem. Deres indflydelse er et separat emne.
Opmærksomhed: Den version, der bliver præsenteret i rapporten, 9.4, er allerede ikke længere relevant. I moderne versioner af PostgreSQL er parameteren checkpoint_segments blevet erstattet af parametrene min_wal_size og max_wal_size.
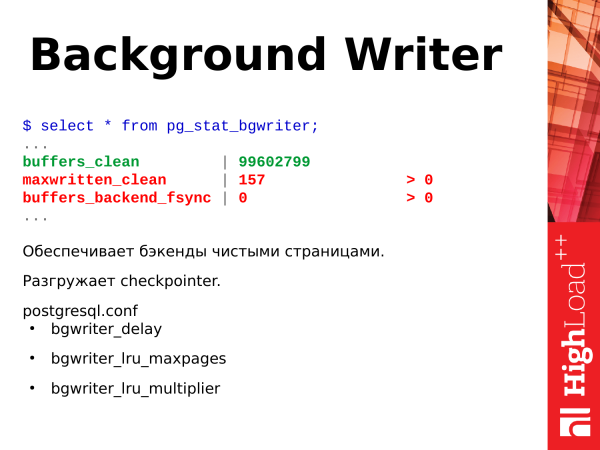
Den næste subsystem er baggrundsskriveren — background writer. Hvad laver han? Han arbejder konstant i en uendelig løkke. Han scanner sider i shared buffers og de “beskidte” sider, han finder, bliver sendt til disken. På den måde hjælper han checkpointeren med at gøre mindre arbejde under udførelsen af kontrolpunkter.
Hvad er han ellers nødvendig for? Han sikrer behovet for rene sider i shared buffers, hvis de pludselig er nødvendige (i stort antal og med det samme) for at placere data. Antag en situation, hvor rene sider kræves for at udføre en forespørgsel, og de allerede er i shared buffers. PostgreSQL backend tager blot disse og bruger dem, han behøver ikke selv at rense noget. Men hvis der pludselig ikke er sådanne sider, stopper backend arbejde og begynder at lede efter sider, for at sende dem til disken og tage dem til sine behov — hvilket negativt påvirker tiden for den nuværende forespørgsel. Hvis du ser, at din parameter maxwritten_clean er høj, betyder det, at baggrundsskriveren ikke klarer sit arbejde, og det er nødvendigt at øge parametrene bgwriter_lru_maxpages, så han kan gøre mere arbejde i en enkelt cyklus og rense flere sider.
Og en anden meget nyttig indikator – buffers_backend_fsync. Backends udfører ikke fsync, fordi det er langsomt. De sender fsync opad i IO-stakken til checkpointeren. Checkpointeren har sin egen kø, han behandler periodisk fsync og synkroniserer siderne i hukommelsen med filer på disken. Hvis køen er stor hos checkpointeren og fyldt, er backend tvunget til selv at udføre fsync, og det forsinker backendens arbejde,, dvs. kunden vil få et svar senere, end han kunne have. Hvis du ser, at denne værdi er større end nul, er det allerede et problem, og det er nødvendigt at være opmærksom på indstillingerne for baggrundsskriveren og også vurdere ydeevnen af disksystemet.
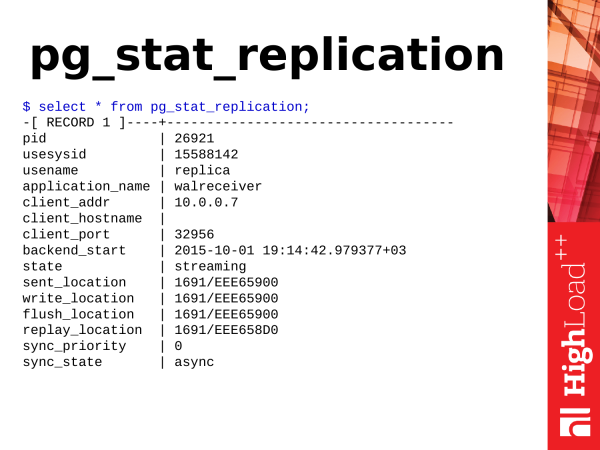
Opmærksomhed: _Den følgende tekst beskriver statistiske repræsentationer relateret til replikation. Størstedelen af navnene på repræsentationer og funktioner blev omdøbt i Postgres 10. Omdøbningerne gik ud på at erstatte xlog og få en fungerende kommando. wal og location og få en fungerende kommando. i navne på funktioner/repræsentationer osv. Et specifikt eksempel, funktionen pg_xlog_location_diff() blev omdøbt til pg_wal_lsn_diff() Her har vi også meget. Men vi skal kun bruge punkterne, der er relateret til placering.._
Hvis vi ser, at alle værdier er ens, så er det den ideelle situation, og replikationen halter ikke bagud i forhold til master.
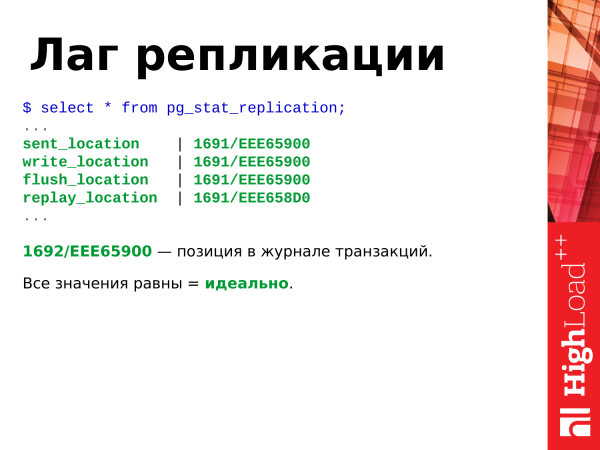
Denne hexadecimale position er positionen i transaktionsloggen. Den stiger konstant, hvis der er nogen aktivitet i databasen: indsættelser, sletninger osv.
hvor meget xlog er skrevet i bytes $ select pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000'); replication lag i bytes $ select client_addr, pg_xlog_location_diff(pg_current_xlog_location(), replay_location) from pg_stat_replication; replication lag i sekunder $ select extract(epoch from now() - pg_last_xact_replay_timestamp());
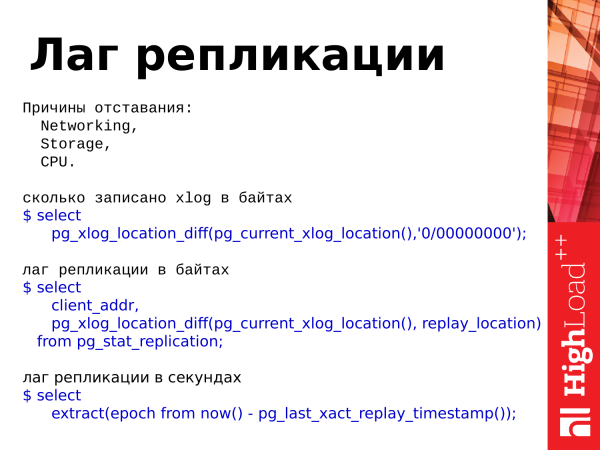
Hvis disse ting adskiller sig, betyder det, at der er et lag. Laget er replikens efterslæb i forhold til master, dvs. dataene adskiller sig mellem serverne.Der er tre årsager til efterslæb:
Det kan være, at disksystemet ikke kan håndtere synkroniseringen af filernes skrivning.
- Der kan være netværksfejl, eller netværket er overbelastet, når dataene ikke kan nå replikken hurtigt nok til at blive gengivet.
- Og CPU'en. CPU'en er en meget sjælden årsag. Jeg har set det ske to eller tre gange, men det kan også ske.
- Og her er tre forespørgsler, der gør det muligt for os at bruge statistikken. Vi kan vurdere, hvor meget der er blevet skrevet til vores transaktionslog. Der er en funktion
pg_xlog_location_diff og vi kan vurdere lagreplikationen i bytes og sekunder. Vi bruger også værdien fra denne repræsentation (VIEWs) til dette. _I stedet for pg_xlog_location
Bemærk: diff() funktionen kan man bruge subtraktionsoperatoren og trække en placering fra en anden. Det er praktisk.Med lagret i sekunder er der én ting at huske. Hvis der ikke sker nogen aktivitet på masteren, var transaktionen der for omkring 15 minutter siden, og der er ingen aktivitet, så hvis vi ser på lagret på replikken, vil vi se et lag på 15 minutter. Dette er vigtigt at huske. Og det kan være forvirrende, når man ser dette lag.
Der er en ting ved lagret i sekunder. Hvis der ikke er nogen aktivitet på masteren, og transaktionen blev udført for omkring 15 minutter siden, vil vi, hvis vi ser på replikaen, bemærke et lag på 15 minutter. Det er noget, man skal huske på. Det kan være forvirrende, når man ser dette lag.
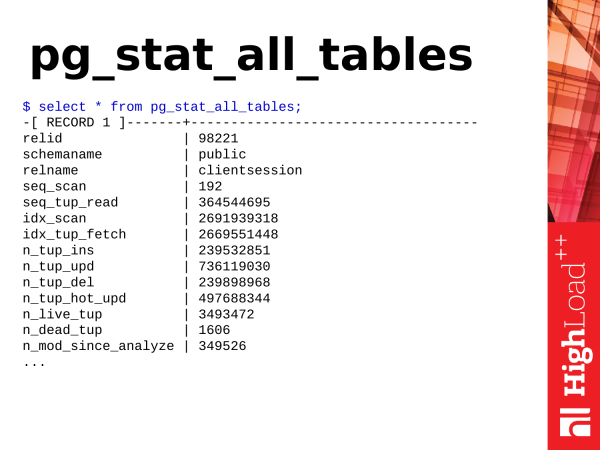
Pg_stat_all_tables – en nyttig visning. Den viser statistik for tabeller. Når vi har tabeller i databasen, og der er aktivitet, kan vi få information om dette fra denne visning.
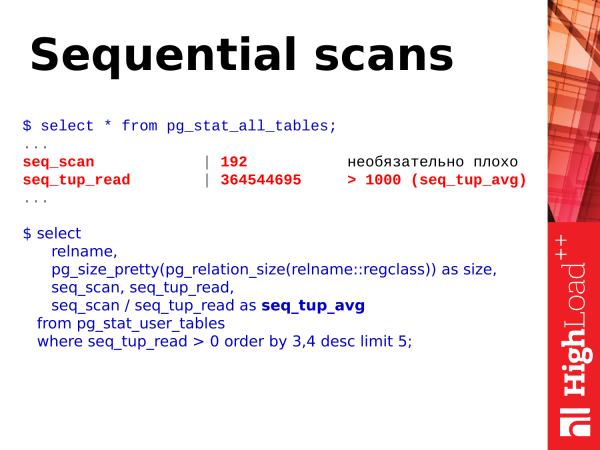
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Det første, vi kan se på, er de sekventielle scanninger for tabellen. Selve tallet efter disse gennemløb er ikke nødvendigvis dårligt og er ikke en indikator på, at vi skal gøre noget.
Der er dog en anden metrik – seq_tup_read. Dette er antallet af rækker, der returneres som resultat af sekventiel scanning. Hvis det gennemsnitlige tal overstiger 1.000, 10.000, 50.000, 100.000, så er det et tegn på, at du måske skal oprette en indeks for at få adgangen til at være indekseret, eller muligvis optimere de forespørgsler, der bruger sådanne sekventielle scanninger, så det ikke sker.
Et enkelt eksempel – lad os sige, at en forespørgsel med et stort OFFSET og LIMIT kører. For eksempel scanner den 100.000 rækker i tabellen, og derefter tages 50.000 nødvendige rækker, mens de tidligere scannede rækker kasseres. Dette er også en dårlig situation. Og sådanne forespørgsler skal optimeres. Og her er en simpel SQL-forespørgsel, hvor man kan se og vurdere de opnåede tal.
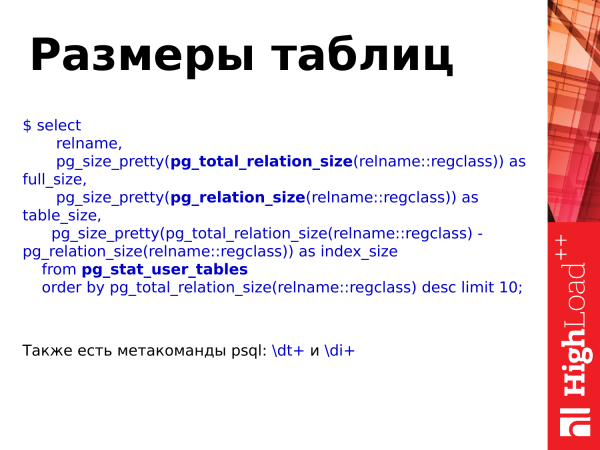
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Størrelsen på tabellerne kan også findes ved hjælp af denne liste og ved hjælp af ekstra funktioner. pg_total_relation_size(), pg_relation_size().
Der findes generelt metakommander dt og di, som kan bruges i PSQL for også at se størrelsen på tabeller og indekser.
Men brugen af funktioner hjælper os med at se størrelsen på tabellerne med eller uden hensyntagen til indekser og allerede gøre nogle vurderinger baseret på væksten i databasen, dvs. hvordan den vokser, med hvilken intensitet og derefter drage nogle konklusioner om optimering af størrelser.
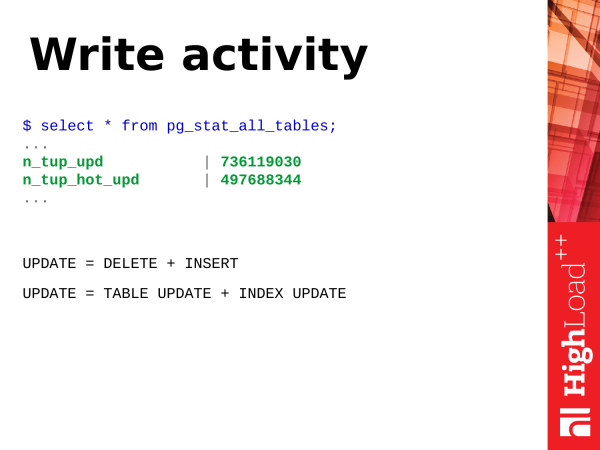
Aktivitet ved skrivning. Hvad er skrivning? Lad os se på operationen. OPDATERING – opdateringsoperationen af rækker i tabellen. I sin essens er update to operationer (eller flere). Det er indsættelse af en ny version af rækken og markering af den gamle version af rækken som forældet. Senere vil autovacuum komme og rydde disse forældede versioner af rækkerne og mærke dette sted som tilgængeligt til genbrug.
Desuden er update ikke kun opdatering af tabellen. Det er også opdatering af indekser. Hvis du har mange indekser på tabellen, skal alle indekser, der involverer felter, der opdateres i forespørgslen, også opdateres. Disse indekser vil også have forældede versioner af rækker, som skal ryddes.
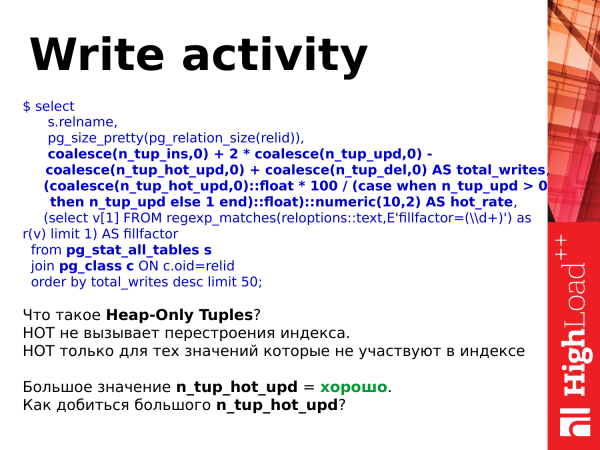
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
Og på grund af designet er UPDATE – tunge operationer. Men de kan lettes. Der er hot updates. De opstod i PostgreSQL version 8.3. Hvad er det? Det er en letvægts update, der ikke forårsager genopbygning af indekserne. Det vil sige, vi opdaterede posten, men kun posten på siden (som tilhører tabellen) blev opdateret, og indeksene henviser stadig til den samme post på siden. Der er en interessant logik i, hvordan det virker; når vacuum kommer, ombygger det disse kæder hot og alt fortsætter med at fungere uden opdatering af indekserne, og det sker med mindre ressourceforbrug.
Og når du har n_tup_hot_upd stort, så er det meget godt. Det betyder, at letvægts updates dominerer, og det er billigere for ressourcerne og fungerer perfekt.
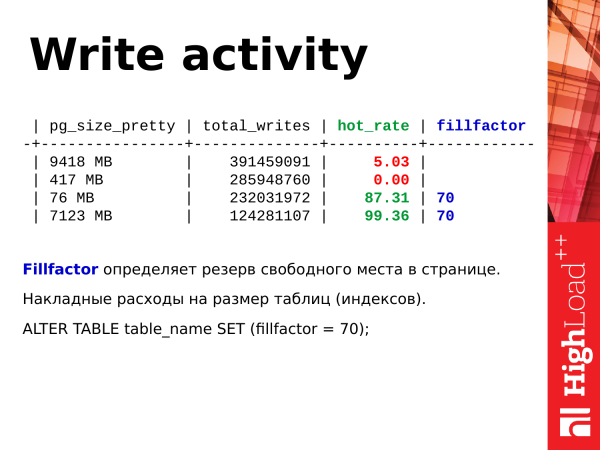
ALTER TABLE table_name SET (fillfactor = 70);Hvordan kan vi øge mængden af hot updates? Vi kan bruge fillfactor. Det bestemmer størrelsen af det reserverede frie plads, når siden i tabellen fyldes med INSERTs. Når der indsættes i tabellen, fylder de helt siden uden at efterlade tomt plads. Derefter allokeres en ny side. Data fyldes igen. Og denne adfærd er standard; fillfactor = 100%.
Vi kan indstille fillfactor til 70 %. Det vil sige, når der indsættes, vil der blive tildelt en ny side, men kun 70 % af siden bliver fyldt ud. De resterende 30 % forbliver som reserve. Når det er nødvendigt at lave en opdatering, vil det højst sandsynligt ske på den samme side, og den nye version af rækken vil blive placeret i den samme side. Der vil blive lavet et hot_update. Dette letter indskrivningen i tabellerne.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
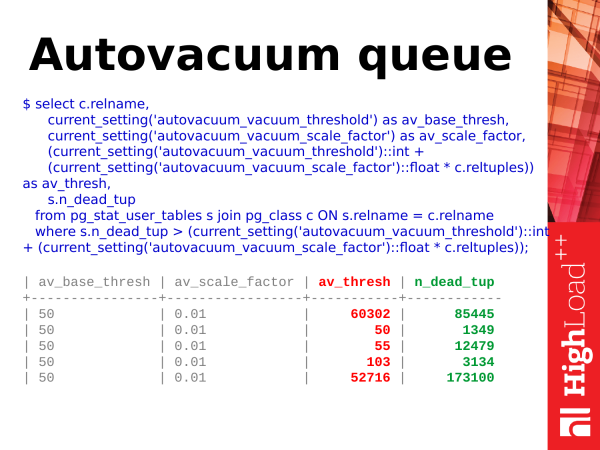
Køen af autovacuum. Autovacuum er et subsystem, hvor statistikken i PostgreSQL er meget sparsom. Vi kan kun i tabellerne i pg_stat_activity se, hvor længe vores vakuumer har varet i øjeblikket. Det er dog meget svært at forstå, hvor mange tabeller der er i hans kø på én gang.
Bemærk: _Siden version 10 af Postgres er situationen med overvågningen af autovacuum blevet meget forbedret — der er kommet en visning pg_stat_progressvacuum, som væsentligt forenkler spørgsmålet om overvågning af autovacuum.
Vi kan bruge en sådan forsimplet forespørgsel. Og vi kan se, hvornår der skal udføres vacuum. Men hvordan og hvornår skal vacuum startes? Det drejer sig om de forældede versioner af rækken, som jeg nævnte tidligere. En opdatering fandt sted, en ny version af rækken blev indsat. En forældet version af rækken dukkede op. I tabellen pg_stat_user_tables er der en parameter n_dead_tup. Den viser antallet af "døde" rækker. Og så snart antallet af døde rækker overstiger en bestemt tærskel, vil autovacuum komme til tabellen.
Og hvordan beregnes denne tærskel? Det er et ganske konkret procentforhold af det samlede antal rækker i tabellen. Der er en parameter autovacuum_vacuum_scale_factor. Den definerer procentforholdet. Antag, 10 % + der er en yderligere basis tærskel på 50 rækker. Hvad bliver resultatet? Når antallet af døde rækker er blevet større end "10 % + 50" af alle rækker i tabellen, sætter vi tabellen på autovacuum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
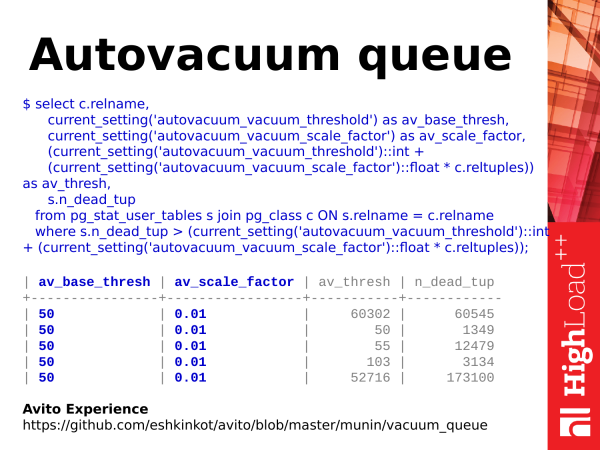
Der er dog et punkt her. Basis tærsklerne for parametrene av_base_thresh og av_scale_factor kan tildeles individuelt. Og derfor vil tærsklen ikke være global, men individuel for tabellen. Derfor skal der anvendes tricks og kneb for at beregne det. Og hvis du er interesseret, kan du se på erfaringerne fra vores kolleger fra Avito (linket på sliden er ugyldigt og opdateret i teksten).
De skrev til , som tager disse ting i betragtning. Der er et dokument på to sider. Men det beregner korrekt og giver en ret effektiv vurdering af, hvor der er behov for meget vakuum til tabellerne, og hvor der er lidt.
Hvad kan vi gøre ved dette? Hvis vi har en stor kø, og autovakuumet ikke kan følge med, kan vi øge antallet af vakuumarbejdere, eller bare gøre vakuumet mere aggressivt, så det trigges tidligere og behandler tabellen i små bidder. Og dermed vil køen blive reduceret. — Det vigtigste her er at overvåge belastningen på diske, da vakuum ikke er gratis, selvom problemet er blevet mindre synligt med fremkomsten af SSD/NVMe enheder.
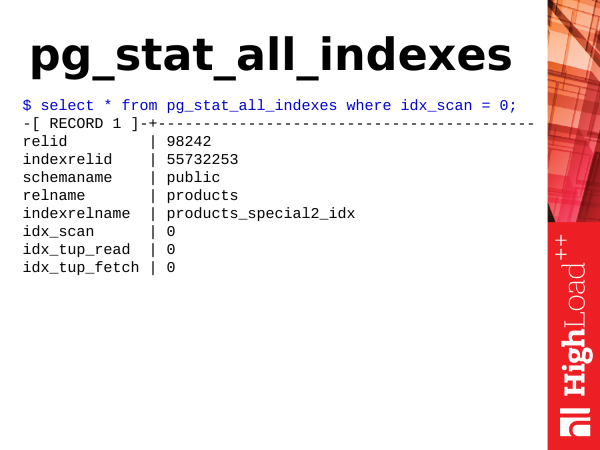
Pg_stat_all_indexes – det er statistikken for indeksene. Den er lille. Og vi kan få information om brugen af indeksene derfra. Og for eksempel kan vi bestemme, hvilke indekser der er overflødige.
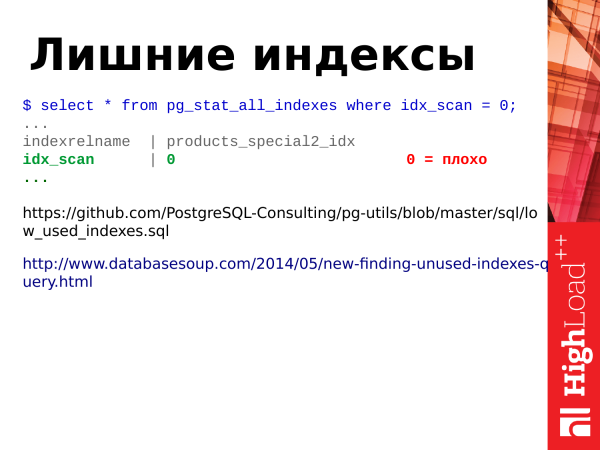
Som jeg allerede har sagt, update – det er ikke kun opdatering af tabeller, det er også opdatering af indekser. Derfor, hvis vi har mange indekser på tabellen, skal indekserne af de indekserede felter også opdateres, når rækkerne i tabellen opdateres, og hvis vi har ubrugte indekser, som der ikke er nogen indeks-scanninger for, så hænger de som ballast. Og vi skal slippe af med dem. Til dette har vi brug for feltet idx_scan. Vi ser bare på antallet af indeks-scanninger. Hvis indekserne har nul scanninger over en relativt lang periode med opbevaring af statistikken (mindst 2-3 uger), er det sandsynligvis dårlige indekser, og vi skal slippe af med dem.
Bemærk: Når vi søger efter ubrugte indekser i tilfælde af klynger med strømreplikering, skal vi kontrollere alle noder i klyngen, da statistikken ikke er global, og hvis indekset ikke bruges på masteren, kan det blive brugt på replikkerne (hvis der er belastning der).
To links:
Dette er mere avancerede eksempler på forespørgsler til, hvordan man søger efter ubrugte indekser.
Det andet link er en ret interessant forespørgsel. Der ligger en meget ikke-trivial logik bag. Jeg anbefaler at se nærmere på det.
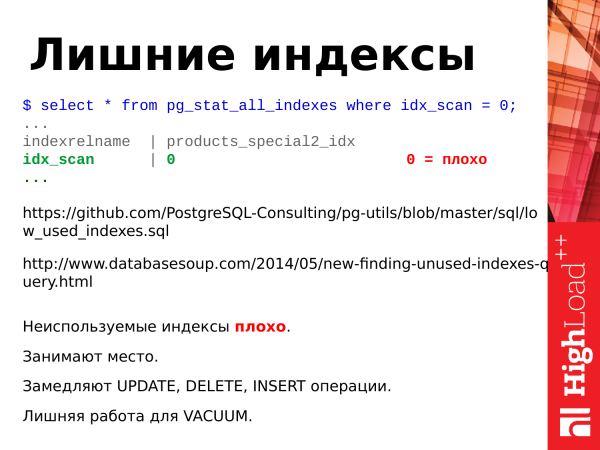
Hvad mere skal opsummeres om indekser?
Ubrugte indekser er dårlige.
De optager plads.
De forsinker opdateringsoperationer.
Det er unødvendigt arbejde for vacuum.
Hvis vi fjerner de ubrugte indekser, vil vi kun forbedre databasen.
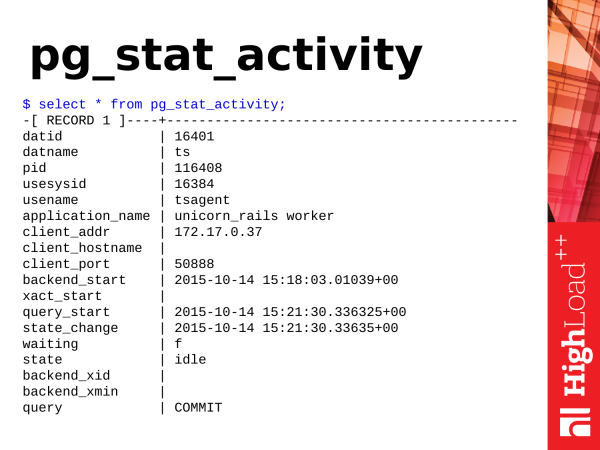
Den næste præsentation er pg_stat_activity. Det er en pendant til værktøjet ps, kun i PostgreSQL. Hvis psdu ser processer i operativsystemet, så pg_stat_activity viser det aktiviteten inden for PostgreSQL.
Hvad kan vi tage med derfra, som er nyttigt?
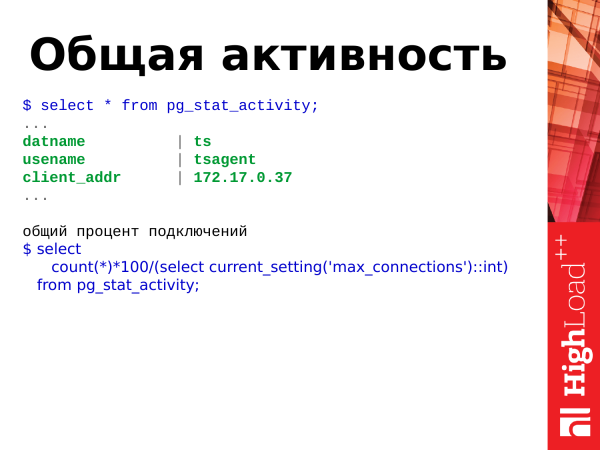
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Vi kan se den samlede aktivitet, hvad der sker i databasen. Vi kan foretage en ny deployment. Det hele er sprunget i luften, nye forbindelser bliver ikke accepteret, fejl vælter ind i applikationen.
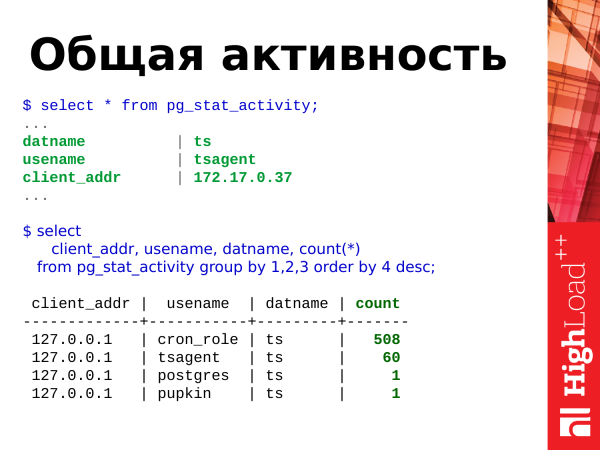
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Vi kan udføre denne forespørgsel og se den samlede procentdel af forbindelser i forhold til det maksimale forbindelseslimit og se, hvem der har flest forbindelser. I dette tilfælde ser vi, at brugeren cron_role har åbnet 508 forbindelser. Og der er sket et eller andet med ham. Vi skal undersøge det og se. Det er meget muligt, at det er et unormalt antal forbindelser.
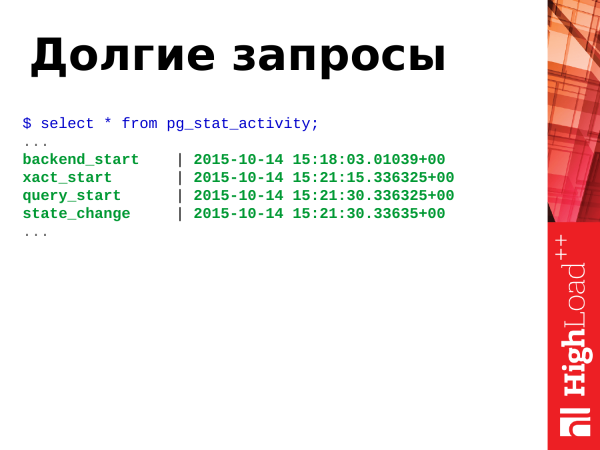
Hvis vi har OLTP-belastning, skal forespørgslerne udføres hurtigt, meget hurtigt, og der må ikke være lange forespørgsler. Men hvis der opstår lange forespørgsler, så er der i det korte løb ikke noget skræmmende, men i det lange løb skader lange forespørgsler databasen, de øger bloat-effekten af tabellerne, når der sker fragmentering af tabellerne. Så vi skal slippe af med både bloat og lange forespørgsler.
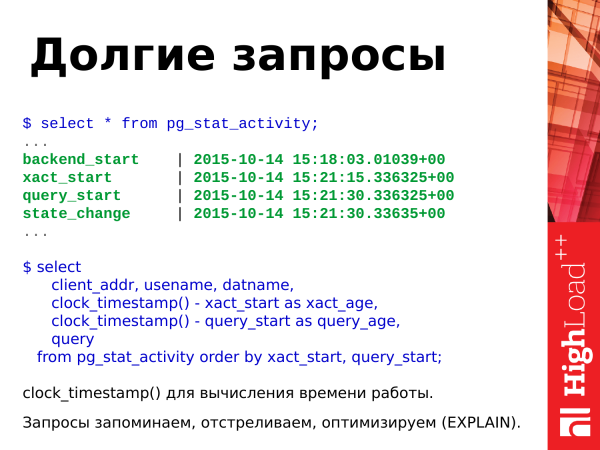
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Bemærk: med denne forespørgsel kan vi identificere lange forespørgsler og transaktioner. Vi bruger funktionen clock_timestamp() til at bestemme varigheden af arbejdet. De lange forespørgsler, vi har fundet, kan vi huske, udføre explain, se planerne og finde måder at optimere dem på. Vi dræber de nuværende lange forespørgsler og fortsætter vores arbejde.
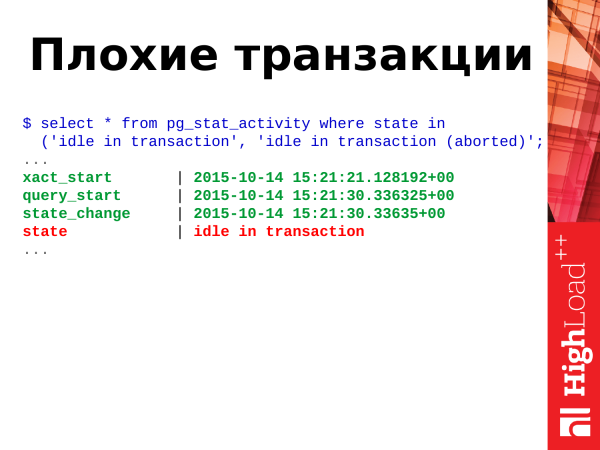
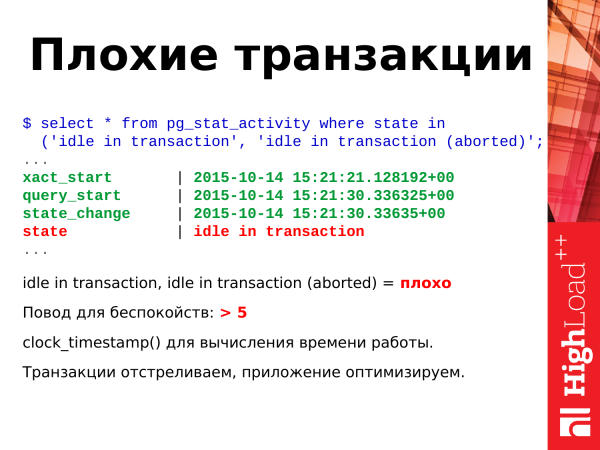
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Dårlige transaktioner er transaktioner i tilstanden idle in transaction og idle in transaction (aborted).
Hvad betyder det? Transaktioner har flere tilstande. Og en af disse tilstande kan indtages på et hvilket som helst tidspunkt. For at definere tilstandene er der et felt state i denne visning. Og vi bruger det til at bestemme tilstanden.
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Og som jeg allerede har sagt, disse to tilstande idle in transaction og idle in transaction (aborted) – dette er problematisk. Hvad er det? Det er, når applikationen har åbnet en transaktion, udført nogle handlinger og derefter fortsat med sine opgaver. Transaktionen forbliver åben. Den hænger, der sker ingenting i den, den optager en forbindelse, låser de ændrede rækker og kan potentielt også øge bloat af andre tabeller på grund af arkitekturen i transaktionsmotoren Postgres. Og sådanne transaktioner bør også annulleres, fordi de er skadelige generelt i enhver sammenhæng.
Hvis du ser, at der er mere end 5-10-20 af dem i din database, så skal du allerede være bekymret og begynde at tage hånd om dem.
Her bruger vi også til beregningstiden clock_timestamp(). Vi annullerer transaktioner, optimerer applikationen.
Som jeg allerede har nævnt, låsninger - det er når to eller flere transaktioner kæmper om en eller en gruppe ressourcer. Til dette har vi et felt waiting med en boolesk værdi true eller false.
True – det betyder, at processen er i venteposition, der skal gøres noget. Når processen er i venteposition, betyder det, at klienten, der initierede denne proces også venter. Klienten sidder i browseren og venter også.
Opmærksomhed: _Fra og med version Postgres 9.6 er feltet waiting fjernet, og i stedet er der tilføjet to mere informative felter wait_event_type og wait_event._
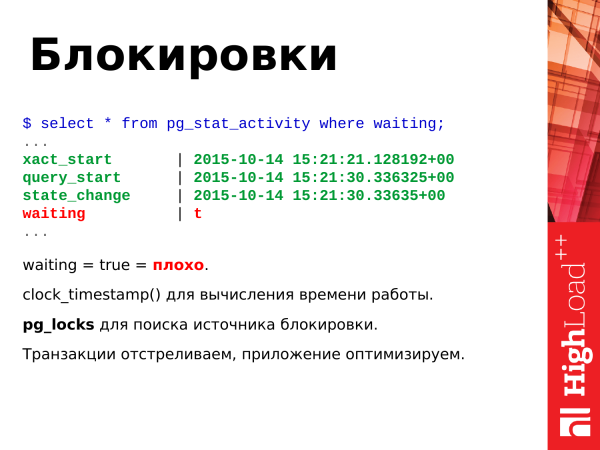
Hvad skal man gøre? Hvis du ser true i lang tid, betyder det, at sådanne forespørgsler skal fjernes. Vi annullerer simpelthen sådanne transaktioner. Vi skriver til udviklerne, at de skal optimere, så der ikke er kapløb om ressourcerne. Og derefter optimerer udviklerne applikationen for at forhindre dette i at ske.
Og den sidste, men potentielt ikke fatale situation – det er opståen af deadlocks. To transaktioner opdaterede to ressourcer og forsøger derefter at få adgang til dem igen, nu til de modsatte ressourcer. PostgreSQL tager i dette tilfælde selv initiativ til at annullere transaktionen, så den anden kan fortsætte arbejdet. Det er en dødfaldssituation, og den løser sig ikke selv. Derfor er PostgreSQL nødt til at tage ekstreme foranstaltninger.
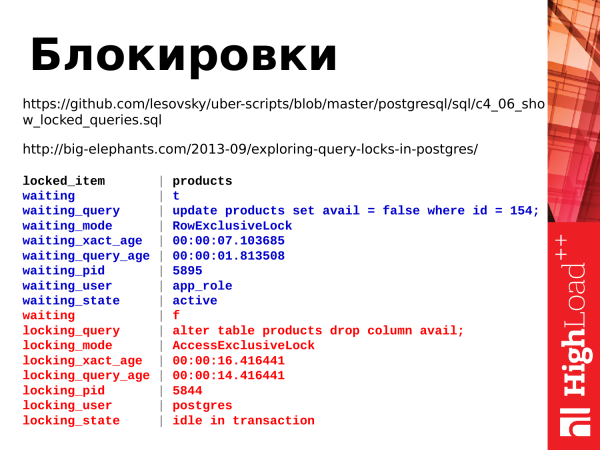
Og her er to forespørgsler, der gør det muligt at overvåge låsninger. Vi bruger visningen pg_locks, som giver mulighed for at spore tunge låsninger.
Og det første link er selve anmodningsteksten. Den er ret lang.
Og det andet link er artiklen om låse. Den er nyttig at læse, den er meget interessant.
Så hvad ser vi? Vi ser to anmodninger. Transaktionen med ALTER TABLE – er en blokerende transaktion. Den startede, men blev ikke afsluttet, og applikationen, der startede denne transaktion, laver andre opgaver et sted. Og den anden anmodning – opdatering. Den venter på, at alter table afsluttes, for at kunne fortsætte sit arbejde.
På denne måde kan vi finde ud af, hvem der har låst hvad, holde øje med det, og vi kan tage det derfra.
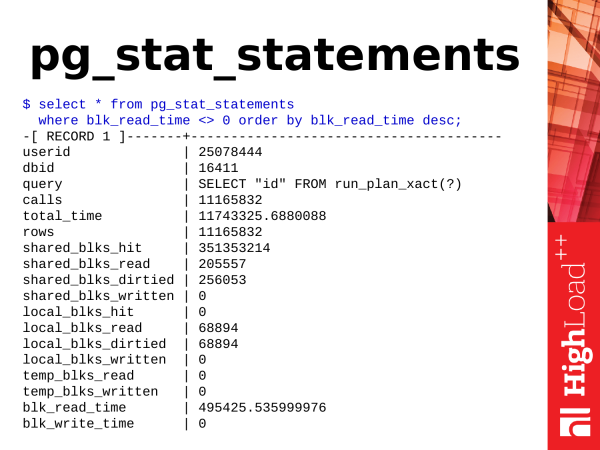
Den næste modul er pg_stat_statements. Som jeg allerede har sagt, er dette en modul. For at bruge den skal biblioteket indlæses i konfigurationen, PostgreSQL genstartes, modulen installeres (med én kommando), og herefter får vi en ny visning.
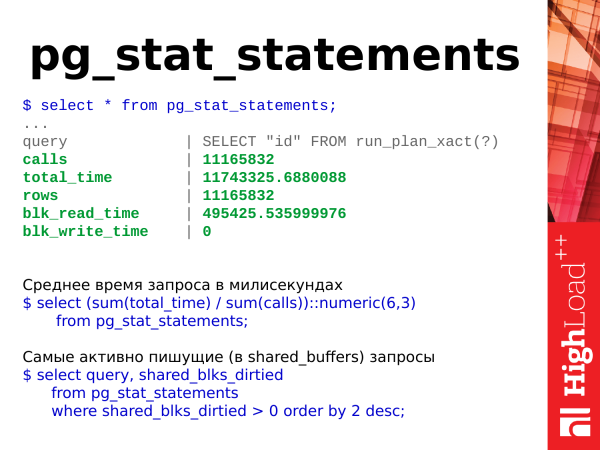
Gennemsnitlig anmodningstid i millisekunder
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

De mest aktive skrivende (i shared_buffers) anmodninger
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Hvad kan vi tage derfra? Hvis vi taler om enkle ting, kan vi tage den gennemsnitlige udførelsestid for anmodningen. Tiden stiger, hvilket betyder, at PostgreSQL reagerer langsomt, og vi skal tage nogle skridt.
Vi kan se på de mest aktive skrivende transaktioner i databasen, der ændrer data i shared buffers. Se, hvem der opdaterer eller sletter data.
Og vi kan simpelthen se på forskellige statistikker for disse anmodninger.
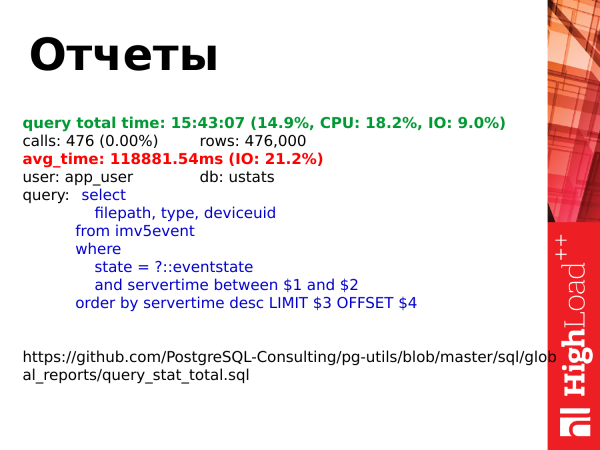
Vi pg_stat_statements bruger vi til at generere rapporter. Vi nulstiller statistikken en gang om dagen. Vi opsamler den. Før nulstillingen af statistikken næste gang, bygger vi rapporten. Her er linket til rapporten. Du kan se den.
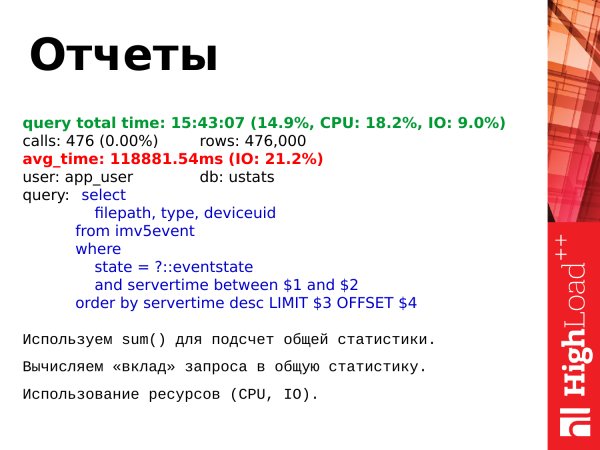
Hvad gør vi? Vi beregner den samlede statistik for alle anmodninger. Derefter beregner vi for hver anmodning dens individuelle bidrag til denne samlede statistik.
Og hvad kan vi se? Vi kan se den samlede udførelsestid for alle anmodninger af en bestemt type i forhold til alle de andre anmodninger. Vi kan se på brugen af CPU-ressourcer og input/output i forhold til det overordnede billede. Og derefter optimere disse anmodninger. Vi bygger topanmodningerne baseret på denne rapport og får fod i tanke om, hvad der skal optimeres.
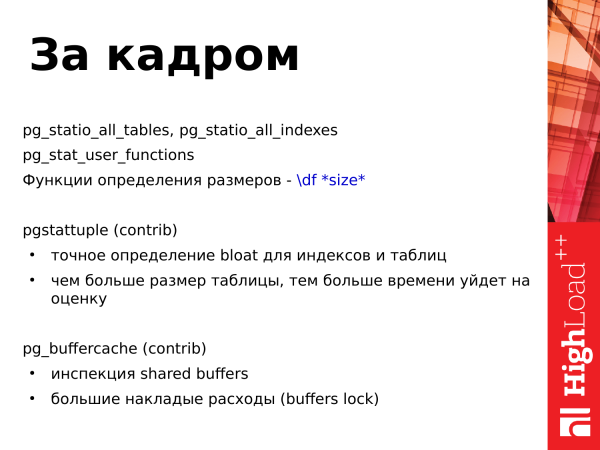
Hvad er der tilbage bag kulisserne? Der er stadig nogle præsentationer, som jeg ikke har taget med, fordi tiden er begrænset.
Der er pgstattuple – dette er også en ekstra modul fra den standard pakke, der hedder contribs. Det giver mulighed for at vurdere bloat tabeller, såkaldt tabelfragmentering. Og hvis fragmenteringen er stor, skal den fjernes, ved at bruge forskellige værktøjer. Og funktionen pgstattuple arbejder længe. Og jo flere tabeller, jo længere tid vil den tage.
Næste contrib – det er pg_buffercache. Det giver mulighed for at inspicere delte buffere: hvor intensivt og til hvilke tabeller siderne i bufferen udnyttes. Og det giver simpelthen mulighed for at kigge ind i de delte buffere og vurdere, hvad der foregår der.
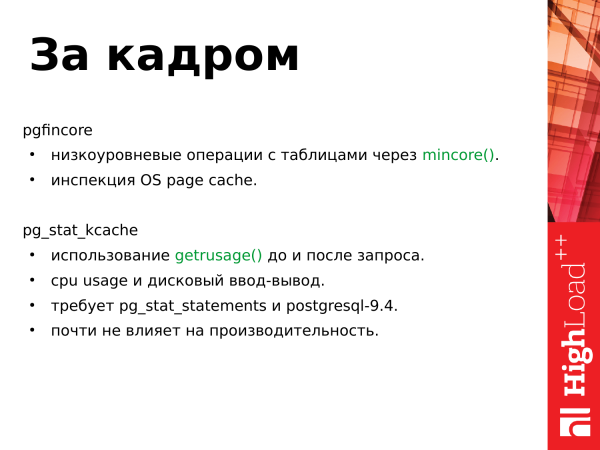
Den næste modul er pgfincore. Det giver mulighed for at udføre lavniveauoperationer med tabeller via systemopkaldet mincore(), d.v.s. det giver mulighed for at indlæse en tabel i de delte buffere, eller at udskille den. Det giver også mulighed for at inspicere sidecachen i operativsystemet, d.v.s. hvor meget plads tabellen optager i page cache, i delte buffere og giver simpelthen mulighed for at vurdere tabelens belastning.
Næste modul – pg_stat_kcache. Det bruger også systemopkaldet getrusage(). Og udfører det før og efter udførelsen af forespørgslen. Og i de opnåede statistikker giver det mulighed for at vurdere, hvor meget vores forespørgsel har anvendt på disk I/O, d.v.s. operationer med filsystemet og ser på processorbrug. Dog er modulet ungt (ahem-ahem) og kræver PostgreSQL 9.4 og pg_stat_statements, som jeg nævnte tidligere.
At kunne bruge statistikken er nyttigt. Du har ikke brug for tredjeparter. Du kan selv kigge ind, se, gøre noget, udføre.
Det er ikke svært at bruge statistikken, det er almindelig SQL. Du har samlet en forespørgsel, sammensat den, sendt den, set.
Statistik hjælper med at besvare spørgsmål. Hvis du har spørgsmål, henviser du til statistikken – ser, drager konklusioner, analyserer resultaterne.
Og eksperimenter. Der er mange forespørgsler, mange data. Man kan altid optimere en eksisterende forespørgsel. Man kan lave sin egen version af en forespørgsel, der passer bedre til ens behov end originalen og bruge den.
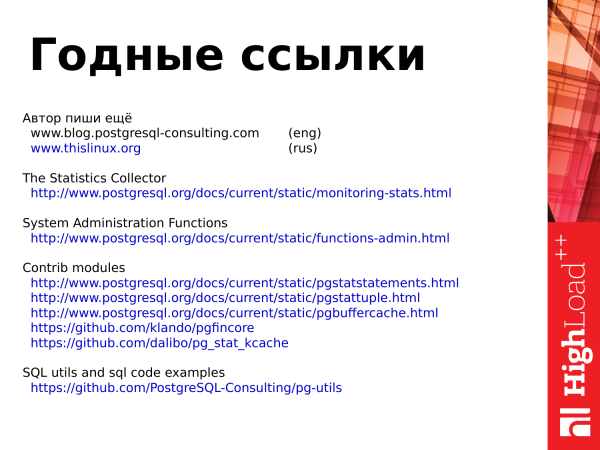
Links
Godt link, som blev nævnt i artiklen, som var grundlaget for rapporten.
Forfatter, skriv mere
(eng)
Statistikindsamleren
Systemadministrationsfunktioner
Contrib-moduler
SQL-værktøjer og SQL-kodeeksempler
Tak for jeres opmærksomhed!
Kilde: habr.com
