

Jeg har altid været nysgerrig efter, hvordan jeg bedre kan organisere bøgerne i mit digitale bibliotek. I sidste ende kom jeg frem til en løsning med automatisk tælling af antal sider og andre smarte funktioner. Jeg beder alle interesserede om at klikke videre.
Del 1. Dropbox
Alle mine bøger ligger på Dropbox. Jeg har inddelt dem i 4 kategorier: Lærebog, Referencemateriale, Skønlitteratur, Faglitteratur. Men jeg tilføjer ikke referencematerialer til tabellen.
Størstedelen af bøgerne er .epub, de resterende er .pdf. Det vil sige, at den endelige løsning skal kunne håndtere begge formater.
Mine stier til bøgerne ser nogenlunde sådanne ud:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Hvis bogen er skønlitterær, fjernes kategorien (det vil sige "Design" i ovenstående tilfælde).
Jeg besluttede ikke at besvære mig med Dropbox API'et, heldigvis har jeg deres app, som synkroniserer mappen. Det vil sige, planen er sådan: vi tager bøgerne fra mappen, kører hver bog gennem en ordtæller og tilføjer den til Notion.
Del 2. Tilføjer række
Selve tabellen skal se omtrent sådan ud. ADVARSEL: Bedst at bruge latinske bogstaver til kolonneoverskrifter.
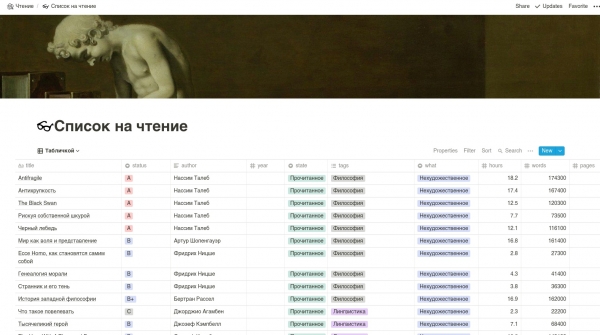
Vi bruger et uofficielt Notion API, fordi det officielle endnu ikke er lanceret.

Vi går ind i Notion, trykker Ctrl + Shift + J, går til Application -> Cookies, kopierer token_v2 og kalder det TOKEN. Derefter går vi til den relevante side med bibliotekstabellen og kopierer linket. Kalder det NOTION.
Så skriver vi koden til at oprette forbindelse til Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Dernæst skriver vi en funktion til at tilføje en række til tabellen.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Skønlitteratur":
            row.author = tags[2]

        elif tags[0] == "Faglitteratur":
            row.tags = tags[2]

        elif tags[0] == "Lærebøger":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Hvad der sker her. Vi tager og tilføjer en ny række til tabellen i den første række. Derefter splitter vi vores sti ved „/“ og får tags. Tags er i forstand som „Skønlitteratur“, „Design“, hvem forfatteren er og så videre. Derefter sætter vi alle de nødvendige felter i tabellen.
Del 3. Tæller ord, timer og andre fordele
Dette er en lidt sværere opgave. Som vi husker, har vi to formater: epub og pdf. Hvis epub-formatet er klart — ordene er sikkert til stede, så er det ikke så entydigt med pdf: det kan bestå af simpelthen sammensatte billeder.
Så funktionen til at tælle ord i pdf vil se sådan ud: vi tager antallet af sider og multiplicerer det med en bestemt konstant (gennemsnitligt antal ord pr. side).
Her er den:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Dette WORDS_PER_PAGE for A4-sider er cirka 300.
Lad os nu skrive en funktion til at tælle siderne. Vi vil bruge .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Dernæst skriver vi en funktion til at tælle sider i epub. Vi bruger . Her tager vi bogen, konverterer den til linjer, og for hver linje tæller vi ordene.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Nu skal vi beregne tiden. Vi tager vores elskede antal ord og dividerer med din læsehastighed.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Del 4. Vi samler alle dele
Vi skal gennemgå alle mulige veje i vores bogmappe. Tjekke, om bogen allerede findes i Notion: hvis ja — så er der ikke behov for at oprette en linje.
Derefter skal vi bestemme filtypen, og afhængigt af dette tælle antallet af ord. Til sidst tilføje bogen.
Her er den kode, vi får:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Og funktionen til at kontrollere, om bogen er tilføjet, ser sådan ud:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Konklusion
Tak for alle, der læste denne artikel. Jeg håber, den vil hjælpe dig med at læse mere 🙂
Kilde: habr.com
