

I takt med lanceringen af det nye kursusforløb har forberedt en oversættelse af interessant materiale.
Oversigt
Vi vil diskutere et ret populært mønster, som applikationer bruger til at håndtere flere datalagre, hvor hver lager anvendes til sine egne mål, for eksempel til opbevaring af den kanoniske dataversion (MySQL osv.), muliggøre avanceret søgning (ElasticSearch osv.), caching (Memcached osv.) og andre formål. Normalt fungerer et af datalagrene som primært lager, mens de andre fungerer som sekundære lagre. Det eneste problem er, hvordan man synkroniserer disse datalagre.
Vi har set på en række forskellige mønstre, der har forsøgt at løse problemet med at synkronisere flere lagre, såsom dobbelt skrivning, distribuerede transaktioner osv. Men disse tilgange har væsentlige begrænsninger med hensyn til praktisk anvendelighed, pålidelighed og vedligeholdelse. Udover datasykronisering skal nogle applikationer også berige data ved at kalde eksterne tjenester.
For at løse disse problemer blev Delta udviklet. Delta er i sidste ende en sammenhængende, begivenhedsstyret platform til synkronisering og berigelse af data.
Eksisterende løsninger
Dobbelt skrivning
For at synkronisere to datalagre kan man bruge dobbelt skrivning, der først skriver til ét lager og derefter straks til det andet. Den første skrivning kan gentages, mens den anden kan afbrydes, hvis den første mislykkes efter at have nået antallet af forsøg. Men de to datalagre kan miste synkroniseringen, hvis skrivningen til det andet lager mislykkes. Dette problem løses normalt ved at oprette en gendannelsesprocedure, der periodisk kan overføre data fra det første lager til det andet eller kun gøre det, hvis der opdages forskelle i dataene.
Problemer:
Udførelsesproceduren for gendannelse er et specifikt arbejde, som ikke kan genbruges. Desuden forbliver dataene mellem lagre desynkroniserede, indtil gendannelsesproceduren er overstået. Problemet forværres, hvis der bruges mere end to datalagre. Endelig kan gendannelsesproceduren tilføre belastning til den oprindelige datakilde.
Ændringslogtabel
Når der sker ændringer i sæt af tabeller (for eksempel indsættelse, opdatering og sletning af poster), tilføjes ændringsposter til ændringslogtabellen som en del af den samme transaktion. En anden tråd eller proces anmoder konstant om begivenheder fra ændringslogtabellen og skriver dem til et eller flere datalagre, og fjerner begivenheder fra ændringslogtabellen efter at alle lagre har bekræftet optegnelsen, hvis det er nødvendigt.
Problemer:
Dette mønster bør implementeres som et bibliotek og ideelt set uden at ændre koden i den anvendelse, der bruger det. I et polyglot-miljø bør implementeringen af et sådant bibliotek eksistere på ethvert nødvendigt sprog, men at sikre konsistens i funktioner og adfærd mellem sprog er meget udfordrende.
Et andet problem ligger i at få ændringer til skemaet i de systemer, der ikke understøtter transaktionelle skemaændringer [1][2], som for eksempel MySQL. Derfor vil mønsteret for at udføre ændringen (for eksempel ændringer til skemaet) og transaktionelt at skrive det til ændringslogtabellen ikke altid fungere.
Fordelte Transaktioner
Fordelte transaktioner kan bruges til at opdele en transaktion mellem flere heterogene datalagre, så operationen enten bekræftes i alle de anvendte lagre eller ikke bekræftes i nogen af dem.
Problemer:
Fordelte transaktioner er et stort problem for heterogene datalagre. De kan i sagens natur kun stole på den mindste fællesnævner blandt de involverede systemer. For eksempel blokerer XA-transaktioner for udførelse, hvis der opstår en fejl i applikationen under forberedelsesfasen. Derudover sikrer XA ikke deadlock-detektering og understøtter ikke optimistiske parallelismehåndteringsskemaer. Desuden understøtter nogle systemer som ElasticSearch ikke XA eller andre heterogene transaktionsmodeller. Derfor er det en betydelig udfordring for applikationer at sikre atomaritet af optegnelser i forskellige datalagertjenester [3].
Delta
Delta blev udviklet for at overvinde begrænsningerne ved eksisterende datasynkroniseringsløsninger, det giver også mulighed for at berige data on-the-fly. Vores mål var at abstrahere alle disse komplekse aspekter væk fra applikationsudviklerne, så de kunne fokusere fuldt ud på implementeringen af forretningsfunktionaliteten. Vi vil nu beskrive "Movie Search", det faktiske anvendelsestilfælde for Delta fra Netflix.
Netflix anvender i vid udstrækning en mikroservice-arkitektur, og hver mikroservice betjener normalt én type data. Grundlæggende oplysninger om film er udraget til en mikroservice kaldet Movie Service, mens relaterede data såsom oplysninger om producenter, skuespillere, leverandører osv. håndteres af flere andre mikroservices (navnlig Deal Service, Talent Service og Vendor Service).
Forretningsbrugere i Netflix Studios har ofte brug for at søge efter film baseret på forskellige kriterier, og derfor er det meget vigtigt for dem at kunne søge i alle data relateret til film.
Før Delta skulle film søgningsteamet hente data fra flere mikroservices, før de kunne indeksere filmdataene. Desuden var teamet nødt til at udvikle et system, der periodisk opdaterede søgeindekset ved at anmode om ændringer fra andre mikroservices, selv hvis der overhovedet ikke var nogen ændringer. Dette system blev hurtigt kompliceret og svært at vedligeholde.
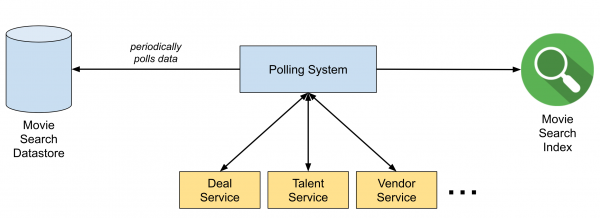
Figur 1. Polling-systemet før Delta
Efter at have taget Delta i brug er systemet blevet forenklet til et begivenhedsstyret system, som vist på følgende figur. CDC-begivenheder (Change-Data-Capture) sendes til Keystone Kafka-emner ved hjælp af Delta-Connector. Delta-applikationen, der er bygget med hjælp fra Delta Stream Processing Framework (baseret på Flink), modtager CDC-begivenheder fra emnet, beriger dem ved at kalde andre mikrotjenester, og sender til sidst de berigede data til søgeindekset i Elasticsearch. Hele processen foregår næsten i realtid, hvilket betyder, at så snart ændringer registreres i datalageret, opdateres søgeindekserne.
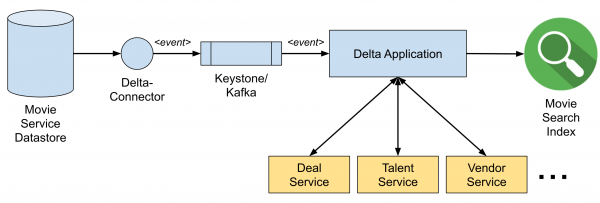
Figur 2. Data pipeline ved brug af Delta
I de følgende sektioner vil vi beskrive, hvordan Delta-Connector fungerer, som forbinder til datalageret og publicerer CDC-begivenheder på transportniveauet, som er infrastrukturen for dataoverførsel i realtid, der dirigerer CDC-begivenheder til Kafka-emner. Til sidst vil vi tale om strukturen for Delta-streambehandling, som applikationsudviklere kan bruge til logik ved behandling og berigelse af data.
CDC (Change-Data-Capture)
Vi har udviklet en CDC-tjeneste kaldet Delta-Connector, som kan registrere committerede ændringer fra datalageret i realtid og skrive dem til strømmen. Ændringer i realtid tages fra transaktionsloggen og lager dumps. Dumps bruges, fordi transaktionslogger normalt ikke gemmer hele ændringshistorikken. Ændringer serialiseres ofte som Delta-begivenheder, så modtageren ikke skal bekymre sig om, hvor ændringen kommer fra.
Delta-Connector understøtter flere ekstra funktioner, såsom:
- Mulighed for at skrive til brugerdefinerede output uden om Kafka.
- Mulighed for at aktivere manuelle dumps når som helst for alle tabeller, en bestemt tabel eller for bestemte primære nøgler.
- Dumps kan hentes i chunks, så der er ikke behov for at starte forfra i tilfælde af fejl.
- Ingen behov for at låse tabeller, hvilket er meget vigtigt for at databaseindtægterne aldrig bliver blokeret af vores tjeneste.
- Høj tilgængelighed på grund af sikkerhedskopierede instanser i AWS Availability Zones.
I øjeblikket understøtter vi MySQL og Postgres, herunder ved implementering i AWS RDS og Aurora. Vi understøtter også Cassandra (multi-master). Du kan finde flere detaljer om Delta-Connector i denne .
Kafka og transportlaget
Transportlaget for Delta-begivenheder er bygget på beskedudvekslingstjenesten i platformen .
Historisk set er publicering af meddelelser i Netflix optimeret med fokus på øget tilgængelighed snarere end holdbarhed (se ). Kompromiset var en potentiel uoverensstemmelse i datalageret i forskellige grænsetilfælde. For eksempel, unclean leader election ansvarlig for, at modtageren potentielt duplikerer eller mister begivenheder.
Med Delta ønskede vi at få mere solide garantier for holdbarhed for at sikre levering af CDC-begivenheder til afledte lagre. Derfor foreslog vi en specielt designet Kafka-klynge som et førsteklasses objekt. Du kan se nogle af brokerindstillingerne i tabellen nedenfor:
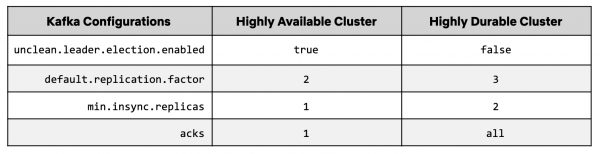
I Keystone Kafka-klynger, unclean leader election er det normalt aktiveret for at sikre publikationens tilgængelighed. Dette kan føre til beskedtab, hvis en usynkroniseret kopi vælges som leder. For en ny, højtilgængelig Kafka-klynge er unclean leader election deaktiveret for at forhindre beskedtab.
Vi har også øget replication factor fra 2 til 3 og minimum insync replicas fra 1 til 2. Udgivere, der skriver til denne klynge, kræver acks fra alle andre, hvilket sikrer, at 2 ud af 3 replikaer har de mest aktuelle meddelelser sendt af udgiveren.
Når en broker-instans afsluttes, bliver en ny instans erstattet den gamle. Den nye broker skal dog indhente de usynkroniserede replikaer, hvilket kan tage flere timer. For at reducere genopretningstiden for dette scenarie er vi begyndt at bruge bloklagring (Amazon Elastic Block Store) i stedet for de lokale diske hos brokerne. Når den nye instans erstatter den afsluttede broker-instans, tilslutter den EBS-volumenet, som den afsluttede instans havde, og begynder at indhente nye beskeder. Denne proces reducerer tid til at afvikle tilbageholdelse fra flere timer til flere minutter, da den nye instans ikke længere behøver at replikere fra en tom tilstand. Generelt mindsker de separate livscyklusser for lager og broker betydeligt indflydelsen af effekten af at skifte broker.
For yderligere at øge garanti for datalevering har vi brugt til at opdage enhver tab af beskeder under ekstreme forhold (f.eks. tidsafvigelse i partitionens leder).
Stream Processing Framework
Behandlingsniveauet i Delta er bygget på Netflix SPaaS-platformen, der integrerer Apache Flink med Netflix-økosystemet. Platformen tilbyder en brugergrænseflade, der styrer implementeringen af Flink-opgaver og orkestreringen af Flink-klynger over vores containerstyringsplatform, Titus. Grænsefladen administrerer også konfigurationerne af opgaverne og giver brugerne mulighed for dynamisk at ændre konfigurationen uden at skulle re-kompilere Flink-opgaverne.
Delta tilbyder et framework til stream processing af data baseret på Flink og SPaaS, der bruger annotationsbaseret DSL (Domain Specific Language) til at abstrahere de tekniske detaljer. For eksempel, for at definere det trin, hvormed hændelser skal beriges ved at kalde eksterne tjenester, skal brugerne skrive følgende DSL, og frameworket vil oprette en model, der vil blive udført af Flink.
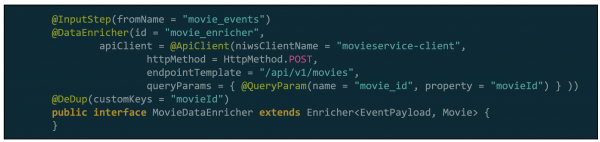
Figur 3. Eksempel på berigelse ved DSL i Delta
Frameworket til behandling reducerer ikke kun læringskurven, men sikrer også fælles funktioner til stream processing som deduplikering, skematisk håndtering samt fleksibilitet og fejltolerance til løsning af almindelige problemer i driften.
Delta Stream Processing Framework består af to nøglemoduler, DSL & API-modulet og Runtime-modulet. DSL & API-modulet tilbyder DSL og UDF (Bruger-Defineret-Funktion) API, så brugerne kan skrive deres egen behandlingslogik (f.eks. filtrering eller transformering). Runtime-modulet leverer en implementering af DSL-parseren, som opbygger en intern repræsentation af behandlingstrinnene i DAG-modeller. Execution-komponenten fortolker DAG-modellerne for at initialisere de faktiske Flink-operatører og til sidst køre Flink-applikationen. Arkitekturen af rammeværket er illustreret i følgende figur.
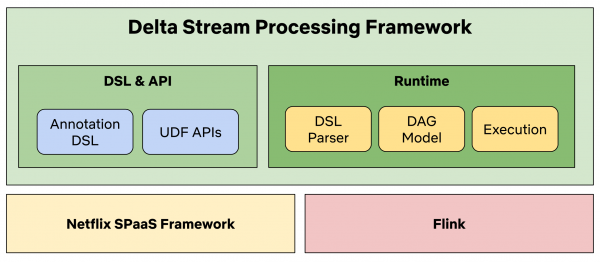
Figur 4. Arkitektur af Delta Stream Processing Framework
Denne tilgang har flere fordele:
- Brugere kan fokusere på deres forretningslogik uden at skulle gå i dybden med Flink-specifikationer eller SPaaS-strukturen.
- Optimering kan udføres på en måde, der er gennemsigtig for brugerne, og fejl kan rettes uden at der er behov for ændringer i brugerens kode (UDF).
- Delta-applikationernes brug er forenklet for brugerne, da platformen tilbyder fleksibilitet og fejltolerance ud af boksen samt indsamler mange detaljerede målinger, der kan bruges til alarmering.
Brug i produktion
Delta har været i produktion i over et år og spiller en nøglerolle i mange applikationer i Netflix Studio. Den har hjulpet teams med at implementere brugssager som søgeindeksering, datalagring og begivenhedsdrevne arbejdsgange. Nedenfor præsenteres en oversigt over den højniveau arkitektur af Delta-platformen.
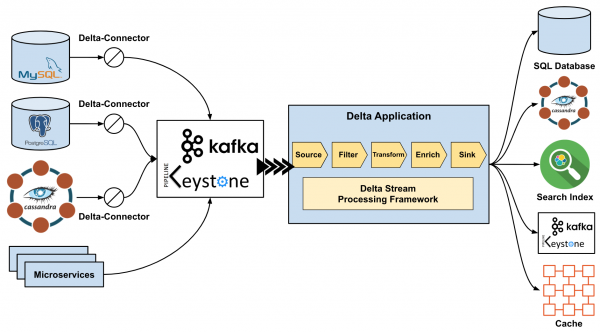
Figur 5. Højniveau arkitektur af Delta.
Taknemmelighed
Vi vil gerne takke følgende personer, der har deltaget i skabelsen og udviklingen af Delta hos Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang og Zhenzhong Xu.
Kilder
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Online eventprocessing. Commun. ACM 62(5): 43–49 (2019). DOI:
: «Data Build Tool til Amazon Redshift-lager».
Kilde: habr.com
