

Del 1: Web / Android
Bemærk: denne artikel er en oversættelse til russisk af den originale artikel Men alle illustrationer, links, citater og termer er bevaret på originalsproget for at undgå forvrængning af betydningen ved oversættelsen til russisk. Jeg ønsker dig en god læsning!
I øjeblikket er specialiteten DevOps en af de mest eftertragtede i IT-industrien. Hvis du åbner populære jobportaler og angiver filtrene for lønninger, vil du se, at stillinger relateret til DevOps ligger i toppen af listen. Men det er vigtigt at forstå, at dette hovedsageligt gælder for 'Senior' stillinger, hvilket indebærer, at kandidaten har et højt færdighedsniveau, kendskab til teknologier og værktøjer. Dette medfører også et højt ansvar for den uafbrudte drift af produktionen. Dog er vi begyndt at glemme, hvad DevOps egentlig er. Oprindeligt var det ikke en specifik person eller afdeling. Hvis man søger efter definitioner på dette udtryk, finder man mange smukke og korrekte substantiver såsom metodologi, praksis, kulturel filosofi, gruppe af koncepter osv.
Min specialisering er QA automatiseringsingeniør, men jeg mener, den ikke kun skal forbindes med at skrive automatetests eller udvikle testframeworks. I 2020 er det også nødvendigt at have kendskab til automatiseringsinfrastruktur. Det gør det muligt at organisere automatiseringsprocessen selvstændigt, fra at køre tests til at give resultaterne til alle interesserede parter i overensstemmelse med de satte mål. Som et resultat heraf er DevOps-færdigheder en afgørende faktor for at udføre dette arbejde. Og alt dette er godt, men desværre er der et problem (spoiler: denne artikel gør forsøg på at forenkle dette problem). Problemet er, at DevOps er kompliceret. Og det er åbenlyst, for virksomhederne vil ikke betale meget for noget, der er let at gøre… I DevOps-verdenen er der et væld af værktøjer, termer og praksisser, man skal mestre. Især er dette vanskeligt i starten af karrieren og afhænger af den akkumulerede tekniske erfaring.
Kilde:
Her vil vi nok afslutte introduktionen og fokusere på formålet med denne artikel.
Hvad handler denne artikel om
I denne artikel vil jeg dele min erfaring med at opbygge en infrastruktur til automatisering af test. Der er mange kilder til information online om forskellige værktøjer og hvordan man bruger dem, men jeg vil fokusere udelukkende på dem i konteksten af automatisering. Jeg tror, at mange automatiseringsingeniører kender til situationen, hvor de udviklede tests, udover dem selv, ikke bliver kørt eller vedligeholdt. Derfor bliver testene forældede, og det kræver tid at opdatere dem. I starten af karrieren kan det være en ret udfordrende opgave at beslutte, hvilke værktøjer der skal hjælpe med at løse dette problem, hvordan man vælger, konfigurerer og vedligeholder dem. Nogle testere henvender sig til DevOps (folk), og lad os være ærlige, denne tilgang fungerer. I mange tilfælde kan det være den eneste mulighed, da vi ikke har overblik over alle afhængigheder. Men som vi ved, er DevOps meget travle mennesker, da de skal tænke på hele virksomhedens infrastruktur, deployment, overvågning, mikrotjenester og andre lignende opgaver afhængigt af organisationen/teamet. Som det ofte er, er automatisering ikke en prioritet. I så fald skal vi forsøge at gøre alt, hvad vi kan fra start til slut. Dette vil reducere afhængigheder, fremskynde arbejdsprocessen, forbedre vores færdigheder og give os et bredere perspektiv på, hvad der foregår.
Artiklen præsenterer de mest eftertragtede og populære værktøjer og viser, hvordan de kan bruges til trin-for-trin opbygning af en automatiseringsinfrastruktur. Hver gruppe er præsenteret med værktøjer, som jeg har testet på egen hånd. Men det betyder ikke, at du skal bruge præcis de samme. Selve værktøjerne er ikke vigtige; de dukker op og bliver forældede. Vores ingeniøropgave er at forstå de grundlæggende principper: hvorfor vi har brug for denne gruppe værktøjer, og hvilke arbejdsopgaver vi kan løse ved hjælp af dem. Derfor efterlader jeg i slutningen af hver sektion links til tilsvarende værktøjer, som muligvis anvendes i din organisation.
Hvad der ikke er i denne artikel
Jeg vil igen understrege, at artiklen ikke handler om specifikke værktøjer, så der vil ikke være nogle kodeeksempler fra dokumentationen eller beskrivelser af specifikke kommandoer. Men i slutningen af hver sektion efterlader jeg links til grundig undersøgelse.
Dette er gjort af følgende årsager:
- materialet er meget let at finde i forskellige kilder (dokumentation, bøger, videokurser);
- hvis vi begynder at gå i dybden, skal vi skrive 10, 20, 30 dele af denne artikel (mens planen er at have 2-3);
- jeg vil blot ikke spilde din tid, da du måske ønsker at bruge andre værktøjer til at opnå de samme mål.
Praktik
Jeg ville virkelig ønske, at dette materiale ville være nyttigt for hver læser og ikke bare blive læst og glemt. I enhver læring er praksis en meget vigtig komponent. Derfor har jeg forberedt. Du vil også få hjemmeopgaver for at sikre, at du ikke blindt har kopieret linjerne med udførte kommandoer.
Plan
Trin
Teknologi
Tools
1
Lokal kørsel (forbered web / android demo tests og kør dem lokalt)
Node.js, Selenium, Appium
2
Versionskontrolsystemer
Git
3
Containerisering
Docker, Selenium grid, Selenoid (Web, Android)
4
CI / CD
Gitlab CI
5
Cloud-platforme
Google Cloud Platform
6
Orkestrering
Kubernetes
7
Infrastruktur som kode (IaC)
Terraform, Ansible
Strukturen for hver sektion
For at opretholde fortællingen i en visuel form, er hver sektion beskrevet efter følgende plan:
- kort beskrivelse af teknologien,
- værdi for automatiseringsinfrastrukturen,
- illustration af den nuværende tilstand af infrastrukturen,
- links til studier,
- lignende værktøjer.
1. Lokal kørsel af tests
Kort beskrivelse af teknologien
Dette er blot et forberedende skridt til at køre demonstrations tests lokalt og for at kontrollere, at de lykkes. I den praktiske del anvendes Node.js, men programmeringssproget og platformen er også uvæsentlige, og man kan bruge dem, der bruges i din virksomhed.
Dog anbefaler jeg at bruge Selenium WebDriver som automatiseringsværktøj til webplatforme og Appium til Android-platformen henholdsvis, da vi i de følgende trin vil bruge Docker-billeder, der er skræddersyet til at arbejde specifikt med disse værktøjer. Desuden, ifølge kravene i jobopslag, er disse værktøjer de mest efterspurgte på markedet.
Som du måske har bemærket, betragter vi kun web- og Android-tests. Desværre er iOS en helt anden historie (tak til Apple). Jeg planlægger at demonstrere løsninger og praksis relateret til iOS i de kommende dele.
Værdi for automatiseringsinfrastruktur
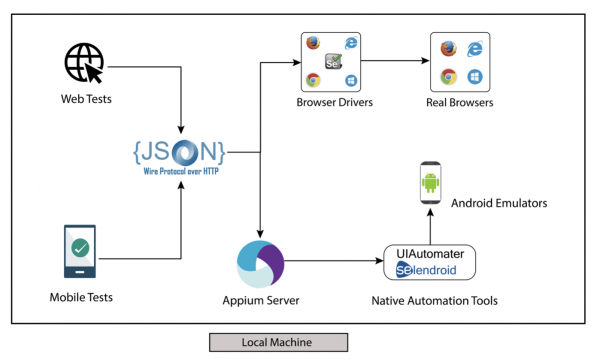
Set fra infrastrukturens synspunkt giver lokal kørsel ingen værdi. Du tjekker kun, at testene fungerer på din lokale maskine i lokale browsere og simulatorer. Men under alle omstændigheder er det et nødvendigt udgangspunkt.
Illustration af den nuværende tilstand af infrastrukturen
Links til undersøgelse
Analoge værktøjer
- hvilket som helst programmeringssprog, du ønsker, sammen med Selenium/Appium - tests;
- enhver test;
- hvilken som helst test-runner.
2. Versionskontrolsystemer (Git)
Kort beskrivelse af teknologien
Det vil ikke komme som en stor overraskelse for nogen, hvis jeg siger, at et versionskontrolsystem er en ekstremt vigtig del af udviklingen både i team og individuelt. Baseret på forskellige kilder kan man med sikkerhed sige, at Git er den mest populære repræsentant. Versionskontrolsystemet giver mange fordele, såsom deling af kode, lagring af versioner, gendannelse til tidligere grene, overvågning af projektets historie, backups. Vi vil ikke diskutere hvert punkt i detaljer, da jeg er sikker på, at du allerede er bekendt med dette og bruger det i dit daglige arbejde. Men hvis du ikke er, anbefaler jeg at stoppe med at læse denne artikel og hurtigt få efterrettet dette hul.
Værdi for automatiseringsinfrastruktur
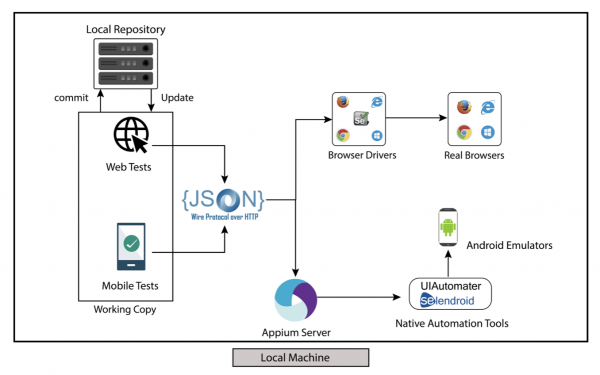
Og her kan du stille et rimeligt spørgsmål: "Hvorfor fortæller han os om Git? Alle kender det og bruger det både til kodeudvikling og autoscripts." Du vil have helt ret, men i denne artikel taler vi om infrastruktur, og denne sektion fungerer som en introduktion til sektion 7: "Infrastruktur som kode (IaC)". For os betyder det, at hele infrastrukturen, inklusive testinfrastrukturen, beskrives i kode, hvilket betyder, at vi også kan anvende versionskontrolsystemer på den og opnå lignende fordele som for kodeudvikling og automatisering.
Vi vil se nærmere på IaC i trin 7, men allerede nu kan du begynde at bruge Git lokalt ved at oprette et lokalt repository. Det samlede billede vil blive udvidet, når vi tilføjer et fjernrepository til infrastrukturen.
Illustration af den nuværende tilstand af infrastrukturen
Links til undersøgelse
Analoge værktøjer
3. Containerisering (Docker)
Kort beskrivelse af teknologien
For at demonstrere, hvordan containerisering har ændret spillet, lad os tage et par årtier tilbage i tiden. Dengang købte og brugte folk servermaskiner til at køre applikationer. Men i de fleste tilfælde var de nødvendige ressourcer til at køre dem ikke kendt på forhånd. Som et resultat brugte virksomheder penge på at købe dyre, kraftige servere, men en del af disse ressourcer blev ikke fuldt udnyttet.
Det næste skridt i evolutionen var virtuelle maskiner (VM), som løste problemet med spildte ressourcer. Denne teknologi gjorde det muligt at køre applikationer uafhængigt af hinanden på en enkelt server og skabte et fuldstændigt isoleret rum. Men desværre har al teknologi sine ulemper. At køre VM kræver et fuldt operativsystem, som bruger CPU, RAM, lager og, afhængigt af operativsystemet, skal man tage højde for licensomkostninger. Disse faktorer påvirker opstartstiden og komplicerer portabiliteten.
Og så er vi nået til containerisering. Igen løser denne teknologi det tidligere problem, da containere ikke bruger et fuldt operativsystem, hvilket frigiver en stor mængde ressourcer og giver en hurtig og fleksibel løsning til portabilitet.
Selvfølgelig er containeriseringsteknologien ikke noget nyt og blev først præsenteret i slutningen af 1970'erne. I de dage blev der lavet meget forskning, udvikling og forsøg. Men det var netop Docker, der tilpassede denne teknologi og gjorde den let tilgængelig for masserne. I dag, når vi taler om containere, mener vi i de fleste tilfælde Docker. Når vi taler om Docker-containere, refererer vi til Linux-containere. Vi kan bruge Windows og macOS-systemer til at køre containere, men det er vigtigt at forstå, at der så opstår et ekstra lag. For eksempel kører Docker på Mac usynligt containere inden i en letvægtig Linux VM. Vi vender tilbage til dette emne, når vi diskuterer kørsel af Android-emulatorer i containere, da der her opstår en meget vigtig nuance, som vi skal uddybe nærmere.
Værdi for automatiseringsinfrastruktur
Vi har konkluderet, at containerisering og Docker er fantastisk. Lad os se på det i en automatiseringskontekst, da hvert værktøj eller teknologi skal løse et eller andet problem. Lad os fremhæve de åbenlyse problemer med automatisering af test i konteksten af UI-tests:
- et stort antal afhængigheder ved installation af Selenium og især Appium;
- kompatibilitetsproblemer mellem versioner af browsere, simulatorer og drivere;
- mangel på isolerede rum til browsere/simulatorer, hvilket er særligt kritisk for parallel kørsel;
- det er svært at administrere og vedligeholde, hvis man skal køre 10, 50, 100 eller endda 1000 browsere samtidigt.
Men eftersom Selenium er det mest populære automatiseringsværktøj, og Docker er det mest populære containeriseringsværktøj, skulle det ikke komme som en overraskelse, at nogen har forsøgt at kombinere dem for at få et kraftfuldt værktøj til løsning af de nævnte problemer. Lad os se nærmere på sådanne løsninger.
Selenium grid i Docker
Dette værktøj er det mest populære i verden til at køre flere browsere på flere maskiner og styre dem fra et centralt hub. For at starte skal der registreres mindst 2 dele: Hub og Node(r). Hub er det centrale punkt, der modtager alle anmodninger fra testene og fordeler dem til de relevante Nodes. For hver Node kan vi konfigurere specifikke indstillinger, for eksempel ved at angive den ønskede browser og dens version. Men vi skal stadig sørge for kompabilitetsdrivere til browsere og installere dem på de relevante Nodes. Af denne grund anvendes Selenium grid ikke i sin reneste form, medmindre vi har brug for at arbejde med browsere, der ikke kan installeres på Linux OS. I alle andre tilfælde vil det være meget mere fleksibelt og korrekt at bruge Docker-images til at køre Selenium grid Hub og Nodes. Denne tilgang forenkler styringen af noderne betydeligt, da vi kan vælge det image, vi har brug for, med allerede installerede kompatible versioner af browsere og drivere.
På trods af negative anmeldelser om stabiliteten, især når man kører et stort antal Nodes parallelt, forbliver Selenium grid stadig det mest populære værktøj til parallelt at køre Selenium-test. Det er vigtigt at bemærke, at der konstant kommer forskellige forbedringer og modifikationer af dette værktøj i open-source, som adresserer forskellige flaskehalse.
Selenoid til Web
Dette værktøj er et gennembrud i Selenium-verdenen, da det fungerer lige ud af boksen og har gjort livet meget lettere for mange automatiseringsingeniører. Først og fremmest er det ikke endnu en modifikation af Selenium grid. I stedet har udviklerne skabt en helt ny version af Selenium Hub i Golang, hvilket sammen med letvægts Docker-billeder til forskellige browsere har givet et boost til udviklingen af automatiseringstestning. Desuden skal vi i tilfælde af Selenium Grid definere alle nødvendige browsere og deres versioner på forhånd, hvilket ikke er et problem, når man kun arbejder med én browser. Men når der er tale om flere understøttede browsere, er Selenoid den bedste løsning takket være funktionen 'browser on demand'. Alt, hvad vi skal gøre, er at uploade de nødvendige billeder med browsere på forhånd og opdatere konfigurationsfilen, som Selenoid interagerer med. Når Selenoid modtager en anmodning fra testene, starter den automatisk den nødvendige container med den ønskede browser. Når testen er afsluttet, stopper Selenoid containeren, hvilket frigør ressourcer til de næste anmodninger. Denne tilgang fjerner fuldstændigt det velkendte problem med 'nodenedbrydning', som vi ofte oplever i Selenium grid.
Men desværre er Selenoid stadig ikke en sølvkugle. Vi har fået funktionen 'browser on demand', men funktionen 'ressourcer on demand' er stadig ikke tilgængelig. For at bruge Selenoid skal vi implementere det på fysisk hardware eller på en VM, hvilket betyder, at vi skal vide på forhånd, hvor mange ressourcer der skal tildeles. Jeg mener, det er ikke et problem for små projekter, der kører 10, 20 eller endda 30 browsere parallelt. Men hvad hvis vi har brug for 100, 500, 1000 eller flere? Det giver ikke mening konstant at opretholde og betale for så mange ressourcer. I afsnit 5 og 6 i denne artikel vil vi diskutere løsninger, som muliggør skalering, hvilket i høj grad reducerer virksomhedens omkostninger.
Selenoid til Android
Efter succesen med Selenoid som et værktøj til webautomatisering ønskede folk noget lignende til Android. Og det er sket – Selenoid er blevet frigivet med support til Android. Fra et højt niveau er principperne for drift sammenlignelige med webautomatisering. Den eneste forskel er, at Selenoid i stedet for browsercontainere starter containere med Android-emulatorer. Efter min mening er dette i øjeblikket det mest kraftfulde gratis værktøj til at køre Android-tests parallelt.
Jeg ville helst ikke tale om de negative sider ved dette værktøj, da jeg virkelig holder meget af det. Men der er dog de samme ulemper her, som også gælder for webautomatisering, relateret til skalering. Derudover skal jeg nævne en anden begrænsning, som kan komme som en overraskelse, hvis vi konfigurerer værktøjet for første gang. For at køre Android-billeder har vi brug for en fysisk maskine eller VM med nested virtualisation-support. I den praktiske vejledning viser jeg, hvordan man aktiverer dette på en Linux VM. Men hvis du er macOS-bruger og ønsker at implementere Selenoid lokalt, vil det være umuligt at køre Android-tests. Men du kan altid køre en Linux VM lokalt med konfigureret 'nested virtualisation' og implementere Selenoid indeni.
Illustration af den nuværende tilstand af infrastrukturen
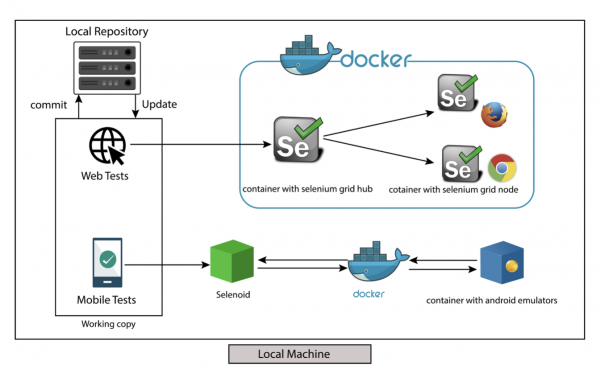
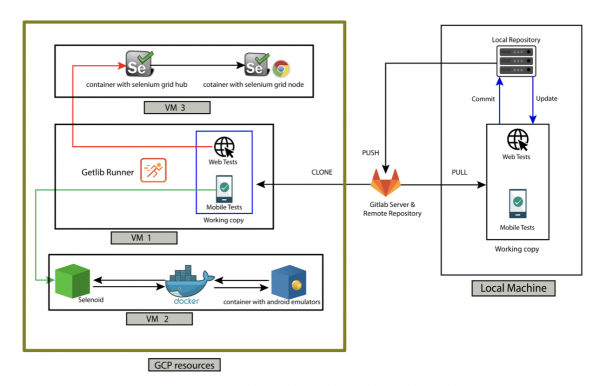
I denne artikels sammenhæng vil vi tilføje 2 værktøjer til illustration af infrastrukturen. Det er Selenium grid til web-tests og Selenoid til Android-tests. I vejledningen på GitHub viser jeg også, hvordan man bruger Selenoid til at køre web-tests.
Links til undersøgelse
Analoge værktøjer
- Der findes andre containeriseringsværktøjer, men Docker er det mest populære. Hvis du vil prøve noget andet, så husk at de værktøjer, vi har set på til parallelt at køre Selenium-tests, ikke vil fungere out of the box.
- Som nævnt er der mange modifikationer af Selenium grid, for eksempel.
4. CI / CD
Kort beskrivelse af teknologien
Praksis med kontinuerlig integration er ganske populær inden for udvikling og står i samme række som versionskontrolsystemer. På trods af dette føler jeg, at der er forvirring omkring terminologien. I dette afsnit vil jeg gerne beskrive tre variationer af denne teknologi efter min mening. Du kan finde mange artikler på internettet med forskellige fortolkninger, og det er helt i orden, hvis din mening adskiller sig. Det vigtigste er, at du er på samme side som dine kolleger.
Så der findes tre termer: CI – Continuous Integration (kontinuerlig integration), CD – Continuous Delivery (kontinuerlig levering) og igen CD – Continuous Deployment (kontinuerlig implementering). (Jeg vil fremover bruge disse termer på engelsk). Hver variant tilføjer flere ekstra trin til din udviklingspipeline. Men ordet continuous (kontinuerlig) er det vigtigste. I denne sammenhæng refererer vi til noget, der sker fra start til slut, uden afbrydelser eller manuel indgriben. Lad os se på CI & CD og CD i denne kontekst.
- Continuous Integration – det er det første skridt i evolutionen. Efter at have sendt ny kode til serveren, forventer vi at få hurtig feedback om, at der ikke er noget galt med vores ændringer. Normalt inkluderer CI kørsel af værktøjer til statisk kodeanalyse og modulære/intern API-test. Dette giver os information om vores kode allerede få sekunder/minutter senere.
- Continuous Delivery er et mere avanceret skridt, hvor vi kører integrations/UI-tests. Men på dette stadium får vi ikke resultaterne så hurtigt som med CI. For det første kræver disse typer tests mere tid at gennemføre. For det andet skal vi have implementeret vores ændringer i test/staging-miljøet, før vi kan køre dem. Desuden, hvis vi taler om mobiludvikling, er der et ekstra trin til opbygning af vores app.
- Continuous Deployment det indebærer, at vi automatisk frigiver (release) vores ændringer til produktion, hvis alle accepttestene er bestået i de tidligere trin. Derudover kan der efter frigivelsestrinnet konfigureres forskellige trin, såsom kørslen af smoke-tests i produktion og indsamling af relevante målinger. Continuous Deployment er kun muligt ved god dækning af automatiserede tests. Hvis der kræves manuel indgriben, herunder test, så er det ikke længere Continuous (kontinuerlig). Så kan vi sige, at vores pipeline kun overholder praksis for Continuous Delivery.
Værdi for automatiseringsinfrastruktur
I dette afsnit skal jeg præcisere, at når vi taler om end-to-end UI-tests, betyder det, at vi skal implementere vores ændringer og relaterede tjenester på testmiljøer. Continuous Integration-processen er ikke anvendelig til denne opgave, og vi skal sikre os, at vi implementerer mindst Continuous Delivery-praksis. Continuous Deployment giver også mening i konteksten af UI-tests, hvis vi planlægger at køre dem i produktion.
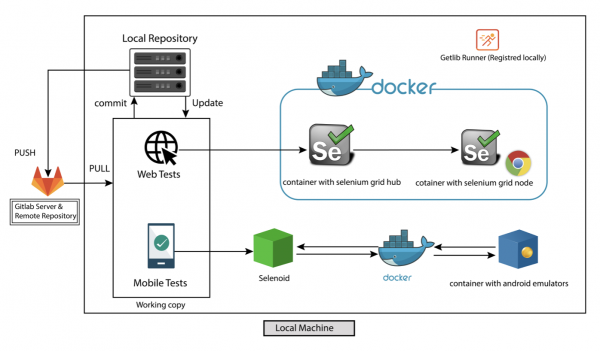
Og før vi ser på illustrationen af ændringen i arkitekturen, vil jeg sige et par ord om GitLab CI. I modsætning til andre CI/CD-værktøjer tilbyder GitLab et fjernlager og mange andre ekstra funktioner. Således er GitLab mere end CI. Det inkluderer indbygget håndtering af kildekode, Agile styring, CI/CD-pipelines, loggingsværktøjer og indsamling af målinger. GitLab-arkitekturen består af GitLab CI/CD og GitLab Runner. Her er en kort beskrivelse fra den officielle hjemmeside:
GitLab CI/CD er en webapplikation med et API, der gemmer sin tilstand i en database, administrerer projekter/builds og tilbyder en brugergrænseflade. GitLab Runner er en applikation, der behandler builds. Den kan implementeres separat og arbejder med GitLab CI/CD gennem et API. For at køre tests har du brug for både GitLab-instansen og Runner.
Illustration af den nuværende tilstand af infrastrukturen
Links til undersøgelse
Analoge værktøjer
- og mange andre
5. Cloud-platforme
Kort beskrivelse af teknologien
I dette afsnit vil vi tale om den populære trend kaldet 'offentlige skyer'. På trods af de enorme fordele, som de førnævnte virtualiseringsteknologier og containerisering giver, har vi stadig brug for beregningsressourcer. Virksomheder køber dyre servere eller lejer datacentre, men i sådanne tilfælde er det nødvendigt at lave beregninger (some gange urealistiske) for hvor mange ressourcer vi har brug for, om vi vil bruge dem 24/7, og til hvilke formål. For eksempel kræver produktion en server, der fungerer døgnet rundt, men har vi brug for tilsvarende ressourcer til test i ikke-arbejdstid? Dette afhænger også af typen af udført test. Et eksempel kunne være belastnings-/stress-test, som vi planlægger at køre i ikke-arbejdstimer for at få resultater til næste dag. Men bestemt, døgnet-rundt tilgængelighed af servere er ikke nødvendig for end-to-end auto-test og især ikke for håndtestmiljøer. For sådanne situationer ville det være godt at få så mange ressourcer, som nødvendigt på forespørgsel, bruge dem, og stoppe med at betale, når de ikke længere er nødvendige. Desuden ville det være fantastisk at få dem øjeblikkeligt ved at lave et par klik med musen eller køre et par scripts. Dette er, hvad offentlige skyer bruges til. Lad os se på definitionen:
«Den offentlige sky defineres som computertjenester, der tilbydes af tredjepartsudbydere over det offentlige internet, hvilket gør dem tilgængelige for enhver, der ønsker at bruge eller købe dem. De kan være gratis eller sælges on-demand, hvilket gør det muligt for kunderne at betale kun for den brug af CPU-cyklusser, lagerplads eller båndbredde, de forbruger».
Der er en opfattelse af, at offentlige skyer er dyre. Men deres nøgleidé er at reducere virksomhedens omkostninger. Som nævnt tidligere giver offentlige skyer mulighed for at få ressourcer on-demand og betale kun for den tid, de bruges. Nogle gange glemmer vi også, at medarbejdere får løn, og specialister er også en dyr ressource. Det er vigtigt at tage højde for, at offentlige skyer betydeligt letter vedligeholdelsen af infrastrukturen, hvilket gør det muligt for ingeniører at fokusere på mere vigtige opgaver.
Værdi for automatiseringsinfrastruktur
Hvilke specifikke ressourcer har vi brug for til end-to-end UI-tests? Primært virtuelle maskiner eller klynger (vi vil diskutere Kubernetes i næste sektion) til at køre browsere og emulatorer. Jo flere browsere og emulatorer vi ønsker at køre samtidig, jo mere CPU og hukommelse kræves, og jo mere skal vi betale for det. Offentlige skyder i konteksten af automatisering af tests giver os mulighed for at køre et stort antal (100, 200, 1000 …) browsere/emulatorer on-demand, få testresultaterne så hurtigt som muligt og stoppe med at betale for sådanne vanvittigt ressourcekrævende kapaciteter.
De mest populære cloud-udbydere er Amazon Web Services (AWS), Microsoft Azure og Google Cloud Platform (GCP). I denne praktiske vejledning gives der eksempler på brug af GCP, men i det store hele er det ligegyldigt, hvad du bruger til automatiseringsopgaver. De tilbyder alle omtrent de samme funktioner. Typisk fokuserer vejledningen til valg af udbyder på hele virksomhedens infrastruktur og forretningsbehov, hvilket ligger uden for rammerne af denne artikel. For automatiseringsingeniører vil det være mere interessant at sammenligne brugen af cloud-udbydere med brugen af cloud-platforme specifikt til testformål, såsom Sauce Labs, BrowserStack, BitBar osv. Så lad os gøre det! Efter min mening er Sauce Labs den mest kendte cloud-testfarm, så jeg valgte den til sammenligning.
GCP vs. Sauce Labs til automatiseringsformål:
Lad os antage, at vi skal køre 8 web-tests og 8 Android-tests samtidig. Til dette vil vi bruge GCP og starte 2 virtuelle maskiner med Selenoid. På den første opsætter vi 8 containere med browsere. På den anden – 8 containere med emulatorer. Lad os se på priserne:
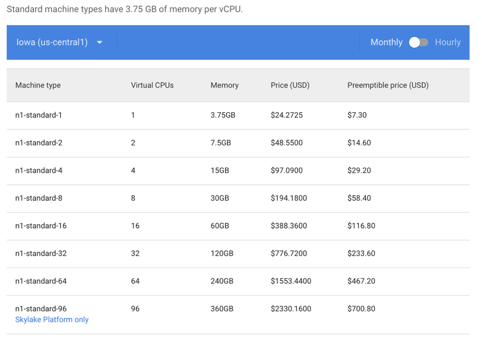
For at køre en container med Chrome, har vi brug for n1-standard-1 maskine. I tilfælde af Android vil det være n1-standard-4 for en enkelt emulator. Faktisk er en mere fleksibel og billigere metode at angive specifikke brugerdefinerede værdier for CPU/Hukommelse, men i øjeblikket er det ikke centralt for sammenligningen med Sauce Labs.
Her er taksterne for brug af Sauce Labs:
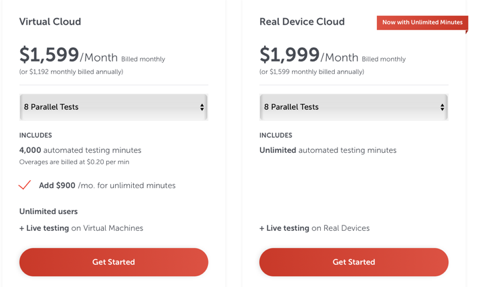
Jeg antager, at du allerede har bemærket forskellen, men alligevel giver jeg et skema med beregninger for vores opgave:
Nødvendige ressourcer
Månedligt
Arbejdstimer(8 a.m — 8 p.m)
Arbejdstimer+ Preemptible
GCP til Web
n1-standard-1 x 8 = n1-standard-8
$194.18
23 dage * 12t * 0.38 = 104.88$
23 dage * 12t * 0.08 = 22.08$
Sauce Labs til web
Virtuelle Cloud8 parallelle tests
$1.559
—
—
GCP til Android
n1-standard-4 x 8: n1-standard-16
$776.72
23 dage * 12t * 1.52 = 419.52$
23 dage * 12t * 0.32 = 88.32$
Sauce Labs til Android
Real Device Cloud 8 parallelle tests
$1.999
—
—
Som du kan se, er prisforskellen enorm, især når testene kun køres i det normale 12-timers arbejdsinterval. Men omkostningerne kan reduceres yderligere ved at bruge preemptible maskiner. Hvad indebærer det?
En preemptible VM er en instans, som du kan oprette og køre til en meget lavere pris end normale instanser. Dog kan Compute Engine afslutte (preempt) disse instanser, hvis den har brug for adgang til disse ressourcer til andre opgaver. Preemptible instanser er overskydende Compute Engine kapacitet, så deres tilgængelighed varierer med brugen.
Hvis dine apps er fejltolerante og kan tåle mulige instans-afbrydelser, kan preemptible instanser reducere dine Compute Engine omkostninger betydeligt. For eksempel kan batchbehandlingsjob køre på preemptible instanser. Hvis nogle af disse instanser afsluttes under behandlingen, bliver jobbet langsommere, men stopper ikke helt. Preemptible instanser afslutter dine batchbehandlingsopgaver uden at lægge ekstra belastning på dine eksisterende instanser og uden at kræve, at du betaler fuld pris for ekstra normale instanser.
Og det er stadig ikke slut! I virkeligheden er jeg sikker på, at ingen kører tests i 12 timer uden pause. Og hvis det er tilfældet, kan du automatisk starte og stoppe virtuelle maskiner, når de ikke er nødvendige. Den faktiske brugstid kan reduceres til 6 timer om dagen. Så ville betalingen i konteksten af vores opgave falde til hele 11$ om måneden for 8 browsere. Er det ikke fantastisk? Men med preemptible maskiner skal vi være forsigtige og forberede os på afbrydelser og ustabil drift, selvom disse situationer kan forudses og håndteres programmatisk. Det er det værd!
Men jeg siger bestemt ikke, at 'du aldrig skal bruge cloud-testfarmen'. De har en række fordele. Først og fremmest er det ikke bare en virtuel maskine, men en fuldgyldig løsning til automatisering af test med et sæt funktioner lige ud af boksen: fjernadgang, logs, screenshots, videooptagelse, forskellige browsere og fysiske mobile enheder. I mange situationer kan dette være en uundgåelig luksus. Især testplatforme er nyttige til IOS-automatisering, hvor offentlige cloud-løsninger kun kan tilbyde Linux/Windows-systemer. Men snakken om IOS vil komme i de næste artikler. Jeg anbefaler altid at vurdere situationen og tage udgangspunkt i opgaverne: i nogle tilfælde er det billigere og mere effektivt at bruge offentlige clouds, mens testplatforme i andre tilfælde bestemt er værd at investere i.
Illustration af den nuværende tilstand af infrastrukturen
Links til undersøgelse
Relaterede værktøjer:
6. Orkestrering
Kort beskrivelse af teknologien
Jeg har gode nyheder – vi er næsten ved slutningen af artiklen! På nuværende tidspunkt består vores automatiseringsinfrastruktur af web- og Android-tests, som vi kører parallelt via GitLab CI ved hjælp af værktøjer med Docker-understøttelse: Selenium grid og Selenoid. Desuden bruger vi virtuelle maskiner oprettet gennem GCP til at opstille containere med browsere og emulatorer. For at reducere omkostningerne kører vi disse virtuelle maskiner kun efter behov og stopper dem, når der ikke udføres test. Er der noget andet, der kan forbedre vores infrastruktur? Svaret er ja! Mød Kubernetes (K8s)!
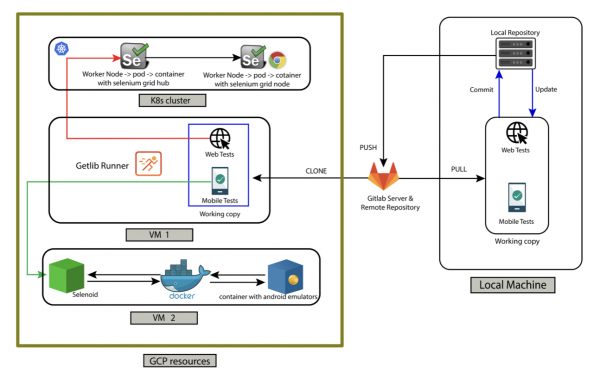
Lad os først se, hvordan ordene orkestrering, klynge og Kubernetes hænger sammen. På et højt niveau er orkestrering et system, der udruller og administrerer applikationer. For automatisering af test er de containeriserede applikationer Selenium grid og Selenoid. Docker og K8s supplerer hinanden. Den første bruges til udrulning af applikationer, mens den anden bruges til orkestrering. K8s er i sin tur en klynge. Klyngens opgave er at bruge VMs som noder, hvilket gør det muligt at installere forskellige funktionaliteter, programmer og tjenester inden for én server (klynge). Hvis en af noderne fejler, tager de andre noder over, hvilket sikrer, at vores applikation fungerer uden afbrydelser. Derudover har K8s en vigtig funktionalitet relateret til skalering, som gør, at vi automatisk får det optimale antal ressourcer baseret på belastningen og de fastsatte begrænsninger.
Ærligt talt er manuel opsætning af Kubernetes fra bunden slet ikke en triviel opgave. Jeg vil efterlade et link til den kendte praktiske vejledning "Kubernetes The Hard Way", og hvis du er interesseret, kan du øve dig. Men heldigvis findes der alternative metoder og værktøjer. Den nemmeste måde er at bruge Google Kubernetes Engine (GKE) i GCP, hvilket giver dig en klar klynge efter et par klik. Til begyndelsen af din læring anbefaler jeg at bruge denne tilgang, da den giver dig mulighed for at fokusere på, hvordan du bruger K8s til dine opgaver i stedet for at undersøge, hvordan de interne komponenter skal integreres.
Værdi for automatiseringsinfrastruktur
Lad os se på nogle betydningsfulde funktioner, som K8s tilbyder:
- udrulning af applikationer: brug af multi-nodes klynge i stedet for VMs;
- dynamisk skalering: reducerer omkostningerne til ressourcer, som kun bruges efter behov;
- selvhelbredelse (Self-healing): automatisk genoprettelse af pods (hvilket også genopretter containere);
- opdatering af funktioner og tilbageførsel af ændringer uden nedetid: opdatering af værktøjer, browsere og emulatorer forstyrrer ikke nuværende brugere
Men K8s er stadig ikke en sølvkugle. For at forstå alle fordele og begrænsninger i konteksten af de værktøjer, vi ser på (Selenium grid, Selenoid), lad os kort diskutere strukturen af K8s. En klynge indeholder to typer noder: Master Nodes og Workers Nodes. Master Nodes er ansvarlige for styring, udrulning og scheduling decisions. Workers Nodes er der, hvor applikationerne kører. Noderne indeholder også miljøet for containerkørsel. I vores tilfælde er det Docker, der håndterer operationer relateret til containere. Men der er også alternative løsninger, for eksempel. Det er vigtigt at forstå, at skalering eller selvhelbredelse ikke relaterer sig direkte til containere. Dette implementeres ved at tilføje/fjerne antal pods, som i sin tur indeholder containere (normalt én container pr. pod, men afhængigt af opgaven kan der være flere). Den højniveaustruktur består af worker nodes, inden i hvilke der er pods, inden i hvilke der er kørende containere.
Skalering er en nøglefunktion og kan anvendes både på nodes inden for cluster node-pool og på pods inden for node. Der findes 2 typer skalering, der gælder for både nodes og pods. Den første type er horisontal skalering, hvor antal nodes/pods øges. Denne type er den mest foretrukne. Den anden type er vertikal skalering, hvor størrelsen på nodes/pods øges i stedet for antallet.
Lad os nu se på vores værktøjer i konteksten af de ovennævnte termer.
Selenium grid
Som nævnt tidligere er Selenium grid et meget populært værktøj, og det er ikke overraskende, at det er blevet containeriseret. Det er derfor heller ikke overraskende, at Selenium grid kan implementeres i K8s. Et eksempel på, hvordan dette gøres, kan findes i det officielle K8s-repository. Som altid vedlægger jeg links i slutningen af sektionen. Derudover viser en praktisk vejledning, hvordan dette gøres gennem Terraform. Der er også en vejledning til, hvordan man skalerer antallet af pods, der indeholder containere med browsere. Men funktionen til automatisk skalering i konteksten af K8s er stadig ikke en helt klar opgave. Da jeg begyndte at studere, fandt jeg ingen praktisk vejledning eller anbefalinger. Efter adskillige undersøgelser og eksperimenter med støtte fra DevOps-teamet valgte vi at løfte containere med de nødvendige browsere inde i én pod, som er inde i én worker node. Denne metode gør det muligt for os at anvende strategien for horisontal skalering af nodes ved at øge deres antal. Jeg håber, at situationen ændrer sig i fremtiden, og at vi ser flere og flere beskrivelser af de bedste metoder og færdige løsninger, især efter udgivelsen af Selenium grid 4 med en ændret intern arkitektur.
Selenoid:
I øjeblikket er implementeringen af Selenoid i K8s den største skuffelse. De er ikke kompatible. Teoretisk set kan vi starte en Selenoid-container inde i en pod, men når Selenoid begynder at køre containere med browsere, vil de stadig befinde sig inde i denne samme pod. Dette gør skalering umulig, og som et resultat vil Selenoids funktion i klyngen ikke adskille sig fra driften inde i en virtuel maskine. Slutningen på historien.
Moon:
Ved at være opmærksom på dette flaskehalsproblem ved brug af Selenoid, har udviklerne udgivet et mere kraftfuldt værktøj, som de har kaldt Moon. Dette værktøj var oprindeligt designet til at arbejde med Kubernetes, og som et resultat heraf kan og bør funktionen for automatisk skalering anvendes. Mere end det, vil jeg sige, at det i øjeblikket er mulige løsning. (For eksempel kan man ikke bare ændre feltet værktøjet i verden af Selenium, som ud af boksen har native K8s cluster-support (det er ikke længere, se næste værktøj ). Den vigtigste funktion ved Moon, som muliggør denne støtte, er:
Helt stateless. Selenoid gemmer i hukommelsen oplysninger om de aktuelt kørende browsersessioner. Hvis det af en eller anden grund går ned — så går alle kørende sessioner tabt. Moon derimod har ingen intern tilstand og kan repliceres på tværs af datacentre. Browsersessioner forbliver aktive, selv hvis en eller flere replikaer går ned.
Så, Moon er en fantastisk løsning, men med et problem, det er ikke gratis. Prisen afhænger af antallet af sessioner. Det er gratis at køre kun 0-4 sessioner, hvilket ikke er særligt nyttigt. Men fra den femte session skal der betales 5$ for hver. Situationen kan variere fra virksomhed til virksomhed, men i vores tilfælde giver det ikke mening at bruge Moon. Som jeg beskrev tidligere, kan vi køre VMs med Selenium Grid efter behov eller øge antallet af Nodes i klyngen. For hver pipeline kører vi cirka 500 browsere og stopper alle ressourcer efter afslutning af testene. Hvis vi brugte Moon, ville vi skulle betale yderligere 500 x 5 = 2500 $ om måneden, uanset hvor ofte vi kører testene. Og igen, jeg siger ikke "brug ikke Moon". For jeres opgaver kan det være en uundgåelig løsning, især hvis I har mange projekter/teams i organisationen, og I har brug for et stort fælles cluster til alle. Som altid efterlader jeg et link til sidst og anbefaler at lave alle nødvendige beregninger i konteksten af jeres opgave.
Callisto: (Advarsel! Dette er ikke i den originale artikel og findes kun i den russiske oversættelse)
Som jeg sagde, er Selenium et meget populært værktøj, og IT-branchen udvikler sig hurtigt. Mens jeg arbejdede på oversættelsen, dukkede et nyt lovende værktøj, Callisto (hej Cypress og andre dræbere af Selenium), op på nettet. Det fungerer nativt med K8s og gør det muligt at køre Selenoid-containere i pods, distribueret på Nodes. Alt fungerer straks ud af boksen, inklusive automatisk skalerering. Fantastisk, men det skal testes. Jeg har allerede formået at implementere dette værktøj og sætte nogle eksperimenter op. Men det er for tidligt at drage konklusioner; efter at have fået resultater over længere tid, vil jeg måske lave en anmeldelse i kommende artikler. Jeg efterlader blot links til selvstændig research.
Illustration af den nuværende tilstand af infrastrukturen
Links til undersøgelse
Links til undersøgelse
Analoge værktøjer
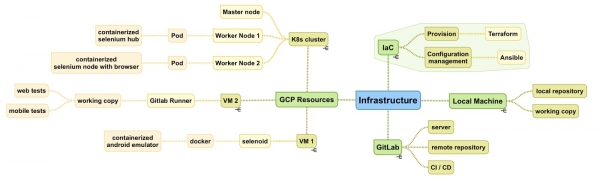
7. Infrastruktur som kode (IaC)
Kort beskrivelse af teknologien
Og nu er vi nået til det sidste afsnit. Normalt falder denne teknologi og de tilknyttede opgaver ikke inden for automatiseringsingeniørernes ansvarsområde. Der er gode grunde til dette. For det første er infrastrukturelle spørgsmål i mange organisationer under kontrol af DevOps-afdelingen, og udviklingsteams bekymrer sig ikke meget om, hvad der får pipeline til at fungere, og hvordan man skal vedligeholde alt, hvad der relaterer sig til det. For det andet, lad os være ærlige, praksis med "Infrastruktur som kode (IaC)" anvendes stadig ikke i mange virksomheder. Men det er bestemt blevet en populær trend, og det er vigtigt at forsøge at være involveret i de processer, tilgange og værktøjer, der er forbundet med dette. Eller i det mindste være informeret om udviklingen.
Lad os starte med motivationen for at bruge denne tilgang. Vi har allerede drøftet, at vi for at køre tests i GitlabCI mindst har brug for ressourcer til at køre Gitlab Runner. Og for at starte containere med browsere/emulatorer skal vi reservere en VM eller et cluster. Udover ressourcerne til testning har vi brug for et betydeligt antal kapaciteter til at understøtte udviklings-, staging- og produktionsmiljøer, hvilket også inkluderer databaser, automatiske tidsplaner, netværkskonfigurationer, belastningsfordelere, brugerrettigheder og så videre. Det centrale problem er den nødvendige indsats for at støtte det hele. Der er flere måder, hvormed vi kan foretage ændringer og implementere opdateringer. For eksempel, i konteksten af GCP kan vi bruge UI-konsollen i browseren og udføre alle handlinger ved at klikke på knapper. En alternativ metode kan være at bruge API-opkald til at interagere med cloud-enkeltheder eller anvende kommandolinjeværktøjet gcloud til at udføre de nødvendige manipulationer. Men med et virkelig stort antal forskellige enheder og infrastrukturelementer bliver det svært eller endda umuligt at udføre alle operationer manuelt. Desuden er alle disse manuelle handlinger ukontrollerede. Vi kan ikke sende dem til gennemgang før udførelse, bruge versionskontrolsystemer og hurtigt rulle ændringer tilbage, som har ført til en hændelse. For at løse sådanne problemer har ingeniører skabt og skaber automatiserede bash/shell-scripts, hvilket ikke er meget bedre end de tidligere metoder, da de ikke er så lette at læse, forstå, vedligeholde og modificere hurtigt i proceduremæssig stil.
I denne artikel og praktiske vejledning bruger jeg to værktøjer, der relaterer sig til IaC-praksis. Dette er Terraform og Ansible. Nogle mener, at det ikke giver mening at bruge dem samtidig, da deres funktionalitet ligner hinanden, og de kan erstatte hinanden. Men sagen er, at de oprindeligt stilles forskellige opgaver. Og det faktum, at disse værktøjer skal supplere hinanden, blev bekræftet ved en fælles præsentation af udviklere repræsenterende virksomhederne HashiCorp og RedHat. Den konceptuelle forskel er, at Terraform er et provisioning-værktøj til at administrere selve serverne. Mens Ansible er et værktøj til konfigurationsstyring, hvis opgave er at installere, konfigurere og administrere softwaren på disse servere.
En anden afgørende forskel mellem disse værktøjer er kodestilen. I modsætning til bash og Ansible bruger Terraform en deklarativ stil, der er baseret på beskrivelsen af den ønskede endelige tilstand, som skal opnås som følge af udførelsen. For eksempel, hvis vi har tænkt os at oprette 10 VMs og anvende ændringerne gennem Terraform, får vi 10 VMs. Hvis vi anvender scriptet igen, vil der ikke ske noget, da vi allerede har 10 VMs, og Terraform ved dette, fordi det gemmer den nuværende tilstand af infrastrukturen i en state-fil. Ansible bruger derimod en procedurebaseret tilgang, og hvis vi beder det om at oprette 10 VMs, får vi 10 VMs ved første kørsel, ligesom med Terraform. Men efter en gentagen kørsel vil vi allerede have 20 VMs. Dette er den vigtige forskel. I den procedurebaserede stil opbevarer vi ikke den nuværende tilstand og beskriver blot rækkefølgen af de skridt, der skal udføres. Selvfølgelig kan vi håndtere forskellige situationer, tilføje nogle kontroller for eksisterende ressourcer og den nuværende tilstand, men der er ikke meget mening i at bruge vores tid og kræfter på at kontrollere denne logik. Desuden øger det risikoen for fejl.
Sammenfattende kan vi konkludere, at Terraform og deklarativ notation er det mere passende værktøj til provisioning af servere. Mens konfigurationsstyring bedre overlades til Ansible. Når vi har forstået dette, lad os se på eksempler på anvendelse i konteksten af automatisering.
Værdi for automatiseringsinfrastruktur
Det er vigtigt at forstå, at infrastrukturen til testautomatisering skal betragtes som en del af hele virksomhedens infrastruktur. Det betyder, at alle IaC-praksisser skal anvendes globalt på ressourcerne i hele organisationen. Hvem der er ansvarlig for dette, afhænger af jeres processer. DevOps-teamet har mere erfaring med disse emner, og de har et overordnet billede af situationen. QA-ingeniører er dog mere involveret i processen med at opbygge automatisering og strukturen af pipeline, hvilket giver dem en bedre forståelse af de nødvendige ændringer og forbedringsmuligheder. Den bedste løsning er at arbejde sammen, dele viden og idéer for at opnå det ønskede resultat.
Lad mig give nogle eksempler på brugen af Terraform og Ansible i konteksten af testautomatisering og de værktøjer, vi har diskuteret tidligere:
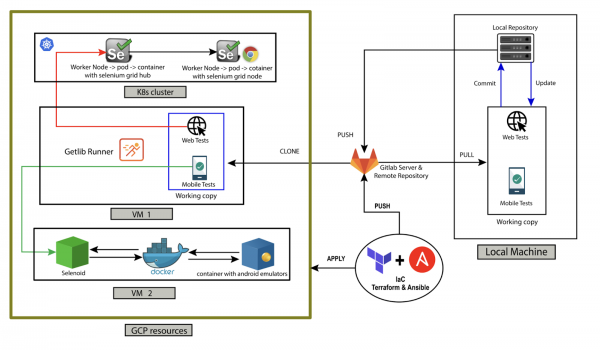
1. Beskrive de nødvendige egenskaber og parametre for VMs og klynger gennem Terraform.
2. Installere de nødvendige testværktøjer med Ansible: docker, Selenoid, Selenium Grid og downloade de nødvendige versioner af browsere/emulatorer.
3. Beskrive egenskaberne for den VM, hvor GitLab Runner skal køres, gennem Terraform.
4. Installere GitLab Runner og nødvendige tilhørende værktøjer med Ansible, og indstille indstillinger og konfigurationer.
Illustration af den nuværende tilstand af infrastrukturen
Links til studier:
Analoge værktøjer
Lad os opsummere!
Trin
Teknologi
Tools
Værdi for automatiseringsinfrastruktur
1
Lokal kørsel
Node.js, Selenium, Appium
- De mest populære værktøjer til web og mobil
- Support for mange sprog og platforme (inklusive Node.js)
2
Versionskontrolsystemer
Git
- Lignende fordele med udviklingskode
3
Containerisering
Docker, Selenium grid, Selenoid (Web, Android)
- Parallel kørsel af tests
- Isolerede miljøer
- Enkel, fleksibel opdatering af versioner
- Dynamisk nedlukning af ubrugte ressourcer
- Nem at konfigurere
4
CI / CD
Gitlab CI
- Tests er en del af pipeline
- Hurtig feedback
- Synlighed for hele virksomheden/teamet
5
Cloud-platforme
Google Cloud Platform
- Ressourcer på efterspørgsel (betal kun når de er nødvendige)
- Nem at administrere og opdatere
- Synlighed og kontrol over alle ressourcer
6
Orkestrering
Kubernetes
I konteksten af containere med browsere/emulatorer i pods:
- Skalering / automatisk skalering
- Selvhelbredelse
- Opdateringer og tilbageskydninger uden nedetid
7
Infrastruktur som kode (IaC)
Terraform, Ansible
- Lignende fordele med udviklingsinfrastruktur
- Alle fordele ved versionering af kode
- Let at ændre og vedligeholde
- Fuldstændig automatiseret
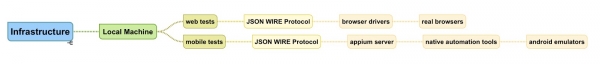
Mind map diagrammer: udviklingen af infrastruktur
step1: Lokal
step2: VCS
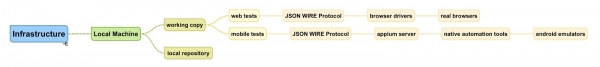
step3: Containerisering
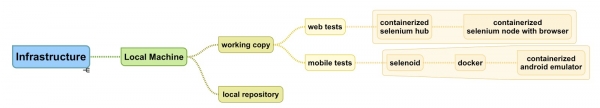
step4: CI/CD
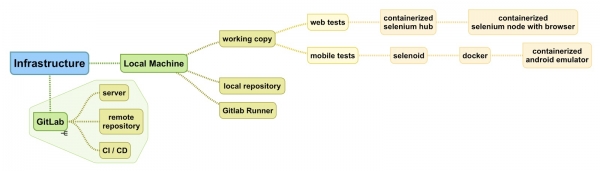
step5: Cloud-platforme
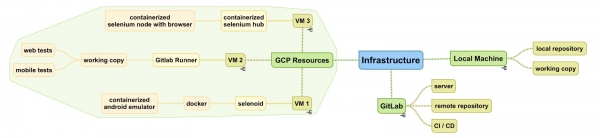
step6: Orkestrering
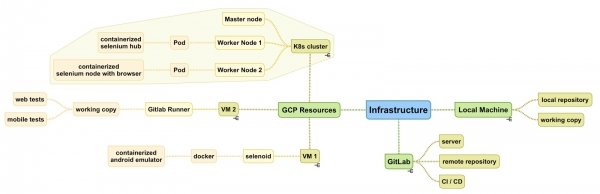
step7: IaC
Hvad nu?
Så, det er slutningen på artiklen. Men i konklusionen vil jeg gerne fastlægge nogle aftaler med dig.
Fra din side
Som nævnt i starten, vil jeg gerne have, at artiklen er praktisk og hjælper dig med at anvende de indsamlede viden i det virkelige arbejde. Jeg tilføjer endnu en gang.
Men selv efter dette, skal du ikke stoppe, øv dig, studer de relevante links og bøger, find ud af, hvordan det fungerer i din virksomhed, find steder der kan forbedres, og deltag i dette. Held og lykke!
Fra min side
Fra overskriften kan du se, at dette kun var den første del. Selvom den blev ret stor, er der stadig vigtige emner, der ikke er blevet dækket. I den anden del planlægger jeg at se på automatiseringsinfrastruktur i konteksten af iOS. På grund af Apples begrænsninger for at køre iOS-simulatorer kun på macOS-systemer er vores udvalg af løsninger indskrænket. For eksempel er vi forhindret i at bruge Docker til at køre simulatoren eller offentlige cloud-tjenester til at køre virtuelle maskiner. Men det betyder ikke, at der ikke er andre alternativer. Jeg vil forsøge at holde dig opdateret med førende løsninger og moderne værktøjer!
Jeg nævnte heller ikke de tematikker, der vedrører overvågning. I del 3 planlægger jeg at se på de mest populære værktøjer til overvågning af infrastruktur samt hvilke data og målinger, der bør tages i betragtning.
Og til sidst. I fremtiden planlægger jeg at udgive en videokursus om opbygning af testinfrastruktur og populære værktøjer. I øjeblikket er der rigtig mange kurser og forelæsninger om DevOps på internettet, men alt materiale præsenteres i konteksten af udvikling, ikke testautomatisering. Jeg har meget brug for feedback på, om et sådant kursus vil være interessant og værdifuldt for test- og automatiseringssamfundet. På forhånd tak!
Kilde: habr.com
