

Kubernetes er et fremragende værktøj til at køre Docker-containere i en klyngemiljø i produktion. Men der er opgaver, som Kubernetes ikke kan løse. Ved hyppig implementering i produktionsmiljøet har vi brug for en fuldt automatiseret Blue/Green deployment for at undgå nedetid i denne proces, hvor det også er nødvendigt at håndtere eksterne HTTP-anmodninger og udføre SSL-udtrækning. Dette kræver integration med en lastbalancer, såsom ha-proxy. En anden udfordring er semi-automatiseret skalering af selve Kubernetes-klyngen, når man arbejder i et cloud-miljø, for eksempel delvis nedskalering af klyngen om natten.
Selvom Kubernetes ikke har disse funktioner lige «ud af boksen», giver det API'er, som kan udnyttes til at løse sådanne opgaver. Værktøjer til automatiseret Blue/Green deployment og skalering af Kubernetes-klyngen er blevet udviklet under Cloud RTI-projektet, som er baseret på open-source.
I denne artikel, som er en transskription af en video, beskrives, hvordan man konfigurerer Kubernetes sammen med andre open-source komponenter for at opnå et produktionsklart miljø, der uden nedetid i produktionen modtager koden fra git commit-ændringer.
Så snart du har fået adgang til dine applikationer fra den eksterne verden, kan du gå videre med at fuldautomatisere opsætningen, det vil sige nå til det punkt, hvor du kan udføre en git commit og sikre, at denne git commit ender i produktion. Det er indlysende, at når disse skridt implementeres, og implementeringen finder sted, ønsker vi ikke at opleve nedetid. Så enhver automatisering i Kubernetes starter med API'et.
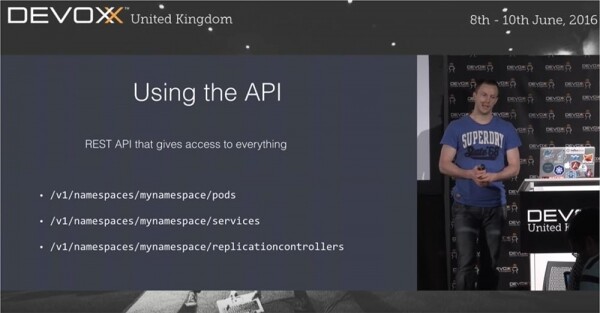
Kubernetes er ikke det værktøj, der kan bruges produktivt «lige ud af boksen». Selvfølgelig kan du gøre det sådan, bruge kubectl osv., men API'et er virkelig den mest interessante og nyttige del af denne platform. Ved at bruge API'et som et sæt funktioner kan du få adgang til næsten alt, hvad du ønsker at gøre i Kubernetes. Selve kubectl bruger også REST API.
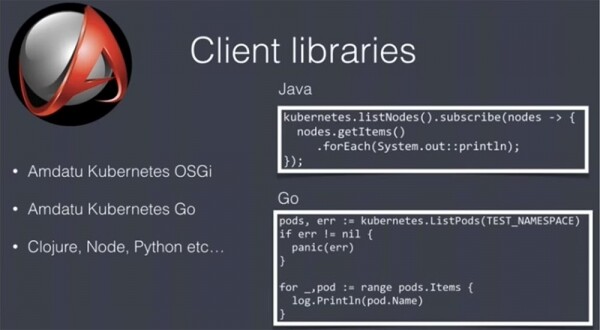
Dette er REST, så du kan bruge ethvert sprog og værktøj til at arbejde med dette API, men brugerbibliotekerne vil gøre dit liv meget lettere. Mit team har skrevet to sådanne biblioteker: et til Java / OSGi og et til Go. Det andet bruges ikke så ofte, men uanset hvad har du disse nyttige værktøjer til rådighed. De udgør delvist et licenseret open-source projekt. Der findes mange sådanne biblioteker til forskellige sprog, så du kan vælge dem, der passer bedst til dine behov.
Så før du går i gang med at automatisere implementeringen, skal du sørge for, at denne proces ikke vil være udsat for nedetid. For eksempel udfører vores team produktionsimplementering midt på dagen, når folk bruger applikationerne mest, så det er meget vigtigt at undgå forsinkelser i denne proces. For at undgå nedetid anvendes der to metoder: blue/green-implementering eller rolling update. I det sidstnævnte tilfælde, hvis du har 5 replikaer af applikationen, bliver de opdateret én efter én. Denne metode fungerer fremragende, men den egner sig ikke, hvis der kører forskellige versioner af applikationen samtidigt under implementeringen. I så fald kan du opdatere brugergrænsefladen, mens backenden kører den gamle version, og applikationen vil stoppe med at fungere. Derfor er det ret udfordrende at arbejde under sådanne forhold.
Dette er en af grundene til, at vi foretrækker at bruge blue/green-implementering til automatisk at implementere vores applikationer. Ved denne metode skal du sikre dig, at der kun er én aktiv version af applikationen på et givent tidspunkt.
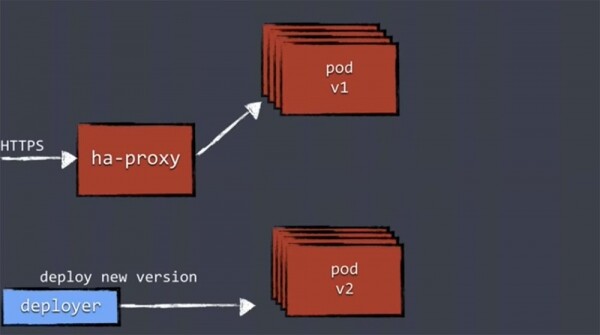
Mechanismen for blue/green-implementering ser således ud. Vi modtager trafik til vores applikationer gennem ha-proxy, som dirigerer den til de aktive replikaer af applikationen med samme version.
Når der udføres en ny implementering, bruger vi Deployer, som får nye komponenter, og den implementerer den nye version. Implementeringen af den nye version af applikationen betyder, at et nyt sæt replikaer "opstilles", hvorefter disse replikaer af den nye version startes i en separat, ny pod. Men ha-proxy ved endnu ikke noget om dem og dirigerer i øjeblikket ingen arbejdsbyrde til dem.
Derfor er det først nødvendigt at udføre en sundhedstjek af de nye versioner for at sikre, at replikaerne er klar til at håndtere arbejdsbyrden.
Alle implementeringskomponenter skal understøtte en form for sundhedstjek. Dette kan være et meget simpelt HTTP-kald, hvor du får en statuskode 200, eller en mere dybdegående kontrol, hvor du tjekker forbindelsen mellem replikaerne og databasen samt andre tjenester, stabiliteten af forbindelserne i det dynamiske miljø, samt om alt kører og fungerer korrekt. Denne proces kan være ret kompliceret.
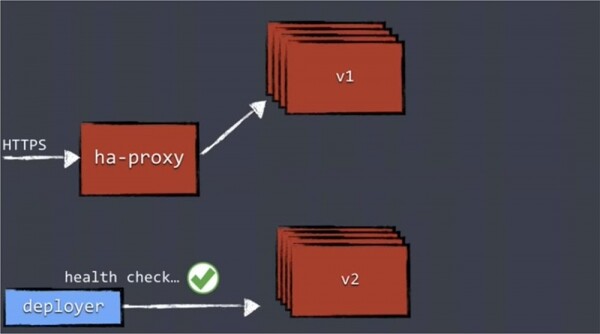
Når systemet har sikret sig, at alle opdaterede replikaer fungerer korrekt, vil Deployer opdatere konfigurationen og videresende den korrekte confd, der omkonfigurerer ha-proxy.
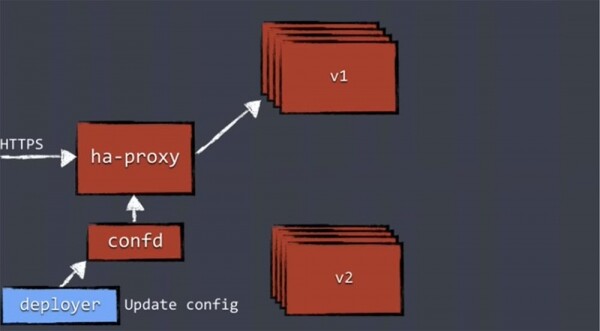
Først efter dette vil trafikken blive sendt til pod'en med replikaerne af den nye version, og den gamle pod forsvinder.
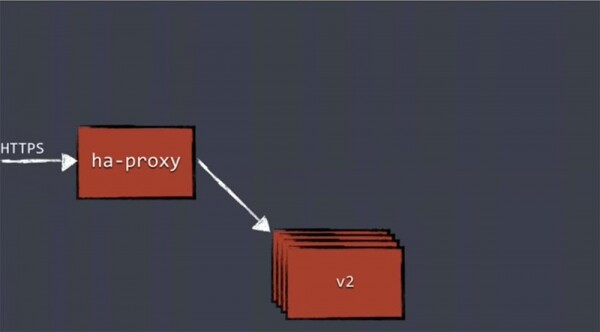
Denne mekanisme er ikke en funktion af Kubernetes. Konceptet Blue/green deployment har eksisteret i lang tid og har altid brugt en belastningsbalance. Først dirigerer du al trafik til den gamle version af applikationen, og efter opdateringen flytter du det helt til den nye version. Dette princip anvendes ikke kun i Kubernetes.
Nu vil jeg præsentere en ny implementeringskomponent – Deployer, som udfører sundhedstjek, rekonfigurerer proxyen og så videre. Dette er et koncept, der ikke henviser til den ydre verden og eksisterer inden i Kubernetes. Jeg vil vise, hvordan man kan oprette sit eget Deployer-koncept ved hjælp af open-source værktøjer.
Så det første, som Deployer gør, er at oprette en Replikations Controller (RC) ved hjælp af Kubernetes API'en. Denne API opretter pods og services til yderligere udrulning, det vil sige den opretter et helt nyt cluster til vores applikationer. Så snart RC'en har sikret sig, at replikaerne er startet, udføres en sundhedstjek for deres funktionalitet. Til dette bruger Deployer kommandoen GET /health. Den starter de relevante kontrolkomponenter og tjekker alle elementer, der er nødvendige for, at clusteren fungerer.
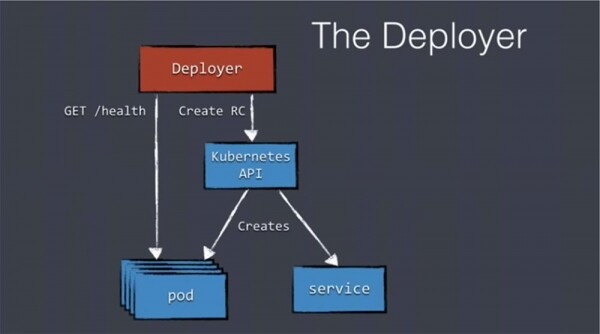
Når alle pods har rapporteret om deres "sundhed", opretter Deployer et nyt konfigurationselement – et distribueret lager etcd, som bruges indenfor Kubernetes, herunder til at gemme konfigurationen for belastningsfordeleren. Vi skriver data til etcd, og et lille værktøj, confd, overvåger etcd for nye data.
Hvis det opdager ændringer i den oprindelige konfiguration, genererer det en ny konfigurationsfil og sender den til ha-proxy. I dette tilfælde genstartes ha-proxy uden at miste nogen forbindelser, og den adresserer belastningen til de nye services, som understøtter den nye version af vores applikationer.
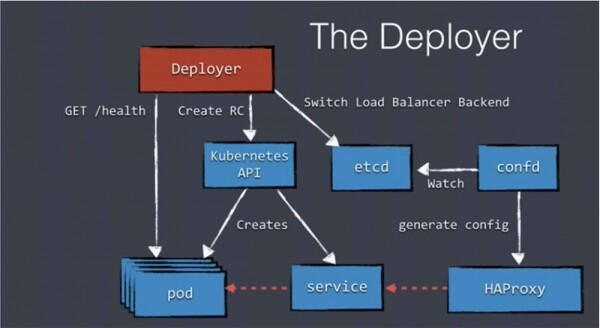
Som du kan se, er der ikke noget kompliceret her på trods af mængden af komponenter. Du skal blot være opmærksom på API'en og etcd. Jeg vil gerne fortælle om en open-source deployer, som vi selv bruger – Amdatu Kubernetes Deployer.
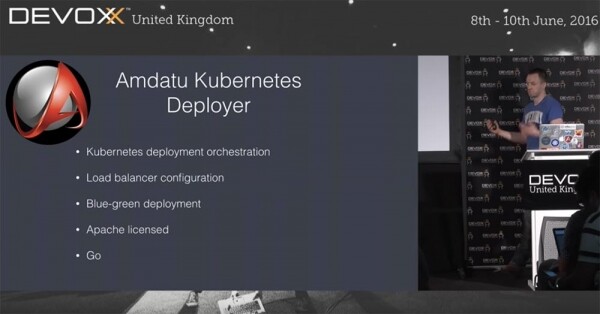
Det er et værktøj til orkestrering af Kubernetes-udrulninger med følgende funktioner:
- Blue/Green deployment;
- konfiguration af ekstern belastningsfordeler;
- håndtering af deployments beskrivelser;
- håndtering af den faktiske udrulning;
- sundhedstjek under udrulning;
- indførelse af miljøvariabler i pods.
Denne Deployer er bygget ovenpå Kubernetes API'en og tilbyder et REST API til at styre beskrivelser og udrulninger samt et Websocket API til streaming af logs under udrulningen.
Den placerer konfigurationsdata for belastningsfordeleren i etcd, så du kan vælge ikke at bruge ha-proxy med understøttelse 'out-of-the-box' og nemt anvende din egen konfigurationsfil til belastningsfordeleren. Amdatu Deployer er skrevet i Go, ligesom Kubernetes selv, og er licenseret under Apache.
Før jeg begyndte at bruge denne version af deployeren, benyttede jeg følgende deploy-beskrivelse, der angiver de parametre, jeg har brug for.
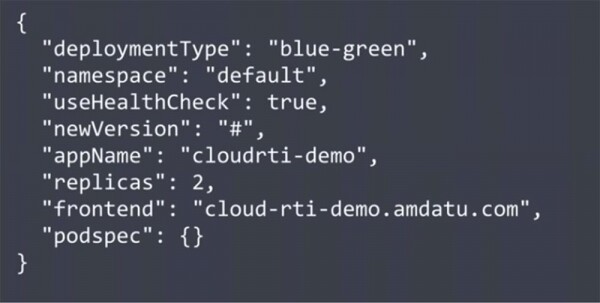
En af de vigtige parametre i denne kode er aktiveringen af flaget "useHealthCheck". Vi skal angive, at der under deployment skal udføres en sundhedstjek. Dette parameter kan deaktiveres, når der anvendes containere fra tredjepart, som ikke skal kontrolleres. I denne beskrivelse er antallet af replikaer og URL'en til front-enden, som ha-proxyen har brug for, også angivet. Til sidst er flaget for podspecifikationen "podspec", som henvender sig til Kubernetes for at hente oplysninger om portkonfigurationen, billedet osv. Dette er en ret simpel beskrivelse i JSON-format.
Et andet værktøj, der er en del af open-source-projektet Amdatu, er Deploymentctl. Det har et brugergrænseflade UI til konfiguration af deployment, gemmer deploymentshistorik og indeholder webhooks til tilbagekaldelser af tredjepartsbrugere og udviklere. Du kan vælge ikke at bruge UI, da Amdatu Deployer selv er et REST API, men dette interface kan gøre deployment meget lettere for dig uden at skulle involvere et API. Deploymentctl er skrevet i OSGi/Vertx ved hjælp af Angular 2.
Nu vil jeg demonstrere det, jeg lige har sagt onscreen, ved at bruge en forudindspillet optagelse, så du ikke skal vente. Vi vil deployere en simpel applikation skrevet i Go. Bekymr dig ikke, hvis du ikke har arbejdet med Go før; det er en meget simpel applikation, så du bør kunne følge med.
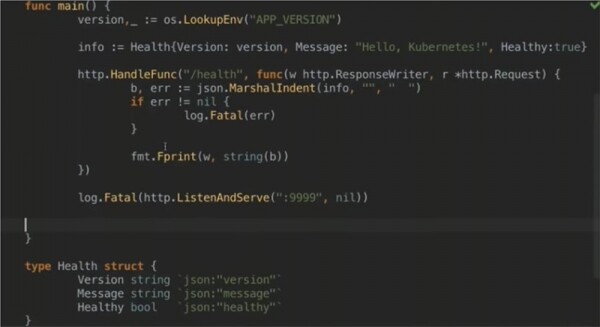
Her opretter vi en HTTP-server, der kun svarer på /health, så denne applikation kun kontrollerer sundhedstjek og ikke mere. Hvis tjekket går igennem, aktiveres den JSON-struktur, som vises nedenfor. Den indeholder versionen af den applikation, der skal deployeres af deployeren, message, som du ser øverst i filen, og en boolean datatyper — om vores applikation fungerer eller ej.
Jeg var lidt smart med den sidste linje, fordi jeg i toppen af filen satte en fast boolean-værdi, som senere vil hjælpe mig med at deployere selv en "usund" applikation. Det vender vi tilbage til senere.
Lad os komme i gang. Først tjekker vi for nogen kørende pods ved hjælp af kommandoen ~ kubectl get pods, og ved fraværet af svar fra frontend-URL’en bekræfter vi, at der i øjeblikket ikke er nogen implementeringer i gang.
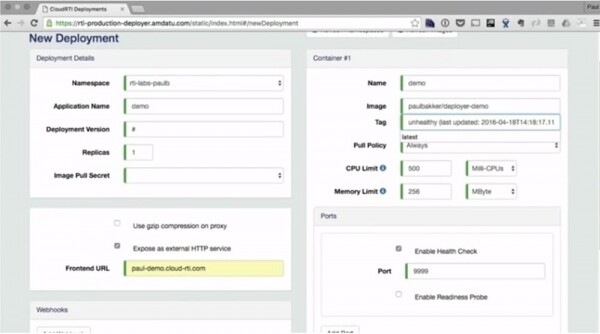
Dernæst kan I på skærmen se det interface, jeg nævnte, kaldet Deploymentctl, hvor parametre for implementering fastsættes: navnerum, applikationsnavn, implementeringsversion, antal replikater, frontend-URL, containerens navn, billede, ressourcegrænser, portnummer til health check osv. Ressourcegrænser er meget vigtige, da de tillader maksimal udnyttelse af hardware. Her kan man også se loggen for implementeringen.
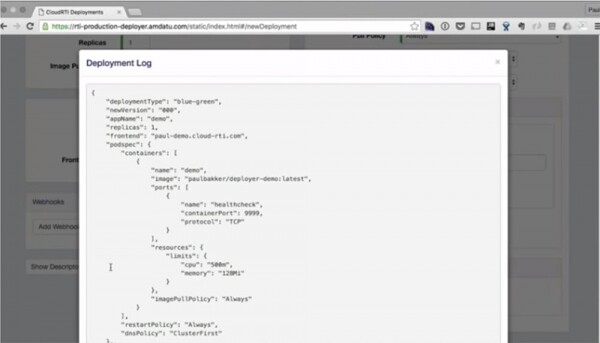
Hvis vi gentager kommandoen ~ kubectl get pods, kan vi se, at systemet "fryser" i 20 sekunder, hvor ha-proxy rekonfigureres. Herefter starter pod’en, og vi kan se vores replika i implementeringsloggen.
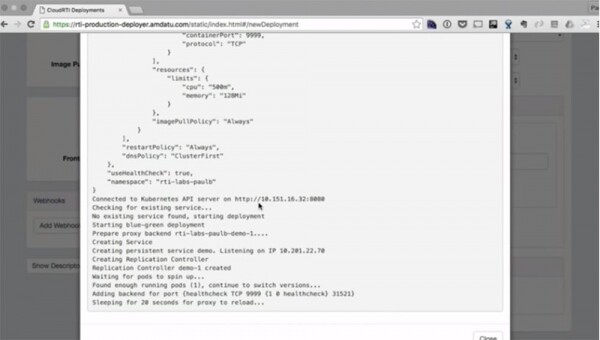
Jeg har klippet det 20-sekunders ventetid ud fra videoen, og nu ser I på skærmen, at den første version af applikationen er implementeret. Alt dette blev gjort udelukkende ved hjælp af UI.
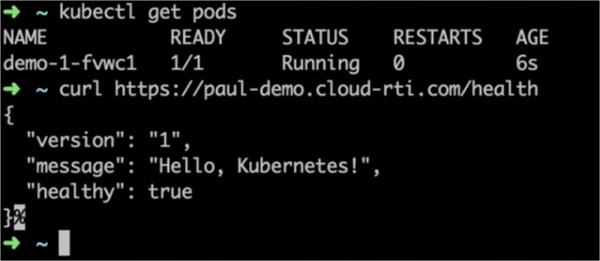
Lad os nu prøve den anden version. Til dette ændrer jeg meddelelsen i applikationen fra "Hello, Kubernetes!" til "Hello, Deployer!", systemet opretter dette billede og placerer det i Docker-registeret, hvorefter vi blot trykker på knappen "Deploy" igen i vinduet Deploymentctl. Under denne proces starter loggen for implementeringen automatisk på samme måde, som det skete ved implementeringen af den første version af applikationen.
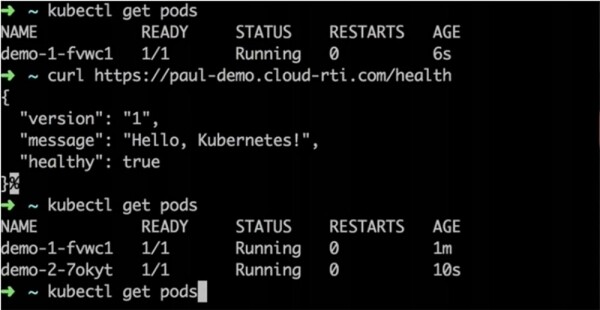
Kommandoen ~ kubectl get pods viser, at der i øjeblikket kører 2 versioner af applikationen, men frontend viser, at vi stadig kører version 1.
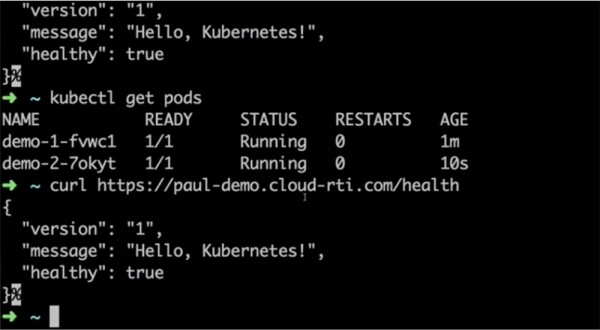
Lastbalancer venter på, at health check skal gennemføres, hvorefter den vil omdirigere trafikken til den nye version. Efter 20 sekunder skifter vi til curl og ser, at vi nu har den 2. version af applikationen implementeret, mens den første er blevet fjernet.
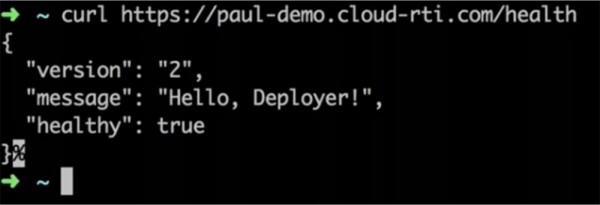
Dette var implementeringen af en "sund" - healthy - applikation. Lad os se hvad der sker, hvis jeg ændrer værdien af parameteren Healthy for den nye applikation fra true til false, dvs. hvis jeg prøver at implementere en unhealthy applikation, der ikke bestod health check. Dette kan ske, hvis der i udviklingen er blevet gjort konfigurationsfejl i applikationen, og den på den måde blev sendt til produktion.
Som du kan se, gennemgår implementeringen alle de tidligere nævnte trin, og ~ kubectl get pods viser, at begge pods kører. Men i modsætning til den tidligere implementering viser loggen en timeout-status. Det vil sige, at den nye version af applikationen ikke kan implementeres, fordi health check ikke bestod. Som et resultat ser du, at systemet er vendt tilbage til at bruge den gamle version af applikationen, mens den nye version blot er blevet slettet.
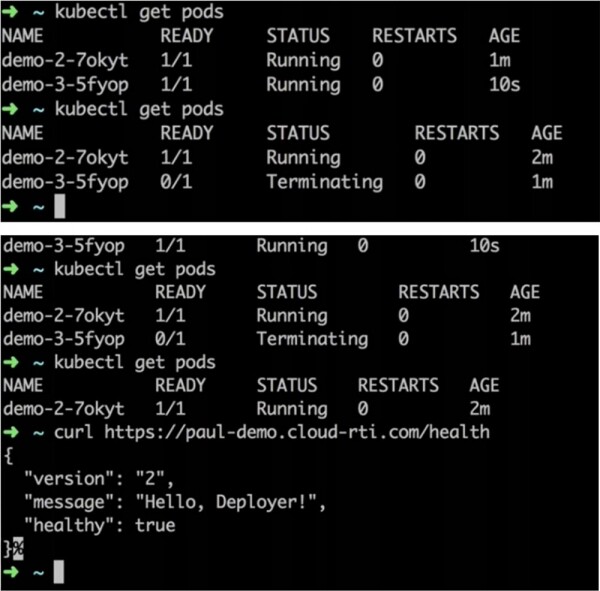
Det gode ved dette er, at selv hvis du har et stort antal samtidige forespørgsler, der kommer ind i applikationen, vil de overhovedet ikke bemærke nedetid under implementeringsproceduren. Hvis man tester denne applikation med Gatling-rammen, som sender det maksimale antal forespørgsler til den, bliver ingen af disse forespørgsler droppet. Det betyder, at vores brugere slet ikke vil bemærke opdateringen af versionerne i realtid. Hvis det fejler, fortsætter driften med den gamle version. Hvis det lykkes, vil brugerne overgå til den nye version.
Der er kun én ting, der kan føre til fejl – hvis health check bestod, men applikationen fejler, så snart den modtager arbejdsbelastningen, det vil sige, at kollapsen kun vil indtræffe efter implementeringen er gennemført. I så fald skal du manuelt rulle tilbage til den gamle version. Således har vi set på, hvordan man bruger Kubernetes sammen med dedikerede open-source værktøjer til det. Implementeringsproceduren vil være meget simplere, hvis du integrerer disse værktøjer i Build/Deploy pipelines. Du kan bruge både brugergrænsefladen og helt automatisere denne proces, for eksempel ved at anvende commit til master.
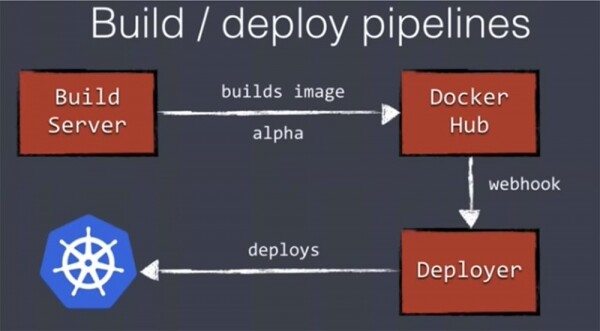
Vores Build Server vil oprette et Docker-image, uploade det til Docker Hub eller en anden registrering, du bruger. Docker Hub understøtter webhook, så vi kan starte en fjernimplementering via Deployer som beskrevet ovenfor. Dette gør det muligt at automatisere implementeringen af applikationen til potentiel produktion fuldstændigt.
Lad os gå videre til emnet for skalering af Kubernetes-klyngen. Jeg vil bemærke, at kubectl-kommandoen er en skalering-kommando. Med den kan man nemt øge antallet af replikaer i den eksisterende klynge. I praksis ønsker vi dog ofte at øge antallet af ikke pods, men noder.
I arbejdstiden kan du have behov for at øge antallet, mens det om natten, for at reducere omkostningerne ved Amazon-tjenesterne, kan være nødvendigt at reducere antallet af aktive programinstanser. Dette betyder ikke, at det er tilstrækkeligt kun at skalere antallet af pods, fordi selv hvis en af noderne er ubenyttet, skal du stadig betale for den til Amazon. Det vil sige, at du ud over at skalere pods også skal skalere antallet af anvendte maskiner.
Dette kan skabe udfordringer, fordi uanset om vi bruger Amazon eller en anden cloud-tjeneste, har Kubernetes ingen information om antallet af anvendte maskiner. Den mangler et værktøj til at skalere systemet på nodeniveau.
Så vi må tage os af både noderne og pods. Vi kan nemt skalere oprettelsen af nye noder ved hjælp af AWS API og autoskaleringsgrupper til at indstille antallet af arbejdsenheder i Kubernetes. Det er også muligt at bruge cloud-init eller et lignende script til at registrere noder i Kubernetes-klyngen.
Den nye maskine starter i Scaling-gruppen, registrerer sig som en node, registreres i masterregisteret og begynder at arbejde. Derefter kan antallet af replikaer øges til brug på de dannede noder. Nedskalering kræver større indsats, da det er nødvendigt at sikre, at denne handling ikke fører til ødelæggelse af allerede kørende applikationer efter frakobling af "unødvendige" maskiner. For at forhindre et sådant scenarie skal noderne bringes til status "unschedulable". Dette betyder, at planlæggeren som standard ved planlægning af DaemonSet-pods vil ignorere disse noder. Planlæggeren vil ikke slette noget fra disse servere, men vil heller ikke starte nye containere der. Det næste skridt er at dræne noden, hvilket indebærer at overføre kørende pods til en anden maskine eller andre noder, der har tilstrækkelig kapacitet til dette. Når det er bekræftet, at der ikke længere er nogen containere på disse noder, kan de slettes fra Kubernetes. For Kubernetes vil de derefter blot ophøre med at eksistere. Derefter skal AWS API bruges til at slukke for de unødvendige noder eller maskiner.
Du kan bruge Amdatu Scalerd — et andet open-source værktøj til skalering, der ligner AWS API. Det leverer CLI til at tilføje eller fjerne noder i klyngen. En interessant funktion ved det er muligheden for at konfigurere planlæggeren med følgende json-fil.
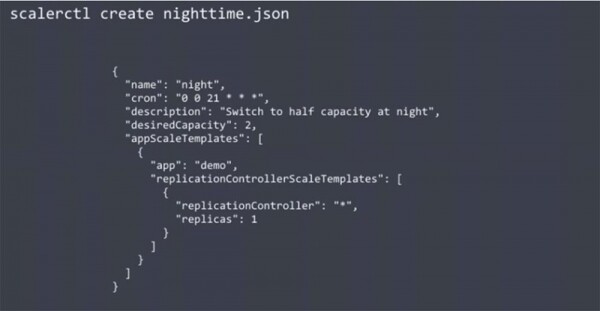
Den viste kode reducerer halvdelen af klyngens kapacitet i natperioden. Den er konfigureret både med antallet af nuværende replikaer og den ønskede kapacitet i Amazon-klyngen. Brug af denne planlægger vil automatisk reducere antallet af noder om natten og øge dem om morgenen, hvilket sparer omkostningerne ved at bruge noder i en cloud-service som Amazon. Denne funktion er ikke indbygget i Kubernetes, men brug af Scalerd vil give dig mulighed for at skalere denne platform, som du vil.
Jeg vil gerne påpege, at mange mennesker siger til mig: "Alt dette er godt, men hvad med min database, som normalt befinder sig i en statisk tilstand?" Hvordan kan man køre noget lignende i et så dynamisk miljø som Kubernetes? Efter min mening bør du ikke gøre det; du bør ikke forsøge at organisere datalagring i Kubernetes. Teknisk set er det muligt, og der er vejledninger om emnet på internettet, men det vil alvorligt komplicere dit liv.
Ja, i Kubernetes findes der begrebet vedholdende lagringsløsninger, og du kan forsøge at køre datalagringsløsninger som Mongo eller MySQL, men det er en ret ressourcekrævende opgave. Dette skyldes, at datalagringsløsninger ikke fuldt ud understøtter interaktionen med dynamiske miljøer. De fleste databaser kræver betydelig konfiguration, herunder manuel cluster-konfiguration, og de kan ikke lide autoskalering og lignende.
Derfor bør du ikke komplicere dit liv ved at forsøge at køre datalagring i Kubernetes. Organiser deres drift på den traditionelle måde ved at bruge velkendte tjenester og lad Kubernetes få mulighed for at anvende dem.
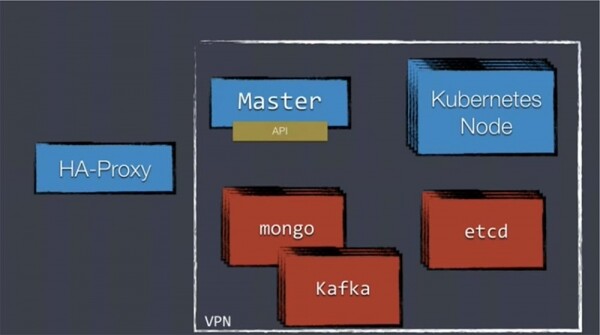
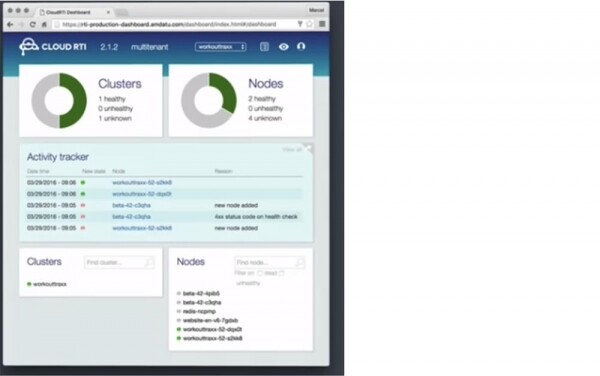
Til slut vil jeg introducere jer for platformen Cloud RTI baseret på Kubernetes, som mit team arbejder på. Den giver centraliseret logføring, applikations- og clusterovervågning og har mange andre nyttige funktioner, som du får brug for. Den bruger forskellige open-source værktøjer, såsom Grafana til overvågning.
Der blev stillet et spørgsmål om, hvorfor man skulle bruge en load balancer ha-proxy med Kubernetes. Det er et godt spørgsmål, for i øjeblikket findes der 2 niveauer af load balancing. Kubernetes-tjenester forbliver stadig på virtuelle IP-adresser. Du kan ikke bruge dem til portene på eksterne værtmaskiner, fordi hvis Amazon overbelaster sin cloud-vært, ændres adressen. Derfor placerer vi ha-proxy foran tjenesterne — for at skabe en mere statisk struktur for uafbrudt trafikinteraktion med Kubernetes.
Et andet godt spørgsmål – hvordan kan man håndtere ændringer i databasen under blue/green deployment? Uanset om du bruger Kubernetes, er det en kompleks opgave at ændre databasen. Du skal sikre, at den gamle og den nye skema er kompatible, hvorefter du kan opdatere databasen og derefter opdatere selve applikationerne. Du kan udføre 'hot swapping' af databasen og derefter opdatere applikationerne. Jeg kender folk, der har indlæst et helt nyt databasekluster med det nye skema, hvilket er en mulighed, hvis du har en schema-less database som Mongo, men det er under alle omstændigheder ikke en simpel opgave. Hvis der ikke er flere spørgsmål, tak for opmærksomheden!
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
