

Hej alle sammen! Mit navn er Oleg Sidorenkov, og jeg arbejder som leder af infrastrukturteamet hos DomClick. Vi har været i gang med at køre 'Kuben' i produktion i over tre år, og i løbet af den tid har vi oplevet mange forskellige interessante øjeblikke. I dag vil jeg fortælle jer, hvordan man med den rette tilgang kan presse endnu mere ydeevne ud af 'vanilje' Kubernetes til jeres klynge. Klar, parat, gå!
I kender alle godt til, at Kubernetes er et skalerbart system med åben kildekode til orkestrering af containere; eller 5 binære filer, der udfører magi ved at styre livscyklus for jeres mikrotjenester i servermiljøet. Desuden er det et ret fleksibelt værktøj, som kan samles som et Lego-sæt for maksimal tilpasning til forskellige opgaver.
Og det ser ud til at fungere godt: smid servere ind i klyngen som brænde i ovnen, og vær ikke bekymret. Men hvis du tænker på miljøet, vil du overveje: 'Hvordan kan jeg holde ilden i ovnen i gang og samtidig skåne skoven?'. Med andre ord, hvordan finde måder at forbedre infrastrukturen og reducere omkostningerne.
1. Hold øje med ressourcerne for teams og applikationer
En af de mest banale, men effektive metoder er at indføre requests/limits. Del applikationerne op i namespaces, og del namespaces op efter udviklingsteam. Angiv for applikationen før deployment værdierne for CPU-forbrug, hukommelse og ephemeral lager.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Vi er erfaret kommet frem til, at man ikke bør overdrive requests i forhold til limits med mere end det dobbelte. Størrelsen på klyngen beregnes ud fra requests, og hvis du angiver en forskel i ressourcer for applikationer, f.eks. 5-10 gange, så forestil dig, hvad der sker med din node, når den fyldes med pods og pludselig får belastning. Intet godt. Som minimum throttling, og som maksimum, kan du sige farvel til workeren og opleve cyklisk belastning på de andre noder, når pods begynder at flytte rundt.
Derudover, ved hjælp af limitranges kan du i starten angive ressourcemyderne for containeren — minimum, maksimum og standard:
➜  ~ kubectl beskrive limitranges --namespace ops
Navn:       limit-range
Namespace:  ops
Type        Ressource           Min   Max   Standard Anmodning  Standard Grænse  Max Grænse/Anmodnings Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Husk at begrænse ressourcerne i namespace, så et hold ikke kan tage alle ressourcerne i klyngen:
➜  ~ kubectl beskrive resourcequotas --namespace ops
Navn:                   resource-quota
Namespace:              ops
Ressource                Bruges          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Som det fremgår af beskrivelsen resourcequotas, hvis holdet ops ønsker at implementere pods, der vil forbruge yderligere 10 cpu, vil planlæggere ikke tillade dette og give en fejlmeddelelse:
Fejl ved oprettelse: pods "nginx-proxy-9967d8d78-nh4fs" er forbudt: overskredet kvote: resource-quota, anmodet: limits.cpu=5, requests.cpu=5, brugt: limits.cpu=77250m, requests.cpu=53850m, begrænset: limits.cpu=10, requests.cpu=10For at løse en sådan opgave kan man skrive et værktøj, for eksempel som , der kan gemme og commite tilstanden af ressourcerne for hold.
2. Vælg det optimale filsystem
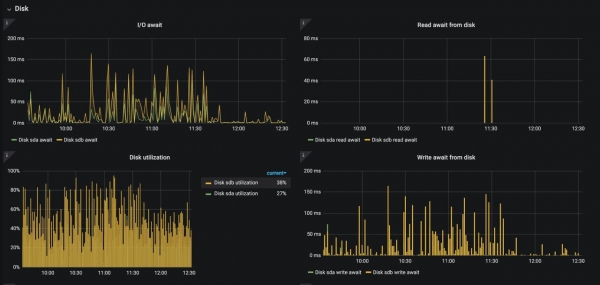
Her vil jeg gerne berøre emnet persistent volumes og disk subsystems i Kubernetes worker-noder. Jeg håber, at ingen bruger "Kube" på HDD i produktion, men nogle gange er selv almindelige SSD'er ikke tilstrækkelige. Vi har stået over for det problem, at logs dræbte disken ved input-output operationer, og her er mulighederne for løsninger ikke mange:
Brug højtydende SSD'er eller skift til NVMe (hvis du selv råder over dit hardware).
Reducer niveauet for logning.
Lav en "intelligent" belastningsbalancering af pods, der nedslår disken (
podAntiAffinity).
Skærmbilledet ovenfor viser, hvad der sker med nginx-ingress-controlleren med disken, når access_logs logning er aktiveret (~12 tusinde logs/sek.). Denne tilstand kan naturligvis føre til forringelse af alle applikationer på denne node.
Hvad angår PV, desværre har jeg ikke prøvet alle Bestandige volumener. Brug den bedste mulighed, der passer til dig. Historisk set har en lille del af tjenesterne haft brug for RWX-volumener, og derfor er NFS-lagring blevet brugt til dette formål. Billigt og… tilstrækkeligt. Selvfølgelig har vi haft vores del af problemer — men vi har lært at optimere det, og vi har ikke længere hovedpine. Hvis muligt, skift til S3 objektlager.
3. Saml optimerede billeder
Det er bedst at bruge containeroptimerede billeder, så Kubernetes hurtigere kan hente dem og mere effektivt udføre dem.
Optimering betyder, at billederne:
indeholder kun én applikation eller udfører kun én funktion;
er små i størrelse, fordi store billeder overfører langsommere over netværket;
har endepunkter til sundhedstjek og beredskab, som Kubernetes kan bruge til at tage handling i tilfælde af nedetid;
bruger containervenlige operativsystemer (som Alpine eller CoreOS), som er mere modstandsdygtige over for konfigurationsfejl;
bruger multi-trins opbygninger, så du kun kan implementere kompilere applikationer uden ledsagende kildekoder.
Der findes mange værktøjer og tjenester, der giver dig mulighed for at kontrollere og optimere billeder i realtid. Det er vigtigt at holde dem opdateret og sikkerhedstestede. I sidste ende får du:
Nedsættelse af netværksbelastningen på hele klyngen.
Reducering af opstartstiden for containeren.
Mindre volumen af hele din Docker registry.
4. Brug DNS-cache
Når vi taler om høje belastninger, er det ret problematisk at leve uden tuning af klyngens DNS-system. For længe siden understøttede udviklerne af Kubernetes deres egen løsning kube-dns. Det blev implementeret hos os, men denne software blev ikke finjusteret og ydede ikke den nødvendige ydeevne, selvom opgaven syntes enkel. Så kom coredns, som vi skiftede til, og vi oplevede ikke flere problemer, og senere blev det standard DNS-tjenesten i K8s. På et tidspunkt nåede vi 40.000 rps til DNS-systemet, og denne løsning var også utilstrækkelig. Men heldigvis blev Nodelocaldns, også kendt som node local cache, introduceret. .
Hvorfor bruger vi det? Der er en fejl i Linux-kernen, der ved flere anmodninger gennem conntrack NAT over UDP fører til en race til at skrive i conntrack-tabellerne, og en del af trafikken gennem NAT går tabt (hver anmodning gennem Service er NAT). Nodelocaldns løser dette problem ved at eliminere NAT og opgradere forbindelsen til TCP til upstream DNS samt lokal caching af DNS-anmodninger til upstreams (inklusive en kort negativ cache på 5 sekunder).
5. Skaler pods horisontalt og vertikalt automatisk
Kan du med sikkerhed sige, at alle dine mikrotjenester er klar til en to- til tre-dobbelt stigning i belastningen? Hvordan tildeler du ressourcer korrekt til dine applikationer? At have et par pods kørende ud over den arbejdsbyrde kan vise sig at være overflødigt, mens at køre dem helt tæt kan risikere nedetid ved pludselig stigning i trafikken til tjenesten. Guldmidten hjælpes med at opnå gennem magi af multiplikation ved sådanne tjenester som og .
VPA muliggør automatisk justering af requests/limits for dine containere i en pod baseret på faktisk brug. Hvordan kan det være nyttigt? Hvis du har pods, der af en eller anden grund ikke kan skaleres horisontalt (hvilket ikke er helt pålideligt), kan du overveje at overlade ændringen af ressourcerne til VPA. Dets funktion er baseret på et anbefalingssystem, der bruger historiske og aktuelle data fra metric-serveren, så hvis du ikke ønsker at ændre requests/limits automatisk, kan du blot overvåge de anbefalede ressourcer for dine containere og optimere indstillingerne for at spare CPU og hukommelse i klyngen.
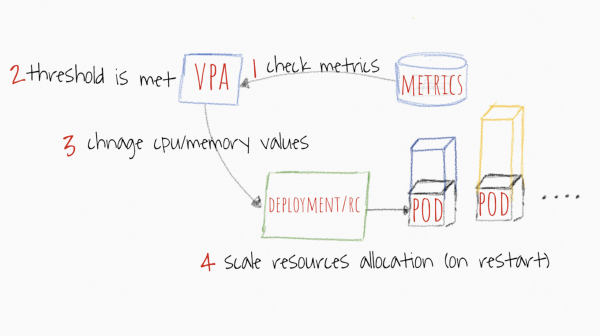 Billedet er hentet fra https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Planlæggeren i Kubernetes er altid baseret på requests. Uanset hvilken værdi du angiver, vil planlæggeren lede efter en passende node ud fra det. Begrænsningsværdierne er nødvendige for kubelet for at forstå, hvornår det skal throttle eller stoppe en pod. Og da den eneste vigtige parameter er requests-værdien, vil VPA arbejde med den. Hver gang du angiver vertikal skalering af applikationen, definerer du, hvad requests skal være. Hvad med limits? Denne parameter vil også blive skaleret proportionalt.
For eksempel er her almindelige indstillinger for en pod:
ressourcer:
   anmodninger:
     hukommelse: 250Mi
     cpu: 200m
   grænser:
     hukommelse: 500Mi
     cpu: 350m
Anbefalingssystemet bestemmer, at din applikation kræver 300m CPU og 500Mi for at fungere korrekt. Du får følgende indstillinger:
ressourcer:
   anmodninger:
     hukommelse: 500Mi
     cpu: 300m
   grænser:
     hukommelse: 1000Mi
     cpu: 525m
Som nævnt tidligere er dette en proportional skalering baseret på forholdet mellem anmodninger/grænser i manifestet:
CPU: 200m → 300m: forhold 1:1.75;
Hukommelse: 250Mi → 500Mi: forhold 1:2.
Hvad angår HPA, så her er arbejdsmetoden mere gennemsigtig. Der indstilles tærskelværdier for metrikker, eksempelvis CPU og hukommelse, og hvis gennemsnittet af alle replikaer overstiger tærsklen, skaleres applikationen op med +1 pod, indtil værdien falder under tærsklen, eller indtil det maksimale antal replikaer er nået.
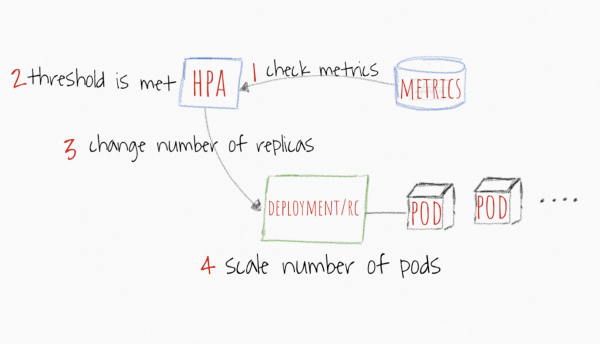 Billedet er hentet fra https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Ud over de almindelige metrikker som CPU og hukommelse kan du konfigurere tærskler baseret på dine brugerdefinerede metrikker fra Prometheus og arbejde med dem, hvis du mener, det er den mest præcise måde at bestemme, hvornår du skal skalere din applikation. Når applikationen stabiliseres under den angivne metrikgrænse, vil HPA begynde at skalere pods ned til det minimale antal replikaer eller til en tilstand, hvor belastningen opfylder den angivne tærskel.
6. Glem ikke Node Affinity og Pod Affinity
Ikke alle noder arbejder på ens udstyr, og ikke alle pods skal køre applikationer, der kræver intensive beregninger. Kubernetes tillader specialisering af noder og pods ved hjælp af Node Affinity og Pod Affinity.
Hvis du har noder, der er velegnede til beregningstunge operationer, er det bedst at binde applikationer til de relevante noder for maksimal effektivitet. Brug nodeSelector med nodeskilt.
Lad os sige, du har to noder: en med CPUType=HIGHFREQ og et stort antal hurtige kerner, den anden med MemoryType=HIGHMEMORY et stort antal hukommelse og højere ydeevne. Det er nemmest at tildele deployment af en pod til noden HIGHFREQ, ved at tilføje denne vælger i sektionen spec :
…
nodeSelector:
	CPUType: HIGHFREQ
En dyrere og mere specifik måde at gøre dette på er at bruge nodeAffinity i feltet affinity i sektionen spec. Der er to muligheder:
requiredDuringSchedulingIgnoredDuringExecution: hård indstilling (planlægningssystemet vil kun deployere pods på specifikke noder (og ingen andre));preferredDuringSchedulingIgnoredDuringExecution: blød konfiguration (planlæggeren vil forsøge at distribuere til specifikke noder, og hvis det ikke er muligt, vil det forsøge at distribuere til den næste tilgængelige node).
Du kan angive en bestemt syntaks til kontrol af node-tags, for eksempel, In, NotIn, Exists, DoesNotExist, Gt eller Lt. Men husk, at komplekse metoder med lange lister af tags vil bremse beslutningsprocessen i kritiske situationer. Med andre ord, gør ikke tingene mere komplicerede.
Som nævnt tidligere giver Kubernetes mulighed for at angive bindende af nuværende pods. Det vil sige, at du kan sikre, at bestemte pods arbejder sammen med andre pods i samme tilgængelighedszone (relevant for skyen) eller noder.
I podAffinity felter affinity i sektionen spec de samme felter er tilgængelige som i tilfælde af nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution og preferredDuringSchedulingIgnoredDuringExecution. Den eneste forskel er, at matchExpressions binder pods til den node, hvor der allerede kører en pod med det samme tag.
Derudover tilbyder Kubernetes et felt podAntiAffinity, som derimod ikke binder en pod til en node med bestemte pods.
Når det kommer til udtryk, nodeAffinity kan man give den samme rådgivning: forsøg at bevare enkelhed og logik i reglerne, og prøv ikke at overbelaste specifikationen af pods med et komplekst regelsæt. Det er meget let at skabe en regel, der ikke vil overholde betingelserne i klyngen, hvilket skaber unødvendig belastning på planlæggeren og reducerer den samlede ydeevne.
7. Taints & Tolerations
Der er endnu en metode til at styre planlæggeren. Hvis du har en stor klynge med hundrede noder og tusinder af mikrotjenester, er det meget svært ikke at tillade bestemte pods at placeres på bestemte noder.
Det hjælper med mekanismen for taints — forbudte regler. For eksempel kan det i visse scenarier være nødvendigt at forbyde bestemte noder at køre pods. For at anvende en taint til en specifik node skal du bruge muligheden taint i kubectl. Angiv nøgle og værdi, og derefter en taint såsom eller NoSchedule:
NoExecute$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoSchedule i kubectl. Angiv nøgle og værdi, og derefter en taint såsom, NoSchedule og Det er også værd at bemærke, at mekanismen for taint understøtter tre grundlæggende effekter:.
i kubectl. Angiv nøgle og værdi, og derefter en taint såsomPreferNoSchedulebetyder, at så længe der ikke er en tilsvarende post i podspecifikationentolerations, vil den ikke kunne distribueres på noden (i dette eksempel).Det er også værd at bemærke, at mekanismen for taint understøtter tre grundlæggende effekter:node10i kubectl. Angiv nøgle og værdi, og derefter en taint såsom— en forenklet version.betyder, at så længe der ikke er en tilsvarende post i podspecifikationenI dette tilfælde vil planlæggeren forsøge at undgå at distribuere pods, som ikke har den tilsvarende post, på noden, men det er ikke en streng begrænsning. Hvis der ikke er ressourcer i klyngen, vil pods begynde at blive distribueret på denne node.NoSchedule— denne effekt udløser en øjeblikkelig evakuering af pods, som ikke har en tilsvarende optegnelse.betyder, at så længe der ikke er en tilsvarende post i podspecifikationen.
Det er interessant, at en sådan adfærd kan annulleres ved hjælp af toleration-mekanismen. Dette er praktisk, når der er en "forbudt" node, og du kun vil placere infrastrukturtjenester på den. Hvordan gør man det? Tillad kun de pods, der har en passende toleration.
Sådan vil pod-specifikationen se ud:
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Det betyder ikke, at ved næste redeployment vil pod'en nødvendigvis lande på denne node, det er ikke en Node Affinity mekanisme, og nodeSelector. Men ved at kombinere flere funktioner kan du opnå en meget fleksibel konfiguration af planlæggeren.
8. Konfigurer prioritet for deployment af pods
Det, at du har konfigureret bindingen af pods til noder, betyder ikke, at alle pods skal behandles med samme prioritet. For eksempel kan du ønske at deploying nogle pods før andre.
Kubernetes tilbyder forskellige måder at justere prioriteringen af pods (Pod Priority and Preemption). Konfigurationen består af flere dele: objektet PriorityClass og beskrivelsen af feltet priorityClassName i pod-specifikationen. Lad os se på et eksempel:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Denne prioritet klasse bør kun bruges til meget vigtige pods"
Vi opretter PriorityClass, giver det et navn, en beskrivelse og en værdi. Jo højere value, jo højere prioritet. Værdien kan være et hvilket som helst 32-bit heltal, mindre eller lig med 1.000.000.000. Højere værdier er reserveret til kritisk vigtige system-pods, som normalt ikke kan blive fordrevet. Fordrivelse vil kun finde sted, hvis der ikke er nogen steder for en højt prioriteret pod at deployere, da en del af pods fra en bestemt node vil blive evakueret. Hvis denne mekanisme er for streng for dig, kan du tilføje indstillingen preemptionPolicy: Never, og så vil der ikke være nogen fordrivelse, pod'en vil stå først i køen og vente på, at planlæggeren finder frie ressourcer til den.
Derefter opretter vi en pod, hvor vi angiver navnet priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Du kan oprette så mange prioritetsklasser, du ønsker, men det anbefales at holde sig til et begrænset antal (for eksempel lav, medium og høj prioritet).
På denne måde kan du, hvis det er nødvendigt, forbedre effektiviteten af udrulningen af kritiske tjenester såsom nginx-ingress-controller, coredns osv.
9. Optimer ETCD-klusteret
ETCD kan betragtes som hjernen i hele klusteret. Det er meget vigtigt at holde denne database i god stand, da hastigheden af operationerne i "Kube" afhænger af den. En standardløsning, der samtidig er en god løsning, er at holde ETCD-klusteret på master-noderne for at have minimal latens til kube-apiserver. Hvis det ikke er muligt, så placér ETCD så tæt som muligt med god båndbredde mellem deltagerne. Vær også opmærksom på, hvor mange noder fra ETCD der kan falde fra uden skade på klusteret.
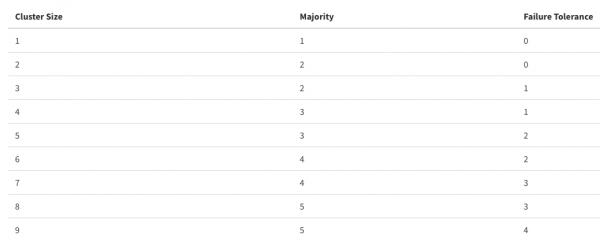
Husk, at en overdreven stigning i antallet af deltagere i klusteret kan forbedre fejlfindingskapaciteten på bekostning af ydeevnen, alt skal være i balance.
Når det kommer til konfigurationen af tjenesten, er der ikke mange anbefalinger:
Hav godt udstyr, afhængigt af klusterets størrelse (du kan læse mere ).
Justér nogle parametre, hvis du har spredt klusteret over et par datacentre, eller hvis dit netværk og dine diske lader meget tilbage at ønske (du kan læse mere ).
Konklusion
I denne artikel beskrives de punkter, som vores team prøver at overholde. Dette er ikke en trin-for-trin beskrivelse af handlinger, men forslag, der kan være nyttige til at optimere omkostningerne i klusteret. Det er klart, at hvert kluster er unikt, og konfigurationsløsninger kan variere meget, så vi ville være interesserede i at høre din feedback: hvordan holder du øje med dit Kubernetes-kluster, og hvordan forbedrer du dets ydeevne? Del din erfaring i kommentarfeltet, det vil være interessant at høre.
Kilde: habr.com
