

Hej alle sammen! Vi har gode nyheder, i juni genoptager OTUS igen kurset , og i den forbindelse deler vi traditionelt nyttigt materiale med jer.
Hvis du har stødt på hele denne historie om mikroservices uden nogen kontekst, kan det være forståeligt, at du finder det en smule mærkeligt. At opdele en applikation i fragmenter, der er forbundet via et netværk, betyder uundgåeligt at tilføje komplekse fejlbeskyttelsesmetoder til det resulterende distribuerede system.
Selvom denne tilgang involverer opdeling i mange uafhængige tjenester, er det overordnede mål meget mere end bare at få disse tjenester til at køre på forskellige maskiner. Det handler om at interagere med den omgivende verden, som i sin essens også er distribueret. Ikke i teknisk forstand, men snarere i betydningen af et økosystem, som består af mange mennesker, teams, programmer, og at hver af disse dele på en eller anden måde skal udføre deres arbejde.
Virksomheder, for eksempel, udgør et sæt distribuerede systemer, der tilsammen bidrager til at opnå et bestemt mål. Vi har ignoreret denne kendsgerning i årtier, hvor vi har forsøgt at opnå integration ved at overføre filer via FTP eller bruge værktøjer til virksomhedsintegração, mens vi har fokuseret på vores egne isolerede mål. Men med ankomsten af tjenester blev alt ændret. Tjenester har hjulpet os med at se ud over horisonten og se en verden af indbyrdes afhængige programmer, der arbejder sammen. Men for at have succes skal man forstå og designe to fundamentalt forskellige verdener: den ydre verden, hvor vi lever i et økosystem af mange andre tjenester, og vores personlige, indre verden, hvor vi hersker alene.
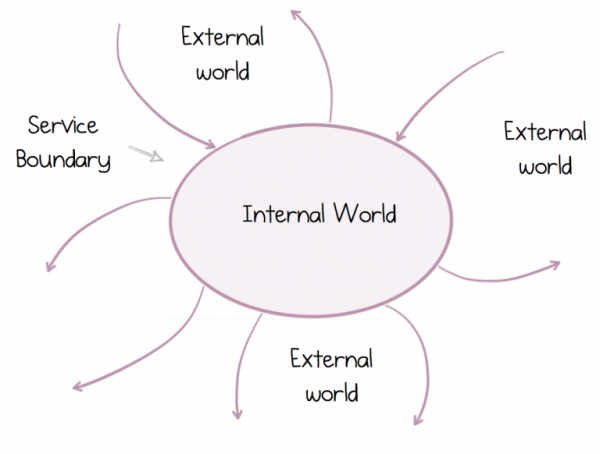
Denne distribuerede verden adskiller sig fra den, vi voksede op i og er vant til. Principperne for opbygning af traditionel monolitisk arkitektur holder ikke. Derfor er en korrekt forståelse af sådanne systemer mere end bare at lave et flot diagram på en hvid markeringsplade eller en imponerende proof of concept. Det handler om, at et sådant system fungerer effektivt over en lang periode. Heldigvis har tjenester eksisteret i lang tid, selvom de ser forskellige ud. de stadig relevante, selv når de er krydret med Docker, Kubernetes og let slidte hipster-skæg.
Så i dag vil vi se på, hvordan reglerne har ændret sig, hvorfor vi skal genoverveje vores tilgang til tjenesterne og dataene, de overfører til hinanden, og hvorfor vi får brug for helt anderledes værktøjer til dette.
Indkapsling vil ikke altid være din ven.
Mikrotjenester kan fungere uafhængigt af hinanden. Det er denne egenskab, der giver dem den største værdi. Denne egenskab muliggør også, at tjenester kan skaleres og vokse. Ikke så meget i betydningen at skalere til kvadrillioner af brugere eller petabytes af data (selvom de også kan hjælpe her), men i betydningen at skalere i forhold til mennesker, da teams og organisationer kontinuerligt vokser.
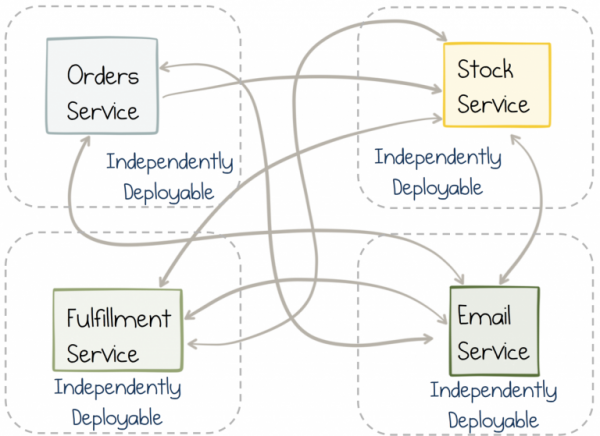
Dog er uafhængighed en tveægget sværd. Det vil sige, at en tjeneste kan køre let og ubesværet på egen hånd. Men hvis der i tjenesten implementeres en funktion, der kræver at inddrage en anden tjeneste, ender vi til sidst med at skulle ændre begge tjenester næsten samtidig. I en monolit er det let at gøre; du laver blot ændringen og sender den på udgivelse, men når det kommer til synkronisering af uafhængige tjenester, opstår der flere problemer. Samordning mellem teams og udgivelsescyklusser ødelægger fleksibiliteten.
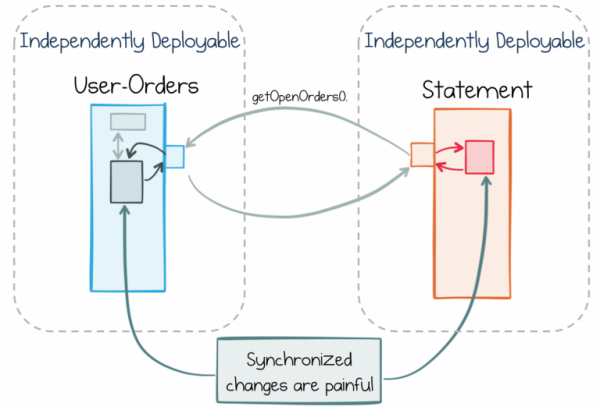
I den standardtilgang tilstræber man at undgå uhensigtsmæssige tværgående ændringer ved klart at adskille funktionaliteten mellem tjenesterne. En gateway-tjeneste kan være et godt eksempel her. Den har en klart defineret rolle, der adskiller den fra andre tjenester. En sådan klar opdeling betyder, at i en verden med hurtigt skiftende krav til de tjenester, den omgiver sig med, vil gateway-tjenesten næppe ændre sig. Den eksisterer inden for en strengt afgrænset kontekst.
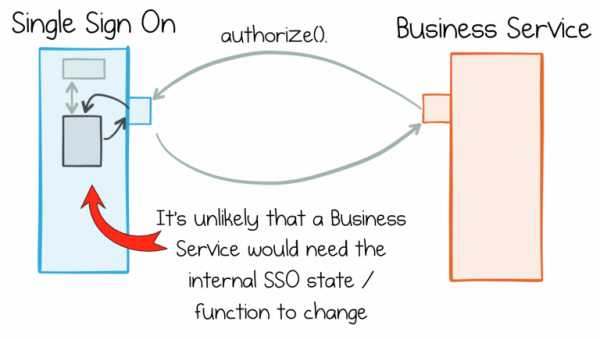
Problemet er, at i den virkelige verden kan forretningstjenester ikke konstant opretholde en klar opdeling af rollerne. For eksempel arbejder de samme forretningstjenester i højere grad med data, der kommer fra andre tilsvarende tjenester. Hvis du driver online detailhandel, vil håndteringen af ordreflowet, produktkataloget eller brugerinformation blive en nødvendighed for mange af dine tjenester. Hver tjeneste vil have brug for adgang til disse data for at fungere.
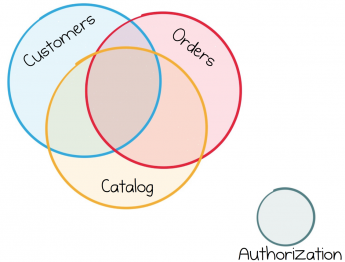
De fleste forretningstjenester bruger det samme datastrøm, så deres arbejde er altid sammenvævet.
Sådan kom vi til et vigtigt punkt, som det er værd at tale om. Mens tjenester fungerer godt for infrastrukturkomponenter, der arbejder i høj grad adskilt, viser det sig, at de fleste forretningstjenester er langt mere tæt sammenvævet.
Dichotomi af data
Tjenesteorienterede tilgange eksisterer muligvis allerede, men der er stadig lidt information om, hvordan man udveksler store datamængder mellem tjenester.
Det grundlæggende problem er, at data og tjenester er uadskillelige. På den ene side opfordrer indkapsling os til at skjule data for at adskille tjenester fra hinanden og gøre det lettere for dem at vokse og ændre sig. På den anden side har vi brug for at kunne dele og have kontrol over fælles data, ligesom med enhver anden. Det handler om at kunne gå i gang med arbejdet med det samme, lige så frit som i ethvert andet informationssystem.
Men informationssystemer har lidt til fælles med indkapsling. Faktisk er det ofte det modsatte. Databaser gør alt, hvad de kan, for at give adgang til de data, der er gemt i dem. De leveres med et kraftfuldt deklarativt interface, der gør det muligt at ændre data, som du har brug for. Denne funktionalitet er vigtig i forskningsfasen, men ikke til at styre den voksende kompleksitet af en konstant udviklende tjeneste.
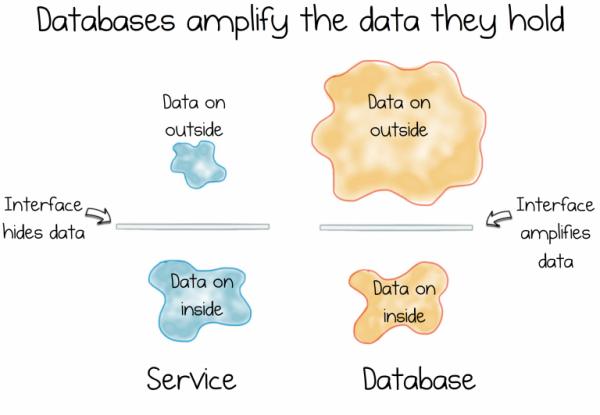
Og her opstår dilemmaet. Modsigelsen. Dichotomien. For informationssystemer handler om at levere data, mens tjenester handler om at skjule.
Disse to kræfter er grundlæggende. De ligger til grund for det meste af vores arbejde og kæmper konstant om overlegenhed i de systemer, vi skaber.
Mens service-systemer vokser og udvikler sig, ser vi forskellige manifestationer af konsekvenserne af data-dikotomien. Enten vil servicegrænsefladen vokse og tilbyde et stadigt bredere funktionalitetsudvalg og begynde at ligne en meget underlig skræddersyet database, eller også vil vi blive skuffede, og vi vil implementere en måde at udtrække eller overføre store datasæt fra service til service.
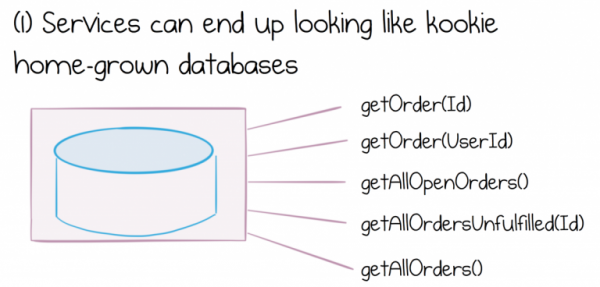
At skabe noget, der ligner en underlig skræddersyet database, vil på sin side føre til en række problemer. Vi vil ikke gå i detaljer om, hvad der er farligt ved shared database, bare sige, at det medfører betydelige og kostbare ingeniør- og drifts for virksomheder, der forsøger at anvende den.
Det værre er, at datamængderne forstærker problemerne med servicegrænser. Jo flere fælles data der er inden for en service, desto vanskeligere bliver det at navigere i grænsefladen, og desto sværere bliver det at samle datasæt, der kommer fra forskellige tjenester.
Et alternativt tilgang med at udtrække og overføre hele datasæt har også sine problemer. En almindelig tilgang til dette spørgsmål ser ud som simpelthen at udtrække og opbevare et datasæt helt og derefter gemme det lokalt i hver forbruger-service.
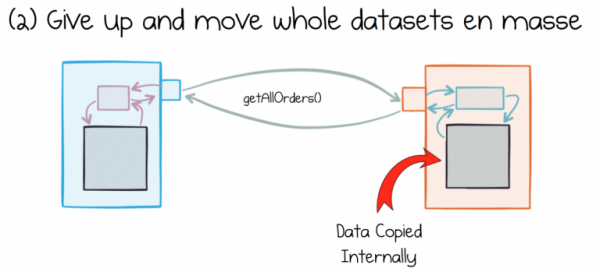
Problemet er, at forskellige services fortolker de data, de forbruger, forskelligt. Disse data er altid lige ved hånden. De ændres og behandles lokalt. Ret hurtigt mister de alt, hvad de havde tilfælles med dataene i kilden.
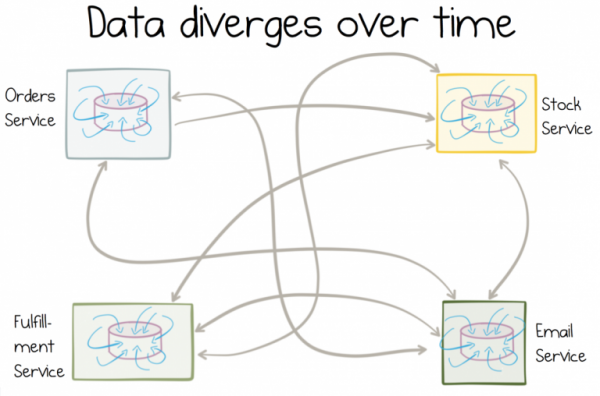
Jo mere mutable kopier er, desto mere vil data adskille sig over tid.
Hvad der er værre, er, at sådanne data er svære at rette op i retrospektivet ( her kan det virkelig komme til hjælp). Faktisk opstår nogle af de vanskeligt løselige teknologiske problemer, som virksomheder står over for, på grund af heterogene data, der multipliceres fra anvendelse til anvendelse.
For at finde en løsning på problemet med fælles data skal man tænke anderledes. De skal blive førstklassige objekter i de arkitekturer, vi bygger. kaldet sådanne data »eksterne« og dette er en meget vigtig egenskab. Vi har brug for indkapsling for ikke at afsløre den interne struktur af tjenesten, men vi skal lette tjenesterne adgang til de delte data, så de kan udføre deres arbejde korrekt.
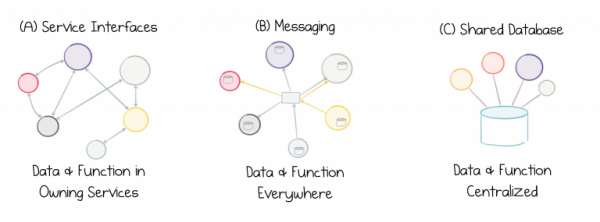
Problemet er, at ingen af tilgange i dag er relevante, fordi hverken tjenestegrænseflader, beskedudveksling eller Shared Database tilbyder en god løsning til håndtering af eksterne data. Tjenestegrænseflader er dårligt egnede til dataudveksling i enhver skala. Beskedudveksling flytter data, men opbevarer ikke deres historie, hvilket med tiden fører til beskadigede data. Shared Databases fokuserer for meget på en enkelt punkt, hvilket hæmmer udviklingen. Vi sidder uundgåeligt fast i en cyklus af datainvaliditet:
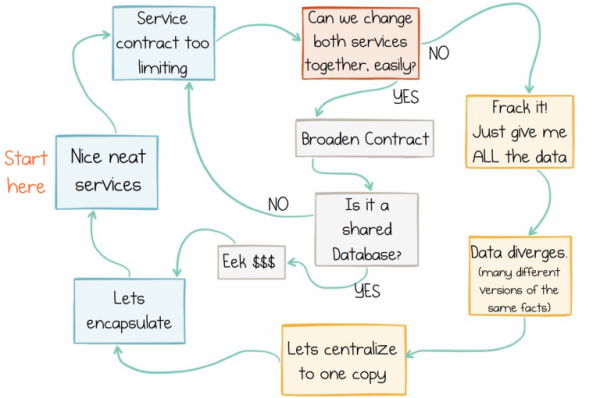
Cyklen af datainvaliditet
Strømme: en decentraliseret tilgang til data og tjenester
Ideelt set skal vi ændre tilgang til, hvordan tjenester arbejder med delte data. Lige nu står enhver tilgang overfor den nævnte dikotomi, da der ikke eksisterer noget magisk stof, som vi kan drysse over det og få det til at forsvinde. Men vi kan genoverveje problemet og komme til et kompromis.
Dette kompromis indebærer en vis grad af centralisering. Vi kan drage fordel af mekanismen med distribuerede logs, da den tilbyder pålidelige, skalerbare strømme. Nu skal tjenesterne kunne tilslutte sig og arbejde med disse delte strømme, men vi ønsker at undgå komplekse centraliserede God Services, der udfører en sådan behandling. Derfor er det bedste valg at indbygge strømbehandling i hver service-forbruger. På den måde kan tjenesterne kombinere datasæt fra forskellige kilder og arbejde med dem, som de ønsker.
En måde at opnå denne tilgang på er ved at bruge en streamingsplatform. Der findes mange muligheder, men i dag vil vi se nærmere på Kafka, da brugen af dens Stateful Stream Processing gør det muligt effektivt at løse det nævnte problem.
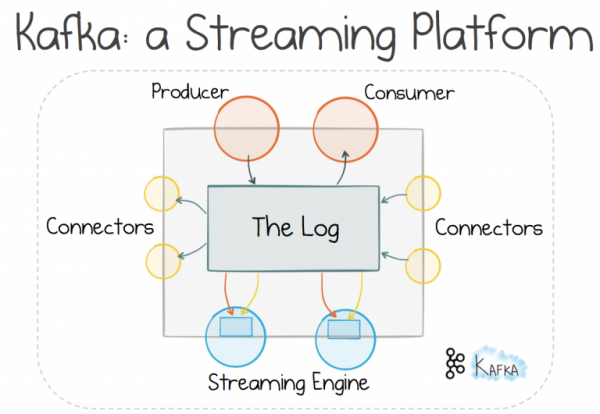
Brugen af mekanismen med distribueret logning gør det muligt for os at følge den fastslåede vej og bruge beskedudveksling til at arbejde med. . Det anses for, at denne tilgang sikrer bedre skalerbarhed og adskillelse end «forespørgsels-svar» mekanismen, da den giver kontrol over flowet til modtageren og ikke afsenderen. Men som med alt i livet, er der en pris, og du får brug for en mægler. Men for store systemer er denne kompromis det værd (hvad du ikke kan sige om dine gennemsnitlige webapplikationer).
Hvis en mægler håndterer distribueret logning i stedet for et traditionelt meddelelsessystem, kan du drage fordel af ekstra funktioner. Transporten kan næsten skaleres lineært lige så godt som et distribueret fils system. Data kan opbevares i loggene i lang tid, så vi får ikke kun meddelelser, men også et datalager. Et skalerbart lager uden frygt for at få et ændret samlet state.
Derefter kan mekanismen for stateful stream processing (behandling af strøm med bevarelse af tilstand) bruges til at tilføje deklarative databaseværktøjer til forbruger tjenester. Dette er en meget vigtig tanke. Mens data opbevares i fælles strømme, som alle tjenester kan få adgang til, er sammenskrivningen og behandlingen, som tjenesten udfører, privat. De er isolerede inden for en strengt afgrænset kontekst.
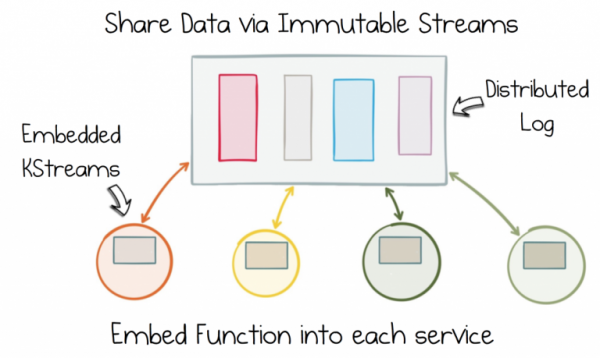
Slip af med datadikotomien ved at adskille den immaterielle tilstandsstrøm. Tilføj derefter denne funktion til hver service gennem Stateful Stream Processing.
Så hvis din service skal arbejde med ordrer, produktkataloget, lageret, vil den have fuld adgang: kun du vil beslutte, hvilke data der skal samles, hvor de skal behandles, og hvordan de bør ændre sig over tid. På trods af at dataene er fælles, er arbejdet med dem helt decentraliseret. Det sker inden for hver service, i en verden, hvor alt følger dine regler.
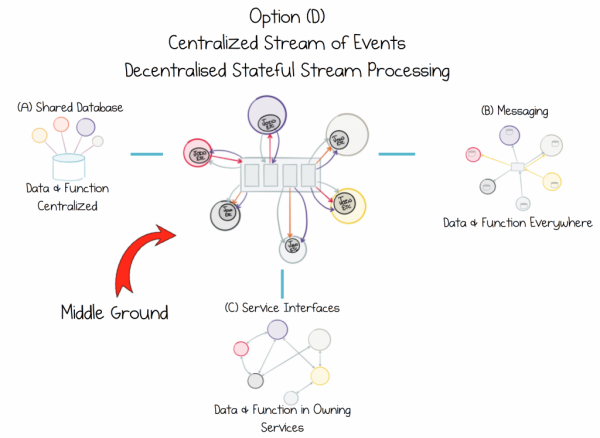
Del data på en måde, så deres integritet ikke kompromitteres. Kapsl funktionaliteten, ikke kilden, i hver service, som den er nødvendig for.
Det sker, at data skal flyttes i stor skala. Nogle gange har tjenesten brug for et lokalt historisk datasæt i den valgte databasebehandling. Pointen er, at man kan garantere, at en kopi kan genskabes fra kilden, når det er nødvendigt, ved at anmode om mekanismen for distribueret logføring. Connectorerne i Kafka klarer denne opgave glimrende.
Således har den tilgang, vi har set på i dag, flere fordele:
- Data bruges i form af fælles strømme, der kan opbevares længe i logfiler, og selve mekanismen til håndtering af fælles data er indlejret i hver enkelt kontekst, hvilket gør det muligt for tjenester at arbejde nemt og hurtigt. På denne måde kan man udligne dikotomien omkring data.
- Data, der kommer fra forskellige tjenester, kan nemt sammenlægges i sæt. Dette forenkler interaktionen med de fælles data og eliminerer behovet for at vedligeholde lokale datasæt i databasen.
- Stateful Stream Processing cache'er kun data, mens kilden til sandheden forbliver de fælles logs, dermed er problemet med datakorruption over tid ikke så presserende.
- I sin kerne styres tjenester af data, hvilket betyder, at på trods af den stadige vækst i datavolumenerne, kan tjenester stadig reagere hurtigt på forretningsbegivenheder.
- Skalerbarhedsproblemer påhviler brokeren og ikke tjenesterne. Dette reducerer betydeligt kompleksiteten ved at skrive tjenester, da der ikke er behov for at tænke på skalerbarhed.
- Tilføjelse af nye tjenester kræver ikke ændringer i de gamle, så tilslutning af nye tjenester bliver lettere.
Som du kan se, er dette mere end bare REST. Vi har fået et sæt værktøjer, der gør det muligt at arbejde med fælles data på en decentraliseret måde.
I dagens artikel er ikke alle aspekter blevet dækket. Vi skal stadig finde ud af, hvordan vi balancerer mellem 'forespørgsel-svar' paradigmet og det begivenhedsorienterede paradigm. Men dette vil vi se nærmere på næste gang. Der er emner, vi skal blive bedre bekendt med, for eksempel hvad der er så godt ved Stateful Stream Processing. Det vil vi tale om i den tredje artikel. Der findes også andre kraftfulde konstruktioner, som vi kan drage fordel af, hvis vi benytter os af dem, for eksempel, . Det ændrer spillereglerne for distribuerede forretningssystemer, da denne struktur giver transaktionelle garantier for i en skalerbar form. Dette vil blive drøftet i den fjerde artikel. Og endelig skal vi hurtigt gennemgå detaljerne i implementeringen af disse principper.
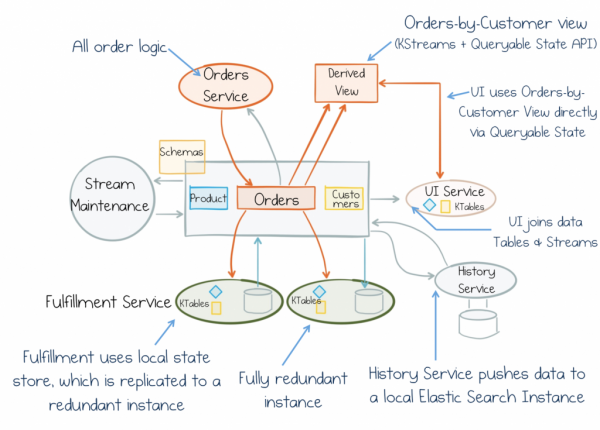
Men husk dette: datadichotomi er den styrke, vi står over for, når vi skaber forretningsservices. Vi må huske på det. Fokus er på at vende det hele på hovedet og begynde at betragte fælles data som førsteklasses objekter. Stateful Stream Processing giver en unik kompromis for dette. Det undgår centraliserede 'God Components', der hæmmer fremskridt. Desuden sikrer det hastighed, skalerbarhed og fejltolerance for datastreaming-pipelines og integrerer dem i hver service. Derfor kan vi fokusere på det fælles tankestrøm, som enhver service kan tilslutte sig og arbejde med dens data. På denne måde bliver services mere skalerbare, kompatible og autonome. Derfor vil de ikke kun se godt ud på whiteboards og under hypotesetests, men de vil også fungere og udvikle sig i årtier.
Kilde: habr.com
