

Da ClickHouse er et specialiseret system, er det vigtigt at tage højde for de særlige kendetegn ved dets arkitektur, når man bruger det. I denne præsentation vil Alexey diskutere typiske fejl ved brug af ClickHouse, som kan føre til ineffektiv drift. Gennem praktiske eksempler vil det blive vist, hvordan valget af en bestemt databehandlingsmetode kan ændre ydelsen markant.
Hej alle sammen! Jeg hedder Alexey, og jeg arbejder med ClickHouse.
For det første, så vil jeg straks glæde jer med, at jeg ikke vil fortælle om, hvad ClickHouse er i dag. Hvis jeg skal være ærlig, så er jeg træt af at gøre det. Jeg fortæller hver gang, hvad det er. Og sandsynligvis ved alle det allerede.
I stedet vil jeg fokusere på de mulige faldgruber, dvs. hvordan man kan bruge ClickHouse forkert. Man skal faktisk ikke være bange, for vi udvikler ClickHouse som et system, der er simpelt, brugervenligt og fungerer med det samme. Installeret og klar, ingen problemer.
Men man skal stadig tage højde for, at dette er et specialiseret system, og man kan let støde på usædvanlige anvendelsesscenarier, som kan bringe systemet ud af sin komfortzone.
Så, hvilke faldgruber findes der? Jeg vil primært tale om åbenlyse ting. Alt er åbenlyst for alle, og de kan glæde sig over, hvor kloge de er, mens de, der ikke forstår, vil lære noget nyt.
Det første, mest enkle eksempel, der desværre ofte ses, er et stort antal inserts med små batches, dvs. et stort antal små inserts.
Hvis vi ser på, hvordan ClickHouse udfører inserts, kan du sende en datastream på op til en terabyte i én forespørgsel. Det er ikke et problem.
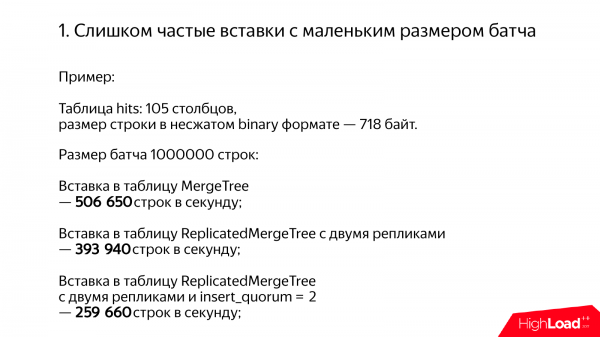
Lad os se på, hvad den typiske ydelse vil være. For eksempel har vi en tabel med data fra Yandex.Metrica. Hits. 105 forskellige kolonner. 700 byte i ukomprimeret form. Og vi vil indsætte i ordentlige batches af en million rækker.
Når vi indsætter i MergeTree-tabellen, får vi en halv million rækker per sekund. Fremragende. I den replicerede tabel bliver det lidt mindre, omkring 400.000 rækker i sekundet.
Og hvis vi aktiverer quorum-insert, får vi lidt mindre, men stadig en anstændig ydeevne, 250.000 rækker i sekundet. Quorum-insert er en uofficiel funktion i ClickHouse*.
* pr. 2020, .
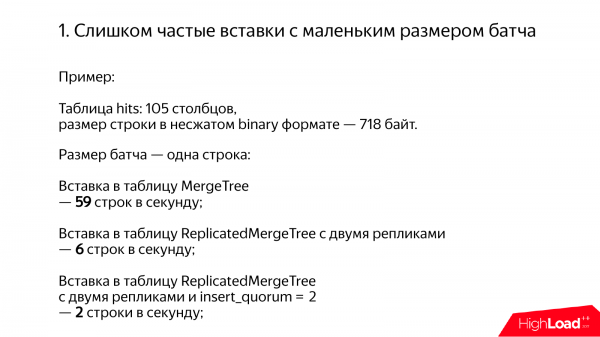
Hvad sker der, hvis man gør det dårligt? Vi indsætter en række ad gangen i MergeTree-tabellen, og det bliver til 59 rækker i sekundet. Det er 10.000 gange langsommere. I ReplicatedMergeTree er det 6 rækker i sekundet. Og hvis quorum også aktiveres, får man 2 rækker i sekundet. Jeg synes, det er virkelig en frygtelig situation. Hvordan kan man være så langsom? Jeg har endda en t-shirt, der siger, at ClickHouse ikke burde være langsom. Men alligevel sker det nogle gange.
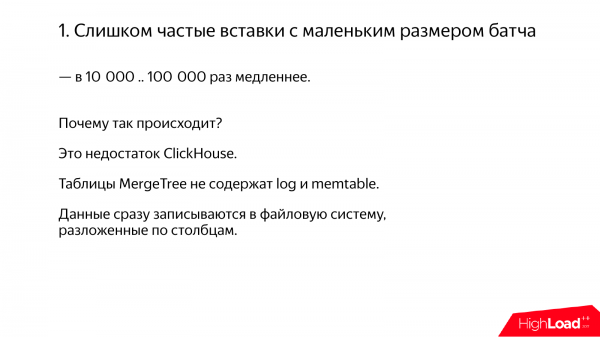
Faktisk er det vores fejl. Vi kunne sagtens have sørget for, at alt fungerede normalt, men det gjorde vi ikke. Og vi gjorde det ikke, fordi det ikke var nødvendigt for vores scenario. Vi havde allerede batches. Data kom ind i batches, og der var ingen problemer. Vi indsatte, og alt fungerede fint. Men selvfølgelig er der mange scenarier. For eksempel, når du har en masse servere, hvor data genereres. Og de indsætter data ikke så ofte, men der er stadig hyppige indsatser. Og det skal man på en eller anden måde undgå.
Fra et teknisk synspunkt er essensen, at når du laver en insert i ClickHouse, så lander dataene ikke i nogen memtable. Vi har ikke engang en rigtig log structure MergeTree, men blot en MergeTree, fordi der hverken er log eller memTable. Vi skriver simpelthen data direkte til filsystemet, allerede opdelt i kolonner. Og hvis du har 100 kolonner, skal over 200 filer skrives til en separat mappe. Det er hele vejen rundt ret besværligt.
Og spørgsmålet opstår: "Hvordan gør man det rigtigt?", hvis man har en situation, hvor man alligevel skal skrive data til ClickHouse.
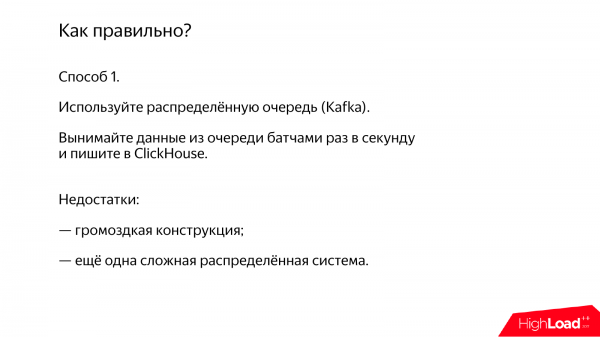
Metode 1. Det er den nemmeste metode. Brug en eller anden distribueret kø. For eksempel Kafka. Du trækker bare data ud fra Kafka, batcher hver sekund. Og så vil det fungere fint, du skriver, og det fungerer alle steder.
Ulemperne er, at Kafka er endnu et besværligt distribueret system. Jeg kan stadig forstå, hvis dit firma allerede har Kafka. Det er godt, det er praktisk. Men hvis det ikke er tilfældet, så skal du tænke grundigt over, inden du bringer endnu et distribueret system ind i dit projekt. Derfor bør du overveje alternativer.
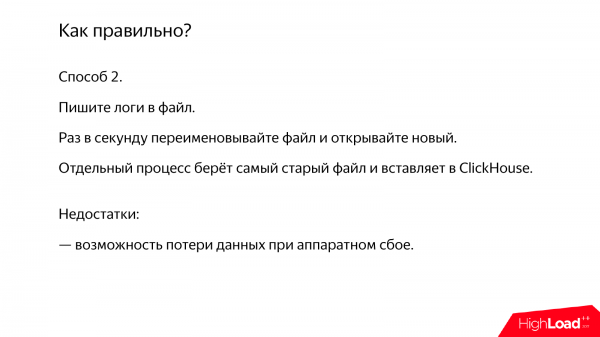
Metode 2. Her er et gammeldags alternativ, og samtidig meget simpelt. Har du en server, der genererer dine logs? Den gemmer blot dine logs i en fil. Og hver sekund for eksempel omdøber vi denne fil og åbner en ny. En separat script, enten via cron eller en daemon, tager den ældste fil og indsætter den i ClickHouse. Hvis logs gemmes hver sekund, fungerer det glimrende.
Men ulempe ved denne metode er, at hvis din server, der genererer logs, forsvinder et sted, så forsvinder dataene også.
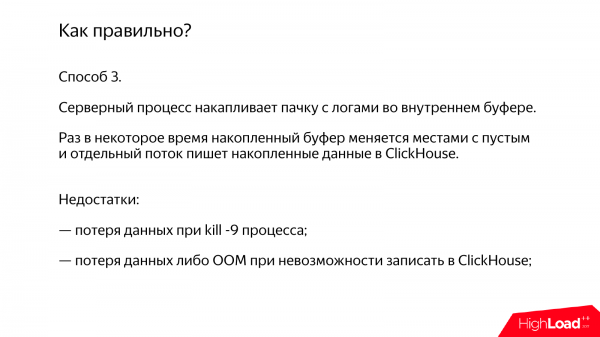
Metode 3. Der er en anden interessant metode, der overhovedet ikke bruger midlertidige filer. For eksempel, hvis du har en eller anden reklamegenerator eller en interessant daemon, der genererer data. Du kan samle en bunke data direkte i RAM, i en buffer. Og når der er gået tilstrækkelig med tid, gemmer du denne buffer, opretter en ny, og i en separat tråd indsætter du det, der allerede er blevet akkumuleret, i ClickHouse.
På den anden side forsvinder dataene også ved kill -9. Hvis din server går ned, mister du disse data. Og derudover er der et problem med, at hvis du ikke kunne skrive til databasen, vil dine data samle sig i RAM. Enten løber RAM'en tør, eller også mister du ganske enkelt dataene.
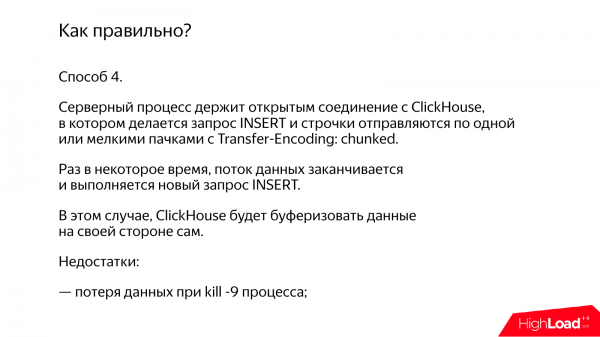
Metode 4. Endnu en interessant metode. Har du en serverprocess, der kan sende data til ClickHouse med det samme, men gøre det i ét forbindelse. For eksempel, sendte en http-anmodning med transfer-encoding: chunked med et insert. Og generere chunks ikke for sjældent, du kan sende hver linje, selvom der vil være overhead til framing af disse data.
Men alligevel, i dette tilfælde vil dataene blive sendt til ClickHouse med det samme. Og ClickHouse vil selv buffere dem.
Men også problemerne opstår. Nu vil du miste data, hvis din proces dræbes, og hvis ClickHouse-processen dræbes, fordi det vil være en ufuldstændig insert. I ClickHouse er inserts atomare op til en værdi, der er specificeret i rækkeantal. I princippet er det en interessant metode. Den kan også bruges.
Metode 5. Her er en interessant metode. Dette er en slags community-udviklet server til batch-databehandling. Jeg har ikke selv set på den, så jeg kan ikke garantere noget. Men for ClickHouse gives der heller ingen garantier. Dette er også open source, men på den anden side kunne du have vænnet dig til en vis standard for kvalitet, som vi arbejder på at sikre. Men for dette værktøj - jeg ved ikke, tag et kig på GitHub, se koden. Måske har de skrevet noget fornuftigt.
* pr. 2020 bør også overvejes .
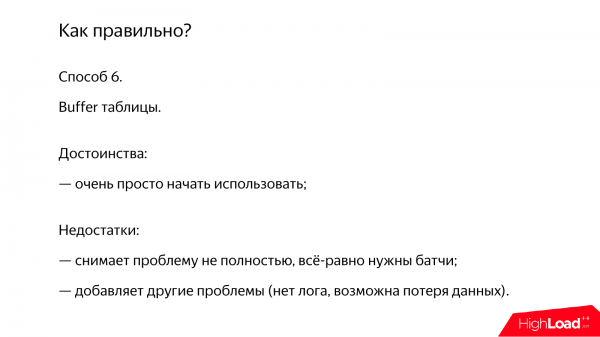
Metode 6. En anden metode er brugen af buffer-tabeller. Fordelen ved denne metode er, at det er meget nemt at begynde at bruge. Du opretter en buffer-tabel og indsætter i den.
Ulempen er, at problemet ikke løses helt. Hvis du indsætter med MergeTree-type, skal du gruppere dataene til en batch pr. sekund, men ved indsættelse i en buffer-tabel, skal du gruppere mindst til flere tusinde pr. sekund. Hvis der er mere end 10.000 pr. sekund, vil det stadig være dårligt. Og hvis du indsætter i batches, så har du set, at der kan komme hundrede tusinde rækker pr. sekund. Og det er allerede med ret tunge data.
Og buffer-tabeller har heller ikke en log. Hvis der er noget galt med din server, vil dataene gå tabt.
Og som en bonus har vi for nylig fået muligheden for at hente data fra Kafka i ClickHouse. Der findes en tabellmotor - Kafka. Du opretter bare en. Og du kan tilføje materialiserede synspunkter til den. I dette tilfælde vil den selv trække data fra Kafka og indsætte i de ønskede tabeller.
Og særligt glæder det mig, at denne mulighed ikke blev lavet af os. Det er en community-feature. Og når jeg siger "community-feature", mener jeg det uden nogen form for nedladende tone. Vi har læst koden, lavet anmeldelser, det burde fungere fint.
* pr. 2020 blev der tilføjet tilsvarende support for .
Hvad kan ellers være ubelejligt eller overraskende ved indsættelse af data? Hvis du laver en insert values-anmodning og i values skriver beregnede udtryk. For eksempel, now() - er dette også et beregnet udtryk. Og i dette tilfælde er ClickHouse nødt til at køre fortolkeren for disse udtryk for hver enkelt række, hvilket vil sænke ydelsen markant. Det er bedst at undgå dette.
* På nuværende tidspunkt er problemet fuldstændig løst, og der er ikke længere nogen regressionsproblemer med ydeevnen ved brug af udtryk i VALUES.
Et andet eksempel, hvor der kan opstå nogle problemer, er, når du har data i én batch, der relaterer sig til flere partitioner. Som standard er partitionerne i ClickHouse månedlige. Og hvis du indsætter en batch på en million rækker, og der er data fra flere år, vil du have flere ti partitioner. Det svarer til, at der vil være batches med flere ti dages størrelse, fordi de altid først opdeles efter partitioner indeni.
* For nylig blev der i ClickHouse i eksperimentel tilstand tilføjet understøttelse af et kompakt format for stykker og stykker i hukommelsen med write-ahead log, hvilket næsten helt løser problemet.
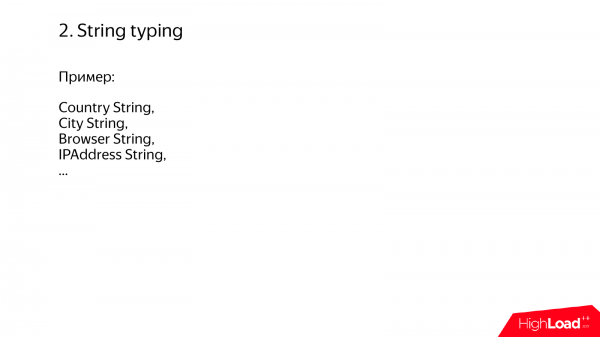
Lad os nu se på den anden type problem – datatyper.
Datatyper kan være strenge eller være af typen string. String-type er, når du bare har taget og erklæret, at alle dine felter er af typen string. Det er ikke en god idé. Sådan skal man ikke gøre.
Lad os finde ud af, hvordan man gør det rigtigt i de tilfælde, hvor man ønsker at sige, at et bestemt felt er en string, og lad os lade ClickHouse ordne det selv, uden at jeg skal bekymre mig. Men det er alligevel værd at gøre nogle anstrengelser.
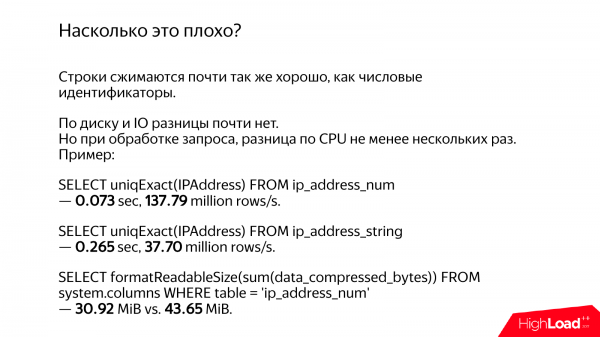
For eksempel har vi en IP-adresse. I ét tilfælde har vi gemt den som en string, f.eks. 192.168.1.1. I et andet tilfælde vil det være et tal af typen UInt32*. 32 bit er tilstrækkeligt til en IPv4 adresse.
For det første, som ikke er overraskende, vil dataene komprimere omtrent ens. Der vil være en forskel, selvfølgelig, men ikke så stor. Så der er ikke større problemer med diskindgangen-udgangen.
Men der er en alvorlig forskel i CPU-tid og udførelsestid for forespørgslen.
Lad os tælle antallet af unikke IP-adresser, hvis de gemmes som tal. Det bliver 137 millioner rækker i sekunder. Hvis det samme gøres som strenge, så vil det være 37 millioner rækker i sekunder. Jeg ved ikke, hvorfor så sammenfald er opnået. Jeg selv udførte disse forespørgsler. Men ikke desto mindre er det cirka 4 gange langsommere.
Og hvis vi beregner forskellen i plads på disken, er der også en forskel. Og forskellen er omkring en fjerdedel, fordi der er mange unikke IP-adresser. Og hvis her var strenge med et lille antal forskellige værdier, ville de nemt kunne komprimeres i en ordbog til omtrent samme volumen.
Og den firedobbelte forskel i tidsforbrug kan ikke ignoreres. Måske er det ligemeget for dig, men når jeg ser sådan en forskel, bliver jeg trist.
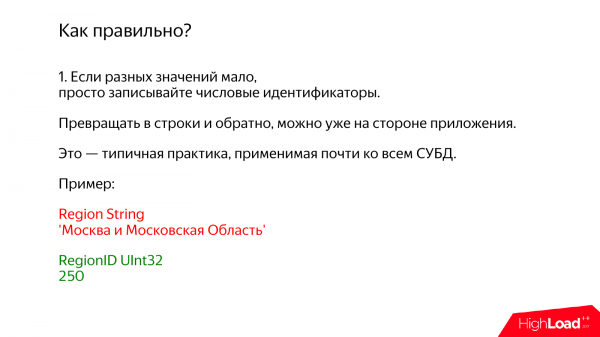
Lad os se på forskellige scenarier.
1. Et scenarie, hvor du har få forskellige unikke værdier. I dette tilfælde bruger vi en simpel praksis, som du sikkert kender og kan anvende på enhver DBMS. Det giver mening ikke kun for ClickHouse. Du indtaster blot numeriske identificatorer i databasen. Og konvertering til strenge og tilbage kan ske i din applikation.
For eksempel har du en region. Og du forsøger at gemme den som en streng. Og der vil stå: Moskva og MO. Når jeg ser, at der står 'Moskva', er det fint, men når der også står MO, så bliver jeg virkelig trist. Det handler jo om, hvor mange bytes der bruges.
I stedet gemmer vi blot nummeret Uint32 og 250. Vi har 250 i Yandex, men det kan være anderledes for dig. For god ordens skyld vil jeg nævne, at ClickHouse har indbygget funktionalitet til at arbejde med geodatabaser. Du indtaster blot et register med regioner, herunder hierarkisk, så der vil være Moskva, MO og alt, hvad du behøver. Og du kan konvertere det på forespørgselsniveau.
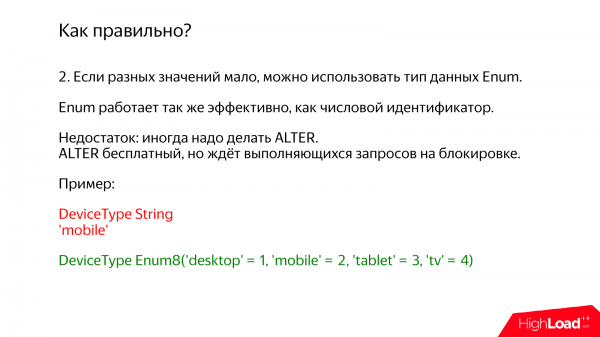
Den anden mulighed er temmelig lignende, men allerede med støtte inden for ClickHouse. Det er datatypen Enum. Du indtaster blot alle de værdier, du har behov for, inden for Enum. For eksempel enhedstype, hvor du skriver: desktop, mobil, tablet, tv. Kun 4 muligheder.
Ulempen er, at du jævnligt skal ændre. Du tilføjer blot én mulighed. Vi laver en ALTER TABLE. Faktisk er ALTER TABLE i ClickHouse gratis. Især gratis for Enum, fordi dataene på disken ikke ændres. Men ikke desto mindre kræver ALTER en lås på tabellen og skal vente, indtil alle SELECTs er gennemført. Og først derefter udføres ALTER, det vil sige, der er stadig nogle ulemper.
* i de nyeste versioner af ClickHouse, er ALTER helt ikke-blokerende.
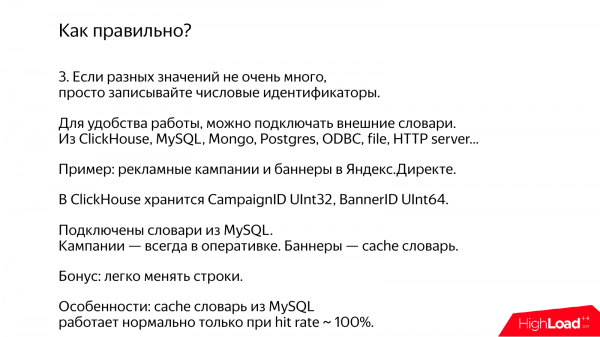
En anden ret unik mulighed for ClickHouse er tilslutning af eksterne ordbøger. Du kan indtaste tal i ClickHouse, mens dine ordbøger opbevares i et system, der er bekvemt for dig. For eksempel kan du bruge: MySQL, Mongo, Postgres. Du kan også lave din egen mikrotjeneste, der via HTTP leverer disse data. Og på ClickHouse-niveau skriver du en funktion, der omdanner disse tal til strenge.
Dette er en specialiseret, men meget effektiv metode til at udføre et join med en ekstern tabel. Der er faktisk to muligheder. I den ene mulighed vil disse data være fuldt cachet, fuldt til stede i RAM og opdateres med nogen jævne mellemrum. I den anden mulighed, hvis disse data ikke kan rummes i RAM, kan de delvist caches.
Her er et eksempel. Der er Yandex.Direct. Og der er en reklamekampagne og bannere. Der er nok omkring ti millioner reklamekampagner. Og de kan omtrent rummes i RAM. Men der er milliarder af bannere, de kan ikke rummes. Og vi bruger et cachetabellen fra MySQL.
Det eneste problem er, at den cache-yget tabel fungerer korrekt, hvis hit rate er tæt på 100 %. Hvis den er lavere, skal vi ved behandling af forespørgsler til hver data pakke reelt hente de manglende nøgler og kigge efter data i MySQL. Om ClickHouse kan jeg stadig sikre mig, at – ja, det stopper ikke, men jeg vil ikke tale om andre systemer.
Og som et bonus er det, at tabellerne – det er en meget simpel måde at opdatere data i ClickHouse bagud i tiden. Det vil sige, hvis du har en rapport om reklamekampagner, og brugeren blot ændrer reklamekampagnen, vil disse data også ændres i alle gamle data og rapporter. Hvis vi skriver rækker direkte til tabellen, vil det være umuligt at opdatere dem.
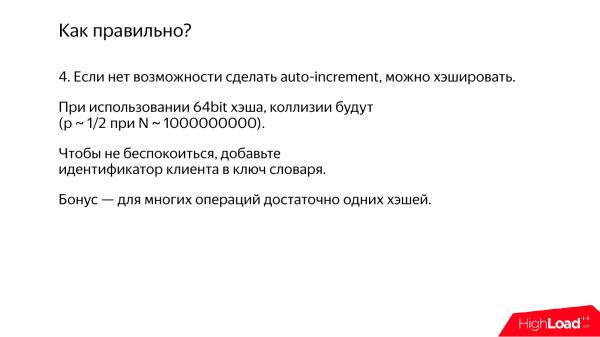
En anden metode, når du ikke ved, hvor du skal hente identifikatorerne til dine rækker. Du kan bare hash'e dem. Og den simpleste mulighed – det er at tage en 64-bit hash.
Det eneste problem er, at hvis hashen er 64-bit, vil der næsten helt sikkert være kollisioner. For hvis der er en milliard rækker, bliver sandsynligheden mærkbar.
Og det ville ikke være særlig godt at hash'e navne på reklamekampagner på den måde. Hvis reklamekampagnerne fra forskellige virksomheder bliver blandet sammen, så vil der ske noget uforståeligt.
Der er et simpelt trick. Selvom det ikke er særlig velegnet til alvorlige data, hvis du har noget, der ikke er alt for vigtigt, så tilføj blot klientens ID til ordbogsnøglen. På den måde vil du få kollisioner, men kun inden for en enkelt klient. Denne metode anvender vi til linkkortet i Yandex.Metrica. Vi har urls der, hvor vi gemmer hasher. Og vi ved, at der bestemt forekommer kollisioner. Men når siden vises, er chancen for, at der på en enkelt side er nogen urls, der overlapper for en bruger, så høje, at det kan ignoreres.
Som bonus – til mange operationer er det tilstrækkeligt at have hasherne, så selve strenge ikke behøver at blive gemt nogen steder.
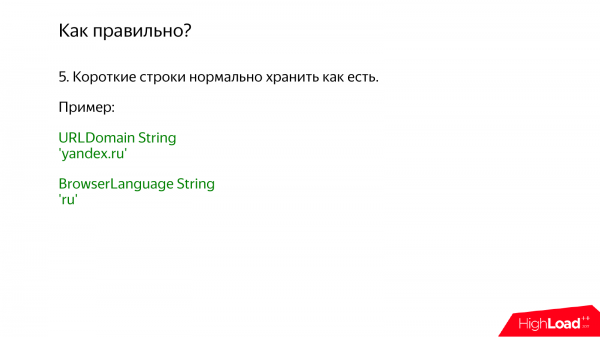
Et andet eksempel er, hvis strenge er korte, såsom domæner. De kan gemmes, som de er. For eksempel, browserens sprog ru – 2 byte. Jeg er selvfølgelig meget ked af hver byte, men behøver ikke bekymre dig, 2 byte er ikke værd at spare på. Gem dem, som de er, uden at tænke mere over det.
En anden situation er, når der er mange strenge, og der er meget unikt indhold, og antallet af unikke nok er ubegribelig stort. Et typisk eksempel er søgefrase eller urls. Søgefraser, herunder dem med stavefejl. Lad os se, hvor mange unikke søgefraser der er på en dag. Det viser sig, at de næsten udgør halvdelen af alle hændelser. I dette tilfælde kan du tænke, at dataene skal normaliseres, identificere IDs og gemme dem i en separat tabel. Men sådan skal det ikke gøres. Gem bare disse strenge, som de er.
Bedre – find ikke på noget, for hvis de gemmes separat, skal der laves en join. Og denne join – i bedste fald vil det indebære tilfældig adgang til hukommelsen, hvis det kan være i hukommelsen. Hvis ikke, vil der være problemer.
Og hvis dataene gemmes in place, så bliver de bare læst i den rigtige rækkefølge fra filsystemet, og så er alt, som det skal være.
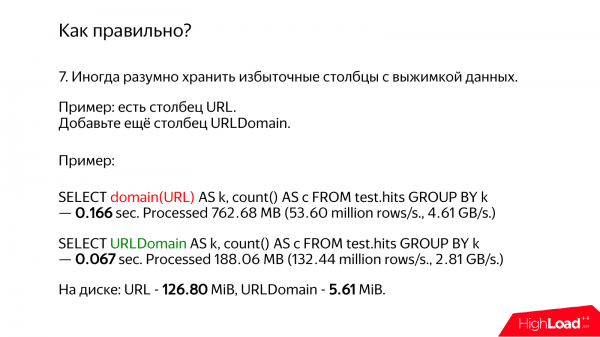
Hvis du har urls eller en anden kompleks lang streng, så bør du overveje at beregne en eller anden opsummering på forhånd og gemme den i en separat kolonne.
For urls kan du for eksempel gemme domænet separat. Og hvis du faktisk har brug for domænet, så kan du blot bruge denne kolonne; urls vil ligge der, og du skal endda ikke røre dem.
Lad os se, hvilken forskel der opstår. I ClickHouse findes der en specialiseret funktion, der beregner domænet. Den er meget hurtig, og vi har optimeret den. Og, for at være ærlig, overholder den ikke engang RFC, men den beregner alligevel alt, hvad vi har brug for.
I det ene tilfælde vil vi blot udtrække URL'er og beregne domænet. Det tager 166 millisekunder. Men hvis vi bruger et færdigt domæne, tager det kun 67 millisekunder, hvilket er næsten tre gange hurtigere. Og hurtigere ikke fordi vi skal foretage nogle beregninger, men fordi vi læser mindre data.
Af en eller anden grund har én af forespørgslerne, der er langsommere, en højere hastighed af gigabyte pr. sekund. Fordi den læser flere gigabytes. Disse data er helt overflødige. Forespørgslen virker hurtigere, men tager længere tid at udføre.
Når vi ser på datavolumen på disken, viser det sig, at URL'en fylder 126 megabyte, mens domænet kun fylder 5 megabyte. Det er 25 gange mindre. Men forespørgslen udføres kun fire gange hurtigere. Det skyldes, at dataene er 'varme'. Hvis de var 'kolde', ville det helt sikkert have været 25 gange hurtigere på grund af disk I/O.
Hvis vi vurderer, hvor meget mindre domænet er end URL'en, er det omkring fire gange. Men af en eller anden grund fylder dataene på disken 25 gange mindre. Hvorfor? På grund af komprimering. Både URL'en og domænet komprimeres. Men ofte indeholder URL'en en masse skrald.
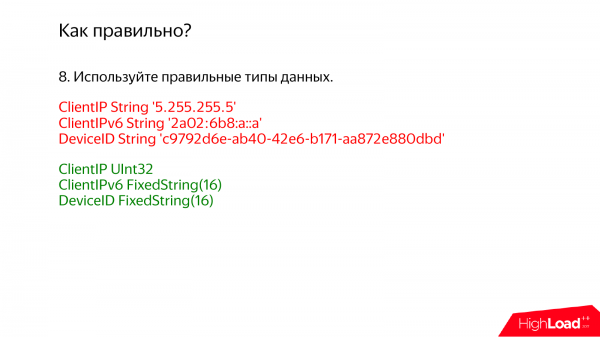
Og det er selvfølgelig vigtigt at bruge de rigtige datatyper, der er specielt designet til de nødvendige værdier eller passer til dem. Hvis du bruger IPv4, skal du gemme det som UInt32*. Hvis det er IPv6, så FixedString(16), fordi en IPv6-adresse er 128 bit, så gem det i binært format.
Hvad gør man, hvis du nogle gange har IPv4-adresser og nogle gange IPv6? Ja, du kan gemme begge. En kolonne til IPv4, en anden til IPv6. Selvfølgelig er der en mulighed for at vise IPv4 som IPv6. Det vil også fungere, men hvis du ofte har brug for IPv4-adressen i dine forespørgsler, er det en god idé at placere den i en separat kolonne.
* nu er der i ClickHouse separate datatyper for IPv4 og IPv6, der gemmer data lige så effektivt som tal, men præsenterer dem lige så praktisk som strenge.
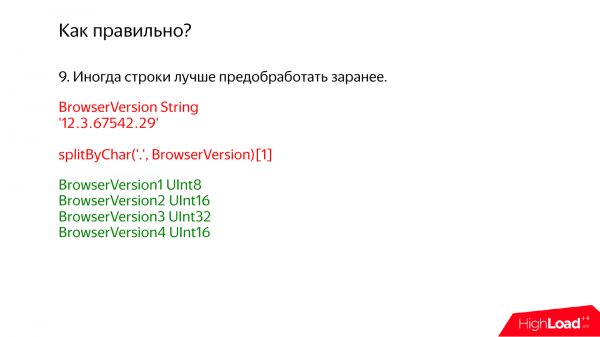
Det er også vigtigt at bemærke, at det er en god idé at forbehandle dataene på forhånd. For eksempel, hvis du modtager nogle rå logs. Og måske er det bedre ikke straks at smide dem ind i ClickHouse, selvom det virker fristende at lade være, og så fungerer alt. Men det er stadig en god idé at lave de beregninger, der er mulige.
For eksempel, browser-versionen. I en nærliggende afdeling, som jeg ikke vil nævne, opbevares versionen af browseren således, altså som en streng: 12.3. Og derefter, for at lave en rapport, tager de denne streng og deler den op i et array, og så på det første element i arrayet. Naturligvis resulterer det i langsommelighed. Jeg spurgte, hvorfor de gør sådan. De svarede, at de ikke kan lide for tidlig optimering. Men jeg kan ikke lide for tidlig pessimisering.
Så i dette tilfælde vil det være bedre at opdele i 4 kolonner. Her skal du ikke være bange, fordi det er ClickHouse. ClickHouse er en kolonnedatabase. Og jo flere præcise små kolonner, jo bedre. Hvis der er 5 BrowserVersion, så lav 5 kolonner. Det er helt normalt.
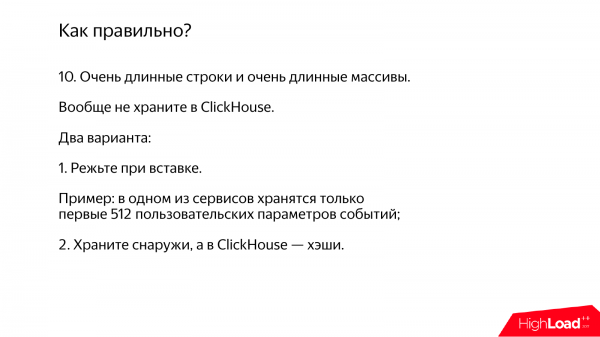
Lad os nu se på, hvad der skal gøres, hvis du har mange meget lange strenge, meget lange arrays. De skal overhovedet ikke lagres i ClickHouse. I stedet kan du kun gemme en eller anden identifikator i ClickHouse. Så send de lange strenge ind i et andet system.
For eksempel, i en af vores analytiske tjenester har vi nogle parametre for begivenheder. Og hvis der kommer mange parametre til begivenhederne, gemmer vi bare de første 512, der kommer forbi. Fordi 512 – det er der ikke noget problem med.
Og hvis du ikke kan beslutte dig for dine datatyper, kan du også skrive dataene til ClickHouse, men i en midlertidig tabel af typen Log, der er specifik for midlertidige data. Efter dette kan du analysere, hvordan distributionen af værdierne er, hvad der overhovedet findes, og sammensætte de rigtige typer.
* lige nu er der i ClickHouse en datatype, som tillader effektiv opbevaring af strenge med færre ressourcer.
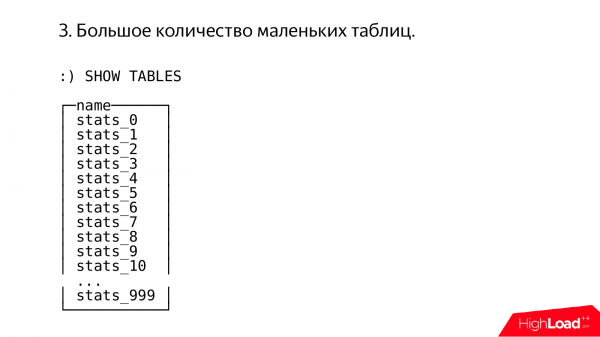
Lad os nu se på et andet interessant tilfælde. Nogle gange fungerer tingene mærkeligt for folk. Jeg går ind og ser noget sådant. Og det giver straks indtryk af, at det er lavet af en meget erfaren, klog admin, der har stor erfaring med opsætning af MySQL version 3.23.
Her ser vi tusinde tabeller, hvor hver indeholder rester fra divisionen af noget, der er uklart, med tusinde.
Generelt respekterer jeg andres erfaringer, og jeg forstår, hvilke kvaler de kan have med deres opnåelse.
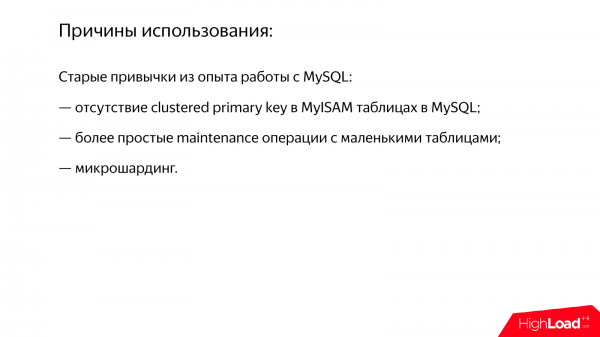
Og årsagerne er mere eller mindre forståelige. Det er gamle stereotyper, der kan have ophobet sig fra arbejde med andre systemer. For eksempel er der ikke en klynget primær nøgle i MyISAM-tabeller. En sådan tilgang til datadeling kan være et desperat forsøg på at opnå den samme funktionalitet.
En anden årsag er, at det er vanskeligt at udføre operationer som alter på store tabeller. Alt vil blive blokeret. Selvom dette problem ikke længere er så alvorligt i de moderne versioner af MySQL.
Eller for eksempel mikroskabeloning, men det vender vi tilbage til lidt senere.
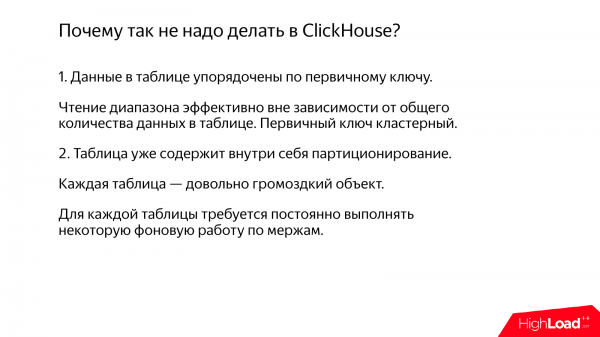
I ClickHouse skal man ikke gøre sådan, fordi for det første er den primære nøgle klynget, og dataene er organiseret efter den primære nøgle.
Og nogle gange spørger folk mig: „Hvordan ændrer ydeevnen af rækkeanmodninger i ClickHouse sig med tabellens størrelse?”. Jeg siger, at den ikke ændrer sig. For eksempel har du en tabel med en milliard rækker, og du læser en række på en million. Det fungerer helt fint. Hvis du har en tabel med en trillion rækker, og du læser en million rækker, vil det næsten være det samme.
Og for det andet kræves der ikke nogle ting som manuelle partitioner. Hvis du går ind og ser, hvad der er på filsystemet, vil du se, at tabellen er en ret alvorlig størrelse. Og derinde er der noget, der ligner partitioner. Det vil sige, at ClickHouse gør alt for dig, så du slipper for at lide.
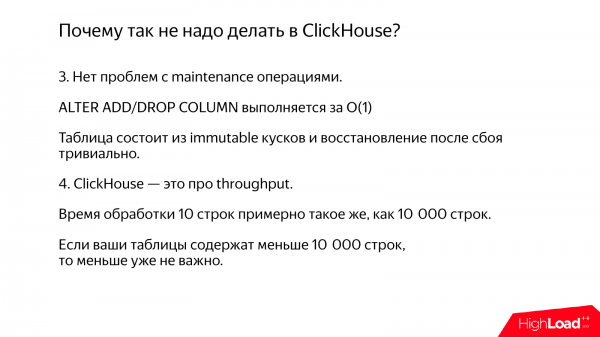
Alter i ClickHouse er gratis, hvis det er alter add/drop column.
Og det giver ikke mening at lave små tabeller, for hvis din tabel har 10 rækker eller 10.000 rækker, så er det helt ligegyldigt. ClickHouse er et system, der optimerer throughput, ikke latency, så det giver ikke mening at behandle 10 rækker.
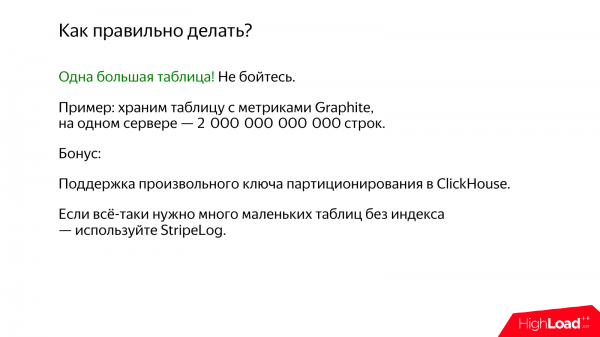
Det er rigtigt at bruge en stor tabel. Slip af med gamle stereotyper, så går det hele godt.
Og som en bonus har vi i den seneste version fået muligheden for at lave en vilkårlig partitionsnøgle for at udføre forskellige vedligeholdelsesoperationer på individuelle partitioner.
For example, you need many small tables, such as when there's a need to process some intermediate data, you receive chunks, and you need to perform transformations on them before writing to the final table. For this case, there is a wonderful table engine – StripeLog. It's somewhat like TinyLog, but better.
* there is also .
Another anti-pattern is micro-sharding. For instance, if you need to shard data and you have 5 servers, but tomorrow there will be 6 servers. You might think about how to rebalance this data. Instead of sharding into 5 shards, you split it into 1,000 shards. Then you map each of these micro-shards to a separate server. For example, one server ends up with 200 ClickHouse instances, each on different ports or separate databases.
But in ClickHouse, this approach doesn't work very well. Because even a single ClickHouse instance tries to use all the available server resources to process one query. For example, if you have a server with 56 CPU cores and you execute a query that takes one second, it will use all 56 cores. If you’ve placed 200 ClickHouse instances on one server, then 10,000 threads will start up. Overall, this will result in very poor performance.
Another reason is that the workload distribution across these instances will be uneven. Some will finish earlier, some later. If all this happened within a single instance, ClickHouse would manage to distribute the data correctly among the threads.
And another reason is that you will have inter-process communication over TCP. Data will need to be serialized and deserialized, and having such a huge number of micro-shards will be inefficient.
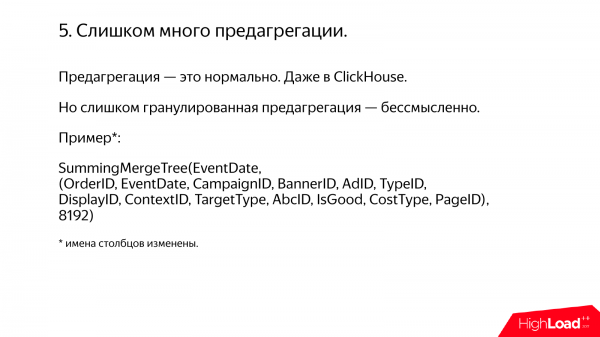
Another anti-pattern, although it’s hard to call it that, is a large number of pre-aggregations.
In general, pre-aggregation is good. If you had a billion rows, aggregated it down to 1,000 rows, then the query executes instantly. That's great. It's perfectly acceptable. For this, ClickHouse even has a special table type called AggregatingMergeTree, which performs incremental aggregation as data is inserted.
Men der er tilfælde, hvor man tror, at vi vil aggregere data på denne måde, og så aggregere data yderligere. I en nærliggende afdeling, som jeg ikke ønsker at nævne, bruger de SummingMergeTree-tabeller til summation efter primærnøglen, og som primærnøgle bruger de omkring 20 forskellige kolonner. Jeg har ændret navnene på nogle kolonner for at skjule deres identitet, men det er stort set sådan, det foregår.
Og der opstår sådanne problemer. For det første mindskes datamængden ikke så meget. For eksempel reduceres den til en tredjedel. En tredjedel ville være en god pris, der gør det muligt at opnå ubegrænsede analytiske muligheder, som opstår, hvis dine data ikke er aggregerede. Hvis dataene er aggregerede, får du i stedet for analyse blot en skræmmende statistik.
Og hvad er det, der især irriterer? At folk fra den nærliggende afdeling går rundt og beder om at tilføje endnu en kolonne til primærnøglen. Det vil sige, at vi har aggregeret dataene på denne måde, men nu ønsker vi lidt mere. Men i ClickHouse er der ingen mulighed for at ændre primærnøglen. Derfor må vi skrive nogle scripts i C++. Og jeg bryder mig ikke om scripts, selvom de er skrevet i C++.
Og hvis man ser på, hvorfor ClickHouse blev skabt, så er det ikke-aggregerede data lige præcis det scenarie, som det er født til. Hvis du bruger ClickHouse til ikke-aggregerede data, så gør du det rigtigt. Hvis du aggregerer, så er det nogle gange tilgiveligt.
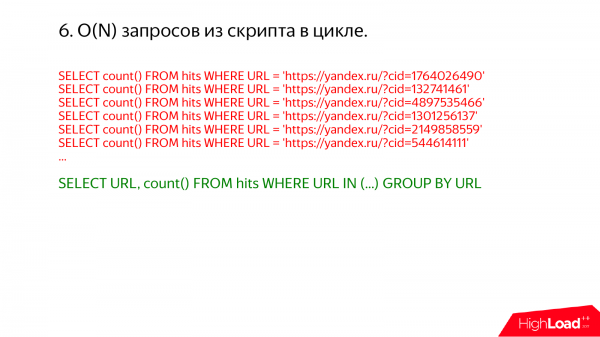
En anden interessant situation er forespørgsler i en uendelig løkke. Nogle gange logger jeg ind på en produktionsserver og ser på processlisten. Og hver gang opdager jeg, at der foregår noget forfærdeligt.
For eksempel sådan her. Her er det klart, at alt kunne være udført i én forespørgsel. Man skal bare skrive url in og listen.
Hvorfor er så mange af sådanne forespørgsler i en uendelig løkke dårligt? Hvis indekset ikke bruges, vil du have mange gennemgange af de samme data. Men hvis indekset bruges, for eksempel, hvis du har en primærnøgle på ru, og du skriver url = noget der. Og du tror, at der præcist vil blive læst ét url fra tabellen, så vil alt være i orden. Men det er det ikke. Fordi ClickHouse håndterer det hele i pakker.
Når du skal læse et datasæt, læser du lidt mere, fordi indekset i ClickHouse er sparsommelig. Dette indeks tillader ikke at finde en individuel række i tabellen, kun et interval af data. Og data komprimeres i blokke. For at læse en række skal du tage en hel blok og dekomprimere den. Og hvis du udfører mange forespørgsler, vil du have mange overlappende forespørgsler, og meget af arbejdet vil blive udført igen og igen.
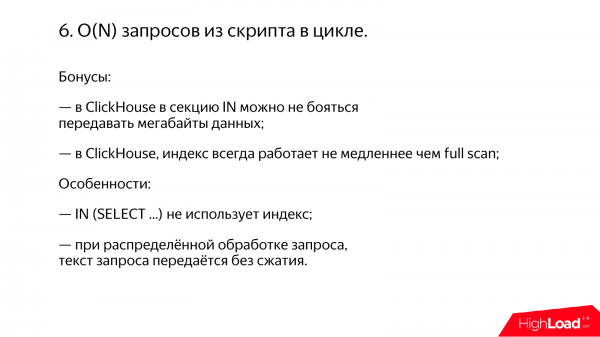
Og som en bonus kan det bemærkes, at i ClickHouse bør du ikke være bange for at sende selv megabytes og endda hundrede megabytes i IN-sektionen. Jeg husker fra vores praksis, at hvis vi sender mange værdier i IN-sektionen i MySQL, for eksempel sender 100 megabytes af nogle tal, så bruger MySQL 10 gigabytes hukommelse og intet mere sker, alt fungerer dårligt.
Og det andet er, at i ClickHouse, hvis dine forespørgsler bruger indekset, så er det altid ikke langsommere end en fuld scanning, dvs. hvis næsten hele tabellen skal læses, kører det sekventielt og læser hele tabellen. Generelt klarer det sig selv.
Men der er alligevel nogle vanskeligheder. For eksempel, at IN med en underforespørgsel ikke bruger indekset. Men det er vores problem, og vi skal rette det. Der er ikke noget fundamentalt her. Vi skal fikse det.
Og en anden interessant ting er, at hvis du har en meget lang forespørgsel og distribueret behandling af forespørgsler sker, så vil denne meget lange forespørgsel blive sendt til hver server uden komprimering. For eksempel, 100 megabytes og 500 servere. Og derfor vil der blive overført 50 gigabytes over netværket. Det vil blive sendt og derefter udført med succes.
* allerede bruger; alt er blevet fikset, som lovet.
Og en ret almindelig situation er, hvis forespørgsler kommer fra API'et. For eksempel, hvis du har lavet en service. Og hvis din service er nødvendig for nogen, så åbnede du API'et, og bogstaveligt talt to dage senere ser du, at der sker noget uforståeligt. Alt er overbelastet, og der kommer nogle skrækkelige forespørgsler, som aldrig burde have været.
Og der er én løsning her. Hvis du har åbnet API'et, så bliver du nødt til at begrænse det. For eksempel indføre kvoter. Der er ingen andre fornuftige muligheder. Ellers vil de straks skrive et script, og der vil være problemer.
Og i ClickHouse er der en særlig mulighed – det er kvoteregnskabet. Man kan faktisk overføre sin egen kvotenøgle, som for eksempel er en intern brugeridentifikator. Og kvoterne vil blive beregnet uafhængigt for hver af dem.
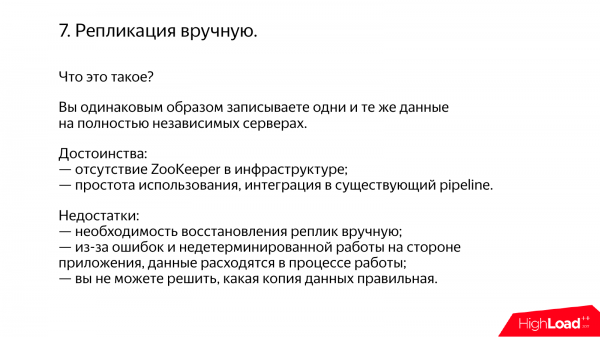
Nu en anden interessant ting. Det er manuel replikation.
Jeg kender mange tilfælde, hvor folk, på trods af at ClickHouse har indbygget support til replikation, alligevel replikere ClickHouse manuelt.
Hvad går princippet ud på? Du har en databehandlingspipeline, som arbejder uafhængigt, for eksempel i forskellige datacentre. Du skriver de samme data på samme måde ind i ClickHouse. Sandheden er, at praksis viser, at dataene stadig vil afvige på grund af nogle specielle forhold i din kode. Jeg håber, at dette ikke er tilfældet for din.
Og af og til bliver du stadig nødt til at synkronisere manuelt. For eksempel laver administratorer rsync en gang om måneden.
Det er faktisk meget lettere at bruge den indbyggede replikation i ClickHouse. Men der kan være nogle kontraindikationer, fordi det kræver ZooKeeper. Jeg vil ikke sige noget dårligt om ZooKeeper, i princippet er systemet fungerende, men nogle mennesker bruger det ikke på grund af en frygt for Java, fordi ClickHouse er et glimrende system skrevet i C++, som man kan bruge uden problemer. Og ZooKeeper er på Java. Det kan endda være lidt fristende at lade være, men hvis det er tilfældet, kan du bruge manuel replikation.
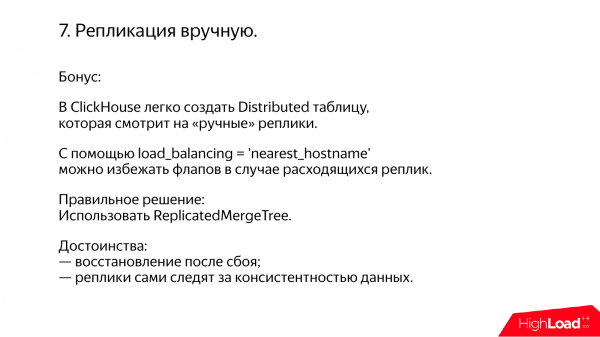
ClickHouse er et praktisk system. Det tager hensyn til dine behov. Hvis du har manuel replikation, kan du oprette en Distributed tabel, der ser på dine manuelle replikater og selv udfører failover imellem dem. Og der er endda en særlig mulighed, der gør det muligt at undgå flapper, selv hvis dine replikater systematisk divergerer.
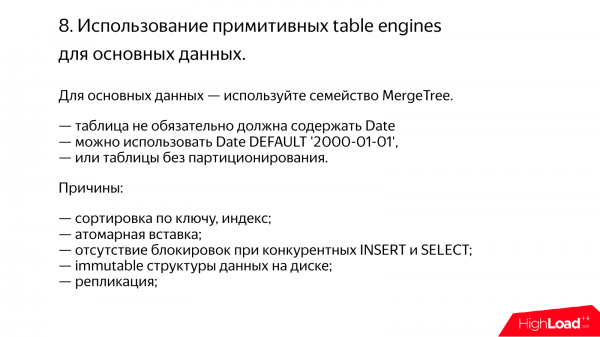
Der kan opstå problemer, hvis du bruger primitive table engines. ClickHouse er som en byggeklods, der har en masse forskellige tabelmotorer. For alle alvorlige tilfælde, som det fremgår af dokumentationen, bør du bruge tabeller fra MergeTree-familien. Alle andre er kun til særlige tilfælde eller til test.
I en MergeTree-tabel er det ikke nødvendigt, at du har en specifik dato og tid. Du kan stadig bruge det. Hvis der ikke er nogen dato og tid, så skriv, at default er 2000. Det vil fungere og kræver ikke ressourcer.
I den nye version af serveren kan du endda angive, at du vil have brugerdefineret partitionering uden partitionstast. Det vil være det samme.
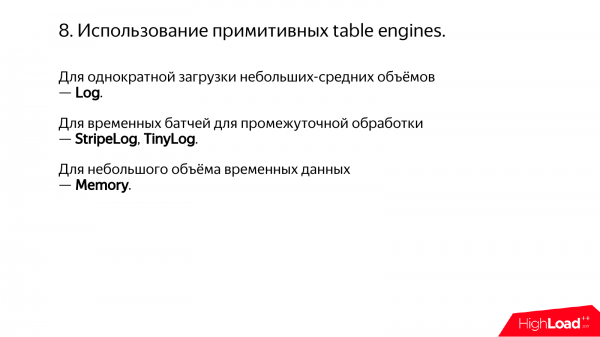
På den anden side kan du bruge primitive tabelmotorer. For eksempel kan du indlæse data én gang og se, vende og slette. Du kan bruge Log.
Eller opbevaring af små mængder til midlertidig behandling – det er StripeLog eller TinyLog.
Memory kan bruges, hvis du har små datamængder, og bare vil dreje noget i hukommelsen.
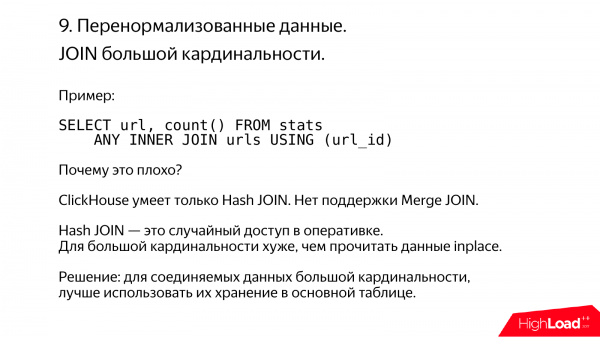
ClickHouse elsker ikke meget normaliserede data.
Her er et typisk eksempel. Det er et stort antal URL'er. Du har lagt dem i en nærliggende tabel. Og så besluttede du at lave JOIN med dem, men det vil normalt ikke fungere, fordi ClickHouse kun understøtter Hash JOIN. Hvis der ikke er nok hukommelse til mange data, som skal forbindes, så kan JOIN ikke udføres*.
Hvis dataene har høj kardinalitet, så bekymre dig ikke, opbevar dem i denormaliseret form, URL'er lige på stedet i hovedtabellen.
* men nu er der også merge join i ClickHouse, og det fungerer under forhold, hvor de mellemliggende data ikke kan være i hukommelsen. Men det er ineffektivt, og anbefalingen står ved magt.
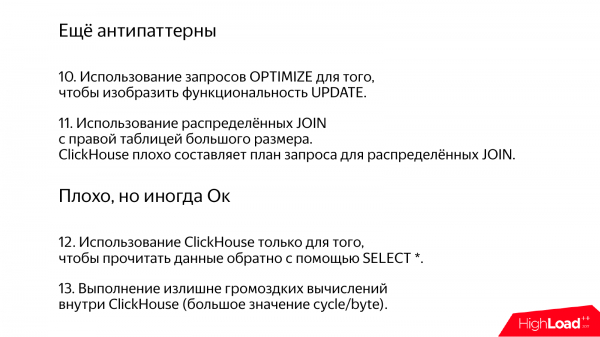
Her er et par eksempler mere, men jeg er allerede i tvivl om, hvorvidt de er antipatterns eller ej.
ClickHouse har en kendt ulempe. Den kan ikke opdatere*. På en måde er det endda godt. Hvis du har nogle vigtige data, for eksempel regnskab, så kan ingen ændre dem, fordi der ikke er nogen opdateringer.
* understøttelse af opdateringer og sletninger i batch-tilstand blev for længst tilføjet.
Men der er nogle særlige metoder, der gør det muligt at udføre opdateringer som om de sker i baggrunden. For eksempel tabeller af typen ReplaceMergeTree. De foretager opdateringer under baggrundsmerges. Du kan tvinge dette med optimize table. Men gør det ikke for ofte, fordi det vil medføre en fuld omskrivning af partitionen.
Distribution JOIN i ClickHouse – det håndteres også dårligt af forespørgselsplanlæggeren.
Dårligt, men nogle gange okay.
Brug af ClickHouse kun for at læse data tilbage med select*.
Jeg vil ikke anbefale at bruge ClickHouse til omfattende beregninger. Men det er ikke helt rigtigt, fordi vi allerede er begyndt at trække os fra denne anbefaling. Vi har for nylig tilføjet muligheden for at anvende maskinlæringsmodeller i ClickHouse – Catboost. Og det bekymrer mig, fordi jeg tænker: „Hvilken rædsel. Hvor mange cykler pr. byte bliver det!“. Jeg har virkelig ondt af at bruge cykler på bytes.
Men frygt ikke, installer ClickHouse, alt vil være godt. Hvis der opstår problemer, har vi et fællesskab. Forresten, fællesskabet – det er jer. Og hvis I har nogen problemer, kan I i det mindste komme ind i vores chat, og jeg håber, at I får hjælp.
Spørgsmål
Tak for præsentationen! Hvor kan man klage over, at ClickHouse falder?
I kan klage til mig personligt lige nu.
Jeg er for nylig begyndt at bruge ClickHouse. Jeg nedbrød straks cli-interfacet.
Du er heldig.
Kort efter nedbrød jeg serveren med et lille select.
Du har talent.
Jeg åbnede en fejl på GitHub, men den blev ignoreret.
Lad os se.
Alexey narrede mig til præsentationen og lovede at fortælle, hvordan du komprimerer data indeni.
Meget enkelt.
Det fandt jeg ud af i går. Mere konkret.
Der er ingen forfærdelige tricks. Det er blot blokkomprimering. Som standard bruges LZ4, man kan aktivere ZSTD*. Blokke fra 64 kilobyte til 1 megabyte.
* der er også støtte til specialiserede komprimeringscodecs, som kan bruges i kæde med andre algoritmer.
Er der bare rå data i blokkene?
Ikke helt rå. Der er arrays. Hvis du har en numerisk kolonne, så er der tal, der er lagt tæt i et array.
Forstået.
Alexey, eksemplet med uniqExact over ip-adresser, dvs. det, at uniqExact tager længere tid over strenge end over tal og så videre. Hvad hvis vi bruger et trick og caster i læseøjeblikket? Dvs. du nævnte, at det næsten ikke adskiller sig på disken. Hvis vi læser strenge fra disken og caster, vil aggregaterne så være hurtigere hos os eller ej? Eller vil vi alligevel ikke mærke nogen betydelig gevinst her? Jeg tror, du testede det, men nævnte det ikke i benchmarket.
Jeg tror, at det vil være langsommere end uden casting. I så fald skal IP-adressen parses fra strengen. Vi har selvfølgelig også optimeret parsing af IP-adresser i ClickHouse. Vi har virkelig gjort vores bedste, men der har I tallene skrevet i ti tusinders format. Meget uhensigtsmæssigt. På den anden side vil funktionen uniqExact også arbejde langsommere på strenge, ikke kun fordi det er strenge, men også fordi der vælges en anden specialisering af algoritmen. Strenge behandles simpelthen anderledes.
Hvad hvis vi tager en mere primitiv datatype? For eksempel, vi skrev user id, som vi har in, vi skrev det som en streng, og så castede vi — vil det være sjovere eller ej?
Jeg er i tvivl. Jeg tror, det vil være endda mere trist, fordi parsing af tal er en alvorlig udfordring. Jeg mener, at en af jeres kolleger endda havde et oplæg om, hvor svært det er at parse tal i ti tusinders format, men måske ikke.
Alexey, mange tak for oplægget! Og også mange tak for ClickHouse! Jeg har et spørgsmål vedrørende funktioner. Er der planer om en funktion til delvis opdatering af ordbøger?
Altså, en delvis genindlæsning?
Ja ja. En mulighed for at angive et MySQL-felt, altså at opdatere efter, så kun disse data bliver indlæst, hvis ordbogen er meget stor.
Meget interessant funktion. Og jeg mener, at en eller anden person har foreslået det i vores chat. Måske var det endda dig.
Jeg tror ikke, det var mig.
Fint, nu ser det ud til, at der er to forespørgsler. Og vi kan begynde at arbejde i ro og mag. Men jeg vil straks advare jer om, at denne funktion er ret simpel at implementere. Altså, i princippet skal man bare skrive versionsnummeret i tabellen og derefter skrive: version mindre end så- og så mange. Og det betyder, at vi sandsynligvis vil foreslå det til entusiaster. Er du en entusiast?
Ja, men desværre ikke i C++.
Kan dine kolleger skrive i C++?
Jeg finder nogen.
Fremragende*.
* muligheden blev tilføjet to måneder efter oplægget — den blev udviklet af spørgsmålets forfatter og sendt sin .
Tak!
Hej! Tak for præsentationen! Du nævnte, at ClickHouse bruger alle tilgængelige ressourcer meget effektivt. Og foredragsholderen ved siden af, fra Luxoft, fortalte om sin løsning til Post Rusland. Han sagde, at de virkelig kunne lide ClickHouse, men de brugte det ikke i stedet for deres hovedkonkurrent, fordi det tog hele CPU'en. Og de kunne ikke få det til at passe ind i deres arkitektur, i deres ZooKeeper med Docker. Er der en mulighed for at begrænse ClickHouse, så det ikke bruger alt, hvad det kan få fat i?
Ja, det kan man, og det er meget nemt. Hvis du ønsker at bruge færre kerner, så skriv bare set max_threads = 1. Og så vil det kun udføre forespørgsler på en enkelt kerne. Desuden kan man angive denne indstilling forskelligt for forskellige brugere. Så der er ingen problemer. Og sig til kollegerne fra Luxoft, at det ikke er godt, at de ikke fandt denne indstilling i dokumentationen.
Alexey, hej! Jeg ville lige høre om et spørgsmål. Det er ikke første gang, jeg hører, at mange begynder at bruge ClickHouse som lager til logfiler. I præsentationen sagde du, at man ikke skulle gøre dette, dvs. man skal ikke gemme lange strenge. Hvad er din holdning til det?
For det første er logfiler som regel ikke lange strenge. Der kan dog være undtagelser. For eksempel kan en service skrevet i Java kaste undtagelser, som logges. Og det kan ske i en uendelig løkke, hvilket fylder pladsen på harddisken. Løsningen er meget enkel. Hvis strenge er meget lange, så skær dem. Hvad betyder lange? Dosis af kilobyte er dårligt*.
* i de nyeste versioner af ClickHouse er "adaptiv granuleret indeks" aktiveret, hvilket i høj grad løser problemet med at gemme lange strenge.
Og er kilobyte normalt?
Normalt.
Hej! Tak for præsentationen! Jeg har allerede spurgt om dette i chatten, men jeg kan ikke huske, om jeg fik svar. Er der planer om at udvide WITH-sektionen på en måde, der ligner CTE?
Ikke lige nu. WITH-sektionen er noget, vi betragter som lidt uformel. Den er som en lille funktion.
Jeg forstår. Tak!
Tak for præsentationen! Meget interessant! Et globalt spørgsmål. Er der planer om at lave en ændring til datalæsning i form af nogen slags stub?
Det vil helt sikkert ske. Det er vores højeste prioritet i rækken. Vi har i øjeblikket aktivt overvejet, hvordan vi gør alt rigtigt. Og det er tid til at begynde at trykke på tasterne*.
* trykkede på tasterne på tastaturet, og så gjorde vi det hele.
Vil dette påvirke systemets ydeevne på nogen måde, eller ej? Bliver indsættelsen lige så hurtig som nu?
Det er muligt, at deletes og updates i sig selv vil være meget tunge, men det vil ikke påvirke ydeevnen af selects og indsættelser.
Og et lille spørgsmål til. På præsentationen nævnte du primærnøglen. Så vi har partitionering, som som standard er månedlig, er det korrekt? Og når vi angiver et datointerval, der falder inden for en måned, bliver kun denne partition læst, ikke?
Ja.
Et sådant spørgsmål. Hvis vi ikke kan udpege en primærnøgle, er det så korrekt at lave den efter feltet "Dato" for at minimere omstruktureringen af disse data i baggrunden, så de bliver mere ordentligt arrangeret? Hvis du ikke har intervalforespørgsler, og du ikke engang kan vælge nogen primærnøgle, skal vi så overveje at inkludere datoen i primærnøglen?
Ja.
Måske giver det mening at inkludere et felt i primærnøglen, hvor data vil blive bedre komprimeret, hvis de er sorteret efter dette felt. For eksempel, identifikatoren for brugeren. En bruger besøger for eksempel den samme hjemmeside. I dette tilfælde lægger du bruger-id og tidspunkt. Og så vil dine data blive bedre komprimeret. Hvad angår datoen, hvis du virkelig ikke har og aldrig har intervalforespørgsler efter datoer, så kan du undlade at inkludere datoen i primærnøglen.
Okay, mange tak!
Kilde: habr.com
