

Søgning efter funktionelle afhængigheder i data anvendes i forskellige retninger inden for dataanalyse: databasehåndtering, datarensning, reverse engineering af databaser og dataeksploration. Vi har allerede offentliggjort om selve afhængighederne. Anastasia Birillo og Nikita Bobrov. Denne gang deler Anastasia — nyuddannet fra Computer Science Center i år — udviklingen af dette arbejde som en del af forskningsprojektet, hun præsenterede i centret.
Valg af opgave
Under min uddannelse i CS centret begyndte jeg at studere databaser grundigt, især søgning efter funktionelle og differentielle afhængigheder. Dette emne var relateret til emnet for mit bachelorprojekt på universitetet, så mens jeg arbejdede med mit projekt begyndte jeg at læse artikler om forskellige afhængigheder i databaser. Jeg skrev en oversigt over dette område — en af mine første. på engelsk, og jeg indsendte den til konferencen SEIM-2017. Jeg var meget glad, da jeg fandt ud af, at den faktisk blev accepteret, og jeg besluttede at dykke dybere ned i emnet. Selve konceptet er ikke nyt — det begyndte at blive anvendt allerede i 90'erne, men det finder stadig anvendelse i mange områder.
I andet semester af min uddannelse i centret begyndte jeg et forskningsprojekt for at forbedre algoritmerne til at finde funktionelle afhængigheder. Jeg arbejdede på det sammen med ph.d.-studerende fra St. Petersborg Universitet, Nikita Bobrov, på JetBrains Research.
Den beregningsmæssige kompleksitet ved at finde funktionelle afhængigheder
Det primære problem — den beregningsmæssige kompleksitet. Antallet af mulige minimale og ikke-trivielle afhængigheder er begrænset af værdien  , hvor
 — antallet af attributter i tabellen. Tiden for algoritmernes kørsel afhænger ikke kun af antallet af attributter, men også af antallet af rækker. I 90'erne kunne algoritmer til at finde funktionelle afhængigheder på en almindelig stationær computer behandle datasæt med op til 20 attributter og titusinder af rækker i op til flere timer. Moderne algoritmer, der kører på multi-core processorer, opdager afhængigheder for datasæt, der består af hundrede attributter (op til 200) og hundredtusinder af rækker, omtrent på samme tid. Alligevel er dette ikke tilstrækkeligt: sådan tid er uacceptabel for de fleste virkelige applikationer. Derfor udviklede vi metoder til at accelerere eksisterende algoritmer.
Cache-skemaer til partitioneringens krydsninger
I den første del af arbejdet udviklede vi cache-skemaer for en klasse af algoritmer, der bruger metoden med partisionsintersection. En partition for en attribut repræsenterer et sæt af lister, hvor hver liste indeholder række numre med de samme værdier for den pågældende attribut. Hver sådan liste kaldes et kluster. Mange moderne algoritmer bruger partitioner til at bestemme, om en afhængighed opretholdes eller ej, og følger specifikt lemmaet: Afhængigheden  opretholdes, hvis
 . Her
 betegner partitionen og anvender begrebet partitionsstørrelse — antallet af klustre i den. Algoritmer, der bruger partitioner, tilføjer ekstra attributter i venstre del af afhængigheden ved brud på afhængigheden, hvorefter de omberegner den ved at udføre en operation for at krydse partitioner. Denne operation kaldes specialisering i artiklerne. Men vi bemærkede, at partitioner for afhængigheder, der kun vil blive opretholdt efter flere runder af specialisering, kan blive aktivt genbrugt, hvilket kan betydeligt reducere algoritmernes køretid, da krydsning af partitioner er en kostbar operation.
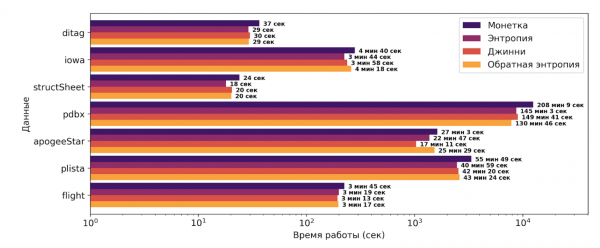
Derfor foreslog vi en heuristik baseret på Shannons Entropi og Ginis usikkerhed, samt vores metrik, som vi kaldte Omvendt Entropi. Denne er en ubetydelig modifikation af Shannons Entropi og vokser i takt med, at unikheden af datasættet stiger. Den foreslåede heuristik ser således ud:

Her  — graden af unikhed i den nyligt beregnede partition
 , og
 er en median score for unikke egenskaber. Alle tre metrics, der er beskrevet ovenfor, blev prøvet som en unikhedsmetrik. Det er også værd at bemærke, at der er to modifikatorer i heuristikken. Den første angiver, hvor tæt den nuværende partition er på den primære nøgle, og gør det let at cache de partitioner, der er langt fra den potentielle nøgle. Den anden modifikator giver mulighed for at spore cache-beholdningen, hvilket stimulerer tilføjelsen af flere partitioner til cachen, når der er ledig plads. At løse denne opgave har gjort det muligt at accelerere PYRO-algoritmen med 10-40 procent afhængigt af datasættet. Det skal bemærkes, at PYRO-algoritmen er den mest succesfulde i dette område.
I figuren nedenfor kan man se resultaterne af anvendelsen af den foreslåede heuristik sammenlignet med den grundlæggende cache-tilgang baseret på flipping af en mønt. X-aksen er logaritmisk.
Alternativ metode til opbevaring af partitioner
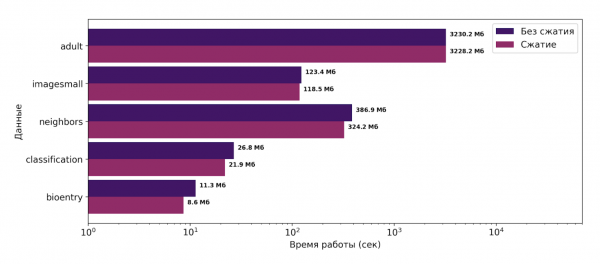
Derefter foreslog vi en alternativ metode til opbevaring af partitioner. Partitioner repræsenterer en samling af klynger, hvor hver indeholder numre på tupler med samme værdier for bestemte egenskaber. Disse klynger kan indeholde lange sekvenser af tuple-numre, for eksempel hvis dataene i tabellen er sorteret. Derfor foreslog vi en komprimeringsskema til opbevaring af partitioner, specifikt intervalopbevaring af værdier i partitionens klynger:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Første~interval}, underbrace{7, 8}_{Andet~interval}, 10}}\ downarrow{Kompression}\ pi(X) = {{underbrace{$, 1, 5}_{Første~interval}, underbrace{7, 8}_{Andet~interval}, 10}}$$display$$
Denne metode formåede at reducere hukommelsesforbruget under udførelsen af TANE-algoritmen med 1 til 25%. TANE-algoritmen er en klassisk algoritme til søgning af FDs, den bruger partitioner i sin proces. I praksis blev netop TANE-algoritmen valgt, da det var meget lettere at implementere intervalopbevaring i den end for eksempel i PYRO for at vurdere, om den foreslåede tilgang virker. De opnåede resultater præsenteres i figuren nedenfor. X-aksen er logaritmisk.
ADBIS-2019 Konference
I september 2019 præsenterede jeg en artikel baseret på forskningsresultaterne på konferencen 23rd European Conference on Advances in Databases and Information Systems (ADBIS-2019). Under præsentationen blev arbejdet fremhævet af Bernhard Thalheim, en betydningsfuld person inden for databaser. Forskningsresultaterne dannede grundlaget for min afhandling på matematik-naturvidenskab ved St. Petersborg Universitet, hvor begge de foreslåede tilgange (caching og kompression) blev implementeret i begge algoritmer: TANE og PYRO. Resultaterne viste, at de foreslåede tilgange er universelle, da der blev observeret en betydelig reduktion i både hukommelsesforbruget og algoritmernes køretid i begge algoritmer ved begge tilgange.
Kilde: habr.com
