

Fortsættende emnet om registrering af store datastreams, som blev rejst , vil vi i denne se på metoderne, som kan reducere den "fysiske" størrelse af det gemte i PostgreSQL, og deres indflydelse på serverens ydeevne.
Vi vil tale om TOAST-indstillinger og datajustering. "I gennemsnit" vil disse metoder ikke spare for mange ressourcer, men de kræver slet ingen ændringer af applikationens kode.
Vores erfaring har dog vist sig at være ret produktiv i denne henseende, da opbevaringen af næsten enhver overvågning i sin natur er størstedelen append-only set fra dataskrivning. Og hvis du er nysgerrig efter, hvordan man kan lære databasen at skrive til disk med 200MB/s halv størrelse — er du velkommen under cut.
Små hemmeligheder fra store data
I forhold til , modtager den regelmæssigt fra loggene tekstpakker.
Og da , hvis databaser vi overvåger, er et flerkomponentprodukt med komplekse datastrukturer, så bliver forespørgslerne for at opnå maksimal ydeevne ret meget Så størrelsen af hver enkelt instans af forespørgslen eller den resulterende udførelsesplan, der når os i loggen, viser sig at være "i gennemsnit" ret stor.
Lad os se på strukturen af en af tabellerne, hvor vi skriver "rå" data — altså den originale tekst fra logregistreringen:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- sektionens nøgle
    date
, data -- det vigtigste
    text
, PRIMARY KEY(pack, recno)
);
En typisk tabel (allerede partitioneret, uden tvivl, derfor er dette en skabelon til sektion), hvor det vigtigste er teksten. Nogle gange ret omfattende.
Lad os huske, at den "fysiske" størrelse af en post i PG ikke kan overstige én datagruppe, men den "logiske" størrelse er en helt anden sag. For at skrive en stor værdi (varchar/text/bytea) i et felt anvendes :
PostgreSQL bruger en fast side størrelse (normalt 8 KB) og tillader ikke, at tuple optager flere sider. Derfor er det ikke muligt direkte at gemme meget store feltværdier. For at omgå denne begrænsning komprimeres og/eller opdeles store feltværdier i flere fysiske rækker. Dette sker uset for brugeren og påvirker størstedelen af serverkoden minimalt. Denne metode er kendt som TOAST …
Faktisk oprettes der automatisk et par af tabeller med "potentielt store" felter for hver "stor" post segmenteret i 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Det vil sige, at hvis vi skal gemme en række med en "stor" værdi data, så vil den faktiske optagelse ske ikke kun i hovedtabellen og dens PK, men også i TOAST og dens PK.
Reducer TOAST-påvirkningen
Men størstedelen af vores poster er trods alt ikke så store, de burde kunne være inden for 8KB — hvordan kan vi spare på dette?..
Her kommer attributten for kolonnen i tabellen os til hjælp:
- EXTENDED tillader både kompression og separat opbevaring. Det er den standardmulighed for de fleste datatyper, der er kompatible med TOAST. Først forsøges det at udføre kompression, derefter — at gemme uden for tabellen, hvis række stadig er for stor.
- MAIN tillader kompression, men ikke separat opbevaring. (Faktisk vil separat opbevaring dog blive udført for sådanne kolonner, men kun som en sidste udvej, når der ikke er nogen anden måde at reducere rækken på, så den kan placeres på siden.)
Faktisk er dette præcis, hvad vi har brug for til tekst — maksimalt at komprimere, og hvis det slet ikke kan være der — at flytte det til TOAST.Dette kan gøres direkte "on the fly" med en kommando:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Hvordan vurdere effekten
Da datamængden ændrer sig dagligt, kan vi ikke sammenligne absolutte tal, men i forhold til hvor mindre andel vi har gemt i TOAST — jo bedre. Men her er der en fare — jo større vores "fysiske" volumen af hver enkelt post, jo "bredere" bliver indekset, fordi der skal dækkes et større antal databasissider.
Sektion før ændringer:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sektion efter ændringer:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Faktisk, vi Vi skriver nu i TOAST dobbelt så sjældent, hvilket ikke kun har lettet disken, men også CPU'en:
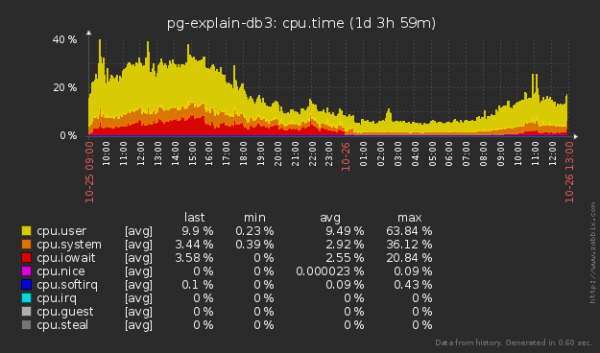
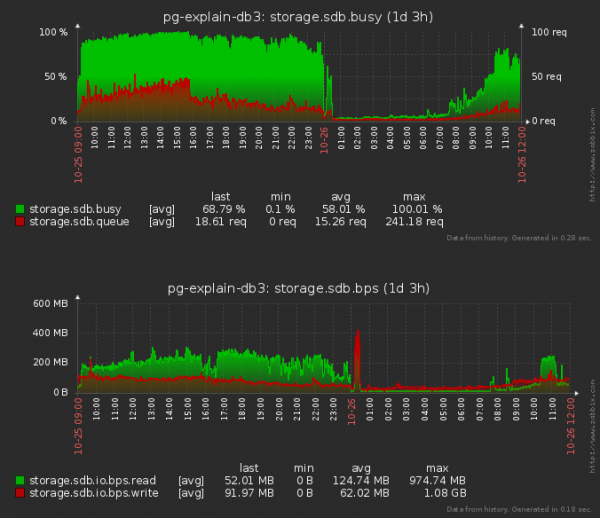
Jeg bemærker, at vi også er blevet bedre til at "læse" disken mindre, ikke kun "skrive" - fordi når vi indsætter en post i en tabel, skal vi "læse" en del af træet for hver af indeksene for at bestemme dens fremtidige position i dem.
Hvem har det godt med PostgreSQL 11
Efter opgraderingen til PG11 besluttede vi at fortsætte med at "finjustere" TOAST og lagde mærke til, at fra denne version blev parameteren :
Koden til behandling af TOAST aktiveres kun, når værdien af strengen, der skal gemmes i tabellen, overstiger TOAST_TUPLE_THRESHOLD bytes (normalt 2 KB). TOAST-koden vil komprimere og/eller flytte værdierne uden for tabellen, indtil strengen bliver mindre end TOAST_TUPLE_TARGET bytes (variabel størrelse, også normalt 2 KB) eller det bliver umuligt at reducere volumen.
Vi besluttede, at vores data normalt enten er "meget korte" eller "meget lange", så vi besluttede at begrænse os til den mindste mulige værdi:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Lad os se, hvordan de nye indstillinger har påvirket diskbelastningen efter justeringen:
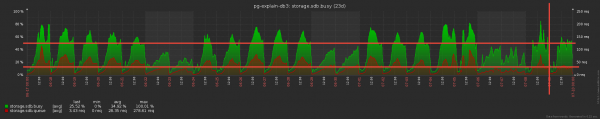
Ikke dårligt! Den gennemsnitlige diskkø er blevet reduceret med cirka 1,5 gange, og diskens "belægning" er faldet med 20%! Men har det muligvis haft en indvirkning på CPU'en?
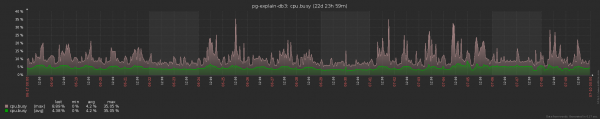
I det mindste er det ikke blevet værre. Selvom det er svært at bedømme, hvis så store mængder stadig ikke kan hæve den gennemsnitlige belastning på CPU'en over 5%.
Fra ændringen af placeringen af ledetrådene... ændrer summen sig!
Som bekendt sparer en rubel penge, og med vores lagringsvolumener på 10TB/måned kan selv en lille optimering give en god fortjeneste. Derfor lagde vi mærke til den fysiske struktur af vores data - hvordan felterne specifikt "er placeret" indeni hver post af disse tabeller.
Fordi på grund af har det direkte :
Mange arkitekturer kræver datajustering på grænserne for maskinord. For eksempel vil på et 32-bit system x86 blive hele tal (integer-type, opptager 4 bytes) justeret til grænsen for 4-byte ord, ligesom dobbeltpræcisions flydende tal (double precision-type, 8 bytes). På et 64-bit system vil double-værdier blive justeret til grænsen for 8-byte ord. Dette er endnu en grund til inkompatibilitet.
På grund af justeringen afhænger størrelsen af tabelrækken af rækkefølgen af felterne. Normalt er denne effekt ikke særlig mærkbar, men i nogle tilfælde kan det føre til en betydelig stigning i størrelsen. For eksempel, hvis man blander felterne char(1) og integer, vil der normalt gå 3 bytes til spilde mellem dem.
Lad os begynde med syntetiske modeller:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bytes

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bytes
Hvor kom de ekstra bytes fra i første tilfælde? Det er ganske enkelt — den 2-byte smallint justeres til en 4-byte grænse før det næste felt, og når det står sidst, er der ikke noget at justere og ikke noget behov.
I teorien er alt godt, og man kan omarrangere felterne, som man ønsker. Lad os tjekke det med reelle data, som et eksempel på en af tabellerne, hvis daglige sektion tager omkring 10-15GB.
Den oprindelige struktur:
CREATE TABLE public.plan_20190220
(
-- Arvet fra tabel plan:  pack uuid NOT NULL,
-- Arvet fra tabel plan:  recno smallint NOT NULL,
-- Arvet fra tabel plan:  host uuid,
-- Arvet fra tabel plan:  ts timestamp with time zone,
-- Arvet fra tabel plan:  exectime numeric(32,3),
-- Arvet fra tabel plan:  duration numeric(32,3),
-- Arvet fra tabel plan:  bufint bigint,
-- Arvet fra tabel plan:  bufmem bigint,
-- Arvet fra tabel plan:  bufdsk bigint,
-- Arvet fra tabel plan:  apn uuid,
-- Arvet fra tabel plan:  ptr uuid,
-- Arvet fra tabel plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sektionen efter ændring af rækkefølgen af kolonnerne — er præcist de samme felter, kun i en anden rækkefølge:
CREATE TABLE public.plan_20190221
(
-- Arvet fra tabel plan:  dt date NOT NULL,
-- Arvet fra tabel plan:  ts timestamp with time zone,
-- Arvet fra tabel plan:  pack uuid NOT NULL,
-- Arvet fra tabel plan:  recno smallint NOT NULL,
-- Arvet fra tabel plan:  host uuid,
-- Arvet fra tabel plan:  apn uuid,
-- Arvet fra tabel plan:  ptr uuid,
-- Arvet fra tabel plan:  bufint bigint,
-- Arvet fra tabel plan:  bufmem bigint,
-- Arvet fra tabel plan:  bufdsk bigint,
-- Arvet fra tabel plan:  exectime numeric(32,3),
-- Arvet fra tabel plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Den samlede størrelse af sektionen bestemmes af antallet af "fakta" og afhænger kun af eksterne processer, så vi deler størrelsen af heap (pg_relation_size) på antallet af poster i den — så vi får den gennemsnitlige størrelse af den reelle lagrede post:
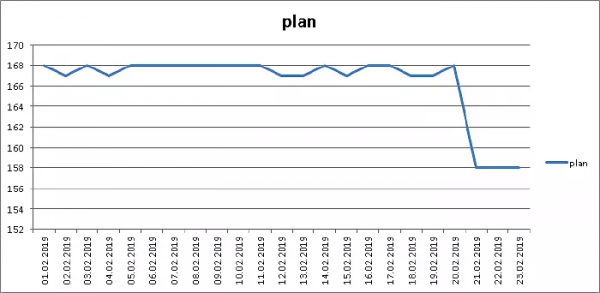
Minus 6% volumen, fremragende!
Men alt er selvfølgelig ikke så rosenrødt — for kan vi ikke ændre rækkefølgen af felterne i indeksene, og derfor er "generelt" (pg_total_relation_size)…
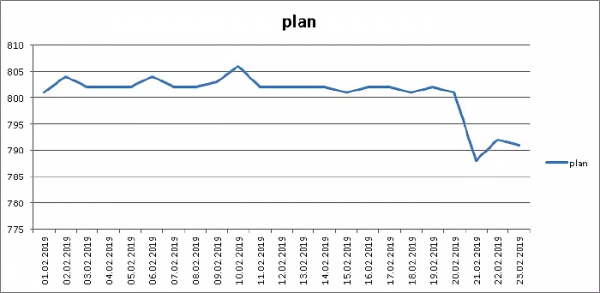
… alligevel her sparet 1,5%, uden at ændre en eneste linje kode. Så ja!
Lad mig bemærke, at den ovenfor beskrevne rækkefølge af felterne — ikke nødvendigvis den mest optimale. Fordi nogle blokke af felter vil man ikke gerne "brække" af æstetiske grunde — for eksempel et par (pack, recno), som er PK for denne tabel.
Generelt set er definitionen af den "mindste" rækkefølge af felter en relativt simpel "brute force" opgave. Så du kan på dine data få resultater, der endda er bedre end vores — prøv!
Kilde: habr.com
