

Oversættelsen af artiklen er udarbejdet forud for begyndelsen af kurset .
Hvordan kan man spare på cloududgifter ved brug af Kubernetes? Der er ikke én rigtig løsning, men denne artikel beskriver flere værktøjer, der kan hjælpe dig med at administrere ressourcerne mere effektivt og reducere omkostningerne til cloud computing.
Jeg har skrevet denne artikel med fokus på Kubernetes for AWS, men den vil også være (næsten) lige så relevant for andre cloududbydere. Jeg går ud fra, at dine klynger allerede har konfigureret automatisk skalering (). At fjerne ressourcer og reducere skaleringsomfanget vil kun spare penge, hvis det også reducerer din park af arbejdsnoder (EC2-instanser).
I denne artikel vil vi se på:
- ryddelse af ubrugte ressourcer ()
- reduktion af skaleringsomfanget i ikke-arbejdstid ()
- brug af horisontal autoskalering (HPA),
- reduktion af overflødig ressourceallokering (, VPA)
- brug af Spot-instanser
Rydning af ubrugte ressourcer
At arbejde i et hurtigt skiftende miljø er fantastisk. Vi ønsker, at tekniske organisationer . Hurtigere softwarelevering betyder også flere PR-udrulninger, forhåndsvisningsmiljøer, prototyper og analytiske løsninger. Alt bliver implementeret på Kubernetes. Hvem har tid til manuelt at rydde op i testudrulninger? Det er let at glemme at slette eksperimenter fra for en uge siden. Regningen for clouden vil i sidste ende stige, fordi vi glemte at lukke:
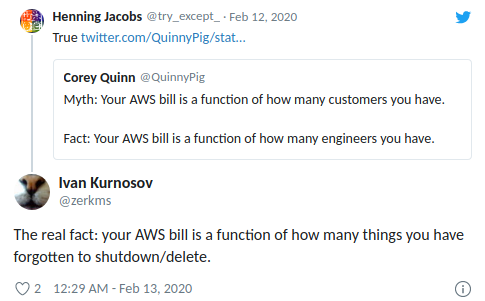
(Henning Jacobs:
Virkeligheden:
(citerer) Corey Quinn:
Myte: Din AWS-regning afhænger af antallet af dine brugere.
Faktum: Din AWS-regning afhænger af antallet af dine ingeniører.
Ivan Kurnosov (til svar):
Reelt faktum: Din AWS-regning afhænger af antallet af ting, du glemte at slukke for/slette.)
(kube-janitor) hjælper med at rydde op i din klynge. Janitor-konfigurationen er fleksibel både til global og lokal brug:
- Generelle regler for hele klyngen kan bestemme den maksimale levetid (TTL — time-to-live) for PR/testudrulninger.
- Separate resources can be annotated using janitor/ttl, for example, to automatically delete spike/prototype after 7 days.
General rules are defined in a YAML file. Its path is passed via the parameter --rules-file in kube-janitor. Here is an example of a rule to delete all namespaces containing -pr- in the name after two days:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
The following example regulates the use of the application label on Deployments and StatefulSet pods for all new Deployments/StatefulSet in 2020, while allowing tests to be run without this label for a week:
- id: require-application-label
  # remove deployments and statefulsets without the "application" label
  resources:
    - deployments
    - statefulsets
  # see http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Running a time-limited demo for 30 minutes in a cluster where kube-janitor is running:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Another source of rising costs is persistent volumes (AWS EBS). When a Kubernetes StatefulSet is deleted, its persistent volumes (PVC - PersistentVolumeClaim) are not deleted. Unused EBS volumes can easily lead to costs of hundreds of dollars per month. Kubernetes Janitor has a feature for cleaning up unused PVCs. For example, this rule will delete all PVCs that are not mounted by a module and are not referenced by a StatefulSet or CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor can help you keep your cluster "clean" and prevent slowly accumulating cloud computing costs. For instructions on deployment and configuration, follow in .
Reducing scaling during non-working hours
Test and staging systems are typically only required to operate during working hours. Some production applications, such as back-office/admin tools, also require only limited availability and can be turned off at night.
(kube-downscaler) giver brugere og operatører mulighed for at nedskalere systemet i nedetid. Deployments og StatefulSets kan skaleres ned til nul replikater. CronJobs kan suspenderes. Kubernetes Downscaler konfigureres for hele klyngen, en eller flere navnerum eller individuelle ressourcer. Man kan indstille enten "nedetid" eller omvendt "driftstid". For eksempel for at maksimere nedskaleringspotentialet om natten og i weekenden:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # deaktiver ikke infrastrukturkomponenter
  - --exclude-namespaces=kube-system,infra
  # ikke deaktiver kube-downscaler, og lad Postgres Operator være aktiveret, så de ekskluderede databaser kan administreres
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Her er grafen for skaleringsarbejdere i klyngen i weekenderne:
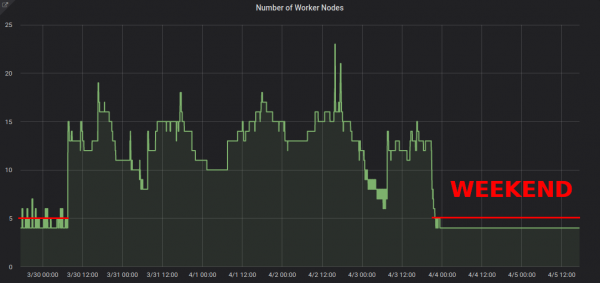
Nedskaleringsniveauet fra ~13 til 4 arbejdere giver helt klart en mærkbar forskel i AWS-regningen.
Men hvad hvis jeg skal arbejde i "nedetid" for klyngen? Bestemte deployments kan permanent ekskluderes fra nedskalering ved at tilføje annoteringen downscaler/exclude: true. Deployments kan midlertidigt ekskluderes med annoteringen downscaler/exclude-until med et absolut tidsstempel i formatet YYYY-MM-DD HH:MM (UTC). Hvis nødvendigt, kan hele klyngen skaleres op igen ved at udrulle en pod med annoteringen downscaler/force-uptime, for eksempel ved at starte en nginx dummy:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # slet deployment efter en time
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Se , hvis du er interesseret i installationsvejledningen og flere muligheder.
Brug horisontal autoscaling
Mange applikationer/tjenester har at gøre med en dynamisk belastningsskema: nogle gange er deres moduler inaktive, og nogle gange kører de på fuld kapacitet. At arbejde med en konstant park af pods for at håndtere maksimal spidsbelastning er ikke økonomisk. Kubernetes understøtter horisontal autoscaling via ressourcen (HPA). CPU-brug er ofte en god indikator for skalering:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando har oprettet en komponent for nemt at tilslutte brugerdefinerede målinger til autoskalering: (kube-metrics-adapter) er en universel metrics-adapter til Kubernetes, der kan indsamle og levere brugerdefinerede og eksterne målinger til horisontal autoskalering af pods. Den understøtter skalering baseret på Prometheus-målingsdata, SQS-køer og andre konfigurationer. For eksempel, for at skalere en deployment for en brugerdefineret måling præsenteret af applikationen som JSON i /metrics, brug:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Opsætning af horisontal autoskalering med HPA bør være en af de standardhandlinger for at øge effektiviteten af tjenester uden at tage hensyn til tilstand. Spotify har en præsentation med deres erfaringer og anbefalinger til HPA: .
Reduktion af overdreven ressourcebeholdning
Kubernetes-arbejdsmængder definerer deres behov for CPU/hukommelse gennem 'resource requests'. CPU-ressourcer måles i virtuelle kerner eller oftere i 'millicores' (millicores), for eksempel 500m betyder 50% vCPU. Hukommelsesressourcer måles i bytes, og almindelige suffikser kan bruges, for eksempel 500Mi, der betyder 500 megabyte. Resource requests 'låser' mængden på arbejdsnoderne, hvilket betyder, at et modul med en CPU-anmodning på 1000m på en node med 4 virtuelle CPU'er kun efterlader 3 virtuelle CPU'er tilgængelige for andre moduler.
Slack (overdreven beholdning) — dette er forskellen mellem de anmodede ressourcer og det faktiske forbrug. For eksempel, en pod, der anmoder om 2 GiB hukommelse men kun bruger 200 MiB, har ~ 1,8 GiB ”overflødig” hukommelse. Overflødighed koster penge. Man kan groft estimere, at 1 GiB overflødig hukommelse koster ~ 10 dollars om måneden.
(kube-resource-report) viser overskydende reserver og kan hjælpe dig med at identificere potentiale for besparelser:
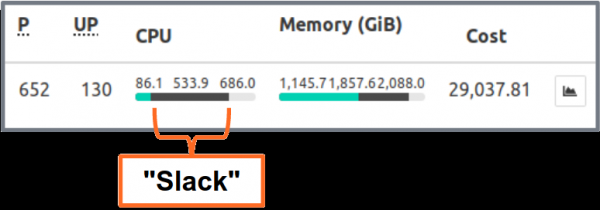
viser overskuddet, aggregeret af applikationen og holdet. Dette gør det muligt at finde steder, hvor ressourceanmodninger kan reduceres. Den genererede HTML-rapport giver kun et snapshot af ressourceforbruget. Du skal se på CPU/ram-forbruget over tid for at bestemme passende ressourceanmodninger. Her er et Grafana-diagram for en "typisk" tjeneste med tung CPU-belastning: alle pods bruger betydeligt mindre end 3 anmodede CPU-kerner:
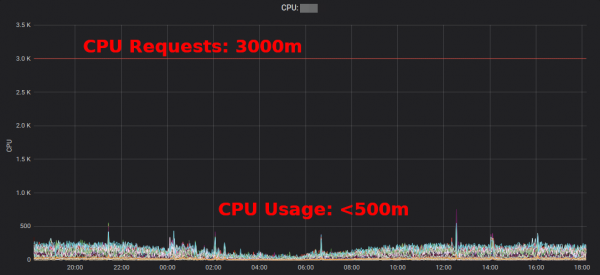
At reducere CPU-anmodningen fra 3000m til ~400m frigiver ressourcer til andre arbejdsbelastninger og gør det muligt at reducere klyngen.
"Gennemsnitligt CPU-forbrug af EC2-instanser svinger ofte mellem ensifrede procenter," . Mens for EC2 , er det let at ændre nogle Kubernetes ressourceanmodninger i YAML-filen, og det kan medføre enorme besparelser.
Men ønsker vi virkelig, at folk ændrer værdier i YAML-filer? Nej, maskiner kan gøre det meget bedre! Kubernetes (VPA) gør netop dette: tilpasser ressourceanmodninger og grænser baseret på arbejdsbelastningen. Her er et eksempel på et graf over CPU-anmodninger fra Prometheus (den tynde blå linje), tilpasset VPA over tid:
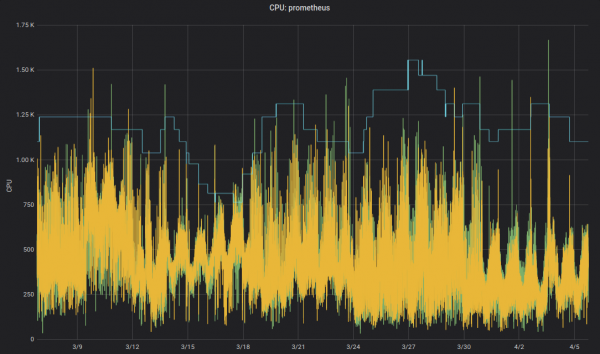
til infrastrukturelle komponenter. Ikke-kritiske applikationer kan også bruge VPA.
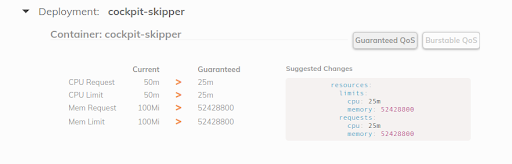
fra Fairwind — er et værktøj, der opretter VPA for hver deployment i navnerummet og derefter viser VPA-anbefalingen på sit dashboard. Det kan hjælpe udviklere med at fastsætte de rigtige CPU/ram-anmodninger for deres applikationer:
Jeg skrev et lille i 2019, og for nylig blev spørgsmålet om VPA diskuteret i .
Brug af EC2 Spot-instanser
Endelig, og lige så vigtigt, kan omkostningerne ved AWS EC2 reduceres ved at bruge Spot-instanser som arbejdsknuder til Kubernetes. . Spot-instanser er tilgængelige med rabatter på op til 90% i forhold til priserne for on-demand. At køre Kubernetes på EC2 Spot er en god kombination: du skal angive flere forskellige typer instanser for højere tilgængelighed, hvilket betyder, at du kan få en større knude til samme eller en lavere pris, og den øgede kapacitet kan udnyttes af containerarbejdsmængderne i Kubernetes.
Hvordan kører man Kubernetes på EC2 Spot? Der er flere muligheder: brug en tredjepartstjeneste som SpotInst (nu kaldet 'Spot', spørg mig ikke hvorfor), eller tilføj blot en Spot AutoScalingGroup (ASG) til din klynge. Her er for eksempel et uddrag af CloudFormation for en 'kapacitetsoptimeret' Spot ASG med flere instanstyper:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Nogle bemærkninger om brugen af Spot med Kubernetes:
- Du skal håndtere Spot-afbrydelser, f.eks. ved at forberede noden til nedlæggelse, når instansen stoppes.
- Zalando bruger den officielle klynge-autoskaleringsløsning med node-puljernes prioriteter.
- Spot-noder til at acceptere 'registreringer' fra arbejdsbelastninger til kørsel på Spot.
CV
Jeg håber, at du finder nogle af de præsenterede værktøjer nyttige til at reducere din cloud-oversigt. Du kan finde det meste af indholdet i artiklen også i .
Hvad er dine bedste praksisser for at spare på cloudomkostningerne ved Kubernetes? Lad mig vide det i .
Faktisk vil færre end 3 virtuelle CPU være anvendelige, da nodekapaciteten reduceres på grund af reserverede systemressourcer. Kubernetes skelner mellem den fysiske kapacitet af en node og de "tildelte" ressourcer ().
Eksempel på beregning: en m5.large instans med 8 GiB hukommelse koster omkring ~84 USD om måneden (eu-central-1, On-Demand), dvs. låsning af 1/8 af noden koster cirka ~10 USD om måneden.
Der er mange andre måder at reducere din EC2-regning på, såsom reserverede instanser, spareplaner osv. — jeg vil ikke dække disse emner her, men du bør bestemt undersøge dem!
Kilde: habr.com
