

Baseret på mine præsentationer ved Highload++ og DataFest Minsk 2019.
For mange er e-mail i dag en uundgåelig del af livet online. Vi bruger den til geschäftskommunikation, opbevarer forskellige vigtige informationer relateret til økonomi, hotelreservationer, ordrebehandling og meget mere. I midten af 2018 formulerede vi en produktstrategi for udviklingen af e-mail. Hvordan skal moderne e-mail være?
E-mail skal være smart, det vil sige hjælpe brugerne med at navigere i den stigende mængde information: filtrere, strukturere og præsentere den på den mest bekvemme måde. Den skal være nyttig, hvilket gør det muligt direkte fra indbakken at løse forskellige opgaver, for eksempel betale bøder (en funktion, som jeg desværre måtte bruge). Og selvfølgelig skal e-mail sikre informationsbeskyttelse ved at blokere spam og beskytte mod hacking, det vil sige være sikre.
Disse retninger definerer en række centrale opgaver, hvoraf mange effektivt kan løses ved hjælp af maskinlæring. Her er eksempler på allerede fungerende funktioner, udviklet inden for strategien — én for hver retning.
- Smart Reply. E-mailen har en smart svar-funktion. Neuralnetværket analyserer teksten i e-mailen, forstår dens mening og formål, og tilbyder derefter tre mest passende svarmuligheder: positiv, negativ og neutral. Dette hjælper betydeligt med at spare tid, når man svarer på e-mails, og ofte besvarer man også på en uventet og sjov måde.
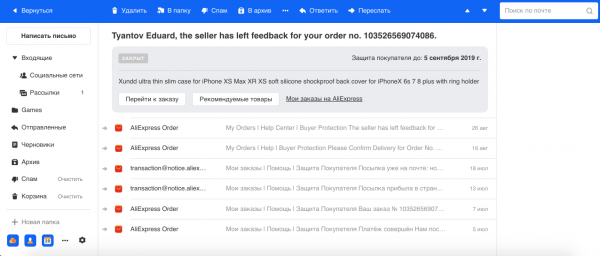
- Gruppering af e-mails, der vedrører ordrer i webshops. Vi handler ofte online, og typisk kan butikker sende flere e-mails pr. ordre. For eksempel fra AliExpress, hvor den største tjeneste sender mange e-mails vedrørende én ordre, og vi har beregnet, at i krisesituationer kan antallet nå op til 29. Derfor bruger vi modellen Named Entity Recognition til at udtrække ordrenummer og anden information fra teksten og gruppere alle e-mails i en tråd. Vi viser også hovedoplysningerne om ordren i et separat felt, hvilket letter arbejdet med denne type e-mails.

- AntiphishingPhishing er en farlig type bedragerisk e-mail, hvor kriminelle forsøger at få fat i finansielle oplysninger (herunder brugernes kreditkortoplysninger) og loginoplysninger. Disse e-mails efterligner ægte e-mails sendt af tjenester, også visuelt. Derfor bruger vi Computer Vision til at genkende logoer og designstile fra store virksomheder (f.eks. Mail.ru, Sber, Alfa) og tager dette i betragtning sammen med tekst og andre indikatorer i vores spam- og phishingklassifikatorer.
Maskinlæring
Lidt om maskinlæring i e-mail generelt. E-mail er et højbelastet system: Gennem vores servere passerer der i gennemsnit 1,5 milliarder e-mails dagligt for 30 millioner daglige brugere. Ca. 30 maskinlæringssystemer håndterer alle nødvendige funktioner og features.
Hver e-mail går gennem en hel klassifikationskæde. Først filtrerer vi spam fra og lader gode e-mails komme igennem. Brugerne bemærker ofte ikke arbejdet med at bekæmpe spam, da 95-99 % af spam ikke selv når ind i den relevante mappe. Spamgenkendelse er en meget vigtig del af vores system og den mest komplekse, da der inden for spambeskyttelse konstant er en tilpasning mellem beskyttelsessystemer og angreb, hvilket giver en kontinuerlig ingeniørudfordring for vores team.
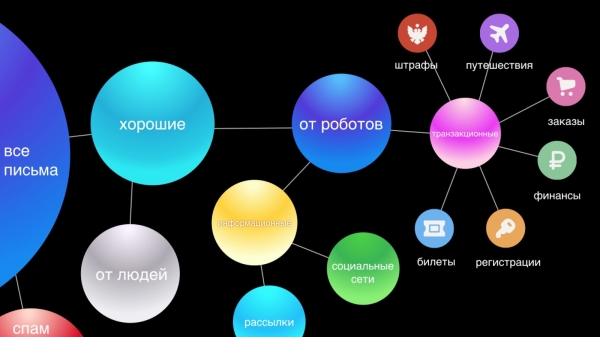
Dernæst adskiller vi e-mails fra mennesker og robotter. E-mails fra mennesker er de mest vigtige, så for dem tilbyder vi funktioner som Smart Reply. E-mails fra robotter opdeles i to kategorier: transaktionelle – dette er vigtige e-mails fra tjenester, såsom bekræftelser af køb eller hotelreservationer, finansielle oplysninger, og informationsmæssige – dette er forretningsreklamer og rabatter.
Vi mener, at transaktionelle e-mails er lige så vigtige som personlig korrespondance. De skal være lige ved hånden, da man ofte hurtigt har brug for at finde information om en ordre eller en flyreservation, og vi bruger tid på at lede efter disse e-mails. Derfor deler vi dem for nemheds skyld automatisk op i seks hovedkategorier: rejser, ordrer, finanser, billetter, registreringer og endelig bøder.
Informationsbreve er den mest talrige og nok også den mindst vigtige gruppe, som ikke kræver øjeblikkelig reaktion, da ingenting væsentligt ændrer sig i brugerens liv, hvis han ikke læser en sådan e-mail. I vores nye interface samler vi dem i to tråde: sociale medier og nyhedsbreve, og derved ryder vi visuelt op i indbakken og lader kun vigtige e-mails være synlige.
Drift
Et stort antal systemer medfører mange udfordringer i driften. For modeller degraderes over tid, ligesom enhver software: tydelige tegn mislykkes, maskiner svigter, og der bygger sig en dårlig kode op. Desuden ændres data konstant: nye tilføjes, brugeradfærdens mønstre transforms, osv., hvorfor en model uden tilstrækkelig support vil fungere dårligere og dårligere over tid.
Man skal også huske, at jo dybere maskinlæring trænger ind i brugernes liv, jo større indflydelse har de på økosystemet, og som følge heraf, jo større økonomiske tab eller gevinster kan aktørerne på markedet opnå. Derfor tilpasser flere og flere aktører sig til at arbejde med ML-algoritmer (klassiske eksempler er reklame, søgning og det allerede nævnte spamfilter).
Desuden har opgaver inden for maskinlæring den egenskab, at enhver, selv en lille, ændring i systemet kan føre til meget arbejde med modellen: databehandling, genuddannelse, deployment, hvilket kan tage uger eller måneder. Så jo hurtigere miljøet, hvor dine modeller opererer, ændrer sig, jo mere kræver det afsætningsarbejde at supportere dem. Et team kan bygge mange systemer og glæde sig over dette, men så bruge næsten alle ressourcer på deres vedligeholdelse, uden mulighed for at lave noget nyt. I et sådant scenario støttede vi tidligere en gang i anti-spam teamet. Og vi nåede den åbenlyse konklusion, at vedligeholdelse skal automatiseres.
Automatisering
Hvad kan automatiseres? Faktisk næsten alt. Jeg har identificeret fire områder, der definerer infrastrukturen for maskinlæring:
- dataindsamling;
- forfining;
- deployment;
- test & overvågning.
Hvis miljøet er ustabilt og konstant ændrer sig, så er hele infrastrukturen omkring modellen langt vigtigere end selve modellen. Det kan være en god gammeldags lineær klassifikator, men hvis man korrekt præsenterer funktionerne for den og etablerer en god feedback fra brugerne, vil den fungere meget bedre end de nyeste state-of-the-art-modeller med alle mulige funktioner.
Feedbackcyklus
Denne cyklus omfatter indsamling af data, finjustering og implementering — i bund og grund hele opdateringscyklussen for modellen. Hvorfor er det vigtigt? Se på grafen for registreringen i e-mailen:
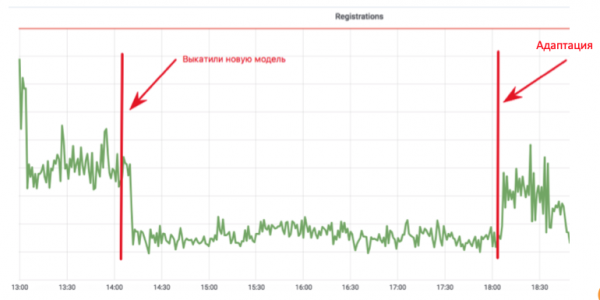
Udvikleren af maskinlæring implementerede en anti-bot model, der forhindrer bots i at registrere sig i e-mailen. Grafen falder til et niveau, hvor der kun er rigtige brugere tilbage. Alt ser fantastisk ud! Men efter fire timer tilpasser bot-skribenterne deres scripts, og alt vender tilbage til status quo. I denne implementering brugte udvikleren en måned på at tilføje funktioner og finjustere modellen, men spammerne kunne tilpasse sig på bare fire timer.
For at det ikke skal blive så pinefuldt og man ikke ender med at skulle gøre alt om, skal man i starten tænke på, hvordan feedbackcyklussen vil se ud, og hvad vi vil gøre, hvis miljøet ændrer sig. Lad os starte med at indsamle data — det er brændstoffet til vores algoritmer.
Dataindsamling
Det er klart, at moderne neurale netværk fungerer bedre jo flere data de har, og disse data genereres reelt af produktets brugere. Brugere kan hjælpe os ved at annotere data, men vi må ikke misbruge dette, fordi brugerne på et tidspunkt vil blive trætte af at finjustere jeres modeller og vil skifte til et andet produkt.
En af de mest almindelige fejl (her henviser jeg til Andrew Ng) er at have en for stærk fokus på metrikker på testdatasættet, snarere end feedback fra brugeren, hvilket faktisk er det vigtigste mål for kvalitet, da vi skaber produkter til brugerne. Hvis brugeren ikke kan forstå eller ikke bryder sig om, hvordan modellen fungerer, så er alt forgæves.
Derfor skal brugeren altid have mulighed for at stemme, og vi skal give dem et værktøj til feedback. Hvis vi mener, at der er kommet en e-mail, der vedrører økonomi, skal vi mærke den som 'økonomi' og tegne en knap, som brugeren kan trykke på og sige, at det ikke er økonomi.
Kvaliteten af feedback
Lad os tale om kvaliteten af brugerfeedback. For det første kan du og brugeren lægge forskellig betydning i det samme begreb. For eksempel mener du og produktcheferne, at "finanser" er bankbreve, mens brugeren mener, at et brev fra sin bedsteforælder om pension også hører til under finans. For det andet er der brugere, der tankeløst elsker at trykke på knapper uden nogen logik. For det tredje kan brugeren være dybt fejlinformeret i sine konklusioner. Et klart eksempel fra vores praksis er implementeringen af klassifikatoren , en temmelig underholdende type spam, hvor brugeren bliver tilbudt at hente flere millioner dollars fra en pludselig funden fjern slægtning i Afrika. Efter implementeringen af denne klassifikator kontrollerede vi klik på "Ikke spam" på disse breve, og det viste sig, at 80 % af dem var saftig nigeriansk spam, hvilket tyder på, at brugerne kan være ekstremt naiv.
Og lad os ikke glemme, at der ikke kun kan trykkes på knapper af mennesker, men også af forskellige bots, der udgiver sig for at være browsere. Så rå feedback er ikke egnet til træning. Hvad kan der gøres med denne information?
Vi anvender to tilgange:
- Feedback fra relateret ML. For eksempel har vi et online anti-bot-system, som, som jeg allerede har nævnt, træffer hurtige beslutninger baseret på et begrænset antal funktioner. Og der er et andet, langsommere system, der arbejder post factum. Det har flere data om brugeren, om hans adfærd osv. Som følge deraf træffes den mest afbalancerede beslutning, hvilket giver det højere nøjagtighed og fuldstændighed. Forskellen i arbejdet mellem disse systemer kan sendes til det første som træningsdata. På denne måde vil det enklere system altid forsøge at nærme sig ydelsen af det mere komplekse.
- Klikklassifikation. Man kan blot klassificere hvert klik fra brugeren, vurdere dets gyldighed og brugsmuligheder. Det gør vi i antispam for e-mails ved at bruge brugerens tegn, hans historik, afsenderens karakteristika, selve teksten og resultatet fra klassificatorerne. I sidste ende får vi et automatisk system, der validerer brugerens feedback. Og da det skal trænes betydeligt sjældnere, kan dets arbejde blive grundlaget for alle andre systemer. Hovedprioriteten i denne model er præcision, fordi det at træne modellen på unøjagtige data kan få alvorlige konsekvenser.
Mens vi renser dataene og træner vores ML-systemer, må vi ikke glemme brugerne, for for os er tusindvis, millioner af fejl på grafen statistik, mens hver fejl for brugeren er en tragedie. Udover at brugeren skal leve med din fejl i produktet, forventer de, efter at have givet feedback, at lignende situationer ikke vil gentage sig i fremtiden. Derfor er det vigtigt altid at give brugerne mulighed for ikke kun at stemme, men også at korrigere ML-systemernes adfærd ved at skabe for eksempel personlige heuristikker for hvert klik på feedbacken; i tilfælde af e-mail kan det være muligheden for at filtrere sådanne e-mails efter afsender og emne for den pågældende bruger.
Der skal også på basis af nogen rapporter eller henvendelser til supporten i et semi-automatisk eller manuelt regime knokles med modellen, så andre brugere ikke lider under lignende problemer.
Heuristikker til træning
Der er to problemer med disse heuristikker og knæk. For det første er det svært at vedligeholde det konstant voksende antal knæk, for ikke at tale om deres kvalitet og effektivitet på lang sigt. Det andet problem er, at fejlen ikke nødvendigvis er hyppig, og at få klik til at træne modellen ikke vil være tilstrækkeligt. Det virker som om, at disse to uafhængige effekter kan reduceres betydeligt, hvis vi anvender den følgende tilgang.
- Oprettelse af et midlertidigt knæk.
- Vi sender data fra det til modellen, som regelmæssigt bliver trænet, også på de indsamlede data. Her er det selvfølgelig vigtigt, at heuristikken har høj nøjagtighed, for ikke at reducere datakvaliteten i træningssættet.
- Derefter sætter vi overvågning op for aktivering af workaround'en, og hvis workaround'en ikke længere aktiveres over tid og helt erstattes af modellen, kan den trygt fjernes. Nu er det usandsynligt, at dette problem vil gentage sig.
Så derfor er en hær af workarounds meget nyttig. Det vigtigste er, at deres tjeneste er midlertidig og ikke vedvarende.
Finjustering
Finjustering er processen med at tilføje nye data, der er indsamlet som følge af feedback fra brugere eller andre systemer, og træne den eksisterende model på disse. Der kan være flere problemer med finjustering:
- Modellen kan simpelthen ikke understøtte finjustering og kun lære fra bunden.
- Der står intet i naturens bog, der siger, at finjustering nødvendigvis vil forbedre kvaliteten i produktionen. Det sker ofte det modsatte, dvs. at der kun er risiko for forringelse.
- Ændringer kan være uforudsigelige. Dette er en ganske delikat sag, som vi har identificeret. Selv hvis den nye model i A/B-testen viser lignende resultater i forhold til den nuværende, betyder det slet ikke, at den vil fungere identisk. Deres præstation kan variere med et enkelt procentpoint, hvilket kan medføre nye fejl eller genindføre allerede rettede gamle fejl. Med de nuværende fejl har både vi og brugerne allerede lært at leve, og når der opstår mange nye fejl, kan brugeren heller ikke forstå, hvad der sker, for han forventer en forudsigelig adfærd.
Derfor er det vigtigste ved finjustering at sikre, at man forbedrer modellen eller i det mindste ikke forringer den.
Det første, der falder mig ind, når vi taler om finjustering, er Active Learning-tilgangen. Hvad betyder det? For eksempel bestemmer en klassificerer, om en e-mail tilhører økonomi, og omkring dens beslutningsgrænse tilføjer vi et udvalg af mærkede eksempler. Dette fungerer godt, for eksempel i reklame, hvor der er meget feedback, og man kan træne modellen i realtid. Men hvis der er lidt feedback, får vi et stærkt skævvredet udvalg i forhold til produktionsdatafordelingen, som ikke kan bruges til at evaluere modellens adfærd i driftsprocessen.
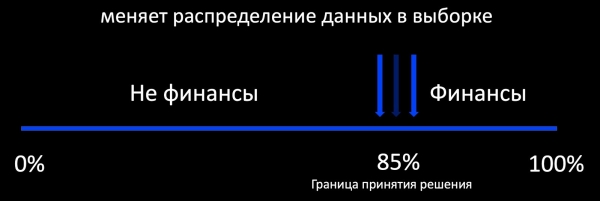
Vores mål er faktisk at bevare de gamle mønstre, de allerede kendte modeller, og at erhverve nye. Her er kontinuitet vigtig. Den model, vi ofte har præsenteret med stort besvær, er allerede i brug, så vi kan basere os på dens ydeevne.
I brevmail anvendes forskellige modeller: træer, lineære, neurale netværk. For hver af dem laver vi vores egen finjusteringsalgoritme. I finjusteringsprocessen får vi ikke kun nye data, men også ofte nye karakteristika, som vi vil tage hensyn til i alle algoritmerne nedenfor.
Lineære modeller
Lad os sige, vi har logistisk regression. Vi sammensætter tabet for modellen af følgende komponenter:
- LogLoss på nye data;
- regulerer vægtene for de nye karakteristika (de gamle berøres ikke);
- lærer også med de gamle data for at bevare de gamle mønstre;
- og måske det vigtigste: vi påfører Harmonic Regularization, som sikrer, at vægtene ikke ændres meget i forhold til den gamle model med hensyn til normen.
Da hver komponent af tab har koefficienter, kan vi finde de optimale værdier for vores opgave gennem krydsvalidering eller baseret på produktkrav.
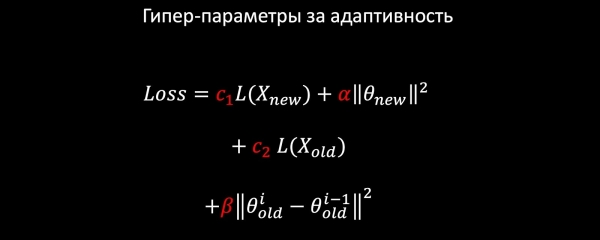
Træer
Lad os gå videre til beslutningstræer. Vi har udviklet følgende algoritme til finjustering af træerne:
- Vi har en skov med 100-300 træer, som er trænet på det gamle datasæt.
- Vi fjerner 5 i slutningen og tilføjer 10 nye, trænet på hele datasættet, men med høj vægt på nye data, hvilket naturligt sikrer en inkrementel ændring af modellen.
Det er tydeligt, at antallet af træer over tid stiger kraftigt, og de skal regelmæssigt reduceres for at overholde tidsrammerne. Til dette bruger vi den i dag almindelige Knowledge Distillation (KD). Kort om princippet bag.
- Vi har den nuværende ’kompleks’ model. Vi kører den på træningsdatasættet og får sandsynlighedsfordelingen for klasserne som output.
- Herefter lærer vi eleven modellen (modellen med færre træer i dette tilfælde) at gentage resultaterne fra modellen ved at bruge klassesandsynlighedsfordelingen som den målrettede variabel.
- Det er vigtigt at bemærke, at vi ikke bruger nogen form for datasætmarkup, og derfor kan vi anvende vilkårlige data. Selvfølgelig bruger vi en sample data fra produktionsstrømmen som træningssæt til elevmodellen. På den måde giver træningssættet os mulighed for at sikre modellens nøjagtighed, mens samplestrømmen garanterer lignende ydeevne ved produktionsfordelingen, hvilket kompenserer for skævheden i træningssættet.
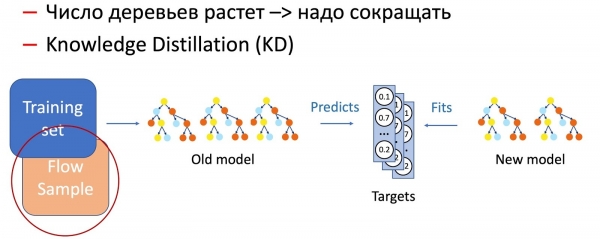
Kombinationen af disse to metoder (tilføjelse af træer og periodisk reduktion af deres antal ved hjælp af Knowledge Distillation) sikrer introduktionen af nye mønstre og fuld kontinuitet.
Med KD udfører vi også operationer med modellens træk, som f.eks. fjernelse af træk og arbejde med mangler. I vores tilfælde har vi en række vigtige statistiske træk (vedrørende afsendere, teksthashes, URL'er osv.), som er gemt i en database med tilbøjelighed til at fejle. Modellen er selvfølgelig ikke klar til en sådan udvikling, da der ikke findes situationer med fejl i træningssættet. I sådanne tilfælde kombinerer vi KD-teknikker med augmentation: ved træning af en del af dataene fjerner eller nulstiller vi nødvendige træk, mens etiketterne (udgangen fra den nuværende model) tages som originale, og elevmodellen lærer at gentage denne fordeling.
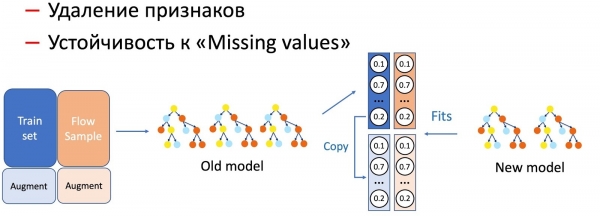
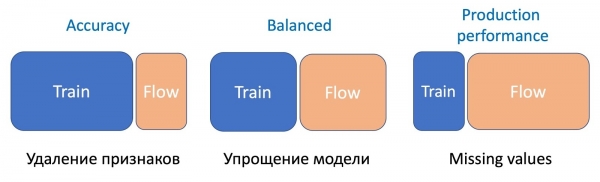
Vi har bemærket, at jo mere alvorlig manipulation med modellerne der udføres, jo mere samplestrøm kræves i procent.
For at fjerne træk, som er den letteste operation, kræves kun en lille del af strømmen, da der kun ændres et par træk, og den nuværende model er blevet trænet på det samme sæt — forskellen er minimal. For at forenkle modellen (reducere antallet af træer flere gange) kræves der allerede 50 til 50. Og for at håndtere mangler af vigtige statistiske træk, som alvorligt påvirker modellens ydeevne, kræves der endnu mere strøm for at nivellere den nye model, der er robust over for mangler, på alle typer af mails.
FastText
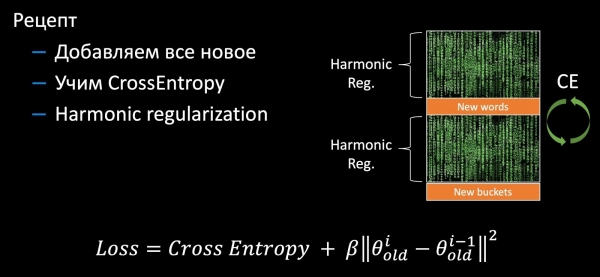
Lad os gå videre til FastText. Jeg minder om, at repræsentationen (Embedding) af et ord består af summen af embedding'en af selve ordet og alle dets bogstav N-grammer, typisk trigrammer. Da der kan være mange trigrammer, anvendes Bucket Hashing, hvilket vil sige, at hele rummet omdannes til en bestemt fast hash-map. Resultatet er, at vægtmatricen får dimensioner svarende til det interne lag gange antallet af ord + buckets.
Under finjustering opstår der nye funktioner: ord og trigrammer. I den standard finjustering, der anvendes af Facebook, sker der ikke noget væsentligt. Kun de gamle vægte bliver finjusteret med kryds-entropi på de nye data. Hermed bruges nye funktioner ikke, og naturligvis har denne tilgang alle de ovennævnte ulemper, der er forbundet med modellens uforudsigelighed i produktionen. Derfor har vi lidt videreudviklet FastText. Vi tilføjer alle nye vægte (ord og trigrammer), finjusterer hele matricen med kryds-entropi og tilføjer harmonisk regularisering som i den lineære model, som sikrer en ubetydelig ændring af de gamle vægte.
CNN
Det er lidt mere kompliceret med konvolutionsnetværk. Hvis de sidste lag i CNN finjusteres, kan man naturligvis anvende harmonisk regularisering og sikre kontinuitet. Men i det tilfælde, hvor hele netværket skal finjusteres, kan sådan en regularisering ikke anvendes på alle lag. Der er dog en mulighed for at træne komplementære embeddings gennem Triplet Loss ().
Triplet Loss
Vi vil i grove træk gennemgå Triplet Loss ved at tage udgangspunkt i opgaven med at opdage phishing. Vi tager vores logo samt positive og negative eksempler på logoer fra andre virksomheder. Vi minimerer afstanden mellem de første og maksimerer afstanden mellem de sidste, og vi gør dette med en lille margin for at sikre større kompakthed af klasserne.
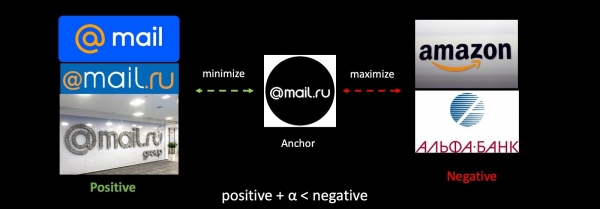
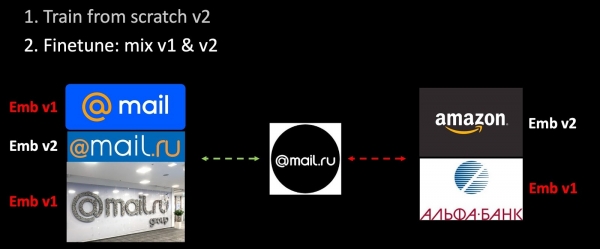
Hvis vi finjusterer netværket, ændres det metrisk rum fuldstændigt, og det bliver absolut inkompatibelt med det forrige. Dette er et alvorligt problem i opgaver, der bruger vektorer. For at overvinde dette problem vil vi blande gamle embeddings ind under træningen.
Vi har tilføjet nye data til træningssættet og træner fra bunden den anden version af modellen. I den anden fase finjusterer vi vores netværk: først finjusteres det sidste lag, og derefter fryses hele netværket. Under sammensætningen af tripletter beregner vi kun en del af indlejringerne ved hjælp af den trænede model, mens resten beregnes med den gamle. På den måde sikrer vi kompatibiliteten mellem de metrisk rum v1 og v2 under finjusteringen. En slags harmonisk regularisering.
Helhedsarkitektur
Hvis vi ser på hele systemet i eksemplet med spamfiltering, så er modellerne ikke isolerede, men indlejret i hinanden. Vi tager billeder, tekst og andre træk, og ved hjælp af CNN og Fast Text får vi indlejringer. Derefter anvendes klassifikatorer over indlejringerne, som giver scores for forskellige klasser (typer af e-mails, spam, tilstedeværelse af logoer). Scores og træk går ind i et skov af træer for at træffe den endelige beslutning. Separate klassifikatorer i denne ordning gør det muligt at bedre fortolke resultaterne fra systemets arbejde og mere målrettet at finjustere komponenterne i tilfælde af problemer, end at give alle data råt ind i beslutningstræerne.
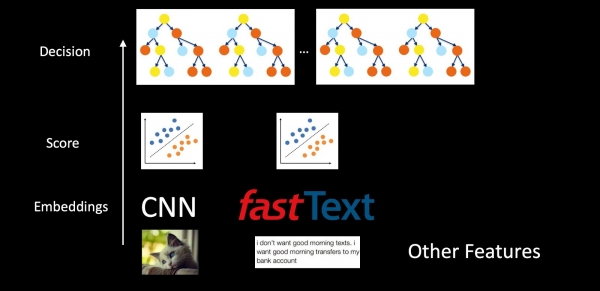
Som et resultat sikrer vi kontinuitet på hvert niveau. På det lavere niveau i CNN og Fast Text anvender vi harmonisk regularisering, og til klassifikatorerne i midten — også harmonisk regularisering og kalibrering af scorerne for at sikre kompatibilitet med sandsynlighedsfordelingen. Boosting af træerne trænes inkrementelt eller ved hjælp af Knowledge Distillation.
Generelt set kan understøttelsen af et sådant indlejret system af maskinlæring være smertefuld, da enhver komponent på det lavere niveau fører til en opdatering af hele systemet ovenfor. Men da hver komponent i vores setup ændres minimalt og er kompatibel med den forrige, kan hele systemet opdateres i bidder uden behov for at gentræne hele strukturen, hvilket gør det muligt at vedligeholde det uden alvorligt overhead.
Deploy
Vi har gennemgået indsamlingen af data og finjusteringen af forskellige typer modeller, så nu går vi videre til deres deployment i produktionsmiljøet.
A/B-testning
Som jeg nævnte tidligere, får vi typisk en skæv stikprøve under dataindsamlingen, hvilket gør det umuligt at vurdere produktionsydeevnen af modellen. Derfor er det vigtigt at sammenligne modellen med den tidligere version ved implementeringen for at forstå, hvordan det faktisk står til, altså at udføre A/B-tests. Faktisk er processen med lancering og analyse af grafer ret rutinemæssig og er let at automatisere. Vi ruller vores modeller ud gradvist til 5 %, 30 %, 50 % og 100 % af brugerne, samtidig med at vi indsamler alle tilgængelige metrics fra modelens svar og brugernes feedback. I tilfælde af alvorlige udsving ruller vi automatisk modellen tilbage, og for de resterende tilfælde, efter at have indsamlet et tilstrækkeligt antal brugerklik, træffer vi en beslutning om at øge procentdelen. I sidste ende bringer vi den nye model op til 50 % af brugerne helt automatisk, mens en person godkender lanceringen til hele publikum, selvom dette trin også kan automatiseres.
Men A/B-testprocessen rummer muligheder for optimering. Problemet er, at enhver A/B-test er relativt lang (i vores tilfælde tager den mellem 6 og 24 timer afhængigt af mængden af feedback), hvilket gør den ret kostbar og med begrænsede ressourcer. Derudover kræves der en høj procentdel af flowet til testen for i realiteten at fremskynde den samlede tid for A/B-testen (at opsamle statistisk signifikante stikprøver for at vurdere metrics på et lille procentdel kan tage lang tid), hvilket gør antallet af A/B-slots ekstremt begrænset. Det er åbenlyst, at vi skal bringe de mest lovende modeller ind i testen, og i løbet af den yderligere træning får vi mange af dem.
For at løse denne opgave har vi trænet en separat klassificer, der forudsiger succesraten for A/B-testen. Til dette bruger vi som funktioner beslutningsstatistik, Precision, Recall og andre metrics på det træningssæt, det afholdte sæt og et sample fra flowet. Vi sammenligner også modellen med den nuværende version i produktionen, med heuristikker og tager modellens kompleksitet (Complexity) i betragtning. Ved at bruge alle disse funktioner scorer klassificeren, der er trænet på testhistorikken, modellerne-kandidater, i vores tilfælde træer i skovene, og træffer beslutning om, hvilken af dem der skal sendes til A/B-test.
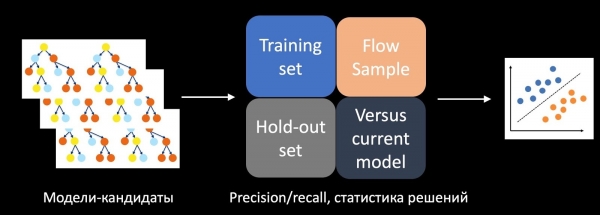
Ved implementeringen gjorde denne tilgang det muligt at øge antallet af vellykkede A/B-tests flere gange.
Testning & overvågning
Testning og overvågning skader, mærkeligt nok, ikke vores helbred; tværtimod forbedrer de det og befrier os for unødvendig stress. Testning forhindrer fejl, mens overvågning opdager dem i tide for at minimere indflydelsen på brugerne.
Her er det vigtigt at forstå, at din system altid vil fejle før eller senere — dette er en del af udviklingscyklussen for enhver software. I starten af systemudviklingen er der altid mange fejl, indtil alt falder på plads og den primære innovationsfase er afsluttet. Men over tid kommer entropien tilbage, og fejl opstår igen på grund af komponentdegradering og ændringer i data, som jeg nævnte indledningsvis.
Her vil jeg gerne bemærke, at ethvert maskinlæringssystem skal betragtes udfra dens afkast gennem hele livscyklussen. Nedenfor vises et eksempel på, hvordan et system til at fange sjældne former for spam fungerede (grafen viser en linje tæt på nul). En gang forårsagede en forkert cachelagret funktion, at det blev ustabilt. Som held var der ingen overvågning for unormale aktiveringer, hvilket resulterede i, at systemet begyndte at gemme e-mails i mappen "spam" i store mængder ved beslutningsgrænsen. På trods af at der blev rettet op på konsekvenserne, havde systemet allerede fejlet så mange gange, at det ikke ville kunne betale sig inden for fem år. Dette er en fuldstændig fiasko i forhold til modellens livscyklus.
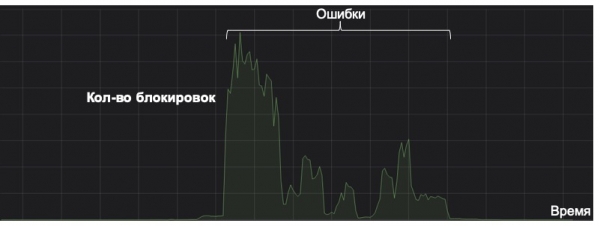
Derfor kan så en simpel ting som overvågning blive afgørende i modellens liv. Udover standard- og åbenlyse målinger vurderer vi fordelingen af modellens svar og scores samt fordelingen af værdierne for de nøglefunktioner. Ved hjælp af KL-divergens kan vi sammenligne den nuværende fordeling med den historiske eller værdierne fra A/B-testen med den øvrige strøm, hvilket gør os i stand til at opdage anomalier i modellen og hurtigt rulle ændringer tilbage.
I de fleste tilfælde starter vi vores første versioner af systemerne ved hjælp af enkle heuristikker eller modeller, som vi senere bruger til overvågning. For eksempel overvåger vi NER-modellen i forhold til regulære udtryk for specifikke onlinebutikker, og hvis dækningen af klassifikatoren falder i forhold til dem, undersøger vi årsagerne. Endnu en nyttig anvendelse af heuristikker!
Resumé
Lad os gennemgå nøglepunkterne i artiklen igen.
- Fibdæk. Vi tænker altid på brugeren: hvordan vil de leve med vores fejl, og hvordan kan de rapportere dem. Vi glemmer ikke, at brugerne ikke er en kilde til rent feedback til modeltræning, og det er nødvendigt at rense det ved hjælp af supplerende ML-systemer. Hvis det ikke er muligt at indsamle signaler fra brugeren, søger vi alternative kilder til feedback, såsom relaterede systemer.
- Finjustering. Her er det vigtigste kontinuitet, så vi bygger videre på den nuværende produktionsmodel. Vi træner nye modeller, så de ikke adskiller sig væsentligt fra den foregående ved hjælp af harmonisk regularisering og lignende tricks.
- Deploy. Autodeploy baseret på metrikker forkorter betydeligt tiden til implementering af modeller. Overvågning af statistikker og beslutningstagningens fordeling, samt antallet af falske svar fra brugerne, er obligatorisk for din sindsro og produktive weekender.
Jeg håber, at det læste hjælper dig med hurtigere at forbedre dine ML-systemer, accelerere deres lancering og gøre dem mere pålidelige, hvilket reducerer stresset ved arbejdet.
Kilde: habr.com
