

Inspiration from the chat discussion
Recently, there have been real battles over defining the concepts of DevOps and SRE.
Although discussions on this topic have become quite repetitive, including for me, I decided to present my perspective to the Habr community. Those who are interested, welcome under the cut. Let it all begin anew!
Background
So, in ancient times, there lived a separate team of software developers and server administrators. The former happily wrote code, while the latter, using various warm and affectionate words towards the former, configured servers, occasionally visiting the developers and receiving the all-encompassing response of "it works on my machine." The business awaited software, everything was idle, occasionally breaking down, and everyone was on edge. Especially the one who was paying for all this mess. A glorious, nostalgic era. But you're already aware of where DevOps originated.
The Birth of DevOps Practices
Then came serious gentlemen who declared — this is not an industry, this way of working is unacceptable. They brought in life cycle models. For example, the V-model.
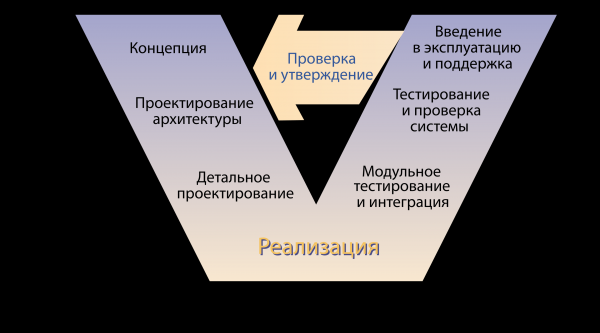
So, what do we see? The business comes with a concept, architects design solutions, developers write code, then — failure. Someone tests the product in some way, someone delivers it to the end user, and somewhere at the end of this miracle model sits a solitary business client waiting for promised results. It was concluded that methods were needed to streamline this process. They decided to create practices that would implement them.
A Lyric Digression on What Practice Is
By practice, I mean a combination of technology and discipline. An example — the practice of describing infrastructure as code using Terraform. Discipline refers to how to describe infrastructure as code, which is in the developer's mind, while the technology itself is Terraform.
Og de besluttede at kalde dem DevOps-praksisser - jeg tror, de mente fra Development til Operations. De opfandt forskellige komplicerede ting - CI/CD-praksisser, praksisser baseret på IaC-princippet, tusinder af dem. Og så gik det, udviklere skriver kode, DevOps-ingeniører transformerer systembeskrivelsen i form af kode til fungerende systemer (ja, kode er desværre kun en beskrivelse, men ikke selve systemet), leveringen kører, og så videre. Tidligere administratorer, der har mestret de nye praksisser, har stolt omdøbt sig til DevOps-ingeniører, og så gik det hele i gang. Og der blev aften, og der blev morgen... undskyld, ikke derfra.
Det hele er igen ikke til at tro.
Bare når alt faldt på plads, begyndte forskellige snedige "metodologer" at skrive tykke bøger om DevOps-praksisser, der stille og roligt opstod debatter om, hvem den berygtede DevOps-ingeniør egentlig er, og hvad DevOps er - en produktionskultur, igen voksede utilfredsheden. Det viste sig pludselig, at levering af software er en absolut ikke-triviel opgave. Hver udviklingsinfrastruktur har sin egen stak, et sted skal det opsamles, et andet sted skal miljøet implementeres, her er tomcat nødvendigt, hér er der behov for en endnu mere kompliceret måde at starte - generelt er det komplekst. Og så var problemet, underligt nok, især i organiseringen af processerne - denne leveringsfunktion blev som en flaskehals hindret processerne. Desuden blev driften (Operations) ikke annulleret. Den er ikke synlig i V-modellen, og der er stadig hele livscyklussen til højre. I sidste ende skal infrastrukturen også vedligeholdes, der skal kigges på overvågningen, og hændelser skal håndteres, og så skal der også tages sig af leveringen. Det vil sige, at man skal stå med det ene ben i udviklingen og det andet i driften - og pludselig blev det til sådan en Development & Operations. Og så kom der også et vildt hype om mikroservices. Og med dem begyndte udviklingen fra lokale maskiner at flytte til skyen - prøv at fejlfinde lokalt, hvis der er titusinder og hundredtusinder af mikroservices, så bliver kontinuerlig levering et middel til overlevelse. For en "lille beskeden virksomhed" kan det være fint, men alligevel? Hvad med Google?
SRE fra Google
Google kom, spiste de største kaktuser, og besluttede, at vi ikke har brug for det, vi har brug for pålidelighed. Og pålidelighed skal styres. Så han sagde, at vi har brug for specialister, der kan styre pålideligheden. Han kaldte dem SR-ingeniører og sagde: 'Her er alt, gør det som sædvanligt, godt. Her er SLI, her er SLO, her er monitorering. Og han pegede hen imod driftsafdelingen. Og han kaldte sin 'pålidelige DevOps' SRE. Det ser rigtigt ud, men der er en beskidt hack, som Google kunne tillade sig — at ansætte folk til SR-ingeniørstillinger, som havde kvalifikationer som udviklere og som også havde lidt erfaring med at forstå fungererende systemer. Problemet er, at Google selv har udfordringer med at ansætte sådanne mennesker — hovedsageligt fordi han konkurrerer med sig selv — man skal jo beskrive forretningslogikken et eller andet sted. Leveringen blev overladt til release-ingeniører, SR-ingeniører styrer pålideligheden (naturligvis ikke direkte, men ved at påvirke infrastrukturen, ændre arkitekturen, overvåge ændringer og indikatorer, håndtere hændelser). Smukt sagt, kan man . Hvad skal man gøre, hvis man ikke er Google, men pålidelighed stadig bekymrer en?
Udvikling af DevOps idéer
Her kom Docker, som voksede ud af lxc, og derefter forskellige orkestreringssystemer som Docker Swarm og Kubernetes, hvor DevOps ingeniører kunne ånde lettet op — en enhed af praksis har forenklet levering. Den forenklede det så meget, at det blev muligt endda at overgive levering til udviklerne — hvad er der i deployment.yaml. Containerisering løser problemet. Og modenheden af CI/CD systemer er allerede på niveauet, hvor man skriver én fil, og så kører det — udviklerne klarer det selv. Og her begynder vi at tale om, hvordan vi laver vores SRE, med ... ja, hvem som helst.
SRE ikke hos Google
Nå ja, vi har givet levering videre, og det ser ud til, at vi kan ånde lettet op og vende tilbage til de gamle gode tider, hvor administratorer overvågede CPU-belastningen, fintune systemerne og stille og roligt nød noget ukendt fra krus i stilhed og ro... Stop. Vi gjorde ikke alt dette for det (hvilket er en skam!). Det viser sig pludselig, at i Googles tilgang kan vi sagtens tage nogle gode praksisser — det er ikke CPU-belastningen, der er vigtig, og ikke hvor ofte vi skifter diske, eller hvordan vi optimerer omkostninger i skyen, men forretningsmetrikker — de samme velkendte SLx. Og ingen har fjernet ansvar for infrastrukturforvaltning, vi skal håndtere hændelser, holde vagt i ny og næ, og vi skal generelt være opdateret på forretningsprocesser. Og drenge, begyd at programmere på et ordentligt niveau, Google har allerede ventet på jer.
For at opsummere. Pludselig er du allerede træt af at læse, og du kan ikke vente med at klage til forfatteren i kommentarfeltet. DevOps som praksis for levering har været, er stadig og vil altid være der. Og det forsvinder ikke nogen steder. SRE som et sæt driftpraksisser gør denne levering succesfuld.
Kilde: habr.com
