

Uanset hvor meget teknologien udvikler sig, vil der altid være en række forældede tilgange, der følger med. Dette kan skyldes en gradvis overgang, menneskelige faktorer, teknologiske nødvendigheder eller noget helt andet. Inden for databehandling er datakilderne et af de mest illustrative eksempler på dette. Uanset hvor meget vi ønsker at slippe for det, sendes en del af dataene fortsat via messengers og e-mails, for ikke at nævne de mere forældede formater. Jeg inviterer til at tage et kig på et eksempel for Apache Airflow, der illustrerer, hvordan man kan trække data fra e-mails.
Background
Mange data overføres stadig via e-mail, fra interpersonelle kommunikationer til standarder for interaktion mellem virksomheder. Det er godt, hvis man kan skrive et interface for at modtage data eller have folk ansat på kontoret, der indtaster denne information i mere bekvemme kilder, men ofte er der simpelthen ikke den mulighed. Den specifikke opgave, som jeg står over for, er at forbinde det velkendte CRM-system til datalageret og derefter til OLAP-systemet. Historisk set har det været praktisk for vores virksomhed at bruge dette system i et specifikt forretningsområde. Derfor ønskede alle, at det skulle være muligt at operere med data også fra dette tredje systems perspektiv. Først og fremmest blev muligheden for at hente data fra den offentlige API undersøgt. Desværre dækkede API'en ikke alle nødvendige data, og for at sige det klart, var det meget utilfredsstillende, og teknisk support kunne ikke eller ville ikke imødekomme os med et mere omfattende funktionalitet. Til gengæld tilbød systemet muligheden for periodisk at modtage de manglende data via e-mail som et link til at downloade arkivet.
Det skal bemærkes, at dette ikke var det eneste tilfælde, hvor virksomheden ønskede at samle data fra e-mails eller messengers. Men i dette tilfælde kunne vi ikke påvirke det tredje firma, der kun leverede en del af dataene på denne måde.
Apache Airflow
For building ETL processes, we most often use Apache Airflow. To help readers unfamiliar with this technology understand how it works in context and overall, I will describe a couple of introductions.
Apache Airflow is an open-source platform used for building, executing, and monitoring ETL (Extract-Transform-Loading) processes in Python. The main concept in Airflow is a directed acyclic graph, where the nodes of the graph represent specific processes, and the edges of the graph represent the flow of control or information. A process can simply call any Python function or have more complex logic involving the sequential calling of several functions within a class context. For the most frequent operations, there are already many ready-made solutions that can be used as processes. Such solutions include:
- operators — for transferring data from one place to another, for example, from a database table to a data warehouse;
- sensors — for waiting for a specific event to occur and directing the flow of control to subsequent nodes of the graph;
- hooks — for lower-level operations, for example, for retrieving data from a database table (used in operators);
- osv.
Describing Apache Airflow in detail in this article would be impractical. You can check out brief introductions eller .
Hook for retrieving data
First of all, to solve the task, we need to write a hook that would allow us to:
- connect to the email;
- find the necessary email;
- retrieve data from the email.
from airflow.hooks.base_hook import BaseHook
import imaplib
import logging

class IMAPHook(BaseHook):
    def __init__(self, imap_conn_id):
        """
           IMAP hook til at hente data fra e-mails

           :param imap_conn_id:       ID for e-mailforbindelsen
           :type imap_conn_id:        string
        """
        self.connection = self.get_connection(imap_conn_id)
        self.mail = None

    def authenticate(self):
        """
            Forbinder til e-mailen
        """
        mail = imaplib.IMAP4_SSL(self.connection.host)
        response, detail = mail.login(user=self.connection.login, password=self.connection.password)
        if response != "OK":
            raise AirflowException("Login fejlede")
        else:
            self.mail = mail

    def get_last_mail(self, check_seen=True, box="INBOX", condition="(UNSEEN)"):
        """
            Metode til at få ID'et af den nyeste e-mail,
            der opfylder søgekriterierne

            :param check_seen:      Markere den nyeste e-mail som læst
            :type check_seen:       bool
            :param box:             Navnet på indbakken
            :type box:              string
            :param condition:       Betegnelser for søgekriterier
            :type condition:        string
        """
        self.authenticate()
        self.mail.select(mailbox=box)
        response, data = self.mail.search(None, condition)
        mail_ids = data[0].split()
        logging.info("Følgende e-mails er fundet i indbakken: " + str(mail_ids))

        if not mail_ids:
            logging.info("Ingen nye e-mails fundet")
            return None

        mail_id = mail_ids[0]

        # hvis der er flere sådanne e-mails
        if len(mail_ids) > 1:
            # markerer de øvrige som læst
            for id in mail_ids:
                self.mail.store(id, "+FLAGS", "\Seen")

            # returnerer den nyeste
            mail_id = mail_ids[-1]

        # skal den nyeste markeres som læst?
        if not check_seen:
            self.mail.store(mail_id, "-FLAGS", "\Seen")

        return mail_id
Logikken er som følger: vi forbinder, finder den nyeste e-mail, hvis der er andre — ignorerer dem. Denne funktion benyttes specifikt, fordi senere e-mails indeholder alle data fra tidligere. Hvis ikke, kan vi returnere et array med alle e-mails eller behandle den første, og de øvrige — ved næste gennemgang. Generelt afhænger det hele af opgaven.
Vi tilføjer to hjælpefunktioner til hooket: en til at downloade en fil og en til at downloade en fil fra et link i en e-mail. Forresten kan de flettes i en operator, afhængigt af hvor ofte denne funktionalitet bruges. Hvad mere der skal skrives i hooket, afhænger igen af opgaven: hvis e-mailen indeholder filer direkte, kan vi downloade vedhæftede filer, hvis dataene kommer i e-mailen, skal vi parse e-mailen osv. I mit tilfælde kommer e-mailen med et enkelt link til en arkivfil, som jeg skal gemme et bestemt sted og starte den videre behandlingsproces.
    def download_from_url(self, url, path, chunk_size=128):
        """
            Metode til at downloade en fil

            :param url:              Downloadadresse
            :type url:               string
            :param path:             Hvor filen skal gemmes
            :type path:              string
            :param chunk_size:       Hvor mange bytes der skrives
            :type chunk_size:        int
        """
        r = requests.get(url, stream=True)
        with open(path, "wb") as fd:
            for chunk in r.iter_content(chunk_size=chunk_size):
                fd.write(chunk)

    def download_mail_href_attachment(self, mail_id, path):
        """
            Metode til at downloade en fil fra et link i en e-mail

            :param mail_id:         E-mailens identifikator
            :type mail_id:          string
            :param path:            Hvor filen skal gemmes
            :type path:             string
        """
        response, data = self.mail.fetch(mail_id, "(RFC822)")
        raw_email = data[0][1]
        raw_soup = raw_email.decode().replace("r", "").replace("n", "")
        parse_soup = BeautifulSoup(raw_soup, "html.parser")
        link_text = ""

        for a in parse_soup.find_all("a", href=True, text=True):
            link_text = a["href"]

        self.download_from_url(link_text, path)
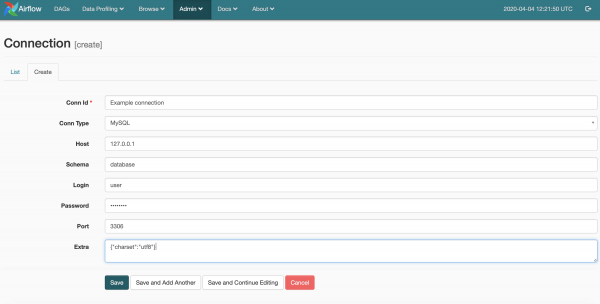
Koden er simpel, så den har sandsynligvis ikke brug for yderligere forklaringer. Jeg vil blot fortælle om den magiske linje imap_conn_id. Apache Airflow opbevarer oplysninger om forbindelser (login, kodeord, adresse og andre parametre), som kan tilgås ved hjælp af en streng-identifikator. Visuelt ser styringen af forbindelser sådan her ud
Sensor til at vente på data
Da vi allerede kan oprette forbindelse og hente data fra mailen, kan vi nu skrive en sensor til at overvåge dem. At skrive en operatør, der straks behandler dataene, når de er tilgængelige, lykkedes ikke i mit tilfælde, da andre processer også arbejder ud fra de modtagne data fra mailen, herunder de, der henter relaterede data fra andre kilder (API, telefoni, web analytics osv.). Et eksempel: En ny bruger er dukket op i CRM-systemet, og vi kender endnu ikke hans UUID. Når vi forsøger at hente data fra SIP-telefoni, får vi opkald knyttet til hans UUID, men vi kan ikke gemme og bruge dem korrekt. I sådanne tilfælde er det vigtigt at tage hensyn til datadependens, især når de kommer fra forskellige kilder. Dette er selvfølgelig ikke tilstrækkelige foranstaltninger for at opretholde dataintegritet, men nødvendige i nogle tilfælde. At bruge ressourcer unødvendigt er heller ikke rationelt.
Således vil vores sensor aktivere de efterfølgende noder i grafen, hvis der er friske oplysninger på mailen, og samtidig markere den tidligere information som irrelevant.
from airflow.sensors.base_sensor_operator import BaseSensorOperator
from airflow.utils.decorators import apply_defaults
from my_plugin.hooks.imap_hook import IMAPHook

class MailSensor(BaseSensorOperator):
    @apply_defaults
    def __init__(self, conn_id, check_seen=True, box="Inbox", condition="(UNSEEN)", *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.conn_id = conn_id
        self.check_seen = check_seen
        self.box = box
        self.condition = condition

    def poke(self, context):
        conn = IMAPHook(self.conn_id)
        mail_id = conn.get_last_mail(check_seen=self.check_seen, box=self.box, condition=self.condition)

        if mail_id is None:
            return False
        else:
            return True
Henter og bruger data
For at hente og behandle data kan man skrive en separat operatør eller bruge en eksisterende. Da logikken indtil videre er trivial — at hente data fra en mail, foreslår jeg at bruge den standard PythonOperator.
fra airflow.models import DAG

fra airflow.operators.python_operator import PythonOperator
fra airflow.sensors.my_plugin import MailSensor
fra my_plugin.hooks.imap_hook import IMAPHook

start_date = datetime(2020, 4, 4)

# Standard konfiguration af grafen
args = {
    "owner": "example",
    "start_date": start_date,
    "email": ["home@home.ru"],
    "email_on_failure": False,
    "email_on_retry": False,
    "retry_delay": timedelta(minutes=15),
    "provide_context": False,
}

dag = DAG(
    dag_id="test_etl",
    default_args=args,
    schedule_interval="@hourly",
)

# Definerer sensoren
mail_check_sensor = MailSensor(
    task_id="check_new_emails",
    poke_interval=10,
    conn_id="mail_conn_id",
    timeout=10,
    soft_fail=True,
    box="my_box",
    dag=dag,
    mode="poke",
)

# Funktion til at hente data fra mailen
def prepare_mail():
    imap_hook = IMAPHook("mail_conn_id")
    mail_id = imap_hook.get_last_mail(check_seen=True, box="my_box")
    if mail_id is None:
        raise AirflowException("Tom indbakke")

    conn.download_mail_href_attachment(mail_id, "./path.zip")

prepare_mail_data = PythonOperator(task_id="prepare_mail_data", default_args=args, dag=dag, python_callable=prepare_mail)

# Beskrivelse af de øvrige knuder i grafen
...

# Definerer forbindelsen i grafen
mail_check_sensor >> prepare_mail_data
prepare_data >> ...
# Beskrivelse af de øvrige kontrolstrømme
Forresten, hvis din virksomhedsmail også er på mail.ru, så vil du ikke have mulighed for at søge efter e-mails efter emne, afsender osv. De lovede at implementere det tilbage i 2016, men ser ud til, at de har ændret mening. Jeg løste dette problem ved at oprette en separat mappe til de relevante e-mails og indstille et filter i webgrænsefladen til mailen for de nødvendige e-mails. På den måde ender kun relevante e-mails i denne mappe, og betingelserne for søgning i mit tilfælde er ganske enkle (UNSEEN).
Sammenfattende har vi følgende rækkefølge: vi kontrollerer, om der er nye e-mails, der opfylder betingelserne; hvis der er, downloader vi et arkiv via linket fra den seneste e-mail.
Under de sidste ellipser er det antydet, at dette arkiv vil blive udpakket, data fra arkivet vil blive renset og behandlet, og det hele vil blive sendt videre til ETL-processens pipeline, men det ligger uden for artiklens emne. Hvis det var interessant og nyttigt, vil jeg gladeligt fortsætte med at beskrive ETL-løsninger og deres dele for Apache Airflow.
Kilde: habr.com
