

Jeg inviterer dig til at se fortolkningen af Román Khavronenkos "ExtendedPromQL"-foredrag
Kort om mig. Mit navn er Román. Jeg arbejder hos CloudFlare, bor i London. Men jeg er også vedligeholder af VictoriaMetrics.
Og jeg er forfatter for Grafana og – det er en lille proxy for ClickHouse.
Vi begynder med den første del, som hedder «Oversættelsesudfordringer», hvor jeg vil fortælle om, at ethvert sprog eller endda blot en kommunikationsform er meget vigtigt. For det er måden, hvorpå du overfører dine tanker til en anden person eller system, hvordan du formulerer din forespørgsel. Folk på internettet diskuterer, hvilket sprog der er bedst – Java eller et andet. For mig har jeg besluttet, at man skal vælge ud fra opgaven, fordi alt dette er specifikt.
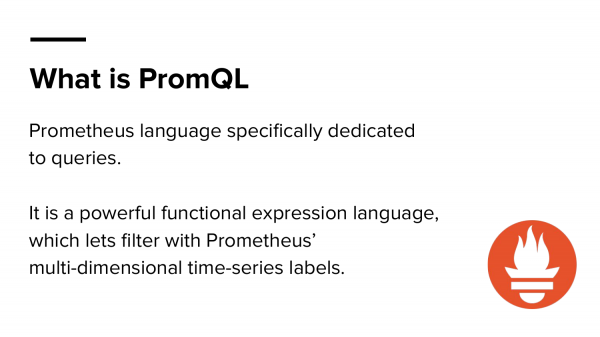
Lad os starte fra begyndelsen. Hvad er PromQL? PromQL er Prometheus Query Language. Det er, hvordan vi danner forespørgsler i Prometheus for at få tidsserie data, tidsrækker.
Hvad er tidsserie data? Bogstaveligt talt er det tre parametre.
Det er:
- Hvad vi ser på.
- Hvornår vi ser på det.
- Og hvilken værdi det viser.
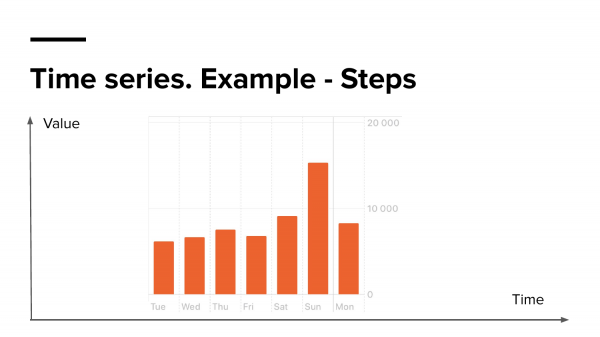
Hvis vi ser på denne graf (denne graf er fra min telefon, som viser statistikken for mine skridt), kan vi hurtigt besvare disse spørgsmål.
Vi ser på skridt. Vi ser værdien og vi ser tidspunktet, hvor vi ser på det. Altså, ved at se på denne graf kan man let sige, at jeg gik omkring 15.000 skridt om søndagen. Det er tidsserie data.
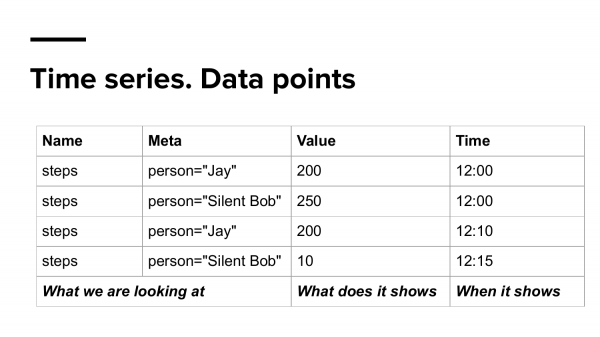
Lad os nu "opdele" (transformere) dem i en anden datamodel i tabelformat. Her har vi også det, vi ser på. Jeg har tilføjet nogle ekstra data, som vi vil kalde metadata, dvs. det var ikke mig, men to personer, lad os sige, Jay og Silent Bob. Dette er det, vi ser på; hvad det viser og hvornår det viser denne værdi.
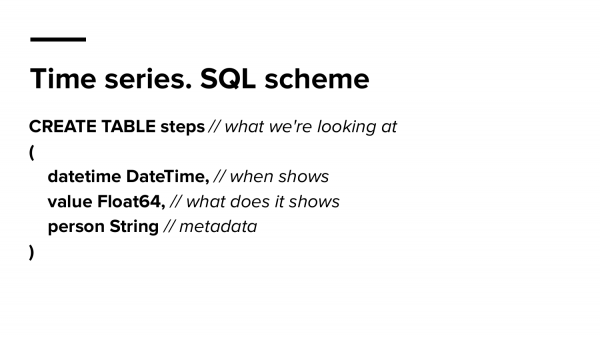
Lad os nu forsøge at gemme alle disse data i en database. For eksemplet har jeg taget ClickHouse-syntax. Og her opretter vi en tabel, der hedder «Steps», dvs. det, vi ser på. Her er tidspunktet, hvor vi ser på det; hvad det viser og nogle metadata, hvor vi opbevarer, hvem det er: Jay og Silent Bob.
Og for at forsøge at visualisere alt dette, vil vi bruge Grafana, fordi det for det første er flot.
Vi vil også bruge denne plugin. Der er to grunde til det. Den første er, at jeg har skrevet den. Og jeg ved præcist, hvor svært det er at trække tidsseriedata ud af ClickHouse for at vise det i Grafana.
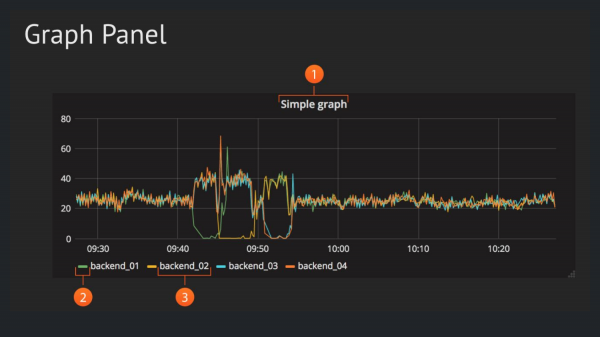
Vi vil vise det i Graph Panel. Det er den mest populære panel i Grafana, der viser afhængigheden af værdien over tid, så vi har kun brug for to parametre.
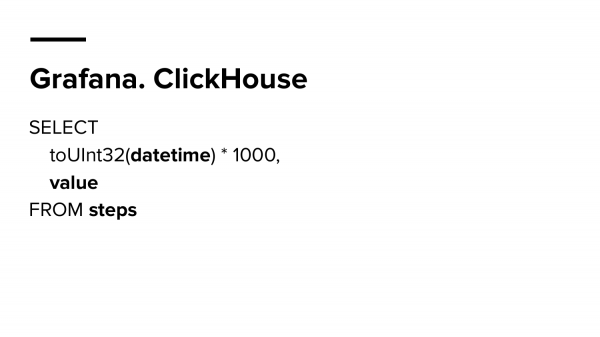
Lad os skrive den enkleste forespørgsel – hvordan man viser skridttælling i Grafana, mens vi gemmer disse data i ClickHouse i den tabel, vi har oprettet. Og vi skriver sådan en simpel forespørgsel. Vi vælger fra skridt. Vi vælger værdien og vælger tidspunktet for disse værdier, dvs. de samme tre parametre, som vi talte om.
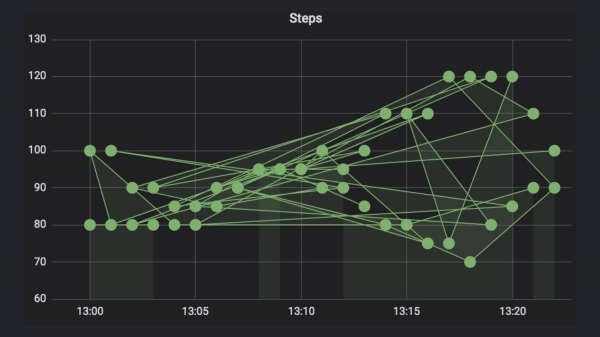
Og resultatet bliver sådan et diagram. Hvem ved, hvorfor det er så mærkeligt?
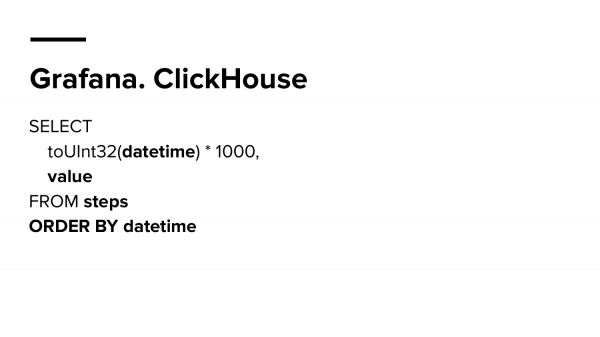
Korrekt, det skal sorteres efter tid.
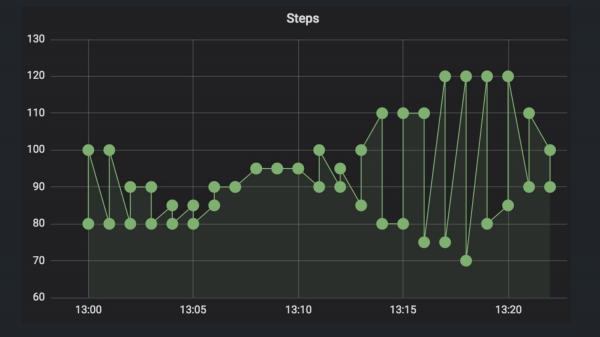
Og i sidste ende får vi et lidt bedre, men stadig mærkeligt diagram. Hvem ved hvorfor? Korrekt, der er to deltagere, og vi i Grafana leverer to tidsserier, for hvis vi ser på datamodellen igen, så er hver tidsserie en unik kombination af navn og alle nøgle-værdier labels.
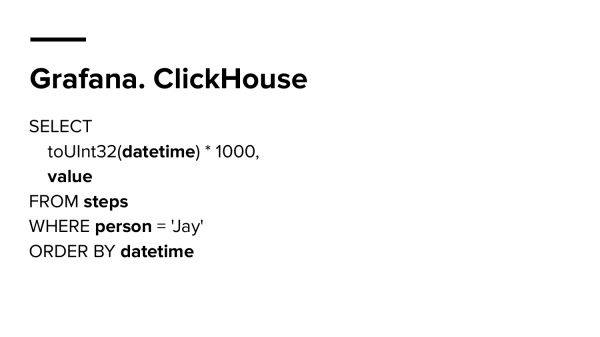
Derfor skal vi vælge en specifik person. Vi vælger Jay.

Og tegner igen. Nu ligner grafen sandheden. Nu er det en normal graf, og alt fungerer godt.
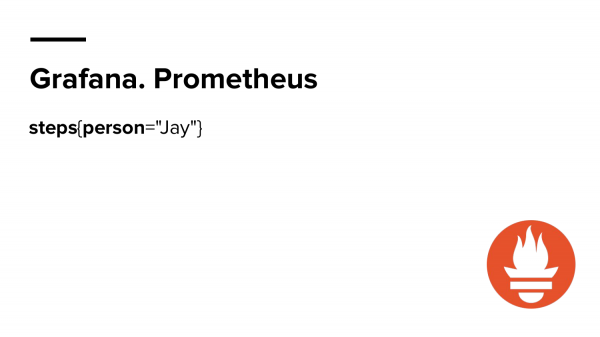
Og måske ved du, hvordan man gør omtrent det samme, men i Prometheus gennem PromQL. Omtrent sådan her. Lidt lettere. Og så vil vi opdele det hele. Vi tog Skridt. Og filtrerer efter Jay. Vi angiver ikke, hvad vi skal have som værdi, og vi vælger ikke tidspunkt.
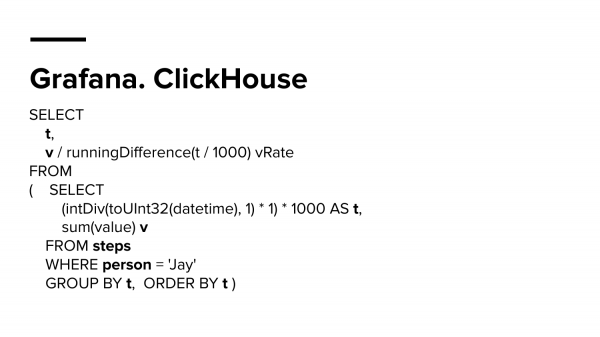
Lad os nu prøve at beregne Jays eller Silent Bobs hastighed. I ClickHouse skal vi lave en runningDifference, dvs. beregne forskellen mellem par af punkter og dele dem med tiden for at få den nøjagtige hastighed. Forespørgslen vil se nogenlunde sådan her ud.
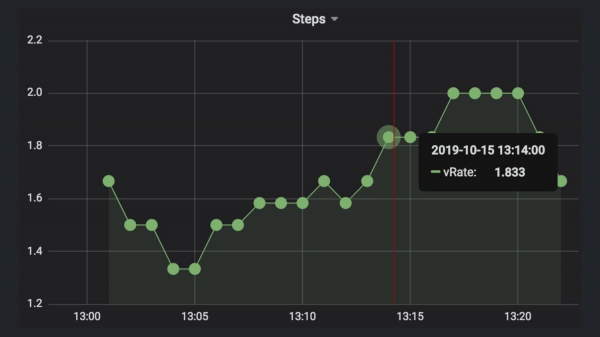
Og den vil vise omtrent sådan nogle værdier, dvs. Silent Bob eller Jay tager cirka 1,8 skridt per sekund.
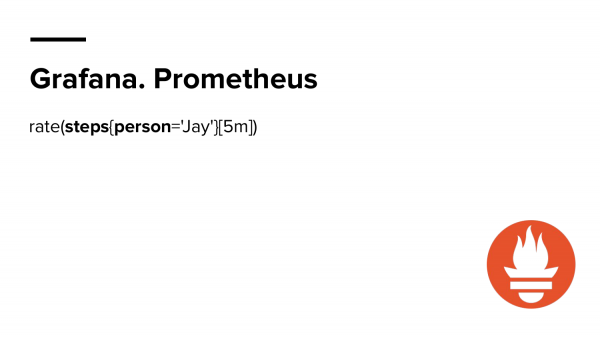
Og i Prometheus ved du også, hvordan man gør det. Meget lettere end før.
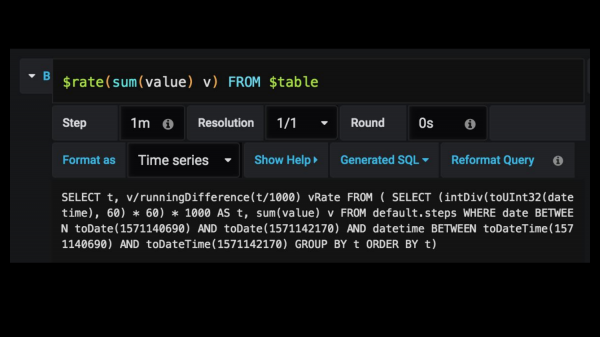 For it to remain just as easy to do in Grafana, I added this wrapper that looks very similar to PromQL. It's called Rate Macros, or however you want to name it. In Grafana, you just write 'rate', but deep down, it's transformed into a large query. You don't even need to look at it; it's there somewhere, saving you a lot of time because writing such huge SQL queries is always costly. You can easily make a mistake and then spend a long time figuring out what's going on.
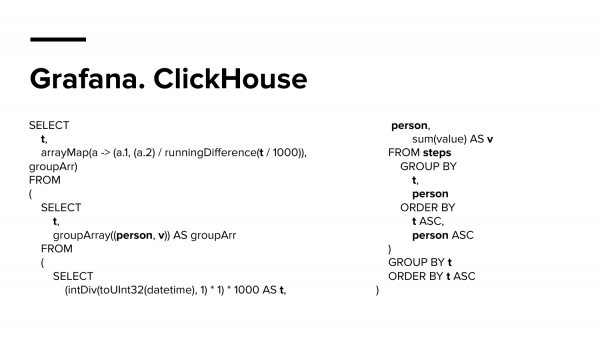
And here is a query that didn't even fit on one slide, so I had to split it into two columns. This is also a ClickHouse query that does the same rate calculation, but for both time series: for Silent Bob and Jay, so we have two time series on the panel. This is already very complex, in my opinion.
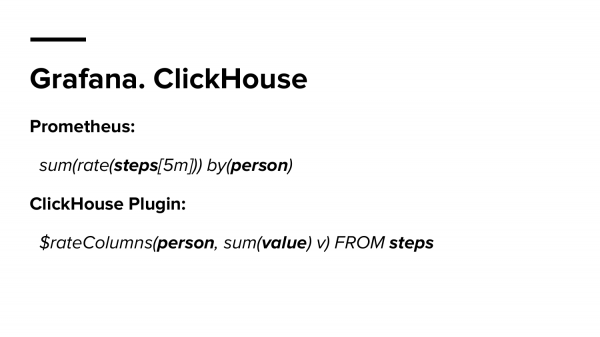
For Prometheus, it will be sum(rate). For ClickHouse, I created a separate macro called RateColumns that looks like a Prometheus query.
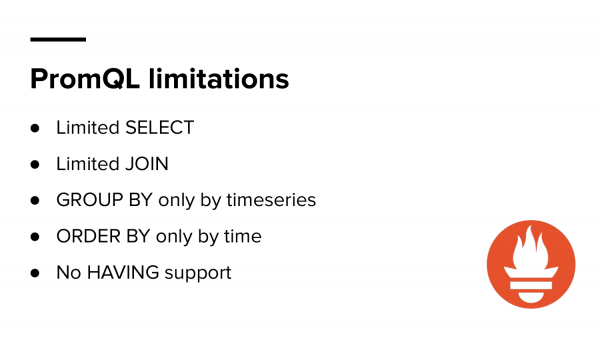
We looked at it and it seems PromQL is really cool, but it does have its limitations.
Det er:
- Limited SELECT.
- Borderline JOIN.
- No support for HAVING.
If you have worked with it for a long time, you know that it can be very challenging to do something in PromQL, whereas in SQL you can do almost anything, because all the options we've just discussed could have been done in SQL. But would it be convenient to use? This makes me think that the most powerful language isn't always the most comfortable one.
So sometimes you need to choose a language suited for the tasks. It's like the battle of Batman versus Superman. Clearly, Superman is stronger, but Batman managed to defeat him because he was more practical and knew exactly what he was doing.
And the next part is Extending PromQL.
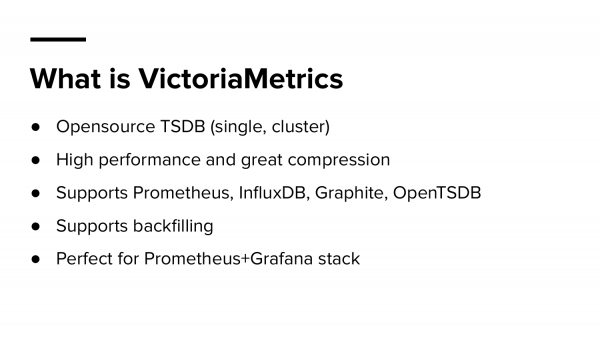
Once again about VictoriaMetrics. What is VictoriaMetrics? It's a time series database, it's open-source, and we distribute both single and cluster versions. According to our benchmarks, it's the fastest currently available on the market, and also comparable in compression, i.e., live users report a compression rate of around 0.4 bytes per point, whereas for Prometheus it's 1.2-1.4.
We not only support Prometheus. We support InfluxDB, Graphite, OpenTSDB.
We can 'write' to it, meaning you can transfer old data.
And we work perfectly with Prometheus and Grafana, meaning we support the PromQL engine. In Grafana, you can simply change the Prometheus endpoint to VictoriaMetrics, and all your dashboards will work as they did.
Men kan dog bruge ekstra funktioner, som VictoriaMetrics tilbyder.
Lad os hurtigt gennemgå de funktioner, vi har tilføjet.
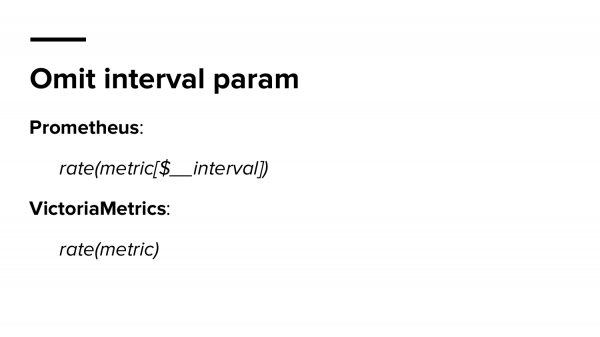
Udelad intervalparameteren – du kan springe intervalparametre over i Grafana. Når du ikke ønsker at få mærkelige grafer ved zoom-in/zoom-out på panelet, anbefales det at bruge variablen {$__interval}. Dette er en intern variabel i Grafana, og den vælger selv dataperioden. VictoriaMetrics kan også selv finde ud af, hvilken periode der skal anvendes, og du behøver ikke at opdatere alle dine forespørgsler. Det bliver meget nemmere.
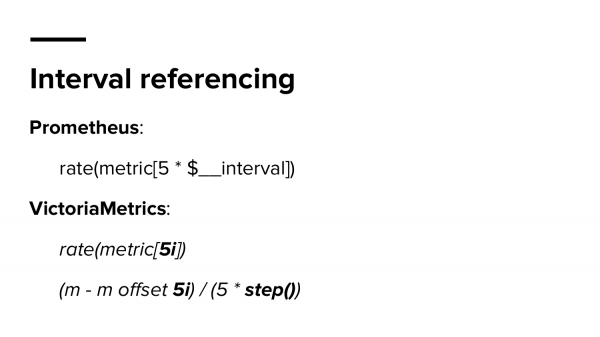
Den anden funktion er intervalreferencen. Du kan bruge dette interval i dine udtryk. Du kan multiplicere, dividere, overføre og referere til det.
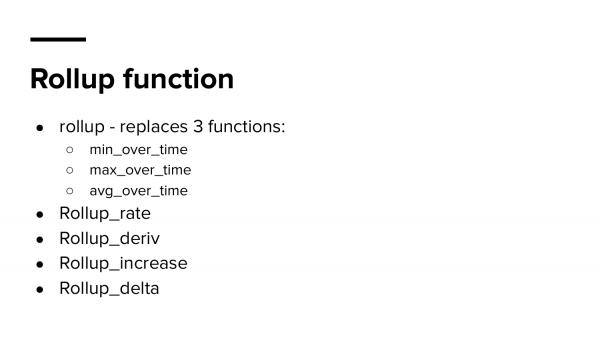
Dernæst er der en familie af rollup-funktioner. Rollup-funktionen transformerer enhver tidsserie til tre separate tidsserier: min, max og avg. Jeg synes, det er meget praktisk, fordi det nogle gange kan vise outliers (afvigelser) og unøjagtigheder.
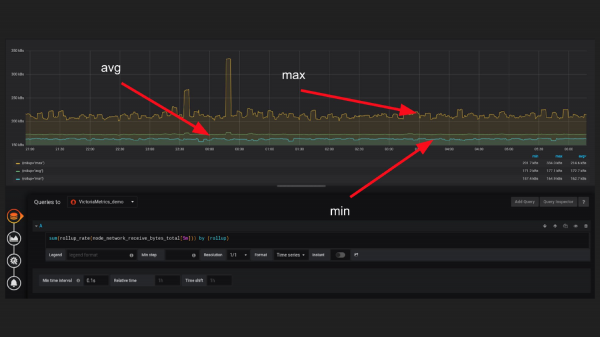
Og hvis du blot laver irate eller rate, kan du sandsynligvis overse nogle tilfælde, hvor tidsserien opfører sig anderledes end forventet. Med denne funktion er det meget nemmere at se, eksempelvis, at max varierer betydeligt fra avg.
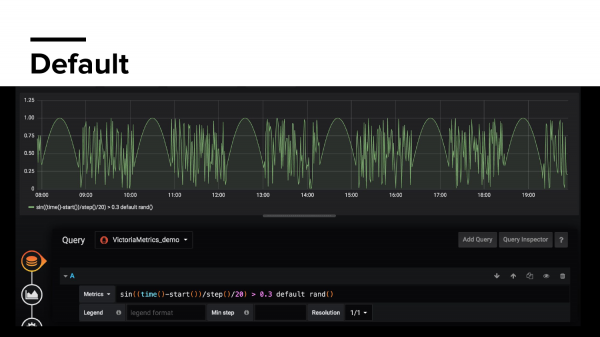
Dernæst er der standardvariablen. Default betyder, hvilket værdi vi skal tegne i Grafana, hvis vi ikke har nogen tidsserier i øjeblikket. Hvornår sker dette? For eksempel, hvis du eksporterer en metrisk data om fejl. Og dit program er så godt, at du under opstart ikke har nogen fejl, og der endda ikke er fejl i de næste tre timer eller endda en dag. Og du har dashboards, der viser forholdet mellem success og error. De vil vise dig ingenting, fordi du ikke har nogen metric for fejl. I default kan du angive hvad som helst.
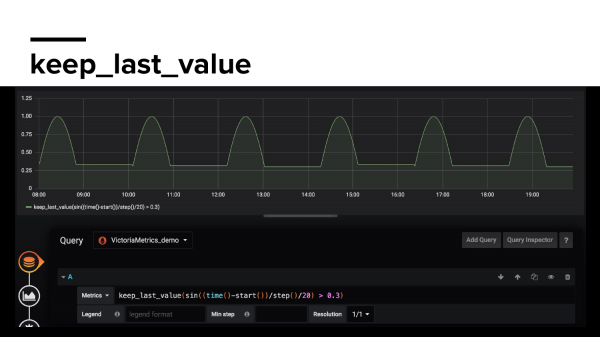
Keep_last_Value – gemmer den sidste værdi af en metrisk data, hvis den forsvinder. Hvis Prometheus ikke finder den efter næste scraping i løbet af 5 minutter, vil vi huske dens sidste værdi, og dine grafer vil ikke bryde.
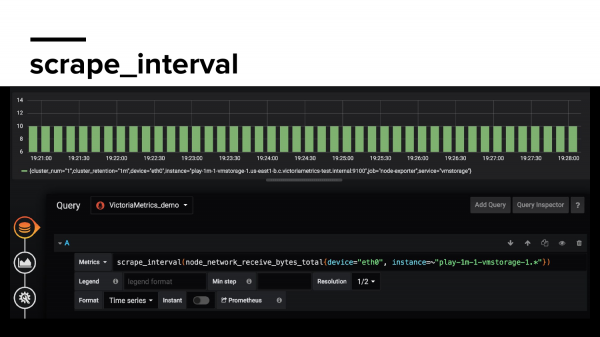
Scrape_interval – viser hvor ofte Prometheus indsamler data om dine metrikker, med hvilken frekvens. Her kan du se, om der er nogen spring.
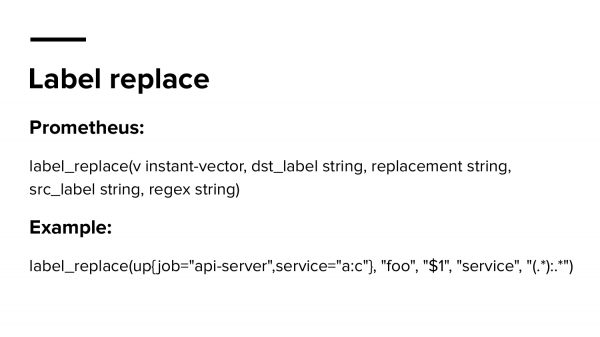
Label replace – en populær funktion. Men vi mener, at den er lidt kompleks, fordi den accepterer hele argumenter. Og du skal ikke kun huske 5 argumenter, men også deres rækkefølge.
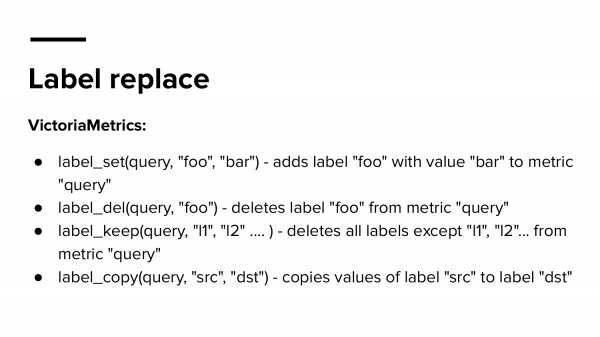
Så hvorfor ikke gøre dem enklere? Dvs. opdele dem i mindre funktioner med en forståelig syntaks.
Og nu det mest interessante. Hvorfor mener vi, at dette er udvidet PromQL? Fordi vi understøtter Common Table Expressions. Du kan scanne QR-koden (), se links med eksempler, samt et playground, hvor du kan udføre forespørgsler direkte i VictoriaMetrics uden installation, blot i browseren.
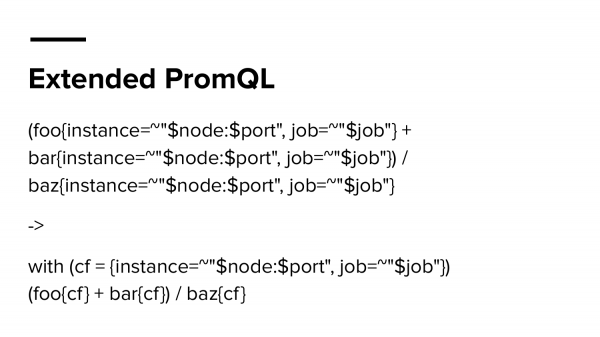
Og hvad er det? Den forespørgsel ovenfor er en ret populær forespørgsel. Jeg tror, at i ethvert dashboard i mange virksomheder bruger du den samme filter for alle. Normalt sådan. Men når du skal tilføje et nyt filter, skal du opdatere hver enkelt panel, eller downloade dashboardet, åbne det i JSON, gøre find og erstat, hvilket også tager tid. Hvorfor ikke gemme denne værdi i en variabel og genbruge den? Det virker, efter min mening, meget lettere og mere forståeligt.
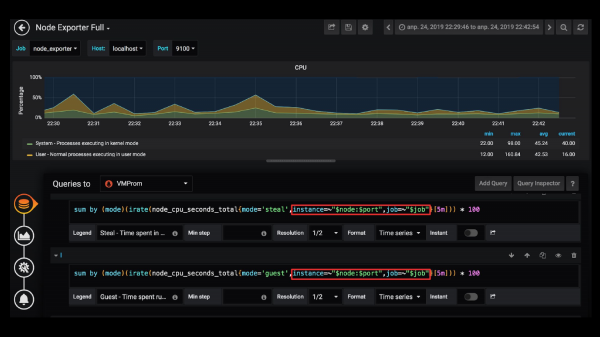
For eksempel, når jeg skal opdatere filtre i Grafana i alle forespørgsler, mens dashboardet kan være kæmpestort, eller der kan være flere. Og hvordan vil jeg gerne løse dette problem i Grafana?
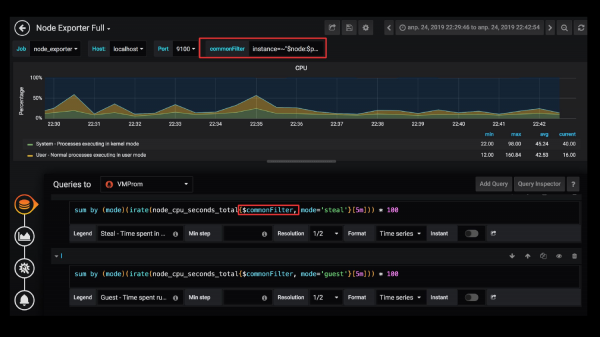
Jeg løser dette problem sådan: jeg laver commonFilter og definerer denne filter der, og så genbruger jeg den i forespørgslerne. Men hvis du gør det på samme måde nu, vil det ikke fungere, fordi Grafana ikke tillader dig at bruge variabler inden for variablerne i forespørgsler. Og det er lidt underligt.
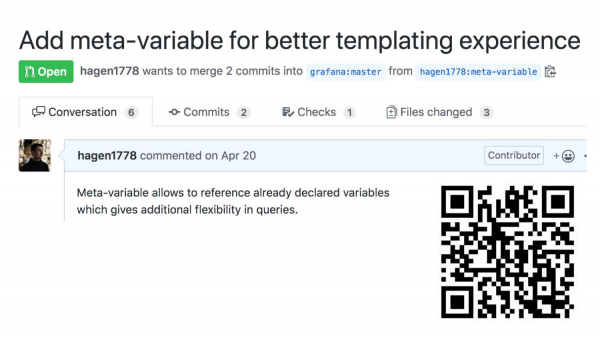
Derfor lavede jeg en mulighed, der tillader det. Og hvis du er interesseret eller ønsker sådan en funktion, så støt eller dislike, hvis du ikke kan lide ideen.
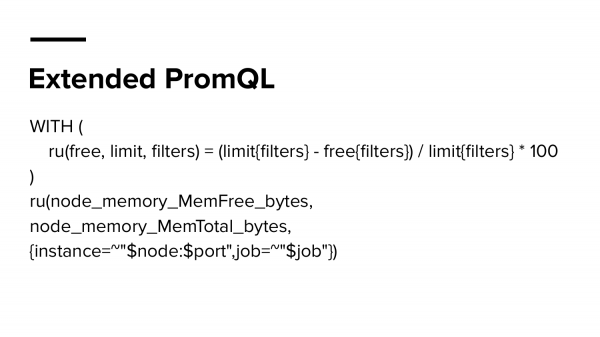
Lad os nu tale om udvidet PromQL. Her definerer vi ikke kun en variabel, men en helt funktion. Og vi kalder den ru (resource usage). Denne funktion tager frie ressourcer, begrænsningen på ressourcen og filteret. Synes syntaksen er ganske simpel. Det er meget nemt at bruge denne funktion og beregne procentdelen af fri hukommelse hos os. Dvs. hvor meget hukommelse vi har, hvilken begrænsning der er, og hvordan vi filtrerer. Det ville være meget mere bekvemt, hvis du skrev alt dette, genbrugte de samme filtre, fordi det ville blive til en stor stor forespørgsel.
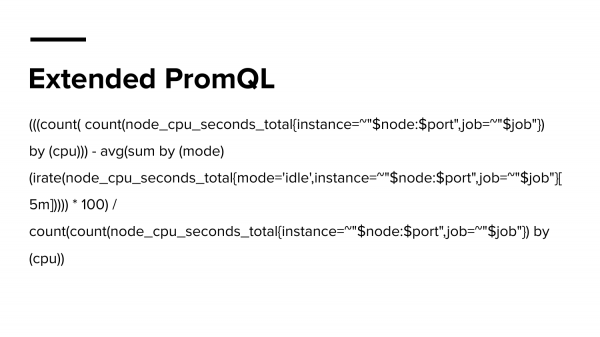
Og her er et eksempel på en meget stor forespørgsel. Den er fra den officielle NodeExporter-dashboard til Grafana. Men jeg forstår kun svagt, hvad der sker her. Jeg mener, selvfølgelig forstår jeg det, hvis man ser nærmere på det, men antallet af parenteser kan straks nedsætte motivationen for at forstå, hvad der sker. Og hvorfor ikke gøre det enklere og mere forståeligt?
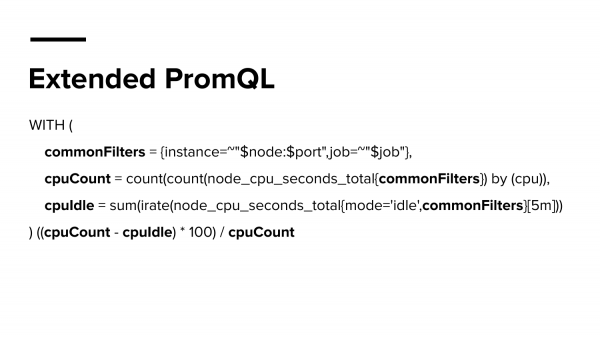
For eksempel på denne måde, ved at fremhæve væsentlige ting eller dele i variabler. Og så udføre sin grundlæggende matematik. Det ligner allerede mere programmering, det er det, jeg gerne vil se i fremtiden i Grafana.
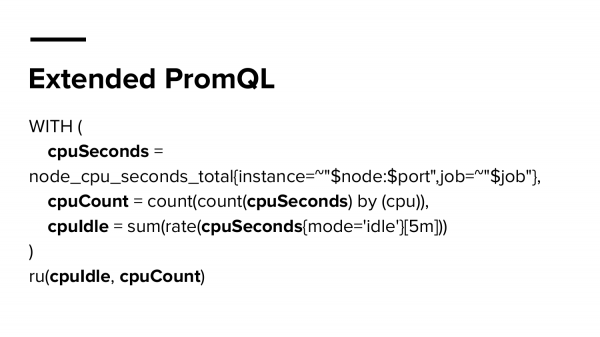
Her er et andet eksempel på, hvordan vi kan gøre det endnu enklere, hvis vi allerede havde denne funktion ru, og den findes allerede i VictoriaMetrics. Og så kan du bare give det cachede værdi, som du har erklæret i CTE.
Jeg har allerede talt om, hvor vigtigt det er at bruge det rigtige programmeringssprog. Og nok sker der nok noget unikt i hver virksomhed i Grafana. Og måske giver du også dine udviklere adgang til Grafana, og udviklerne laver noget unikt. Og de gør det alle på forskellig vis. Jeg ville ønske, at de kunne gøre det mere ensartet og samlet i en fælles standard.
Lad os sige, at du ikke bare har systemingeniører, måske har du også eksperter, devops eller SRE. Måske har du eksperter, der ved, hvad overvågning er, ved hvad Grafana er, det vil sige, at de har arbejdet med det i årevis, og de ved præcis, hvordan man gør det rigtigt. Og de har allerede skrevet det 100 gange og forklaret det til alle, men af en eller anden grund lytter ingen.
Hvad nu hvis de kunne integrere disse viden direkte i Grafana, så andre brugere kunne genbruge funktionerne? Og hvis de skulle beregne procentdelen af ledig hukommelse, så ville de bare anvende funktionen. Hvad hvis skaberne af eksportører, sammen med deres produkt, også tilbød et sæt funktioner til at arbejde med deres metrikker, fordi de ved præcis, hvad det er for metrikker, og hvordan man beregner dem korrekt?
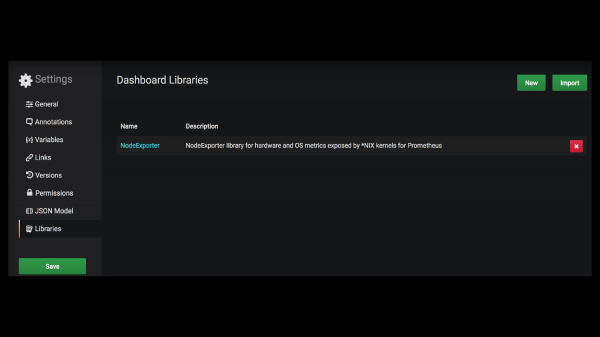
Dette eksisterer faktisk ikke. Dette har jeg gjort selv. Det er understøttelse af biblioteker i Grafana. Lad os sige, at drengene, der lavede NodeExporter, gjorde det, jeg talte om. Og de tilbød også et sæt funktioner.
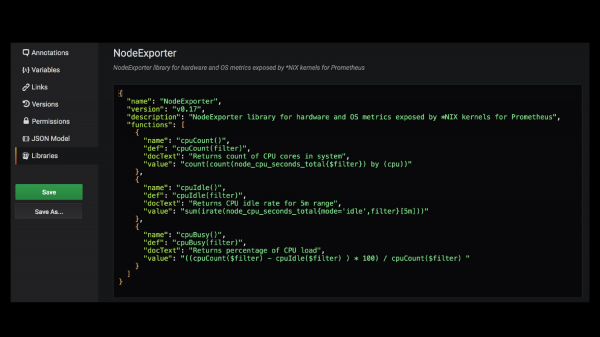
Det vil sige, det ser cirka sådan ud. Du tilslutter dette bibliotek i Grafana, går ind i redigering, og her er det meget enkelt, hvordan man arbejder med denne metrik skrevet i JSON. Det er et sæt funktioner, deres beskrivelser og hvordan de præsenteres.
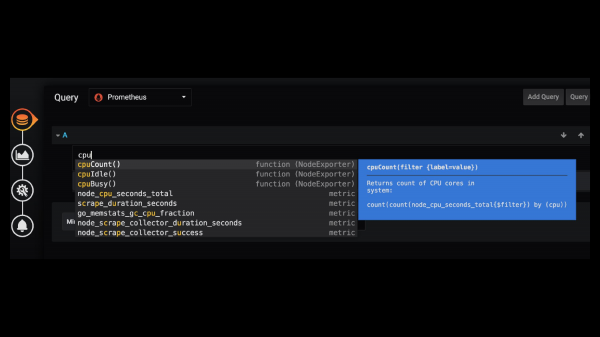
Efter min mening kunne dette være nyttigt, fordi du så ville skrive på denne måde i Grafana. Og Grafana "siger" til dig, at der er en bestemt funktion fra et sådant bibliotek – lad os bruge den. Jeg synes, det ville være fantastisk.
Lidt om VictoriaMetrics. Vi laver mange interessante ting. Læs vores artikler om kompression, om vores konkurrencer med andre tidsserie-datakapplikationer, vores forklaring på, hvordan man arbejder med PromQL, fordi der stadig er mange nybegyndere i dette, samt om vertikal skalerbarhed og vores modstand mod Thanos.
Spørgsmål:
Jeg vil starte mit spørgsmål med en simpel livshistorie. Da jeg først begyndte at bruge Grafana, skrev jeg en meget overbevisende forespørgsel på fem linjer. Der kom en meget overbevisende graf ud af det. Denne graf var næsten klar til produktion. Men ved nærmere eftersyn viste det sig, at grafen viste absolut nonsens, som ikke havde noget forhold til virkeligheden, selvom tallene var inden for det område, vi forventede at se. Mit spørgsmål er: Vi har biblioteker, vi har funktioner, men hvordan skriver vi tests for Grafana? Du har skrevet en kompleks forespørgsel, som forretningsbeslutningen – at bestille en ægte servercontainer eller ikke gøre det – afhænger af. Og hvordan ved vi, at funktionen, der tegner grafen, ligner sandheden? Tak.
Tak for spørgsmålet. Der er to dele. For det første har jeg indtryk, baseret på min erfaring, at de fleste brugere, når de ser på deres grafer, ikke forstår, hvad de viser. Af en eller anden grund er folk meget gode til at finde undskyldninger for enhver anomali, der opstår på graferne, selvom det er en fejl i funktionen. Og den anden del – jeg mener, at brugen af sådanne funktioner ville passe meget bedre til at løse dit problem, fremfor at hver af dine udviklere laver deres egen kapacitetsplanlægning og er forkerte med en vis sandsynlighed.
Hvordan kan man teste?
Hvordan kan man teste? Måske ikke muligt.
I form af en test i Grafana.
Hvad har Grafana med det at gøre? Grafana transmitterer denne forespørgsel direkte til datakilden.
Ved at tilføje lidt i parametrene.
Nej, de tilføjer ikke noget i Grafana. Der kan være GET-parametre, som f.eks. step. Det er ikke tydeligt angivet, men du kan overskrive det, du kan vælge ikke at overskrive det, men det tilføjes automatisk. Du skriver ikke tests her. Jeg mener, at man ikke bør stole på Grafana som en sandhedskilde.
Tak for præsentationen! Tak for kompressionen! Du nævnte mapping af variablen i grafen, at man ikke kan bruge en variabel i en variabel i Grafana. Forstår du, hvad jeg mener?
Ja.
Det var oprindeligt et hovedbrud, da jeg ville lave en alert i Grafana. Og man skal lave en alert for hver enkelt vært. Den ting, du lavede, fungerer den til alerts i Grafana?
Hvis Grafana ikke henter variabler på en anden måde, så ja, det vil fungere. Men mit råd er at undgå at bruge alerting i Grafana overhovedet, det er bedre at bruge alertmanager.
Ja, jeg bruger det, men det virkede bare lettere at konfigurere i Grafana, men tak for rådet!
Kilde: habr.com
