

RAID-algoritmerne blev præsenteret for offentligheden tilbage i 1987. Den dag i dag forbliver de den mest eftertragtede teknologi til beskyttelse og acceleration af adgang til data i informationslagring. Men alderen på IT-teknologien, der har passeret 30-års grænsen, er snarere et tegn på forældelse end modenhed. Årsagen er fremskridt, der uundgåeligt bringer nye muligheder. I en tid, hvor der i praksis ikke fandtes andre lagringsmedier end HDD, gjorde RAID-algoritmer det muligt at udnytte de tilgængelige lagerressourcer mest effektivt. Men med fremkomsten af SSD er situationen ændret fundamentalt. I dag er RAID, når det arbejdes med SSD'er, snarere en 'snare' for deres ydeevne. Derfor er det nødvendigt at have en helt anden tilgang til at arbejde med dem for at frigøre det fulde potentiale af SSD'ernes hastighedsegenskaber.
Ud over de åbenbare forskelle mellem HDD og SSD i drift, har disse typer lagermedier også en anden vigtig egenskab: enhver hårddisk kan overskrive hvilke som helst data med en granularitet på én blok (som oftest 4KB i dag). For SSD'er derimod er overskrivningsprocessen en langt mere kompleks procedure:
- Ændrede data kopieres til et nyt sted. Granulariteten er den samme blok, men bestående af flere sider og med en størrelse på 256KB – 4MB. Dvs. ved ændring af de samme 4KB skal alle nabosider, som danner en samlet blok, også kopieres.
- «Gamle» blokke markeres som ikke anvendte, så de senere kan overskrives af en 'Garbage Collector'.
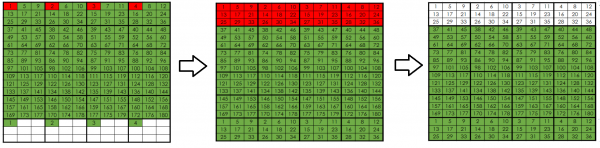
Sekventiel skrivning/overskrivning på SSD
I tilfælde af sekventiel skrivning/overskrivning spiller denne funktionelle egenskab ved SSD ikke en stor rolle med hensyn til ydeevnen, da blokkene er placeret tæt på hinanden, og 'Garbage Collector' klarer sit arbejde i baggrunden. Men i det virkelige liv, især i Enterprise-segmentet, bruges der oftest tilfældig adgang til data på SSD'er. Og disse data skrives til vilkårlige steder på lagringsmedierne.
Jo mere data der skrives til SSD'en, jo sværere bliver det for garbage collector at arbejde, da fragmenteringen stiger kraftigt. På et tidspunkt opstår der en situation, hvor renseprocessen ikke længere er 'baggrundsaktiviteter': SSD'ens ydeevne falder betydeligt, da en mærkbar del af den bliver taget af Garbage Collector.
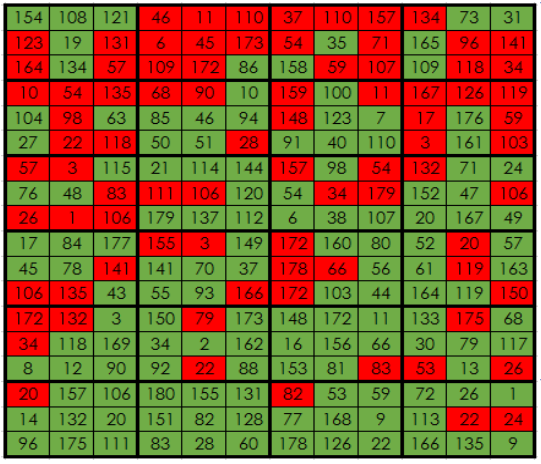
Den reelle placering af data på SSD'en under daglig brug
For at illustrere effekten af garbage collectorens arbejde afhængig af skriveindstillingen på drevet, kan man udføre enkle tests: sekventiel og tilfældig skrivning i blokke af 4KB på et 100GB drev. (Kilde – virksomhed )
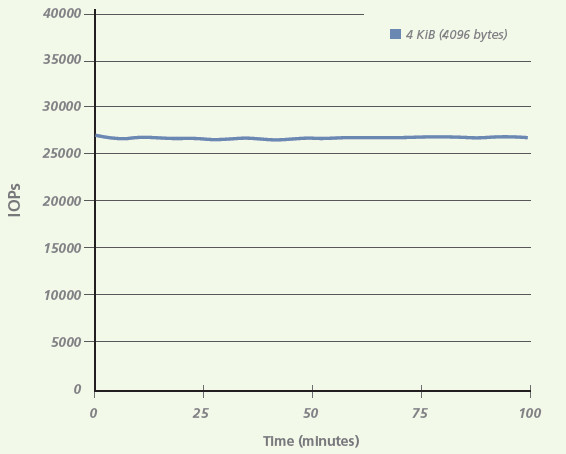
Ydeevne ved sekventiel skrivning
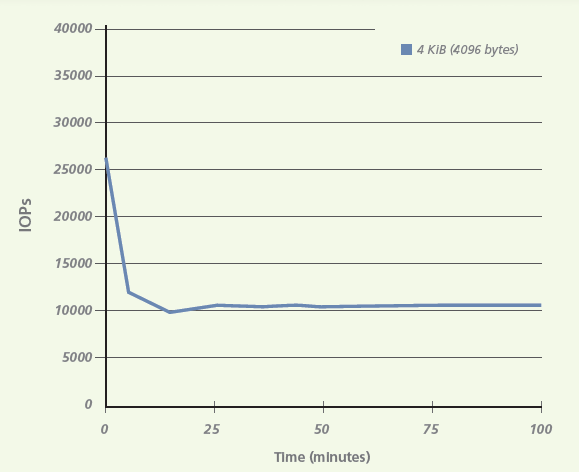
Ydeevne ved tilfældig skrivning
Som det ses i testene, kan faldet i ydeevne nå over det dobbelte. Og dette er kun et enkelt drev. I tilfælde af brug af SSD i et RAID-gruppe stiger antallet af omskrivningsoperationer betydeligt på grund af arbejdet med parity.
Generelt, på grund af disse SSD-arbejdsfunktioner, findes der en parameter kendt som skriveforstærkning (write amplification). Dette er forholdet mellem mængden af data, der skrives til drevet, og mængden af data, som værten faktisk har sendt. For den mest populære RAID5 er dette forhold cirka ~3.5.
Som et resultat genbruger systemer med klassisk RAID kun cirka ~10% af deres reelle hastighed og skalerer dårligt i ydeevne, når antallet af drev overstiger ti.
Vi skal også bemærke, at overflødige skriveoperationer ikke kun reducerer SSD'ens ydeevne, men også mindsker dens ikke uendelige ressourcer, hvilket forkorter drevets levetid.
, som er kernen i alle AccelStor-produkter, er netop udviklet som et alternativ til klassiske RAID-algoritmer ved arbejde med SSD'er. Teknologisk innovation er anerkendt både gennem forskellige patenter og priser (herunder på Flash Memory Summit 2016) samt resultater fra uafhængige tests (f.eks. SPC1).
Essensen består i at omdanne alle indkommende skriveanmodninger, især af typen random, til et sæt blokke, der i videst muligt omfang ligner sekventiel skrivning set fra et lagersynspunkt. Som resultat sker skrivningen på SSD i den mest komfortable tilstand for dem, og den endelige ydeevne overstiger enhver klassisk RAID-system.
Alle SSD'er i AccelStor-systemene opdeles i to symmetrisk grupper FlexiRemap®. Gruppens størrelse afhænger af modellen og består af 5-11 enheder. For fejltolerance inden for gruppen anvendes paritet ligesom RAID5. Begge grupper bruges sammen og danner et samlet lagerområde. Derfor vil den samlede fejltolerance være lig med et RAID50-array bestående af to grupper: systemet kan klare fejl op til to SSD'er, men ikke mere end én i hver FlexiRemap®-gruppe.
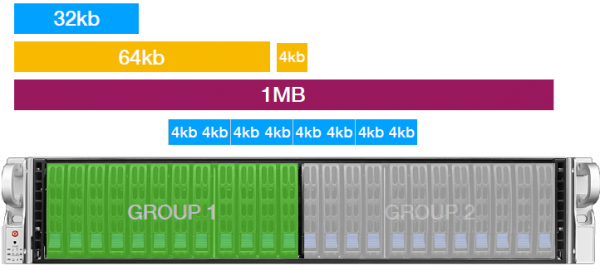
Alle indkommende skriveanmodninger opdeles i blokke af 4KB, som i round robin-tilstand skrives til begge grupper FlexiRemap®. Systemet holder konstant styr på efterspørgslen efter de skrevne blokke og forsøger at skrive lignende blokke så tæt sammen som muligt ved ændringer. Resultatet er et virtuelt analog til tiering, hvis man skal udtrykke det i termer fra SAN. Dette letter arbejdet for 'mængdesamleren': ubrugte blokke vil altid være tæt på hinanden.
Det skal bemærkes, at i modsætning til konkurrenternes produkter bruger ikke funktionen til caching af indkommende anmodninger i controllerens RAM. Alle indkommende datablokke skrives straks til SSD. Værtsystemet modtager bekræftelse på vellykket skrivning først efter, at dataene fysisk er placeret på lagringsenhederne. I RAM opbevares kun tabeller til placering af blokke på SSD for at fremskynde adgangen og bestemme, hvor næste datablok skal skrives. Selvom det selvfølgelig er for pålidelighed, findes der også kopier af disse tabeller på selve lagermedierne. Som resultat kræver AccelStor-systemerne ingen cachebeskyttelse i form af batteri/kondensator (dog er muligheden for at etablere forbindelse til en UPS til 'blød' udtænding i tilfælde af strømafbrydelser tilgængelig).
Takket være denne tilgang til organisering af optegnelser kan affaldssamleren virkelig arbejde i baggrunden uden at have en væsentlig indvirkning på hastigheden af lagermedierne, hvilket i sidste ende gør det muligt at genbruge op til 90 % af SSD'ens ydeevne inden for systemet. Det er netop dette, der forklarer de høje IOPS-værdier i AccelStor-systemer sammenlignet med All Flash, som er baseret på RAID-algoritmer.
En anden vigtig funktion ved FlexiRemap®-teknologien er det betydelige reducering af unødige skriveoperationer på SSD. Således er skrivekoefficienten (write amplification) for AccelStor-systemer kun 1,3, hvilket på almindeligt sprog betyder, at levetiden for lagermedierne forlænges med mere end 2,5 gange sammenlignet med RAID5!
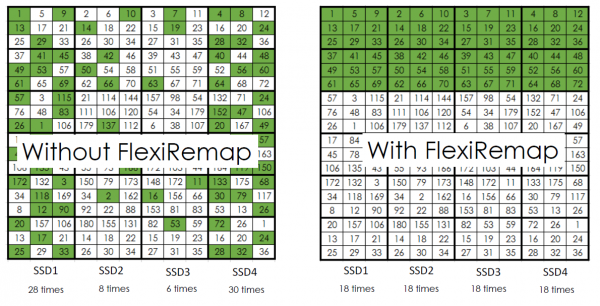
Takket være konstant kontrol fra systemet over politikken for dataopbevaring på SSD, slides alle lagermedier ensartet. Denne tilgang gør det muligt at forudsige deres levetid og proaktivt advare administratoren, når skrivekapaciteten nærmer sig sin grænse.
Det er klart, at SSD kan fejle. I sådanne tilfælde begynder systemet straks at rebuilde til en af hot spare-diskene. I denne process går FlexiRemap®-gruppen, der er i degraded-tilstand, over i "kun læse"-tilstand, og alle skriveanmodninger sendes til den anden gruppe. Denne beskyttelsesmekanisme er designet til at accelerere rebuilde-operationen og reducere risikoen for, at endnu en lagermedie fejler i den samme gruppe. For det er ingen hemmelighed, at alle lagermedier i gruppen oplever øget belastning under rebuilde-processen på grund af interferens fra læse-, skrive- og genoprettelsesoperationer på hot spare. Hermed øges risikoen for svigt af endnu en disk. Jo flere skriveoperationer, desto længere tid vil rebuilde tage.
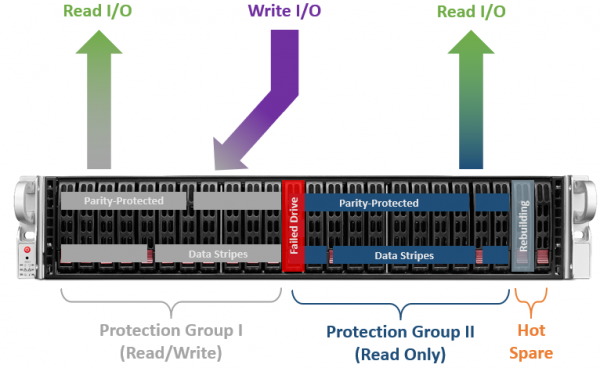
Efter afslutningen af genoprettelsesprocessen og tilbageførsel af FlexiRemap®-gruppen til normal tilstand, vil der opstå en lille ubalance i skrivekapaciteten mellem de to grupper. Derfor vil de efterfølgende skriveoperationer oftere blive rettet mod den genoprettede gruppe (naturligvis med hensyn til, at systemets samlede ydeevne ikke lider betydeligt).
At øge ydeevnen af All Flash-systemer baseret på RAID-algoritmer over visse værdier (~280K IOPS@4K random write) kan ikke lade sig gøre, selv med komplekse cache-systemer. FlexiRemap®-teknologien, takket være en helt anden tilgang til organisering af lagerplads, overvinder ikke kun denne barriere let, men forlænger også SSD'ens levetid med flere gange. Så systemerne har betydelige fordele blandt All Flash-array på mange fronter (IOPS/$, GB/$, TCO, ROI), hvilket gør dem til ideelle kandidater til nøglepositioner i kundernes datacentre for at løse ressourcekrævende opgaver.
Kilde: habr.com
