

I dag er det umuligt at forestille sig et projekt baseret på Kubernetes uden ELK-stakken, som bruges til at gemme logs fra både applikationer og systemkomponenter i klyngen. I vores praksis anvender vi EFK-stakken med Fluentd i stedet for Logstash.
Fluentd er en moderne, universel logindsamler, der får stigende popularitet og er blevet en del af Cloud Native Computing Foundation, hvilket gør, at udviklingsretningen er fokuseret på brug sammen med Kubernetes.
Brugen af Fluentd i stedet for Logstash ændrer ikke det grundlæggende i softwarepakken, men Fluentd har sine egne specifikke nuancer, der følger af dens multifunktionalitet.
For eksempel, da vi begyndte at bruge EFK i et belastet projekt med høj loggingsintensitet, stødte vi på, at nogle meddelelser viste sig flere gange i Kibana. I denne artikel vil vi forklare, hvorfor dette fænomen opstår, og hvordan man løser problemet.
Problemet med dublering af dokumenter
I vores projekter er Fluentd implementeret som DaemonSet (som automatisk kører i én instans på hver node i Kubernetes-klyngen) og overvåger stdout-loggene fra containerne i /var/log/containers. Efter indsamling og behandling sendes loggene i form af JSON-dokumenter til ElasticSearch, der er sat op i enten klynge- eller standalone-tilstand, afhængigt af projektets omfang og krav til ydeevne og fejltolerance. Kibana anvendes som den grafiske grænseflade.
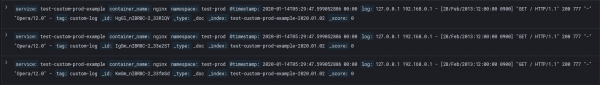
Når vi bruger Fluentd med en buffer-plugin ved udgangen, stødte vi på en situation, hvor nogle dokumenter i ElasticSearch har helt ens indhold og kun adskiller sig ved identifikatoren. Man kan bekræfte, at dette netop er duplikater af meddelelser ved hjælp af et eksempel fra Nginx-loggen. I logfilen findes denne meddelelse kun i én instans:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Men i ElasticSearch findes der flere dokumenter, der indeholder denne meddelelse:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}
Desuden kan der være flere end to gentagelser.
Under registreringen af dette problem i Fluentd-logfilerne kan man observere et stort antal advarsler af følgende art:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] kunne ikke tømme bufferen. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="kunne ikke skubbe logs til Elasticsearch-klyngen ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): læse timeout nået"Disse advarsler opstår, når ElasticSearch ikke kan returnere et svar på anmodningen inden for den angivne parameter request_timeout, hvilket gør, at det overførte bufferfragment ikke kan ryddes. Efterfølgende forsøger Fluentd at sende bufferfragmentet til ElasticSearch igen, og efter et vilkårligt antal forsøg afsluttes operationen med succes:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] retry lykkedes. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] retry lykkedes. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] retry lykkedes. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] retry lykkedes. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] retry lykkedes. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Dog ElasticSearch opfatter hver af de overførte bufferfragmenter som unikke og tildeler dem unikke værdier til felterne _id ved indeksering. På den måde opstår der kopier af meddelelserne.
I Kibana ser det således ud:
Løsning på problemet
Der er flere muligheder for at løse dette problem. En af dem er den indbyggede mekanisme til generering af unikke hashes for hvert dokument i pluginet fluent-plugin-elasticsearch. Hvis denne mekanisme anvendes, vil ElasticSearch genkende duplikater på transportstadiet og forhindre duplikering af dokumenter. Men man må ikke glemme, at denne løsningsmetode kun bekæmper symptomet og ikke eliminerer fejlen med den manglende timeout, hvorfor vi har valgt at fravælge denne tilgang.
Vi bruger en bufferplugin til udgangen af Fluentd for at undgå tab af logs i tilfælde af kortvarige netværksproblemer eller øget logningsintensitet. Hvis ElasticSearch af en eller anden grund ikke kan skrive dokumentet i indekset med det samme, havner dokumentet i en kø, som opbevares på disken. Derfor, for at fjerne kilden til det problem, der fører til den ovenfor beskrevne fejl, er det nødvendigt at angive korrekte værdier for bufferindstillingerne, således at Fluentd's output buffer har en tilstrækkelig størrelse og samtidig kan tømmes til tiden.
Det skal bemærkes, at værdierne for de parametre, vi vil diskutere nedenfor, er individuelle for hver specifik brug af buffering i udgangsplugins, da de afhænger af mange faktorer: intensiteten af logning af beskeder fra tjenesterne, ydeevnen af disk-systemet, belægningen af netværkskanalen og dens båndbredde. Derfor, for at få passende, men ikke overdrevne bufferindstillinger til hver enkelt situation og undgå langvarig blind prøve, kan man bruge de fejlinformationer, som Fluentd skriver til sin log under drift, og forholdsvis hurtigt få de korrekte værdier.
På tidspunktet for problemets registrering så konfigurationen følgende ud:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Under løsningen af problemet blev værdierne for følgende parametre manuelt justeret:
chunk_limit_size — størrelsen på de chunks, som beskederne opdeles i i bufferen.
- flush_interval — den tidsinterval, hvormed bufferen renses.
- queue_limit_length — det maksimale antal chunks i køen.
- request_timeout — den tid, der er sat for forbindelsen mellem Fluentd og ElasticSearch.
Den samlede størrelse af bufferen kan beregnes ved at multiplicere parametrene queue_limit_length og chunk_limit_size, hvilket kan tolkes som "det maksimale antal chunks i køen, hver med en given størrelse." Hvis bufferen er for lille, vises følgende advarsel i loggene:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] mislykkedes med at skrive data i bufferen på grund af bufferoverløb action=:blockDet betyder, at bufferen ikke bliver renset hurtigt nok, og de data, der kommer ind i den fyldte buffer, blokkeres, hvilket vil føre til tab af dele af loggene.
Bufferen kan øges på to måder: ved at øge enten størrelsen af hver chunk i køen eller antallet af chunks, der kan være i køen.
Hvis chunk-størrelsen chunk_limit_size sættes til mere end 32 megabyte, vil ElasticSearch ikke acceptere det, da den indgående pakke bliver for stor. Derfor, hvis det er nødvendigt at øge bufferen yderligere, er det bedst at øge den maksimale længde af køen queue_limit_length.
Når bufferen ikke længere vil overfyldes, og der kun er en meddelelse om timeout-mangel tilbage, kan man begynde at øge parameteren request_timeout. Men hvis værdien sættes over 20 sekunder, vil følgende advarsler begynde at dukke op i Fluentd-loggene:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] buffer flush tog længere tid end slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Denne meddelelse påvirker ikke systemets drift og betyder, at tiden til at rense bufferen har taget længere tid end hvad der er angivet af parameteren slow_flush_log_threshold. Dette er debug-information, og vi bruger den til at vælge værdien af parameteren request_timeout.
Den generelle algoritme til justering ser således ud:
- Sæt værdien af request_timeout til en garanti, der er større end nødvendigt (hundrede sekunder). I løbet af konfigurationen vil det primære kriterium for korrektheden af denne parameter være, at advarsler om timeout-mangel forsvinder.
- Vent på meddelelser om overskridelse af grænsen slow_flush_log_threshold. I teksten til advarslen vil feltet elapsed_time vise den faktiske tid til rensning af bufferen.
- Sæt værdien request_timeout højere end den maksimale værdi elapsed_time, der er opnået i observationsperioden. Vi beregner værdien af request_timeout som elapsed_time + 50%.
- For at fjerne advarsler om langsom bufferrydning fra loggen kan man hæve værdien af slow_flush_log_threshold. Vi beregner denne værdi som elapsed_time + 25%.
De endelige værdier for disse parametre, som nævnt tidligere, er individuelle for hver sag. Ved at følge ovenstående algoritme garanterer vi, at vi eliminerer fejlen, der fører til gentagelse af meddelelser.
I tabellen nedenfor vises, hvordan antallet af fejl pr. dag, der fører til duplikerede meddelelser, ændrer sig, mens vi justerer værdierne af de nævnte parametre:
node-1
node-2
node-3
node-4
Før/Efter
Før/Efter
Før/Efter
Før/Efter
failed to flush the buffer
1749/2
694/2
47/0
1121/2
retry succeeded
410/2
205/1
24/0
241/2
Det er også værd at bemærke, at de opnåede indstillinger kan miste deres relevans, efterhånden som projektet vokser og dermed antallet af logs øges. Et primært tegn på utilstrækkelig etableret timeout er, at der i Fluentd-loggen vises meddelelser om langsom bufferrydning, dvs. overskridelse af grænsen for slow_flush_log_threshold. Fra dette tidspunkt er der stadig lidt margen til at overskride parametret request_timeout, så det er nødvendigt at reagere rettidigt på disse meddelelser og gentage processen med at finde de optimale indstillinger, der er beskrevet ovenfor.
Konklusion
Finjustering af Fluentd-udgangsbufferen er et af de vigtigste trin i opsætningen af EFK-stakken, som definerer stabiliteten i dens drift og korrekt placering af dokumenter i indekserne. Ved at følge den beskrevne opsætningsalgoritme kan man være sikker på, at alle logs vil blive gemt i ElasticSearch-indekset i den rigtige rækkefølge, uden duplikationer og tab.
Læs også andre artikler på vores blog:
Kilde: habr.com
