

Kommandoen tilbyder ingeniør Rahul Bhatia fra Clairvoyant om de forskellige filformater inden for big data, de mest almindelige funktioner i Hadoop-formater, og hvilket format der er bedst at bruge.
Hvorfor er der behov for forskellige filformater
Et alvorligt flaskehals i ydeevnen for applikationer, der understøtter HDFS, såsom MapReduce og Spark, er tiden til at søge, læse samt skrive data. Disse problemer forstærkes af vanskelighederne ved at håndtere store datasæt, hvis vi ikke har et fast, men et udviklende skema, eller hvis der er bestemte begrænsninger for opbevaring.
Behandling af big data øger belastningen på lagersystemet - Hadoop gemmer data redundantly for at opnå fejltolerance. Udover diske belastes CPU, netværk, input-output systemer osv. Som datamængden vokser, stiger omkostningerne ved behandling og opbevaring.
Forskellige filformater i er opfundet for at løse netop disse problemer. Valget af det rigtige filformat kan give betydelige fordele:
- Hurtigere læsetid.
- Hurtigere skrivning.
- Delte filer.
- Understøttelse af skemaudvikling.
- Udvidet kompressionsunderstøttelse.
Nogle filformater er designet til almindelig brug, andre til mere specifikke anvendelser, og nogle er udviklet med fokus på konkrete datakarakteristika. Så valget er faktisk ret stort.
Filformatet Avro
For til dataserialisering bruges i vid udstrækning - Avro er et linie-baseret, hvilket betyder, at det er et linjebaseret format til datalagring i Hadoop. Det gemmer skemaet i JSON-format, hvilket letter læsningen og fortolkningen af ethvert program. Selve dataene ligger i et binært format, kompakt og effektivt.
Avro's serialiseringssystem er sprogneutral. Filer kan behandles af forskellige sprog, herunder C, C++, C#, Java, Python og Ruby.
En nøglefunktion ved Avro er den pålidelige understøttelse af datastrukturer, der ændrer sig over tid, det vil sige, at de udvikler sig. Avro forstår ændringer i skemaet - fjernelse, tilføjelse eller ændring af felter.
Avro understøtter forskellige datastrukturer. For eksempel kan du oprette en post, der indeholder et array, et enum-typ og en underpost.
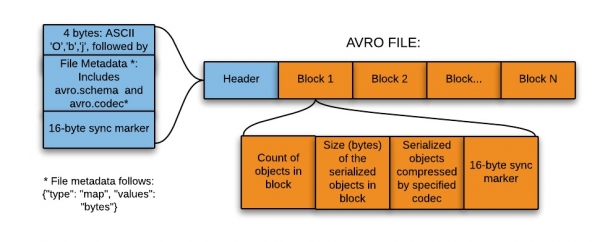
Dette format er ideelt til skrivning til en landing (overgangs) zone i datalaget (, or data lake — a collection of instances for storing various types of data in addition to the data sources themselves).
So, to record in the landing zone of the data lake, this format is best suited for the following reasons:
- Data from this zone is usually read in full for further processing by downstream systems — and the row-based format is more efficient in this case.
- Downstream systems can easily extract schema tables from files — there's no need to store schemas separately in an external metadata storage.
- Any change in the original schema is easily handled (schema evolution).
Parquet file format
Parquet is an open-source file format for Hadoop that stores nested data structures in a flat columnar format..
Compared to the traditional row-based approach, Parquet is more efficient in terms of storage and performance.
This is especially useful for queries that read specific columns from a wide (with many columns) table. Due to the file format, only the necessary columns are read, minimizing input-output operations.
A brief aside-explanation: to better understand the Parquet file format in Hadoop, let’s look at what a column-based — that is, columnar — format is. In such a format, homogeneous values of each column are stored together.
, the record includes fields ID, Name, and Department. In this case, all values of the ID column will be stored together, as will the values of the Name column, and so on. The table will look something like this:
ID
Navn
Department
1
emp1
d1
2
emp2
d2
3
emp3
d3
In row format, the data will be saved as follows:
1
emp1
d1
2
emp2
d2
3
emp3
d3
In a columnar file format, the same data will be saved like this:
1
2
3
emp1
emp2
emp3
d1
d2
d3
The columnar format is more efficient when you need to query several columns from a table. It will read only the necessary columns, as they are adjacent to each other. Thus, input-output operations are minimized.
For example, you only need the NAME column. In each record in the dataset needs to be loaded, parsed into fields, and then the NAME data extracted. The columnar format allows you to go directly to the Name column, as all values for that column are stored together. You won’t have to scan the entire record.
På den måde øger kolonneformatet forespørgselsydelsen, da det kræver mindre tid at søge efter de nødvendige kolonner, og antallet af input-output operationer reduceres, fordi der kun læses de nødvendige kolonner.
En af de unikke egenskaber er, at det i dette format kan opbevare data med indlejrede strukturer. Det betyder, at i Parquet-filen kan selv indlejrede felter læses individuelt uden at skulle læse alle felter i den indlejrede struktur. For at gemme indlejrede strukturer bruger Parquet en shredding and assembly-algoritme.
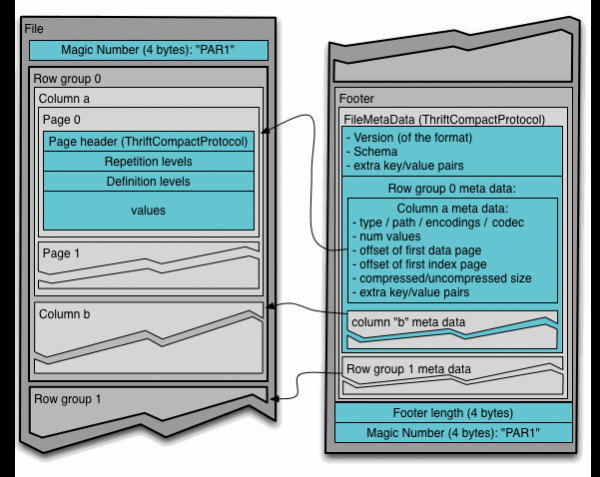
For at forstå Parquet filformatet i Hadoop, er det nødvendigt at kende følgende termer:
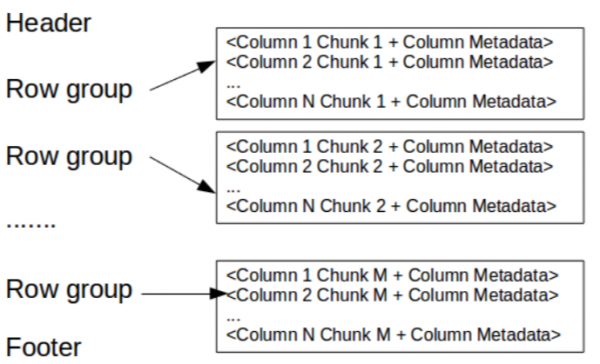
- Rækkegruppe (row group): en logisk vandret opdeling af data i rækker. En rækkegruppe består af et fragment af hver kolonne i datasættet.
- Kolonnefragment (column chunk): et fragment af en specifik kolonne. Disse kolonnefragmenter lever i en bestemt rækkegruppe og vil være sammenhængende i filen.
- Side (page): kolonnefragmenter opdeles i sider, der skrives efter hinanden. Siderne har en fælles header, så unødvendige data kan springes over når de læses.
Her indeholder headeren simpelthen et magisk tal PAR1 (4 byte), som identificerer filen som en Parquet filformat.
I footer'en er der skrevet følgende:
- Metadata for filen, som indeholder startkoordinaterne for metadata for hver kolonne. Ved læsning skal man først læse metadataen for filen for at finde alle de interessante kolonnefragmenter. Derefter skal kolonnefragmenterne læses sekventielt. Metadata inkluderer også versionsnummeret for formatet, skemaet og eventuelle yderligere nøgle-værdi par.
- Længden af metadata (4 byte).
- Det magiske tal PAR1 (4 byte).
ORC filformat
Optimeret række-kolonne filformat (Optimized Row Columnar, ) tilbyder en meget effektiv måde at opbevare data på og blev udviklet for at overvinde begrænsningerne ved andre formater. Det opbevarer data i en perfekt kompakt form, hvilket gør det muligt at springe over unødvendige detaljer - uden at det kræver opbygning af store, komplekse eller manuelt vedligeholdte indekser.
Fordele ved ORC formatet:
- Én fil som output fra hver opgave, hvilket reducerer belastningen på NameNode (navneserver).
- Understøttelse af Hive-datatyper, herunder DateTime, decimaler og komplekse datatyper (struct, list, map og union).
- Samtidig læsning af den samme fil af forskellige RecordReader-processer.
- Mulighed for at opdele filer uden at scanne for markører.
- Vurdering af den maksimalt mulige tildeling af heap-hukommelse til læse-/skriveprocesser baseret på information i filens footer.
- Metadata gemmes i det binære protokolbuffer-serialiseringsformat, som tillader tilføjelse og fjernelse af felter.
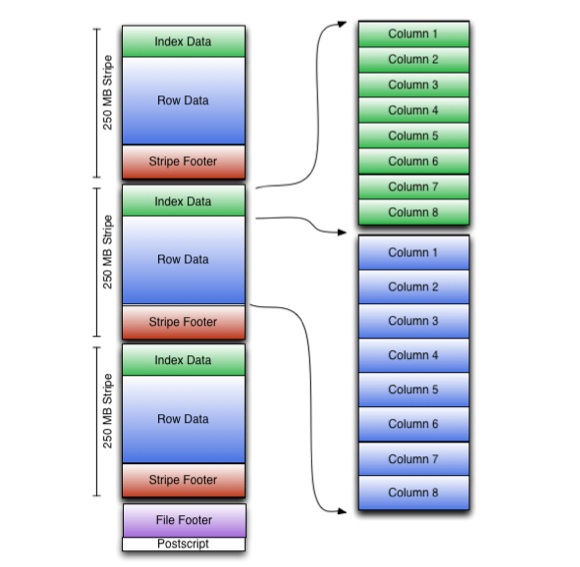
ORC gemmer samlinger af rækker i en fil, mens de indeni samlingen lagres i kolonneformat.
ORC-filen gemmer grupper af rækker, kaldet strimler (stripes), og supplerende information i filens footer. Postscripten i slutningen af filen indeholder komprimeringsparametre og størrelsen af den komprimerede footer.
Standardstørrelsen for en stripe er 250 MB. Ved at have striber af en så stor størrelse udføres læsning fra HDFS mere effektivt i store, sammenhængende blokke.
Footeren i filen indeholder en liste over strimlerne i filen, antallet af rækker pr. stripe og datatypen for hver kolonne. Der står også den resulterende værdi for count, min, max og sum for hver kolonne.
Footer for strimlen indeholder en katalog med placeringer for strømmen.
Række-data bruges, når tabeller scannes.
Indexdata inkluderer minimums- og maksimumsværdier for hver kolonne og rækkeplaceringer i hver kolonne. ORC-indexer bruges kun til at vælge striber og grupper af rækker, ikke til at besvare forespørgsler.
Sammenligning af forskellige filformater
Avro sammenlignet med Parquet
- Avro er et rækkeorienteret lagringsformat, mens Parquet lagrer data i kolonner.
- Parquet er bedre egnet til analytiske forespørgsler, hvilket betyder, at læsnings- og dataprocesseringsoperationer er langt mere effektive end skrivning.
- Skriveoperationer i Avro er mere effektive end i Parquet.
- Avro håndterer skemaudvikling mere modent. Parquet understøtter kun tilføjelse af skemaer, mens Avro implementerer multifunktionel udvikling, dvs. tilføjelse eller ændring af kolonner.
- Parquet er ideelt til at forespørge et delmængde af kolonner i en multi-kolonne tabel. Avro egner sig til ETL-operationer, hvor vi anmoder om alle kolonner.
ORC sammenlignet med Parquet
- Parquet er bedre til at gemme indlejrede data.
- ORC er bedre til at understøtte predicate pushdown.
- ORC understøtter ACID-egenskaber.
- ORC komprimerer data bedre.
Andre artikler om emnet:
- .
- .
- .
Kilde: habr.com
