

Rigtige databaseklæbe-sværd — globaler — har længe været kendt, men stadig få formår effektivt at bruge dem eller overhovedet ejer dette supervåben.
Hvis man bruger globaler til at løse de opgaver, som de virkelig er gode til, kan man opnå fremragende resultater. Enten i ydeevne eller i forenkling af løsning af opgaven (, ).
Globaler er en speciel måde at gemme og behandle data på, helt anderledes end-tabeller i SQL. De blev introduceret i 1966 i sproget (evolutionært udviklet — , også kaldet COS) i medicinske databaser og anvendes stadig aktivt der. Globaler i moderne DBMS understøtter transaktioner, logning, replikation og partitionering. Det vil sige, at man kan bygge moderne, pålidelige, distribuerede og hurtige systemer på dem.
Globaler begrænser ikke dig til rammerne af den relationelle model. De giver frihed til at udvikle datakonstruktioner, der er optimeret til specifikke opgaver. For mange applikationer kan en fornuftig brug af globaler være virkelig et hemmeligt våben, der sikrer en ydeevne, som udviklere af relationelle applikationer kun kan drømme om.
Globaler som datalagringsmetode kan bruges i mange moderne programmeringssprog, både høj- og lavniveau. Derfor vil jeg i denne artikel fokusere specifikt på globaler og ikke på det sprog, de engang stammer fra.
2. Hvordan fungerer globaler
Lad os først forstå, hvordan globaler fungerer, og hvad deres styrker er. Man kan se på globaler fra forskellige vinkler. I denne del af artiklen ser vi dem som træer. Eller som hierarkiske datalagre.
Forenklet sagt er en global en vedholdende array. En array, der automatisk gemmes på disk.
Det er svært at forestille sig noget mere enkelt til datalagring. I kode (på COS/M-sprog) adskiller det sig fra et almindeligt associativt array kun med symbolet
foran navnet. ^ For at gemme data i en global er det ikke nødvendigt at lære SQL-forespørgselssproget, kommandoerne til at arbejde med dem er meget enkle. Man kan lære dem på en time.
For at gemme data i globalen behøver man ikke at lære SQL-spørgsmålssproget, da kommandoerne til at arbejde med dem er meget enkle. Man kan lære dem på en time.
Lad os starte med det enkleste eksempel. Et en-niveau træ med 2 grene. Eksempler er skrevet i COS.
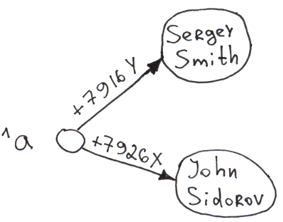
Set ^a("+7926X") = "John Sidorov"
Set ^a("+7916Y") = "Sergey Smith"
Når man indsætter information i globalen (kommando Set) sker der automatisk 3 ting:
- Gemmer data på disken.
- Indeksering. Det, der er i parentes, fungerer som en nøgle (i den engelsksprogede litteratur kaldet «subscript»), og til højre for lighedstegnet er værdien («node value»).
- Sortering. Dataene sorteres efter nøgle. Ved traversal af arrayet bliver det første element «Sergey Smith» og det andet «John Sidorov». Når liste over brugere hentes fra globalen, bruger databasen ikke tid på sortering. Desuden kan man anmode om en udskrift af den sorterede liste, der starter med en hvilken som helst nøgle, selv en ikke-eksisterende (udskriften starter med den første reelle nøgle, der følger efter den ikke-eksisterende).
Alle disse operationer sker utrolig hurtigt. På min hjemmecomputer opnåede jeg værdier op til 750.000 indsætninger/s i én proces. På flerkernede processorer kan værdierne nå indsætninger/s.
Selvfølgelig siger indsætningshastigheden ikke meget i sig selv. Man kan for eksempel hurtigt skrive information til tekstfiler — sådan at Visa-processering fungerer. Men i tilfælde af globale får vi en struktureret, indekseret lager, som man efterfølgende kan arbejde med let og hurtigt.

- Den største styrke ved globale er hastigheden af nye nodes indsættelse.
- Data i globalen er altid indekserede. Deres traversal, både på ét niveau og dybt i træet, er altid hurtig.
Lad os tilføje et par grene på andet og tredje niveau til globalen.
Set ^a("+7926X", "city") = "Moscow"
Set ^a("+7926X", "city", "street") = "Req Square"
Set ^a("+7926X", "age") = 25
Set ^a("+7916Y", "city") = "London"
Set ^a("+7916Y", "city", "street") = "Baker Street"
Set ^a("+7916Y", "age") = 36 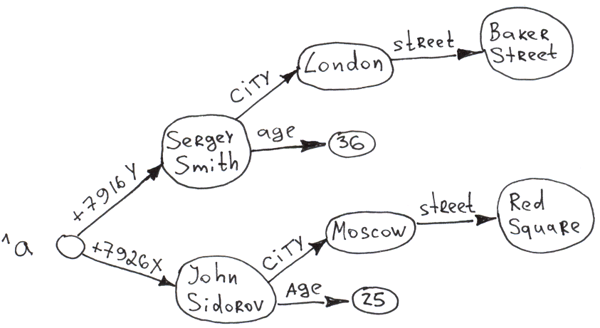
Det er tydeligt, at man kan bygge flerniveaus træer baseret på globala. Desuden er adgangen til enhver node næsten øjeblikkelig på grund af autoindeksering under indsættelse. Og på ethvert niveau i træet er alle grene sorteret efter nøgle.
Som man kan se, kan information gemmes både i nøglen og værdien. Den samlede længde af nøglen (summen af længderne af alle indekser) kan nå , mens værdierne for Caché. Antallet af niveauer i træet (antal dimensioner) er 31.
En anden interessant detalje. Man kan bygge et træ uden at angive værdierne for noderne på de øverste niveauer.
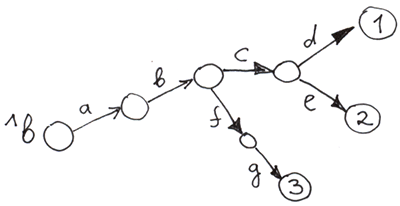
Sæt ^b("a", "b", "c", "d") = 1
Sæt ^b("a", "b", "c", "e") = 2
Sæt ^b("a", "b", "f", "g") = 3
Tomme noder er noder, der ikke har nogen værdi tildelt.
For bedre at forstå globale variabler, lad os sammenligne dem med andre træer: have- og filsystemstræer.
Lad os sammenligne træerne med de mest velkendte hierarkiske strukturer: de sædvanlige træer, der vokser i haver og marker, samt filsystemer.
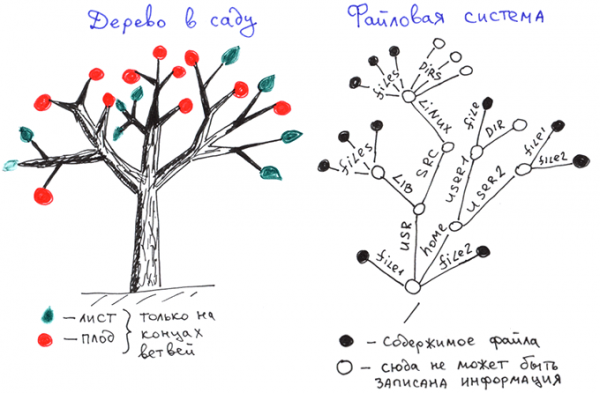
Som vi ser, har have træer blader og frugter kun på enderne af grenene.
På filsystemer opbevares oplysninger kun på enderne af grenene, som er de fulde navne på filerne.
Og her er datastrukturen for en global variabel.
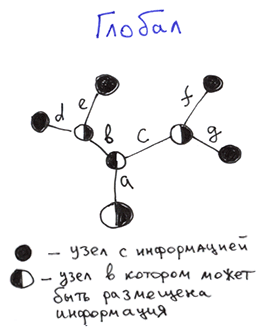 Forskelle:
- Interne noder: Oplysninger i globale kan opbevares i hver knude, ikke kun på enderne af grenene.
- Eksterne noder: En global skal have værdi defineret på enderne af grenene, hvilket ikke er nødvendigt for filsystem- og havetræer.
Når det kommer til dele af de interne noder, kan man sige, at strukturen af en global er et overmængde af strukturen af filsystemers og havetræs navne. Dvs. mere fleksibel.
Generelt repræsenterer en global et ordnet træ med mulighed for at opbevare data i hver knude..
For bedre at forstå, hvordan globale fungerer, lad os forestille os, hvad der ville ske, hvis skaberne af filsystemerne brugte en metode til at opbevare oplysninger, der var lig med globale?
- Ved at slette en enkelt fil i en mappe ville mappen automatisk blive slettet, ligesom alle overliggende mapper, der kun indeholdt den lige slettede mappe.
- Behovet for mapper ville være forsvundet. Der ville blot være filer med underfiler og filer uden underfiler. Hvis man sammenligner det med et almindeligt træ, ville hver gren blive til en frugt.

- Sådanne ting som README.txt-filer ville muligvis forsvinde. Alt, hvad der skulle siges om indholdet af en mappe, kunne skrives i selve mappen. I stinavnet er filnavnet uadskilleligt fra mappenavnet, så man kunne nøjes med filer.
- Hastigheden ved at slette mapper med indlejrede undermapper og filer ville stige dramatisk. Flere gange er der dukket artikler op på Habr om, hvor lang tid det tager at slette millioner af små filer (, ). Men hvis du laver et pseudo-filssystem på globalen, vil det tage sekunder eller brøkdele deraf. Da jeg testede sletning af undertræer på min hjemmecomputer, kunne jeg i løbet af 1 sekund slette 96-341 millioner noder fra et to-niveau træ på HDD (ikke SSD). Og dette handler om at slette dele af træet, ikke bare hele filen med globalerne.
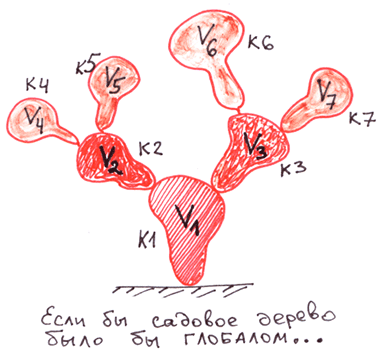

Sletning af undertræer er endnu en stærk side ved globalerne. Dette kræver ikke rekursion. Det sker utrolig hurtigt.
I vores træ kunne dette gøres med kommandoen Kill.
Kill ^a("+7926X") 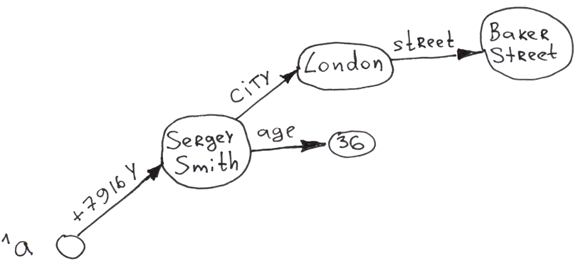
For bedre forståelse af, hvilke handlinger vi har til rådighed over globalerne, vil jeg give en kort tabel.
Hovedkommandoer og funktioner til arbejde med globaler i COS
Indstilling af grene til noden (hvis de endnu ikke er defineret) og nodens værdi
Kopiering af undertræet
Sletning af undertræet
Sletning af værdien af en bestemt node. Undertræet, der kommer fra noden, berøres ikke
Fuld gennemgang af træet med indgående besøg
Gennemgang af grene af en bestemt node
Tjekker om noden er defineret
Atomisk inkrementering af nodens værdi. For at undgå læsninger og skrivninger, til ACID. For nylig anbefales det at ændre til
Tak for din opmærksomhed, vi er klar til at besvare dine spørgsmål.
Ansvarsfraskrivelse: Denne artikel og mine kommentarer til den er min mening og har ikke noget at gøre med den officielle position fra InterSystems.
Fortsættelse . Du vil lære, hvilke datatyper der kan vises på globalerne, og hvornår de giver det største udbytte.
Kilde: habr.com
