

 I tidligere afsnit (, ) talte vi om globale variabler som træer, i dette afsnit vil vi se på globale variabler som sparsommelige arrays.
er en type array, hvor størstedelen af værdierne har den samme værdi.
I praksis støder man ofte på så enorme sparsomme arrays, at det ikke giver mening at optage hukommelse med ens elementer. Derfor giver det mening at implementere sparsomme arrays, så der ikke bruges hukommelse på at gemme ensartede værdier.
I nogle programmeringssprog er sparsomme arrays en del af sproget, , . I andre programmeringssprog findes der specielle biblioteker, som gør det muligt at implementere dem. For C++ — og andre.
Globale variabler er gode kandidater til at implementere sparsomme arrays, fordi:
- De opbevarer værdier for kun bestemte noder og gemmer ikke værdier for udefinerede;
- Adgangsinterfacet til en noders værdi er ekstremt lig det, der er implementeret i mange programmeringssprog for at få adgang til elementer i et multidimensionalt array.
Set ^a(1, 2, 3)=5 Write ^a(1, 2, 3) - Globalen er en tilstrækkelig lavniveaubygget struktur til datalagring, så de har fremragende hastighedsegenskaber (fra hundredtusinder til flere millioner transaktioner pr. sekund afhængigt af hardware, jf. )
Da globalen er en vedholdende struktur, giver det mening at lave sparsomme arrays på dem, når man på forhånd ved, at mængden af RAM vil være utilstrækkelig.
Et af egenskaberne ved implementationer af sparsomme arrays er returnering af en standardværdi, hvis man prøver at tilgå en udefineret celle.
Dette kan implementeres ved at bruge funktionen i COS. I dette eksempel er der betragtet et 3-dimensionelt array.
SET a = $GET(^a(x,y,z), defValue)I hvilke opgaver er sparsomme arrays nødvendige, og hvordan kan globale variabler hjælpe?
Adjacensmatrix (sammenhæng)
bruges til at repræsentere grafer:
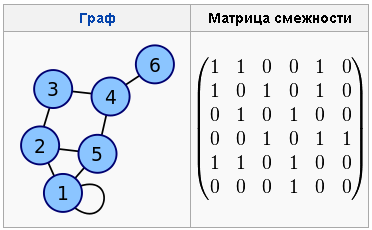
Det er tydeligt, at jo større grafen er, desto flere nuller vil der være i matricen. For eksempel, hvis man tager et socialt netværksgraf og repræsenterer det som en sådan matrix, vil den næsten helt bestå af nuller, dvs. den vil være et sparsomt array.
Set ^m(id1, id2) = 1
Set ^m(id1, id3) = 1
Set ^m(id1, id4) = 1
Set ^m(id1) = 3
Set ^m(id2, id4) = 1
Set ^m(id2, id5) = 1
Set ^m(id2) = 2
....
I dette eksempel gemmer vi i globalen ^m tilknytningsmatricen samt antallet af kanter ved hver node (hvem der er venner med hvem og antal venner).
Hvis antallet af elementer i grafen ikke overstiger 29 millioner (det tal tages som produktet af 8 * ), så findes der en endnu mere økonomisk metode til opbevaring af sådanne matricer - bitstrenge, da der i deres implementering specialoptimeres for store huller.
Manipulationer med bitstrenge udføres af funktionen .
; sæt bit
SET $BIT(rowID, positionID) = 1
; hent bit
Write $BIT(rowID, positionID)
Overgangstabel for enautomater
Da grafen af overgangene for en automat er en almindelig graf, er overgangstabellen for automaten den samme som den adjacensmatrix, der blev nævnt ovenfor.
Cellulære automater
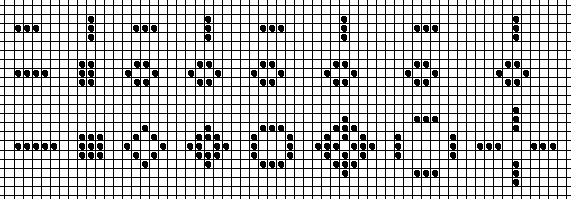
Den mest kendte cellulære automat er , som på grund af sine regler (når en celle har mange naboer - dør den) repræsenterer et sparsomt array.
Stephen Wolfram mener, at cellulære automater er en I 2002 udgiver han den 1280-sider lange bog 'A New Kind of Science', hvor han argumenterer for, at fremskridt inden for cellulære automater ikke er isoleret, men meget robuste og har stor betydning for alle videnskabsområder.
Det er bevist, at enhver algoritme, der kan udføres på en computer, kan implementeres ved hjælp af en cellulær automat. Cellulære automater bruges til modellering af dynamiske miljøer og systemer, til løsning af algoritmiske problemer og andre formål.
Hvis vi har et kæmpestort felt, og vi skal registrere alle mellemtilstande i den cellulære automat, er det ganske fornuftigt at bruge globale variabler.
Kartografi
Det første, jeg kommer i tanker om, når det drejer sig om brugen af sparsomme arrays, er kartografiske opgaver.
Som regel er der meget tomt rum på kort. Hvis kortet repræsenteres som store pixels, vil 71% af pixels på Jorden være dækket af oceaner. Sparsomt array. Og hvis man kun registrerer menneskeskabte strukturer, vil der være over 95% tomt rum.
Selvfølgelig gemmer ingen kort som raster arrays; der anvendes vektorrepræsentation.
Men hvad består vektorkort af? Det er en ramme bestående af punkter, polylinjer og polygoner.
Faktisk er databasen med punkter og forbindelser mellem dem.
En af de mest ambitiøse opgaver inden for kortlægning er missionen for at kortlægge vores galakse med Gaia-teleskopet. Billedligt talt er vores galakse, ligesom hele universet, en sammenhængende fortyndet masse: enorme rum af tomhed, hvori der findes sjældne små punkter – stjerner. Den tomme plads udgør 99,999999…….%. For at gemme kortet over vores galakse blev en global database valgt – Caché.
Jeg kender ikke den nøjagtige struktur af globaler i dette projekt, men jeg kan antage, at det ligner noget som:
Set ^galaxy(b, l, d) = 1; Stjernens nummer ifølge kataloget, hvis der er et
Set ^galaxy(b, l, d, "name") = "Sun"
Set ^galaxy(b, l, d, "type") = "normal"; mulighederne omfatter blackhole, quazar, red_dwarf osv.
Set ^galaxy(b, l, d, "weight") = 14E50
Set ^galaxy(b, l, d, "planetes") = 7
Set ^galaxy(b, l, d, "planetes", 1) = "Mercury"
Set ^galaxy(b, l, d, "planetes", 1, weight) = 1E20
...
Hvor b, l, d er og afstand til solen.
Den fleksible struktur af globaler gør det muligt at gemme alle nødvendige egenskaber for stjerner og planeter, da databaser baseret på globaler er skema-frie (scheme-less).
Caché blev valgt til at gemme kortet over vores univers, ikke kun på grund af sin fleksibilitet, men også på grund af dens evne til meget hurtigt at gemme datastreams, samtidig med at den opretter indeks globale for hurtig søgning.
Hvis vi vender tilbage til Jorden, så blev der oprettet kortlægningsprojekter på globaler og fork af OpenStreetMap – .
For nylig på blev der implementeret geospatiale indekser . Vi ser frem til detaljer om implementeringen fra forfatterne af artiklen.
Implementeringen af rumlige indekser på globale i OpenStreetMap XAPI
Billederne er taget fra .
Hele jorden opdeles i kvadrater, som derefter opdeles i underkvadrater, og underkvadraterne opdeles i under-underkvadrater og så videre. Samlet set får vi en hierarkisk struktur, hvor globaler er skabt til opbevaring.
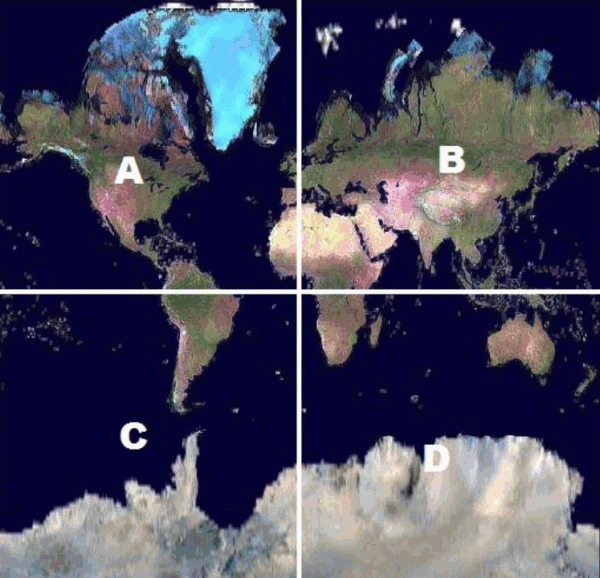
Når som helst kan vi praktisk talt øjeblikkeligt anmode om det ønskede kvadrat eller rydde det, og alle underkvadrater vil også blive returneret eller ryddet.
En lignende ordning med globaler kan implementeres på flere måder.
Variant 1:
Set ^m(a, b, a, c, d, a, b,c, d, a, b, a, c, d, a, b,c, d, a, 1) = idFørstePunkt
Set ^m(a, b, a, c, d, a, b,c, d, a, b, a, c, d, a, b,c, d, a, 2) = idAndetPunkt
...
Variant 2:
Set ^m('abacdabcdabacdabcda', 1) = idFørstePunkt
Set ^m('abacdabcdabacdabcda', 2) = idAndetPunkt
...
I begge tilfælde er det let at anmode om punkter, der befinder sig i et kvadrat på ethvert niveau på COS/M. Det vil være lidt lettere at rydde kvadratiske stykker rum på ethvert niveau i det første tilfælde, men det er sjældent nødvendigt.
Eksempel på en af de nederste kvadrater:
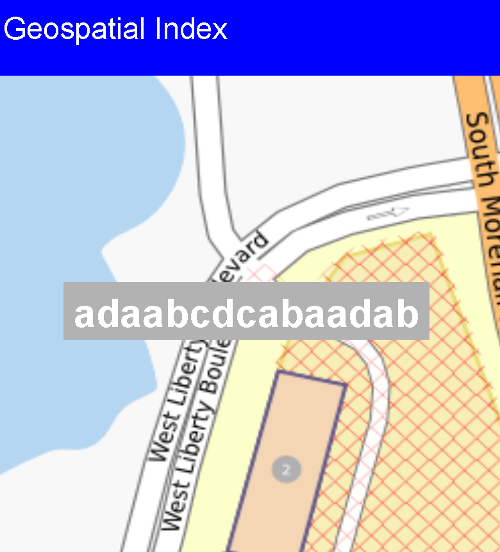
Her er nogle globaler fra projektet XAPI: indekspræsentationen på globalerne:
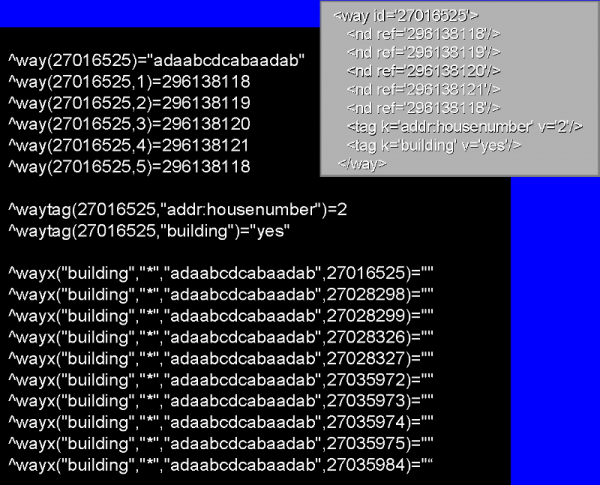
Global ^way brugt til at gemme punkter (veje, små floder osv.) og polygoner (lukkede områder: bygninger, skove osv.).
En grov klassificering af brugen af sparsomme matrixer på globalerne.
- Vi gemmer koordinater for visse objekter og deres tilstande (kortlægning, celleautomater)
- Vi gemmer sparsomme matricer.
I tilfælde 2) ved anmodning om en bestemt koordinat, hvor elementet ikke har tildelt en værdi, skal vi modtage værdien af elementet i den sparsomme matrix som standard.
Bonusserne, som vi modtager ved at gemme flerdimensionale matricer i globalerne
Hurtig sletning og/eller udtræk af rumstykker, der er multipla af rækker, planer, kuber osv. For tilfælde, hvor der bruges heltalsindekser, kan det være nyttigt at have mulighed for hurtig sletning og/eller udtræk af rumstykker, der er multipla af rækker, planer, kuber osv.
Med kommandoen Vi kan slette såvel et enkelt element som en række, og endda et helt plan. Takket være egenskaberne ved globalerne sker dette meget hurtigt — tusinder af gange hurtigere end elementvis sletning.
Illustrationen viser en tredimensionel matrix i globalen ^a og forskellige typer sletninger.
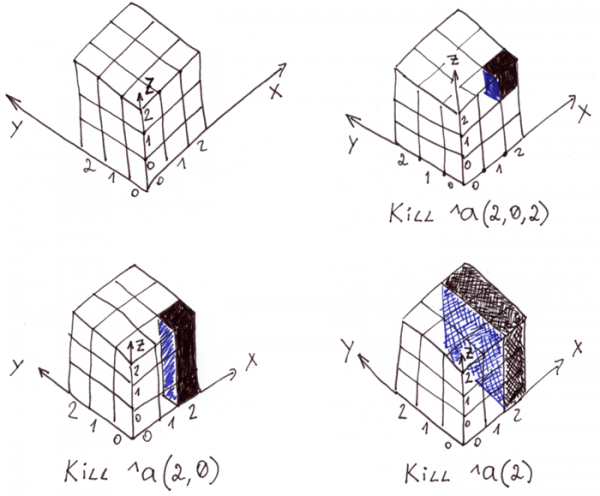
For at udtrække rumstykker efter kendte indekser kan kommandoen anvendes .
Udtræk af matrixkolonne til variablen Column:
; Lad os definere en tredimensional sparsomme matrix 3x3x3
Set ^a(0,0,0)=1,^a(2,2,0)=1,^a(2,0,1)=1,^a(0,2,1)=1,^a(2,2,2)=1,^a(2,1,2)=1
Merge Column = ^a(2,2)
; Vi udskriver variablen Column
Zwrite Column
Output:
Column(0)=1
Column(2)=1
Interessant er det, at variablen Column også endte med at være en sparsomme matrix, som også skal tilgås via , da standardværdierne ikke gemmes i den.
Udtræk af rumstykker kan også gøres gennem et lille program med brug af funktionen . Dette er især praktisk i rum, hvis indekser ikke er kvantiserede (kortlægning).
Konklusion
Nutidens tider stiller nye ambitiøse opgaver. Grafer kan bestå af milliarder af noder, kort kan indeholde milliarder af punkter, og nogen kunne endda ønske at starte deres egen univers på cellulære automater (, ).
Når mængden af data i sparse arrays ikke længere kan rummes i RAM, men det er nødvendigt at arbejde med dem, bør man overveje muligheden for at implementere sådanne projekter på globale og COS.
Tak for din opmærksomhed! Vi ser frem til dine spørgsmål og ønsker i kommentarerne.
Ansvarsfraskrivelse: Denne artikel og mine kommentarer til den er min mening og har ikke noget at gøre med den officielle position fra InterSystems.
Kilde: habr.com
