

Forord eller hvordan idéen til partitionering opstod
Begyndelsen på historien her: Efter at næsten alle ressourcer til optimering af forespørgslen på det tidspunkt var opbrugt, kom spørgsmålet — hvad så nu? Sådan opstod idéen om partitionering.
En lyrisk afstikker:
Netop 'på det tidspunkt', fordi . Tak og Habr !
Så hvordan kan vi yderligere gøre kunden lidt lykkeligere, samtidig med at vi opgraderer vores egne færdigheder?
Hvis vi forenkler det til det yderste, så er der kun to fundamentale måder at forbedre databaseydelsen markant:
1) Ekstensiv metode — vi øger ressourcerne, ændrer konfigurationen;
2) Intensiv metode — optimering af forespørgsler
Da, som jeg gentager, på det tidspunkt var det allerede uklart, hvad der ellers kunne ændres i forespørgslen for at fremskynde den, blev vejen valgt — ændringer i designet af tabellerne.
Så — det store spørgsmål opstår — hvad og hvordan skal vi ændre?
Startbetingelser
For det første er der denne ERD (vist betinget og forenklet):
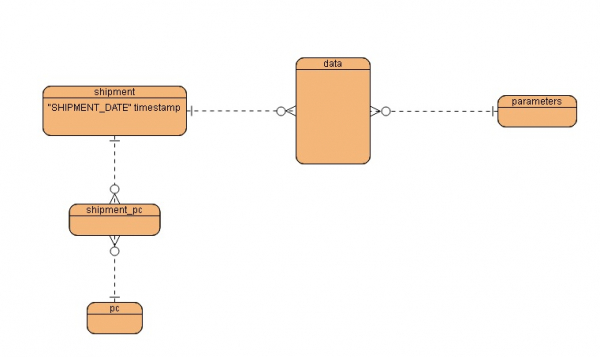
Hovedfunktioner:
- forholdet 'mange til mange'
- tabellen har allerede en potentiel partitioneringsnøgle
Den oprindelige forespørgsel:
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."SPARAM_NAME" AS SPARAM_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN ( SELECT w2."LASERMARK" , MAX(s2."SHIPMENT_DATE") AS "SHIPMENT_DATE"
                          FROM shipment s2 INNER JOIN data w2 ON s2."SHIPMENT_ID" = w2."SHIPMENT_ID"
                          GROUP BY w2."LASERMARK"
                         ) md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
             s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30' ;
Resultater af udførelsen på den testdatabase:
Omkostninger : 502 997.55
Udførelsestid: 505 sekunder.
Hvad ser vi? En almindelig forespørgsel, efter tidsinterval.
Lad os lave en simpel logisk antagelse: hvis der er et udvalg af tidsinterval, vil det hjælpe os? Rigtigt — partitionering.
Hvad skal partitioneres?
Ved første øjekast er valget indlysende — deklarativ partitionering af tabellen "shipment" efter nøglen "SHIPMENT_DATE" (men langt fremme — i sidste ende blev det lidt anderledes i produktion).
Hvordan partitionerer man?
Dette spørgsmål er heller ikke alt for svært. Heldigvis, i PostgreSQL 10, er der nu en menneskelig partitioneringsmekanisme.
Så:
- Vi gemmer et dump af den oprindelige tabel — pg_dump source_table
- Vi sletter den oprindelige tabel — drop table source_table
- Vi opretter en overordnet tabel med partitionering efter interval — create table source_table
- Vi opretter sektioner — create table source_table, create index
- Vi importerer dumpen, der blev lavet i trin 1 — pg_restore
Scripts til partitionering
For enkelhed og bekvemmelighed er trin 2, 3, 4 blevet slået sammen i ét script.
Så:
Vi gemmer et dump af den oprindelige tabel
pg_dump postgres --file=\/dump\/shipment.dmp --format=c --table=shipment --verbose > \/dump\/shipment.log 2>&1Sletter den oprindelige tabel + Opretter en overordnet tabel med partitionering efter interval + Opretter sektioner
--create_partition_shipment.sql
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;
begin
  RAISE NOTICE 'OPRETTELSE AF TEMPORÆR TABEL FOR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'DROP TABLE shipment';
  drop table shipment cascade ;

  CREATE TABLE public.shipment
  (
    "SHIPMENT_ID" integer NOT NULL DEFAULT nextval('shipment_shipment_id_seq'::regclass),
    "SHIPMENT_NAME" character varying(30) COLLATE pg_catalog."default",
    "SHIPMENT_DATE" timestamp without time zone,
    "REPORT_NAME" character varying(40) COLLATE pg_catalog."default"
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
      OIDS = FALSE
  )
  TABLESPACE pg_default;

  RAISE NOTICE 'OPRETTELSE AF PARTITIONER FOR TABEL shipment';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      IF to_number(current_month,'99') = to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         CONTINUE ;
      ELSE
       --NEW borders only for second and after time
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      partition_name := 'shipment_shipment_date_'||begin_year||'-'||begin_month||'-01-'|| next_year||'-'||next_month||'-01'  ;

     EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF shipment FOR VALUES FROM ( %L ) TO ( %L )  ' , current_year||'-'||current_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEX NAVN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      --Drop first time flag
      first_flag := false ;

  END LOOP;

end
$$;
Importer dump
pg_restore -d postgres --data-only --format=c --table=shipment --verbose shipment.dmp > /tmp/data_dump/shipment_restore.log 2>&1Vi kontrollerer resultaterne af sektioneringen
Hvad har vi så som resultat? Den fulde tekst for udførelsesplanen er lang og kedelig, så det er helt rimeligt at begrænse sig til de afsluttende tal.
Var
Omkostninger: 502 997.55
Udførelsestid: 505 sekunder.
Er blevet
Omkostninger: 77 872.36
Udførelsestid: 79 sekunder.
Et ganske godt resultat. Vi har reduceret omkostningerne og udførelsestiden. Sådan set giver brugen af partitionering den ønskede effekt, og generelt – uden overraskelser.
At glæde kunden
Testresultaterne blev præsenteret for kunden til overvejelse. Efter at have set på dem gav de en noget uventet dom: "Fremragende, partitioner tabellen 'data'."
Ja, men vi har jo undersøgt en helt anden tabel 'shipment', tabellen 'data' har ikke feltet 'SHIPMENT_DATE'.
Det er ikke et problem, tilføj, ændr. Det vigtigste er, at kunden er tilfreds med, hvad der kommer ud af det, detaljerne omkring implementeringen er ikke så vigtige.
Vi partitionerer hovedtabellen 'data'
Overordnet set opstod der ikke særlige vanskeligheder. Selvom algoritmen for partitionering selvfølgelig ændrede sig en smule.
Vi tilføjer kolonnen 'SHIPMENT_DATE' til tabellen 'data'
psql -h vært -U database -d bruger
=> ALTER TABLE data ADD COLUMN "SHIPMENT_DATE" timestamp without time zone ;
Vi fylder værdierne i kolonnen 'SHIPMENT_DATE' i tabellen 'data' med værdierne fra den tilsvarende kolonne i tabellen 'shipment'
-----------------------------
--update_data.sql
--opdatering for den ændrede tabel "data" til værdierne af "SHIPMENT_DATE" fra tabellen "shipment"
--version 1.0
do language plpgsql $$
declare
rec_shipment_data RECORD ;
shipment_date timestamp without time zone ;
row_count integer ;
total_rows integer ;
begin

  select count(*) into total_rows from shipment ;
  RAISE NOTICE 'Total %',total_rows;
  row_count:= 0 ;

  FOR rec_shipment_data IN SELECT * FROM shipment LOOP

   update data set "SHIPMENT_DATE" = rec_shipment_data."SHIPMENT_DATE" where "SHIPMENT_ID" = rec_shipment_data."SHIPMENT_ID";

   row_count:=  row_count +1 ;
   RAISE NOTICE 'row count = % , from %',row_count,total_rows;
  END LOOP;

end
$$;
Vi gemmer dumpen af tabellen 'data'
pg_dump postgres --file=\/dump\/data.dmp --format=c --table=data --verbose > \/dump\/data.log 2>&1<\/sourceVi genskaber den partitionerede tabel 'data'
--create_partition_data.sql
--opret partitioner for tabellen "wafer data" efter interval-kolonnen "shipment_data" med en varighed på en måned
--version 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;

begin

  RAISE NOTICE 'OPRET TEMPORÆR TABEL FOR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;


  RAISE NOTICE 'DROP TABLE data';
  drop table data cascade ;


  RAISE NOTICE 'OPRET PARTITIONERET TABEL data';

  CREATE TABLE public.data
  (
    "RUN_ID" integer,
    "LASERMARK" character varying(20) COLLATE pg_catalog."default" NOT NULL,
    "LOTID" character varying(80) COLLATE pg_catalog."default",
    "SHIPMENT_ID" integer NOT NULL,
    "PARAMETER_ID" integer NOT NULL,
    "INTERNAL_VALUE" character varying(75) COLLATE pg_catalog."default",
    "REPORTED_VALUE" character varying(75) COLLATE pg_catalog."default",
    "LOWER_SPEC_LIMIT" numeric,
    "UPPER_SPEC_LIMIT" numeric ,
    "SHIPMENT_DATE" timestamp without time zone
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
    OIDS = FALSE
  )
  TABLESPACE pg_default ;


  RAISE NOTICE 'OPRET PARTITIONER FOR TABELLEN data';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;
  i := 1;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      --Init grænser
      IF   begin_year = '0' THEN
       RAISE NOTICE '***Init grænser';
       first_flag := true ; --første gang flag
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

--      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
--      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
--      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      -- Tjek nuværende dato mod grænserne IKKE for første gang

      RAISE NOTICE 'Nuværende data = %',to_char( to_date( current_year||'.'||current_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Begin data = %',to_char( to_date( begin_year||'.'||begin_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Næste data = %',to_char( to_date( next_year||'.'||next_month, 'YYYY.MM'), 'YYYY.MM');

      IF to_date( current_year||'.'||current_month, 'YYYY.MM') >= to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         RAISE NOTICE '***FORTSÆT';
         CONTINUE ;
      ELSE
       --NYE grænser kun for anden gang og derefter
       RAISE NOTICE '***NYE GRÆNSER';
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;


      END IF;

      IF to_number(current_month,'99') < 10 THEN
        current_month := '0'||current_month ;
      END IF ;

      IF to_number(begin_month,'99') < 10 THEN
        begin_month := '0'||begin_month ;
      END IF ;

      IF to_number(next_month,'99') < 10 THEN
        next_month := '0'||next_month ;
      END IF ;

      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      partition_name := 'data_'||begin_year||begin_month||'01_'||next_year||next_month||'01'  ;

      RAISE NOTICE 'PARTITION NUMMER % , TABEL NAVN =%',i , partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , begin_year||'-'||begin_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      RAISE NOTICE 'INDEX NAVN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      RAISE NOTICE 'INDEX NAVN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEX NAVN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      RAISE NOTICE 'INDEX NAVN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      RAISE NOTICE 'INDEX NAVN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

      --Fjern første gang flag
      first_flag := false ;

  END LOOP;
end
$$;
Vi indlæser dump-filen oprettet i trin 3.
pg_restore -h host -user -d database --data-only --format=c --table=data --verbose data.dmp > data_restore.log 2>&1Opretter en separat sektion for gamle data
---------------------------------------------------
--create_partition_for_old_dates.sql
--opret partitioner til opbevaring af gamle datoer
--version 1.0
DO LANGUAGE plpgsql $$
DECLARE
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;

BEGIN

      SELECT min("SHIPMENT_DATE") AS min_date INTO rec_shipment_date FROM data ;

      RAISE NOTICE 'Gammel dato er %', rec_shipment_date.min_date ;

      partition_name := 'data_old_dates'  ;

      RAISE NOTICE 'PARTITIONNAVN ER %', partition_name;

      EXECUTE FORMAT('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , '1900-01-01' ,
              TO_CHAR(rec_shipment_date.min_date,'YYYY') || '-' || TO_CHAR(rec_shipment_date.min_date,'MM') || '-01'  ) ;

      index_name := partition_name || '_shipment_id_parameter_id_idx';
      EXECUTE FORMAT('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name || '_lasermark_idx';
      EXECUTE FORMAT('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name || '_shipment_id_idx';
      EXECUTE FORMAT('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name || '_parameter_id_idx';
      EXECUTE FORMAT('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name || '_shipment_date_idx';
      EXECUTE FORMAT('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

END
$$;
Endelige resultater:
Var
Omkostninger: 502 997.55
Udførelsestid: 505 sekunder.
Er blevet
Omkostninger: 68 533.70
Udførelsestid: 69 sekunder
Imponerende, ganske imponerende. Og i betragtning af at vi på vejen mere eller mindre har mestret partitioneringsmekanismen i PostgreSQL 10 — Et fremragende resultat.
Lyrisk afstikker
Kan vi gøre det endnu bedre — JA, DET KAN VI!Til dette skal vi bruge MATERIALIZED VIEW.
CREATE MATERIALIZED VIEW LASERMARK_VIEW
CREATE MATERIALIZED VIEW LASERMARK_VIEW
AS
SELECT w."LASERMARK", MAX(s."SHIPMENT_DATE") AS "SHIPMENT_DATE"
FROM shipment s INNER JOIN data w ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
GROUP BY w."LASERMARK" ;

CREATE INDEX lasermark_vw_shipment_date_ind ON lasermark_view USING btree ("SHIPMENT_DATE") TABLESPACE pg_default;
ANALYZE lasermark_view ;
Vi skriver forespørgslen om igen:
Forespørgsel med brug af materialized view
VÆLG
            p."PARAMETER_ID" som parameter_id,
            pc."PC_NAME" som pc_name,
            pc."CUSTOMER_PARTNUMBER" som customer_partnumber,
            w."LASERMARK" som lasermark,
            w."LOTID" som lotid,
            w."REPORTED_VALUE" som reported_value,
            w."LOWER_SPEC_LIMIT" som lower_spec_limit,
            w."UPPER_SPEC_LIMIT" som upper_spec_limit,
            p."TYPE_CALCUL" som type_calcul,
            s."SHIPMENT_NAME" som shipment_name,
            s."SHIPMENT_DATE" som shipment_date,
            ekstrakt(år fra s."SHIPMENT_DATE") som år,
            ekstrakt(måned fra s."SHIPMENT_DATE") som måned,
            s."REPORT_NAME" som report_name,
            p."STC_NAME" som STC_name,
            p."CUSTOMERPARAM_NAME" som customerparam_name
        FRA data w INDRE JOIN shipment s PÅ s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INDRE JOIN parameters p PÅ p."PARAMETER_ID" = w."PARAMETER_ID"
             INDRE JOIN shipment_pc sp PÅ s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INDRE JOIN pc pc PÅ pc."PC_ID" = sp."PC_ID"
             INDRE JOIN LASERMARK_VIEW md PÅ md."SHIPMENT_DATE" = s."SHIPMENT_DATE" OG md."LASERMARK" = w."LASERMARK"
        HVOR
              s."SHIPMENT_DATE" >= '2018-07-01' OG s."SHIPMENT_DATE" <= '2018-09-30';
Og vi får endnu et resultat:
Var
Omkostninger: 502 997.55
Udførelsestid: 505 sekunder
Er blevet
Omkostninger: 42 481.16
Udførelsestid: 43 sekunder.
Selvom dette lovende resultat er vildledende, da præsentationerne skal opdateres. Så den samlede tid til dataindsamling vil ikke rigtig hjælpe. Men som et eksperiment er det ret interessant.
Faktisk, som det viser sig, tak igen og Habr !-
Efterord
Så kunden er tilfreds. Og man skal udnytte situationen.
Ny opgave: Hvad kan vi finde på for at uddybe og udvide?
Og her kommer jeg til at tænke på — folk, vi har faktisk ikke overvågning af vores PostgreSQL databaser.
Ærligt talt, der er en form for overvågning i form af Cloud Watch på AWS, men hvilken nytte har denne overvågning for DBA? Næsten ingen.
Hvis der er en mulighed for at lave noget nyttigt og interessant for os selv, bør man ikke lade den chance gå fra sig ...
FOR
Sådan er vi kommet til det mest interessante:
3. december 2018.
Beslutningen om at påbegynde arbejdet med at undersøge de tilgængelige muligheder for overvågning af PostgreSQL forespørgselsydelse.
Men det er en helt anden historie.
Fortsættelse følger…
Kilde: habr.com
