

Vi vil se på, hvordan Zabbix fungerer med TimescaleDB som backend. Vi viser, hvordan man starter fra bunden, og hvordan man migrerer fra PostgreSQL. Vi vil også fremvise sammenlignende ydeevnetests af de to konfigurationer.
HighLoad++ Sibirien 2019. Sal "Tomsk". 24. juni, 16:00. Resumé og . Den næste HighLoad++ konference finder sted den 6. og 7. april 2020 i Sankt Petersborg. Detaljer og billetter .
Andrej Gushchin (herefter – AG): – Jeg er ingeniør i teknisk support for ZABBIX (herefter – "Zabbix"), træner. Jeg har arbejdet i over 6 år i teknisk support og har direkte erfaring med ydeevne. I dag vil jeg tale om den ydeevne, TimescaleDB kan tilbyde, når man sammenligner med almindelig PostgreSQL 10. Der vil også være nogle introduktioner om, hvordan det hele fungerer.
De vigtigste ydeevneudfordringer: fra indsamling til rensning af data
Lad os starte med, at der er specifikke ydeevneudfordringer, som hvert overvågningssystem møder. Den første ydeevneudfordring er hurtig indsamling og behandling af data.
Et godt overvågningssystem skal hurtigt og til tiden indsamle alle data, behandle dem i henhold til triggerbetingelser, det vil sige behandle dem efter visse kriterier (som varierer fra system til system) og gemme dem i databasen, så disse data kan bruges senere.
Den anden ydeevneudfordring er opbevaring af historik. At opbevare i databasen og have hurtig og nem adgang til de metrikker, der er indsamlet over en bestemt periode. Det vigtigste er, at disse data er lette at få fat i, så de kan bruges i rapporter, diagrammer, triggere og i nogle tærskelværdier til alarmer osv.
Den tredje ydeevneudfordring er rensning af historik, det vil sige når der kommer en dag, hvor du ikke behøver at gemme detaljerede metrikker, der er indsamlet i 5 år (eller endda måneder eller to måneder). Nogle netværksnoder er blevet fjernet, eller nogle hosts er ikke længere nødvendige, fordi de er forældede og ikke længere indsamles. Alt dette skal renses, så din database ikke vokser til en stor størrelse. Og generelt er rensning af historik ofte en alvorlig test for opbevaringssystemet – det påvirker ofte ydeevnen meget.
Hvordan løser man cacheproblemer?
Jeg vil nu tale specifikt om «Zabbix». I «Zabbix» er den første og anden opkald løst ved hjælp af caching.
Indsamling og behandling af data – vi bruger RAM til at gemme alle disse data. Der vil nu blive fortalt mere om disse data.
Der er også en vis caching på databasesiden for de vigtigste forespørgsler – til grafer og andre ting.
Caching på selve Zabbix-serveren: vi har ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Hvad er det?
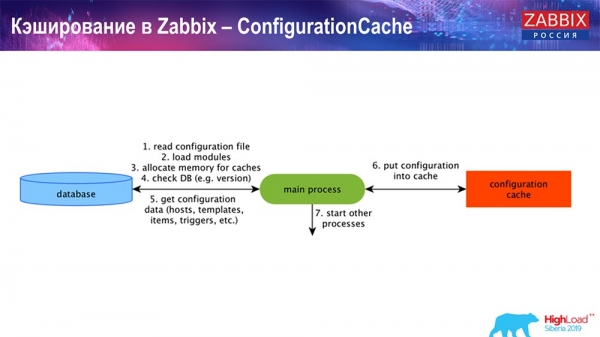
ConfigurationCache er den primære cache, hvor vi gemmer metrics, hosts, dataelementer, triggere; alt hvad der er nødvendigt for at behandle præbehandling, indsamle data, hvilke hosts der skal indsamles fra, og hvor ofte. Alt dette gemmes i ConfigurationCache for ikke at skulle henvende sig til databasen og skabe unødvendige forespørgsler. Efter serverens opstart opdaterer vi denne cache (skaber) og opdaterer det jævnligt (afhængigt af konfigurationens indstillinger).
Caching i Zabbix. Dataindsamling
Her er diagrammet ret omfattende:
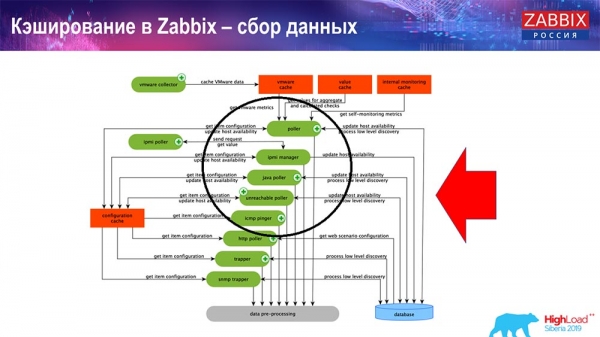
Hovedkomponenterne i diagrammet – de er disse indsamler:
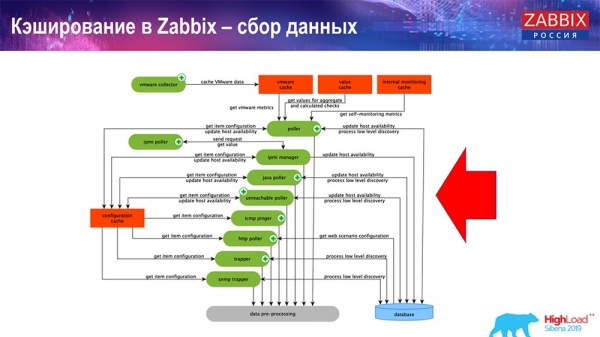
Det er selve indsamleprocesserne, forskellige «pollere», der er ansvarlige for forskellige typer indsamlinger. De indsamler data via icmp, ipmi, forskellige protokoller og sender det hele til præbehandling.
PreProcessing HistoryCache
Hvis vi også har beregnede dataelementer (dem, der er bekendt med «Zabbix», ved det), det vil sige beregnede, aggregationsdataelementer – vi henter dem direkte fra ValueCache. Hvordan den fyldes, vil jeg fortælle om senere. Alle disse indsamler bruger ConfigurationCache til at få deres opgaver og sender derefter til præbehandling.
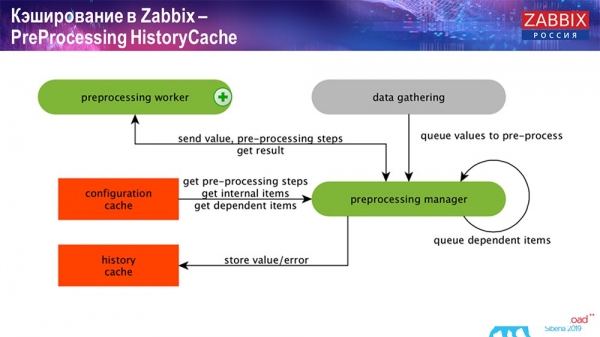
Præbehandling bruger også ConfigurationCache til at modtage præbehandlingstrin, behandler disse data på forskellige måder. Fra version 4.2 er det flyttet til proxyen. Det er meget praktisk, fordi selve præbehandlingen er en ret tung operation. Og hvis du har en meget stor «Zabbix», med mange dataelementer og høj indsamlingfrekvens, letter det arbejdet betydeligt.
Når vi har behandlet disse data på en eller anden måde ved hjælp af præbehandling, gemmer vi dem i HistoryCache for yderligere behandling. Dette afslutter dataindsamlingen. Vi går til hovedprocessen.
Arbejdet History syncer
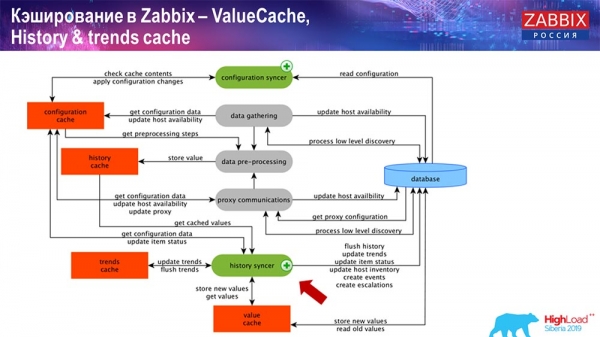
Den primære proces i «Zabbix» (da det er en monolitisk arkitektur) – History syncer. Dette er den primære proces, der håndterer atomisk behandling af hver datapunkt, det vil sige hver værdi:
- en værdi kommer ind (den hentes fra HistoryCache);
- tjekker i Configuration syncer: er der nogle triggere til beregning – beregner dem;
hvis der er – opretter begivenheder, opretter eskalering for at generere en notifikation, hvis det er nødvendigt i henhold til konfigurationen; - registrerer triggere til efterfølgende behandling, aggregering; hvis du aggregerer over den sidste time osv., husker denne værdi ValueCache for ikke at skulle gå til historik tabellen; dermed fyldes ValueCache med de nødvendige data til beregning af triggere, beregnede elementer osv.;
- derefter registrerer History syncer alle data i databasen;
- databasen gemmer dem på disk – her slutter behandlingsprocessen.
Databaser. Caching
På DB-siden, når du vil se grafer eller nogle rapporter om begivenheder, er der forskellige caches. Men inden for denne præsentation vil jeg ikke berøre dem.
For MySQL er der Innodb_buffer_pool, og også en række forskellige caches, der også kan konfigureres.
Men disse er de primære:
- shared_buffers;
- effective_cache_size;
- shared_pool.
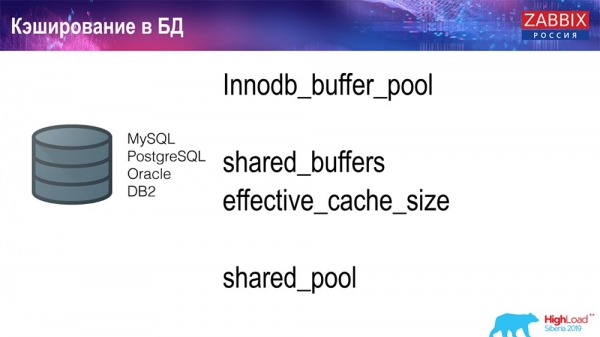
Jeg har angivet, at der er bestemte caches for alle databaser, som gør det muligt at holde de data, der ofte er nødvendige til forespørgsler, i hukommelsen. De har deres egne teknologier til dette.
Om databaseydelse
Der er en konkurrencepræget miljø, hvor «Zabbix»-serveren indsamler data og gemmer dem. Ved genstart læser den også fra historien for at fylde ValueCache osv. Du kan også have scripts og rapporter, der bruger «Zabbix»-API, som er bygget på webgrænsefladen. «Zabbix»-API går ind i databasen og henter de nødvendige data for at få grafer, rapporter eller en liste over begivenheder, de seneste problemer.
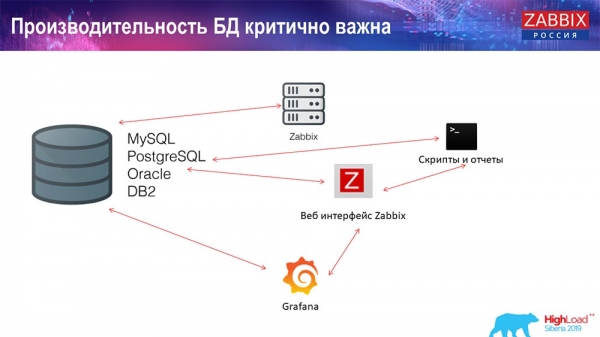
Et meget populært visualiseringsværktøj – er Grafana, som vores brugere anvender. Det kan tilgås direkte både via «Zabbix»-API og databasen. Det skaber også en vis konkurrence for at hente data: en mere finjusteret, god opsætning af databasen er nødvendig for at sikre hurtig levering af resultater og test.
Rydning af historik. I Zabbix findes der en Housekeeper
Den tredje funktion, der anvendes i 'Zabbix', er rydning af historik med hjælp fra Housekeeper. 'Housekeeper' overholder alle indstillinger, hvilket betyder, at vi i datavarianter angiver, hvor meget der skal opbevares (i dage), hvor længe trends skal opbevares, og dynamikken i ændringerne.
Jeg nævnte ikke TrendCache, som vi beregner i realtid: data kommer ind, vi aggregerer dem over en time (primært tal fra den seneste time), det gennemsnitlige/minimale antal, og vi registrerer dette én gang i timen i tabellen for ændringsdynamik ('Trends'). 'Housekeeper' aktiveres og sletter data fra databasen med almindelige SELECTs, hvilket ikke altid er effektivt.
Hvordan forstår man, at det ikke er effektivt? Du kan på grafikkerne for de interne processers ydeevne se dette billede:
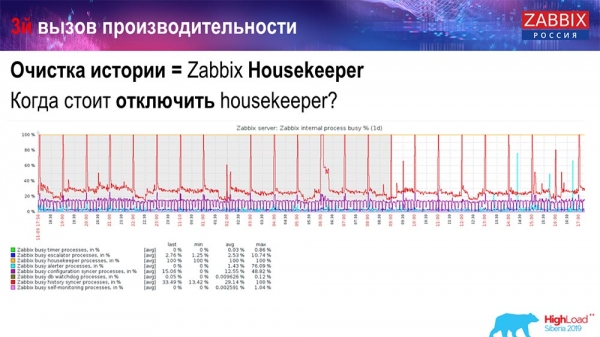
Du har History syncer, som konstant er optaget (den røde graf). Og den 'orange' graf, der løber ovenover. Dette er 'Housekeeper', som aktiveres og venter på, at databasen skal slette alle de rækker, som den har angivet.
Lad os tage en vilkårlig Item ID: det skal fjerne de sidste 5000; selvfølgelig via indekserne. Men normalt er datasættet stort – databasen læser det stadig fra disken og indlæser det i cachen, og det er en meget dyr operation for databasen. Afhængigt af dens størrelse kan det føre til visse ydeevneproblemer.
Du kan deaktivere 'Housekeeper' på en simpel måde – vi har det velkendte webinterface. Indstillingen i Administration general (indstillinger for 'Housekeeper') og vi deaktiverer intern housekeeping for intern historik og trends. Følgelig håndterer 'Housekeeper' ikke længere dette:
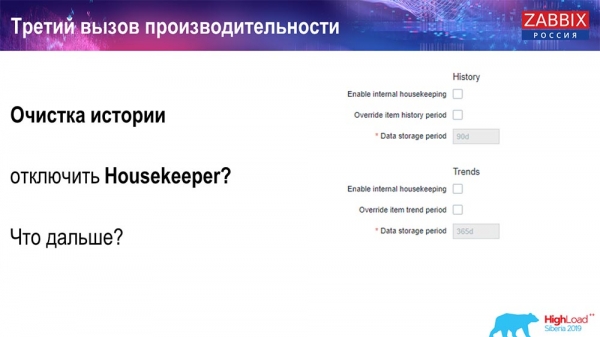
Hvad kan man gøre næste gang? Du har deaktiveret det, og dine grafer er blevet justeret... Hvilke problemer kan der opstå herefter? Hvad kan hjælpe?
Partitionering
Normalt konfigureres dette forskelligt på hver relationel database, som jeg har nævnt. På MySQL findes der sin egen teknologi. Men generelt er de meget ens, når man taler om PostgreSQL 10 og MySQL. Selvfølgelig er der mange interne forskelle i, hvordan det hele er implementeret, og hvordan det påvirker ydeevnen. Men generelt fører oprettelsen af en ny partition ofte også til visse problemer.
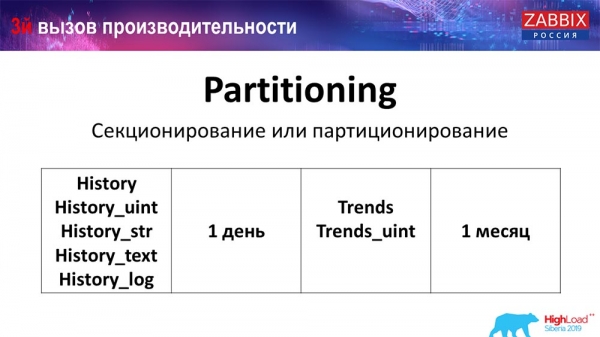
Afhængigt af dit setup (hvor mange data du genererer på en dag), sætter man som regel det mindste - det er 1 dag/partition, og for „trends“, ændringernes dynamik - 1 måned / ny partition. Dette kan ændre sig, hvis du har et meget stort setup.
Lad mig straks fortælle om størrelsen på setup'et: op til 5.000 nye værdier pr. sekund (nvps som det kaldes) - dette betragtes som et lille „setup“. Mellemstore - fra 5.000 til 25.000 værdier pr. sekund. Alt over dette er store og meget store installationer, som kræver omhyggelig tuning af databasen.
På meget store installationer kan 1 dag være suboptimalt. Jeg har personligt set MySQL-partitioner på 40 gigabyte om dagen (og de kan være større). Dette er en meget stor mængde data, som kan føre til problemer. Det skal reduceres.
Hvorfor er partitionering nødvendig?
Hvad partitionering giver, tror jeg, alle ved - det er sektionering af tabeller. Ofte er det separate filer på disken og sporing af forespørgsler. Den vælger mere optimalt én partition, hvis det falder ind under normal partitionering.
For „Zabbix“ anvendes det i særdeleshed efter interval, det vil sige vi bruger timestamps (almindelige tal, tid siden begyndelsen af æraen). Du angiver begyndelsen af dagen / slutningen af dagen, og dette udgør partitionen. Derfor, hvis du forespørger data fra for to dage siden, hentes alt fra databasen hurtigere, fordi det kun er nødvendigt at indlæse én fil i cachen og udlevere den (og ikke en stor tabel).
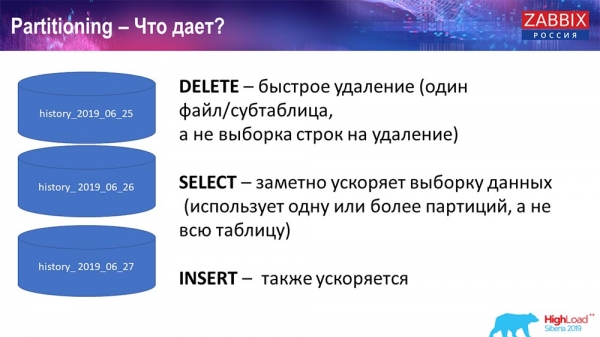
Mange databaser fremskynder også indsættelse (indsættelse i én child-tabel). Mens jeg taler abstrakt, er dette også muligt. Partitionering hjælper ofte.
Elasticsearch til NoSQL
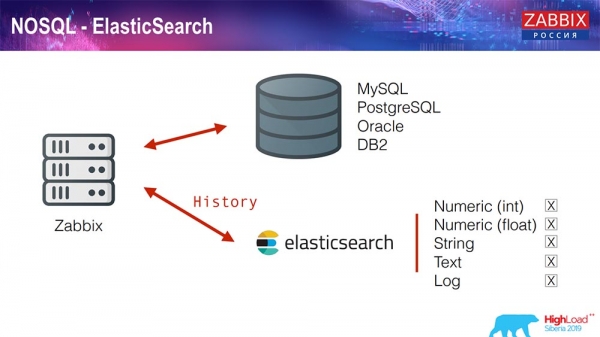
For nylig, i version 3.4, implementerede vi en løsning til NoSQL. Vi tilføjede muligheden for at skrive til Elasticsearch. Du kan skrive forskellige typer: vælg - enten tal, eller nogle symboler; vi har string-tekst, logfiler kan du skrive til Elasticsearch... Derfor vil webgrænsefladen også henvende sig til Elasticsearch. Det fungerer fremragende i visse tilfælde, men i øjeblikket kan det bruges.
TimescaleDB. Hyper-tabeller
For 4.4.2, we noticed one thing about TimescaleDB. What is it? It's an extension for PostgreSQL, meaning it has a native PostgreSQL interface. Additionally, this extension allows for significantly more efficient handling of timeseries data and offers automatic partitioning. Here's how it looks:
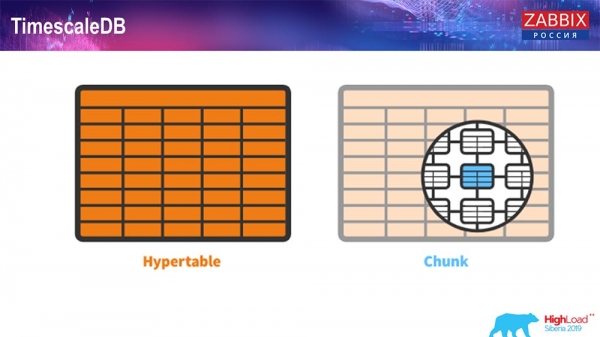
This is a hypertable – a concept in Timescale. This is the hypertable you create, which contains chunks. Chunks are partitions, essentially child tables, if I’m not mistaken. This is really efficient.
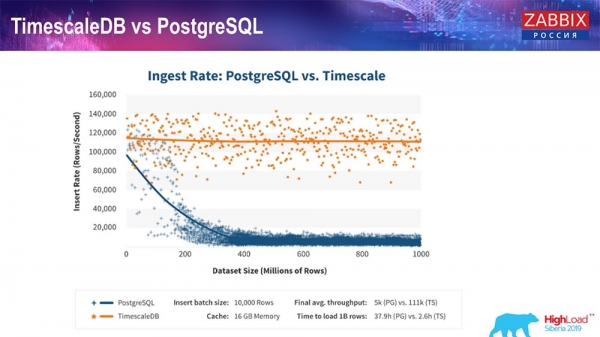
TimescaleDB and PostgreSQL
As the makers of TimescaleDB assure, they employ a more optimal query processing algorithm, particularly for inserts, which maintains near-constant performance even as the size of the dataset increases. Thus, after 200 million rows, regular PostgreSQL starts to degrade severely, losing performance almost to zero, while Timescale allows inserts to be performed as efficiently as possible, regardless of data volume.
How to install TimescaleDB? It's simple!
The documentation provides detailed instructions – you can install it from packages for any systems... It relies on official PostgreSQL packages. You can also compile it manually. It turned out I had to compile it for the database myself.
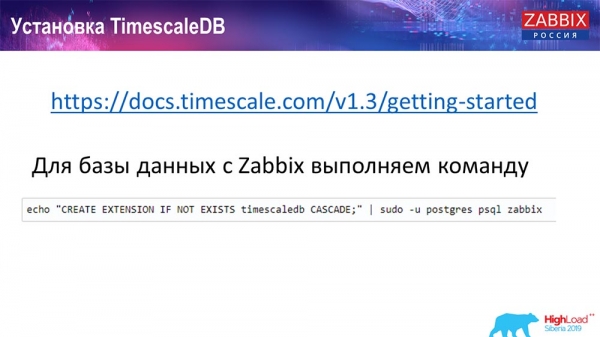
In Zabbix, we just activate the Extension. I believe those who have used Extensions in PostgreSQL know... You simply activate the Extension and create it for the Zabbix database you are using.
And the last step…
TimescaleDB. Migration of history tables
You need to create a hypertable. For this, there is a special function – Create hypertable. The first parameter is the table that needs to be created as a hypertable in this database.
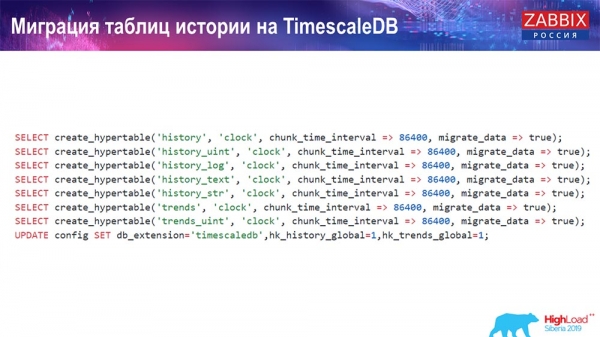
The field by which to create, and chunk_time_interval (this is the interval of chunks (partitions to be used). 86,400 corresponds to one day.
Parameter migrate_data: if you set it to true, it will move all current data into the pre-created chunks.
I used migrate_data myself – it takes a considerable amount of time, depending on the size of your database. I had more than a terabyte – the creation took over an hour. In some test cases, I deleted historical data for text (history_text) and string (history_str) to avoid transferring them – they were not particularly interesting to me.
Og den sidste opdatering, vi laver i vores db_extention: vi installerer timescaledb, så databasen og især vores "Zabbix" forstår, at der er en db_extention. Den aktiverer det og bruger den korrekte syntaks og forespørgsler til databasen ved at benytte de "funktioner", der er nødvendige for TimescaleDB.
Serverkonfiguration
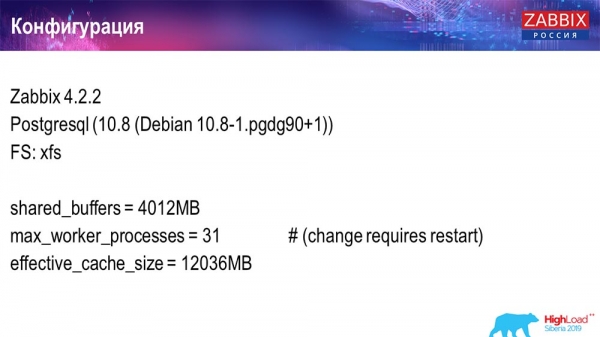
Jeg brugte to servere. Den første server er en virtuel maskine, der er ret lille, med 20 processorer og 16 gigabyte RAM. Jeg har konfigureret den med PostgreSQL 10.8:
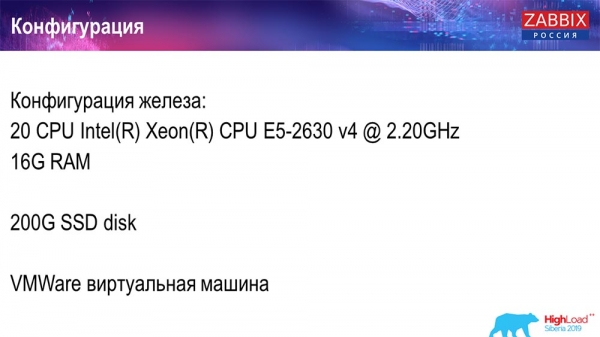
Operativsystemet var Debian, filsystemet – xfs. Jeg lavede minimale indstillinger for udelukkende at bruge denne database, bortset fra at 'Zabbix' vil bruge det. På samme maskine kørte Zabbix-serveren, PostgreSQL og belastningsagenterne.
Jeg brugte 50 aktive agenter, der anvendte LoadableModule, til hurtigt at generere forskellige resultater. De genererede strenge, tal og så videre. Jeg fyldte databasen med en stor mængde data. Oprindeligt indholdt konfigurationen 5.000 datakilder per vært, og hver datakilde indeholdt en trigger – for at skabe en realistisk opsætning. Nogle gange kræver brugen endda mere end én trigger.
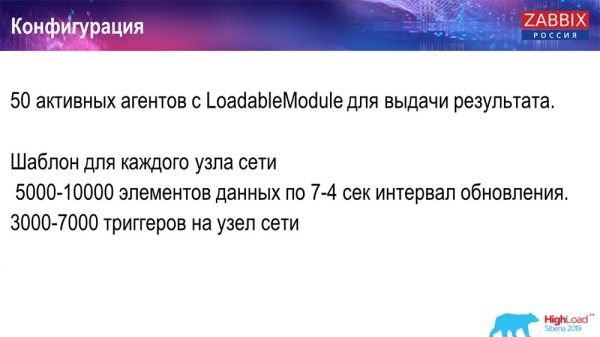
Jeg regulerede opdateringsintervallet og belastningen ved ikke kun at bruge 50 agenter (jeg tilføjede flere), men også ved hjælp af dynamiske datakilder og sænkede opdateringsintervallet til 4 sekunder.
Ydelsestest. PostgreSQL: 36.000 NVP'er
Første kørsel, første opsætning havde jeg på ren PostgreSQL 10 på dette udstyr (35.000 værdier per sekund). Generelt, som det kan ses på skærmen, tager dataindsættelsen brøkdele af et sekund – alt fungerer godt og hurtigt, SSD-diskene (200 gigabyte). Det eneste, jeg kan nævne, er, at 20 GB hurtig bliver fyldt.
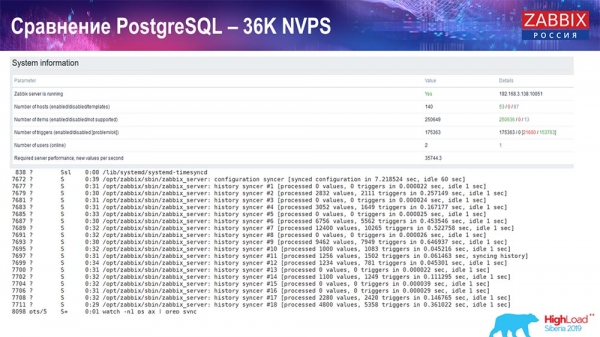
Der vil komme mange flere sådanne grafikker. Det er standard præstationsdashboard for Zabbix-serveren.
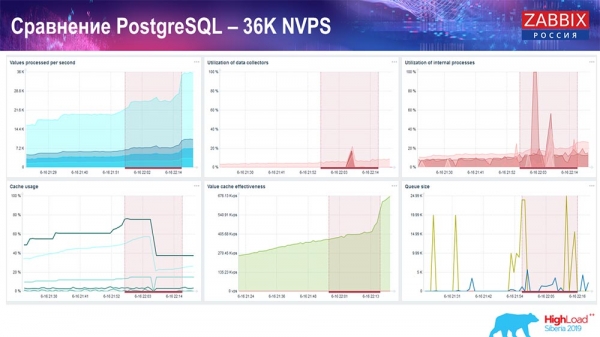
Den første grafik – antallet af værdier per sekund (blå, øverst til venstre), 35.000 værdier i dette tilfælde. Det er (øverst i midten) belastningen af samlingsprocesser, og det er (øverst til højre) belastningen fra interne processer: history syncers og housekeeper, som her (nederst i midten) blev udført i en betydelig tid.
Denne graf (nede i midten) viser brugen af ValueCache – hvor mange hits ValueCache har for triggers (flere tusinde værdier per sekund). En anden vigtig graf er den fjerde (nede til venstre), som viser brugen af HistoryCache, som jeg har nævnt, der fungerer som en buffer før indsættelse i DB.
Ydelsestest. PostgreSQL: 50.000 NVP'er
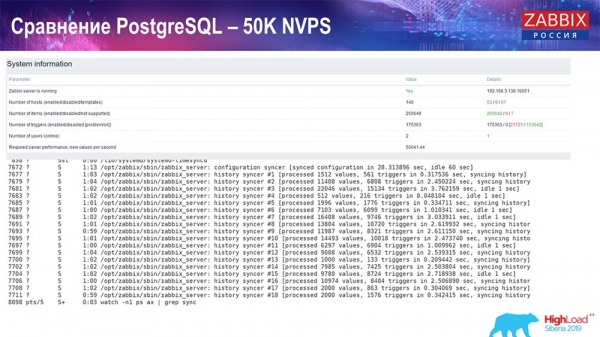
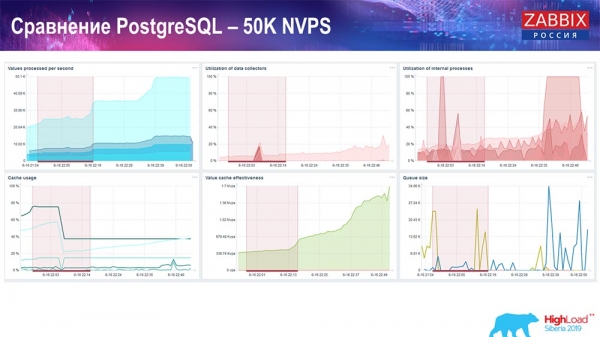
Dernæst øgede jeg belastningen til 50.000 værdier per sekund på det samme udstyr. Ved indlæsning af 'Housekeeper' blev 10.000 værdier allerede skrevet på 2-3 sekunder med beregningen. Det er faktisk vist på det næste screenshot:
'Housekeeper' begynder allerede at forstyrre arbejdet, men generelt er belastningen på history syncers stadig på niveauet 60 % (den tredje graf, øverst til højre). HistoryCache begynder allerede under 'Housekeeper's arbejde at fyldes aktivt (nede til venstre). Den var omkring en halv gigabyte og fyldtes med 20%.
Ydelsestest. PostgreSQL: 80.000 NVP'er
Derefter øgede jeg til 80.000 værdier per sekund:
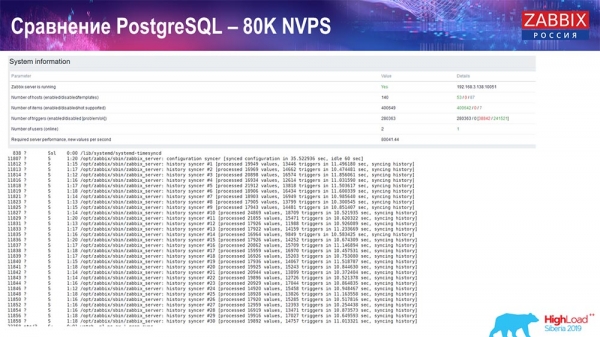
Det var cirka 400.000 dataelementer, 280.000 triggers. Indsættelsen, som du kan se, havde en ganske høj belastning på history syncers (der var 30 af dem). Jeg fortsatte med at ændre forskellige parametre: history syncers, cache… På dette udstyr begyndte belastningen på history syncers at stige til maksimum, praktisk talt 'i hylden' – tilsvarende gik HistoryCache i en meget høj belastning:
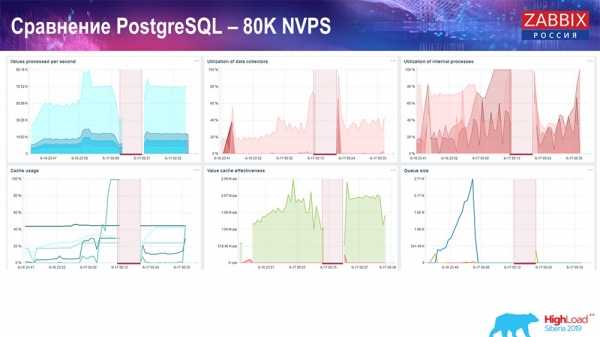
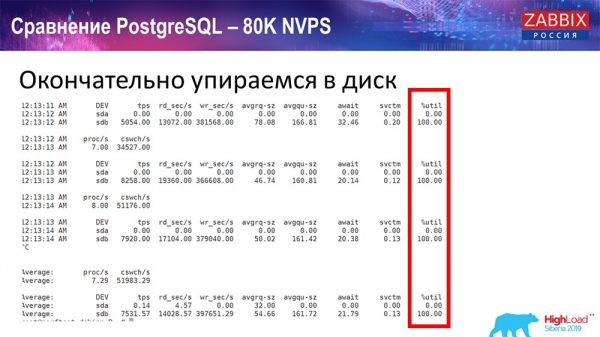
I hele denne tid overvågende jeg alle systemparametre (hvordan CPU'en blev brugt, RAM) og opdagede, at diskudnyttelsen var maksimal – jeg havde opnået den maksimale kapacitet for denne disk på dette udstyr, på denne virtuelle maskine. 'Postgres' begyndte ved sådan intensitet at frigive data ret aktivt, og disken kunne ikke følge med til skrivning, læsning…
Jeg tog en anden server, som allerede havde 48 CPU'er og 128 gigabyte RAM:
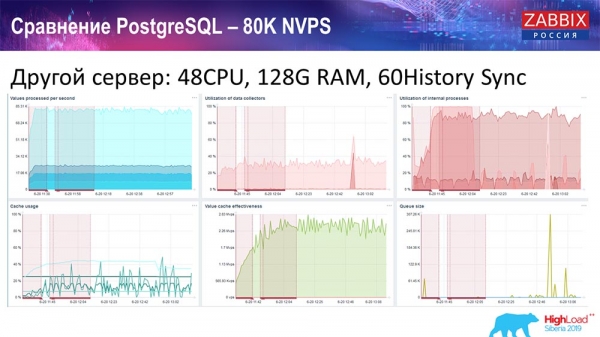
Jeg 'tunede' også den – satte History syncer (60 stk.) og opnåede acceptabel ydeevne. Faktisk er vi ikke 'i hylden', men det er nok grænsen for ydeevne, hvor der allerede skal gøres noget ved det.
Ydelsestest. TimescaleDB: 80.000 NVP'er
Mit hovedmål var at bruge TimescaleDB. På hver graf ses et dyk:
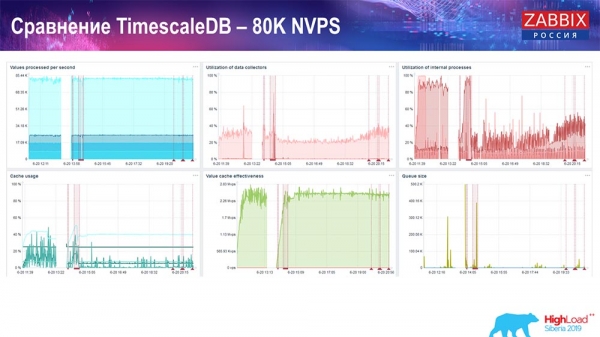
Disse nedbrud er netop datamigrering. Efter dette har profilen for belastning af history-syncere på 'Zabbix'-serveren, som du kan se, ændret sig betydeligt. Den tillader praktisk talt at indsætte data tre gange hurtigere og bruger mindre HistoryCache – dermed vil data blive leveret til dig rettidigt. Igen, 80.000 værdier pr. sekund – det er en ret høj hastighed (selvfølgelig ikke for 'Yandex'). Generelt er dette en ret stor opsætning, med én server.
Ydelsestest af PostgreSQL: 120.000 NVP'er
Derefter forbedrede jeg antal datapunkter til en halv million og fik en beregnet værdi på 125.000 pr. sekund:
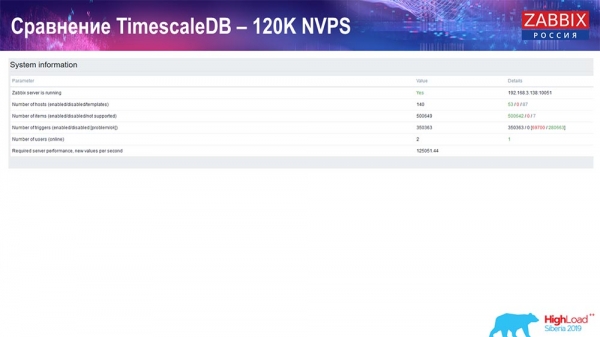
Og jeg fik sådanne grafer:
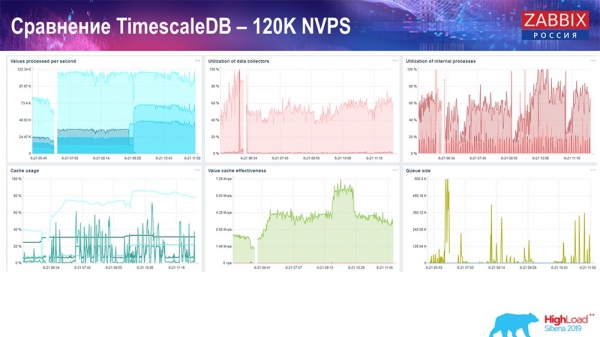
Principielt er dette en fungerende opsætning, den kan køre i længere tid. Men da jeg kun havde en disk på 1,5 terabyte, brugte jeg den op på et par dage. Det vigtigste var, at der samtidig blev oprettet nye partitioner i TimescaleDB, og dette skete helt uset for ydeevnen, hvilket ikke kan siges om MySQL.
Normalt oprettes partitioner om natten, fordi det blokerer for indlæsning og arbejde med tabellerne, hvilket kan føre til degradering af servicen. I dette tilfælde er det ikke tilfældet! Hovedopgaven var at teste mulighederne for TimescaleDB. Resultatet blev: 120.000 værdier pr. sekund.
Der findes også eksempler i 'communities':
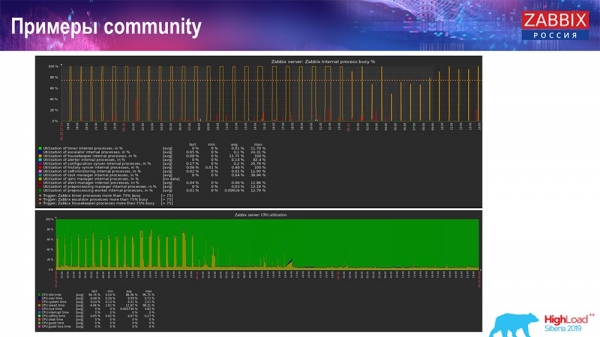
En person aktiverede også TimescaleDB, og belastningen på io.weight faldt på processoren; og brugen af interne proces-elementer blev også reduceret takket være aktiveringen af TimescaleDB. Disse er almindelige HDD'er, dvs. en normal virtuel maskine på almindelige diske (ikke SSD)!
For mindre opsætninger, der er begrænset af diskens ydeevne, virker TimescaleDB, som jeg mener, som en rigtig god løsning. Det tillader en ret god fortsat drift, inden man migrerer til hurtigere hardware til databasen.
Jeg inviterer jer alle til vores arrangementer: Konference – i Moskva, Summit – i Riga. Brug vores kanaler – 'Telegram', forum, IRC. Hvis du har spørgsmål, så kom til vores stand, så kan vi tale om alt.
Spørgsmål fra publikum
Spørgsmål fra publikum (herefter – A): – Hvis TimescaleDB er så nemt at konfigurere, og det giver et så stort præstationsboost, er det så måske bedst at bruge det som en god praksis til at konfigurere «Zabbix» med «Postgres»? Og er der nogen faldgruber eller ulemper ved denne løsning, eller kan jeg bare tage «Postgres», installere «Timescale» og bruge det uden at bekymre mig om problemer?
AG: – Ja, jeg vil sige, at det er en god anbefaling at bruge «Postgres» med det samme sammen med TimescaleDB-udvidelsen. Som jeg allerede har nævnt, er der mange gode anmeldelser, selvom denne «funktion» er eksperimentel. Men faktisk viser tests, at det er en fremragende løsning (med TimescaleDB), og jeg tror, det vil udvikle sig! Vi følger med i, hvordan denne udvidelse udvikler sig, og vil justere det, der er nødvendigt.
Vi har endda i udviklingen bygget videre på en af deres kendte «funktioner»: der kunne man arbejde lidt anderledes med chunks. Men så fjernede de det i den næste udgave, og vi måtte ikke længere bygge på den kode. Jeg ville anbefale at bruge denne løsning på mange opsætninger. Hvis du bruger MySQL… fungerer enhver løsning fint for mellemstore opsætninger.
A: – På de seneste diagrammer, der kommer fra community'et, var der et diagram med «Housekeeper»:
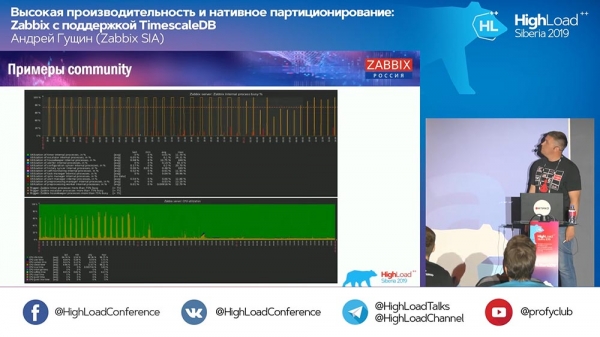
Han fortsatte med at arbejde. Hvad gør «Housekeeper» med TimescaleDB?
AG: – Lige nu kan jeg ikke sige det præcist – jeg vil kigge på koden og give dig en mere detaljeret svar. Han bruger forespørgsler fra TimescaleDB ikke til at slette chunks, men på en eller anden måde aggregere. Indtil videre er jeg ikke klar til at svare på dette tekniske spørgsmål. På standen vil vi få det præciseret i dag eller i morgen.
A: – Jeg har et lignende spørgsmål – om ydeevnen ved sletning i «Timescale».
A (svar fra publikum): – Når du sletter data fra tabellen, hvis du gør det via delete, skal du gennemgå tabellen – slette, rydde, markere alt til fremtidig vakuum. I «Timescale», da du har chunks, kan du droppe. Groft sagt siger du bare til filen, der ligger i big data: «Slet!»
«Timescale» forstår simpelthen, at den chunk ikke længere eksisterer. Da det integreres i forespørgselsplanlæggeren, fanger det dine betingelser i select'en eller i andre operationer og forstår med det samme, at denne chunk ikke længere er der – «Jeg går ikke derhen igen!» (data mangler). Det er alt! Det vil sige, at scanning af tabellen erstattes af sletning af binærfilen, så det er hurtigt.
A: – Vi har allerede berørt emnet omkring ikke-SQL. Så vidt jeg forstår, har «Zabbix» ikke meget brug for at ændre data, og alt dette er lidt ligesom en log. Kan man bruge specialiserede databaser, som ikke kan ændre deres data, men som til gengæld er meget hurtigere til at gemme, akkumulere og returnere – Clickhouse, for eksempel noget kafka-lignende?.. Kafka er jo også en log! Kan man integrere dem på en eller anden måde?
AG: – Eksport kan gøres. Vi har en bestemt «funktion» fra version 3.4: du kan skrive i filer alle historiske filer, events og alt andet; og derefter sende det til enhver anden database med en eller anden behandler. Faktisk er der mange, der omskriver og skriver direkte til databasen. History-synkere skriver dette direkte til filer, roterer disse filer og så videre, og det kan du overføre til «Clickhouse». Jeg kan ikke sige noget om planer, men muligvis vil yderligere støtte af NoSQL-løsninger (som «Clickhouse») fortsætte.
A: – Altså, kan man helt undgå PostgreSQL?
AG: – Selvfølgelig, den sværeste del i «Zabbix» er de historiske tabeller, som skaber størst problemer, og events. I dette tilfælde, hvis du ikke vil opbevare events i lang tid og opbevarer historien med trends i et andet hurtigt lager, så vil der generelt ikke være nogen problemer, tænker jeg.
A: – Kan du vurdere, hvor meget hurtigere alt vil fungere, hvis vi går over til «Clickhouse», for eksempel?
AG: – Jeg har ikke testet. Jeg mener, at man kan opnå i hvert fald de samme resultater ret nemt, idet «Clickhouse» har sit eget interface, men jeg kan ikke sige det entydigt. Det er bedst at teste. Alt afhænger af konfigurationen: hvor mange hosts du har, og så videre. Indsættelse er én ting, men man skal også hente disse data – med Grafana eller noget lignende.
A: – Så det drejer sig om lige konkurrence, og ikke et stort forspring for disse hurtige databaser?
AG: – Jeg tror, når vi integrerer, vil der være mere præcise tests.
A: – Hvad skete der med den gode gamle RRD? Hvad fik os til at skifte til SQL-databaser? Oprindeligt blev alle målinger indsamlet i RRD.
AG: – I "Zabbix" var RRD muligvis kun i en meget gammel version. Der har altid været SQL-databaser – den klassiske tilgang. Den klassiske tilgang er MySQL, PostgreSQL (som allerede eksisterer i lang tid). Vi har et fælles interface til SQL-databaser, og vi har stort set aldrig brugt RRD.

Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
