

Alle taler om udviklings- og testprocesser, uddannelse af medarbejdere, motivation, men disse processer er ikke nok, når et minuts nedetid for servicen koster astronomiske beløb. Hvad skal man gøre, når man foretager finansielle transaktioner under strenge SLA'er? Hvordan øger man pålideligheden og fejltolerance af sine systemer uden at inddrage udvikling og test?
Den næste HighLoad++ konference finder sted den 6. og 7. april 2020 i Sankt Petersborg. Detaljer og billetter findes på . 9. november, kl. 18:00. HighLoad++ Moskva 2018, sal "Delhi + Kolkata". Noter og .
Evgeny Kuzovlev (nedenfor – EK): – Venner, hej! Mit navn er Kuzovlev Evgeny. Jeg er fra firmaet EcommPay, det specifikke afdeling – EcommPay IT, IT-afdelingen i koncernen. Og i dag vil vi tale om nedetid – hvordan man undgår det, og hvordan man minimerer konsekvenserne, hvis det ikke kan undgås. Emnet er: "Hvad skal man gøre, når et minuts nedetid koster 100.000 dollars"? Tallet vil i vores tilfælde, spoiler alert, være sammenligneligt.
Hvad beskæftiger EcommPay IT sig med?
Hvem er vi? Hvorfor står jeg her foran jer? Hvorfor har jeg ret til at fortælle jer noget her? Og hvad vil vi være mere detaljerede omkring?
EcommPay gruppen er en international betalingsudbyder. Vi behandler betalinger over hele verden – i Rusland, Europa, Sydøstasien (Overalt i verden). Vi har 9 kontorer, 500 ansatte i alt, og cirka halvdelen af dem er IT-specialister. Alt, hvad vi gør, alt, hvad vi tjener penge på, det har vi lavet selv.
Alle vores produkter (og vi har mange nok – i vores sortiment af store IT-produkter har vi omkring 16 forskellige komponenter) har vi skrevet selv; vi skriver selv, og vi udvikler selv. Og i øjeblikket foretager vi omkring en million transaktioner om dagen (millioner – det er nok en korrekt måde at beskrive det). Vi er en relativt ung virksomhed – vi er kun omkring seks år gamle.
For 6 år siden var det et startup, da folk kom sammen med forretningen. De var forenet af en idé (der var ikke andet end idéen), og så løb vi. Ligesom ethvert startup løb vi hurtigere... For os var hastighed vigtigere end kvalitet.
På et tidspunkt stoppede vi op: vi indså, at vi ikke længere kunne leve med den hastighed og kvalitet. Vi måtte prioritere kvaliteten. På det tidspunkt besluttede vi at udvikle en ny platform, der ville være korrekt, skalerbar og pålidelig. Vi begyndte at skrive denne platform (investere, udvikle, teste), men indså på et tidspunkt, at udvikling og test ikke tillod os at nå et nyt kvalitetsniveau for vores service.
Du lancerer et nyt produkt, men alligevel vil der altid ske noget uventet. I dag vil vi tale om, hvordan man når et nyt kvalitetsniveau (det er vores erfaring), hvor udvikling og test ikke er i fokus; vi vil tale om, hvad driftsafdelingen kan gøre selv, og hvad den kan tilbyde testen for at påvirke kvaliteten.
Nedetider. Driftsprincipper.
Den grundlæggende hjørnesten, som vi i dag vil tale om, er nedetid. Et skræmmende ord. Hvis vi oplever nedetid, så er alt galt. Vi løber for at genoprette det, administratorerne holder serveren – lad os håbe, den ikke falder, som der synges i sangen. Dette vil vi tale om i dag.
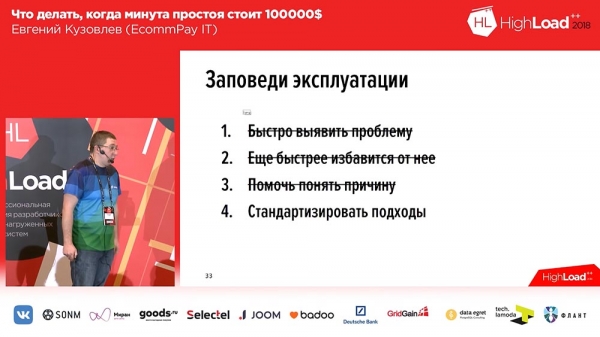
Da vi begyndte at ændre vores tilgange, definerede vi 4 principper. De er præsenteret på slides:
Disse principper er relativt enkle:
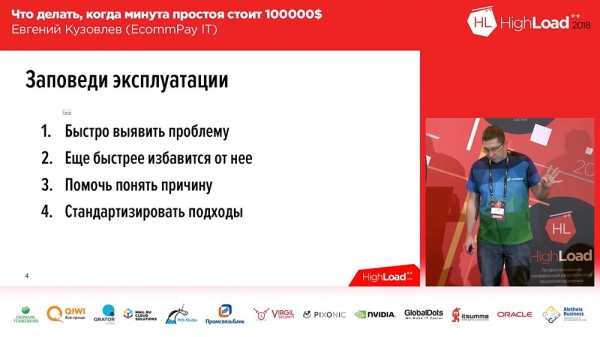
- Hurtigt identificere problemet.
- Endnu hurtigere fjerne det.
- Hjælpe med at forstå årsagen (senere, for udviklerne).
- Og standardisere tilgange.
Jeg vil gerne fremhæve punkt nr. 2. Vi fjerner problemet, ikke løser det. At løse er sekundært. For os er det primære, at brugeren er beskyttet mod dette problem. Det vil eksistere i et eller andet isoleret miljø, men dette miljø vil ikke interagere med brugeren. Vi vil gennemgå disse fire grupper af problemer (nogle dybere, andre mindre dybtgående), jeg vil fortælle, hvad vi bruger, hvad vores erfaring er med løsninger.
Problemløsning: hvornår de opstår, og hvad man skal gøre ved dem?
Men begynder vi ikke i rækkefølge, men med punkt nr. 2 – hvordan man hurtigt slipper af med problemet? Der er et problem – vi skal løse det. "Hvad skal vi gøre med det?" – det er det centrale spørgsmål. Og når vi begyndte at tænke over, hvordan vi kunne løse problemet, udviklede vi nogle krav, som problemløsningen skulle følge.
For at formulere disse krav besluttede vi at stille os selv spørgsmålet: "Hvornår opstår der problemer for os"? Og det viste sig, at problemer opstår i fire tilfælde:
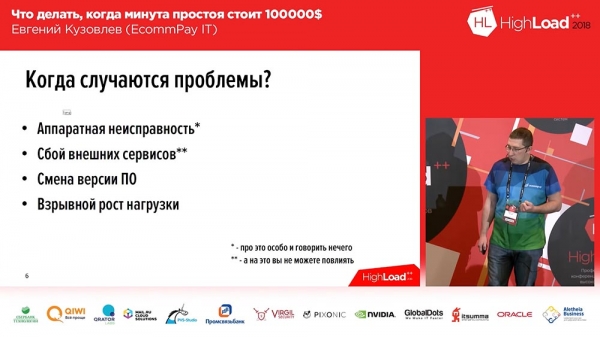
- Hardwarefejl.
- Uheld i eksterne tjenester.
- Ændring af softwareversion (den såkaldte deployment).
- Eksplosiv vækst i belastning.
Vi vil ikke tale om de første to. Hardwarefejl løses ret enkelt: alt bør være duplikeret. Hvis det er diske, skal diske være samlet i RAID, hvis det er servere – serverne skal være duplikeret, hvis det er dit netværk – du skal sætte en anden kopi af netværksinfrastrukturen, så du tager og duplikerer. Og hvis noget fejler, skifter du til nødstrøm. Her er der ikke meget mere at sige.
Det andet – er uheld i eksterne tjenester. For de fleste systemer er dette slet ikke et problem, men ikke for os. Da vi behandler betalinger, er vi en aggregator, der står mellem brugeren (som indtaster sine kortoplysninger) og bankerne, betalingssystemer ("Visa", "MasterCard", "Mir" osv.). Vores eksterne tjenester (betalingssystemer, banker) har en tendens til at fejle. Hverken vi eller du (hvis du har sådanne tjenester) kan påvirke det.
Hvad skal man så gøre? Her er der to muligheder. For det første, hvis du kan, bør du duplikere denne tjeneste på en eller anden måde. For eksempel, hvis vi kan, flytter vi trafikken fra én tjeneste til en anden: hvis vi for eksempel behandler kort via "Sberbank", og "Sberbank" har problemer – så overfører vi trafikken [hypotetisk] til "Raiffeisen". For det andet, hvad vi kan gøre – er at meget hurtigt opdage fejl i eksterne tjenester, og derfor vil vi tale om reaktionstiden i næste del af præsentationen.
Af de fire punkter kan vi konkret påvirke opdatering af softwareversioner – gøre handlinger, der fører til forbedringer i forhold til deployment og i forhold til den eksplosive vækst i belastning. Det er præcist det, vi har gjort. Her, igen, en lille bemærkning…
Af disse fire problemer kan flere løses straks, hvis du har cloud. Hvis du bruger 'Microsoft Azure', 'Ozon', vores clouds fra 'Yandex' eller 'Mail', bliver hardwarefejl i det mindste deres problem, og så har du straks en god situation i forhold til hardwarefejl.
Vi er en smule unormale som virksomhed. Her taler alle om 'Kubernetes', om clouds – vi har hverken 'Kubernetes' eller clouds. Men vi har servere med hardware i mange datacentre, og på dette hardware må vi leve, vi er nødt til at tage ansvar for det hele. Så i denne kontekst vil vi tale om problemer. De første to lader vi ligge.
Opdatering af softwareversion. Grundlag
Vores udviklere har ikke adgang til produktionen. Hvorfor er det sådan? Fordi vi er certificerede i henhold til PCI DSS, og udviklere har ikke ret til at roame i 'prod'. Punktum. Overhovedet. Derfor slutter udviklernes ansvar nøjagtigt i det øjeblik, udviklingen overfører build til release.
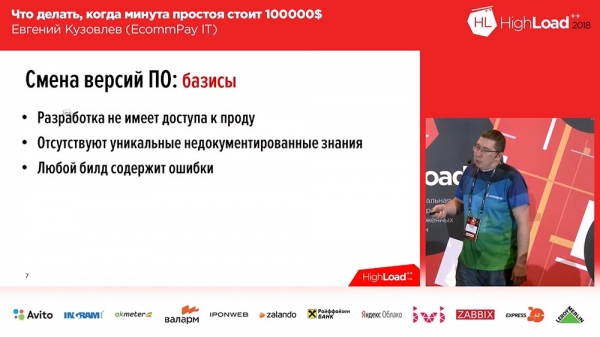
Det andet grundlag, vi har, og som også hjælper os meget – er, at der ikke findes unikke, udelte viden. Jeg håber, du har det på samme måde. For hvis ikke, vil du få problemer. Problemerne opstår, når de unikke, ikke-dokumenterede viden ikke er til stede på det rette tidspunkt og sted. Lad os sige, at én person ved, hvordan man deployerer en specifik komponent – hvis denne person ikke er til stede, da han er på ferie eller syg – så har du problemer.
Og det tredje grundlag, vi er kommet til. Vi er kommet til det gennem smerte, blod, tårer – vi er kommet til den erkendelse, at hver af vores builds indeholder fejl, selvom der ikke skulle være nogen. Vi har besluttet, at når vi deployerer noget, når vi sender noget ud i produktion – er vores build med fejl. Vi har dannet kravene, som vores system skal opfylde.
Krav til opdatering af softwareversion
Der er tre krav:
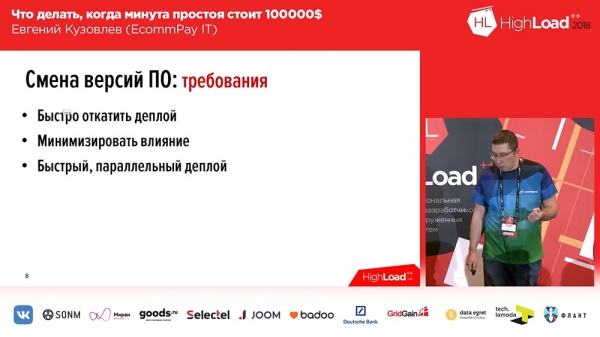
- Vi skal hurtigt kunne rulle deployment tilbage.
- Vi skal minimere indflydelsen af en mislykket deployment.
- Og vi skal have mulighed for hurtigt at kunne deployere parallelt.
Præcis i den rækkefølge! Hvorfor? Fordi hastigheden ikke er vigtig, når du deployer en ny version, men hvis der opstår problemer, er det vigtigt hurtigt at kunne rulle tilbage og minimere påvirkningen. Men hvis du har et sæt versioner i produktion, som indeholder en fejl (som et lyn fra en klar himmel, ingen deploy er sket, men fejlen er til stede) - så er hastigheden på den efterfølgende deploy vigtig. Hvad har vi gjort for at imødekomme disse krav? Vi har anvendt en metodologi:
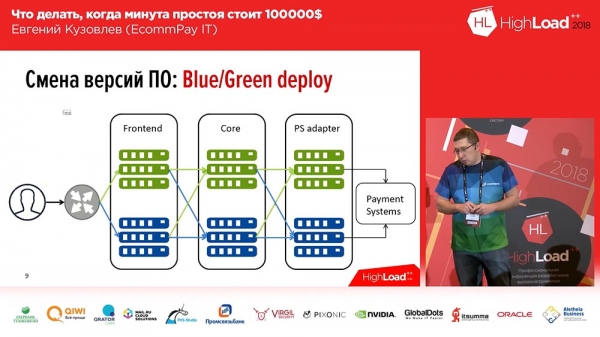
Den er ret kendt, vi har ikke opfundet den – det er Blue/Green deploy. Hvad er det? For hver gruppe servere, hvor dine applikationer kører, skal du have en kopi. Kopien er "varm": der er ikke trafik på den, men i hvilken som helst situation kan trafikken sendes til denne kopi. Denne kopi indeholder den tidligere version. Og i deploy-momentet ruller du koden ud på den inaktive kopi. Derefter skifter du en del af trafikken (eller hele delen) til den nye version. For at ændre trafikflowet fra den gamle version til den nye, skal du kun foretage en enkelt handling: du skal ændre balancereren upstream, ændre retningen – fra en upstream til en anden. Det er meget praktisk og løser problemet med hurtig skiftning og hurtig tilbageførsel.Her er løsningen på det andet spørgsmål – minimalisering: du kan sende kun en del af din trafik til den nye linje, linjen med den nye kode (lad os f.eks. sige 2%). Og disse 2% er ikke 100%! Hvis du mister 100 % af trafikken ved en mislykket deploy – det er skræmmende, hvis du mister 2% af trafikken – det er surt, men det er ikke skræmmende. Desuden vil brugerne sandsynligvis ikke engang bemærke det, fordi i nogle tilfælde (ikke alle) vil den samme bruger, når de trykker F5, komme til en anden, fungerende version.
Blue/Green deploy. Routing
Men ikke alt er så simpelt med "Blue/Green deploy"… Alle vores komponenter kan opdeles i tre grupper:
- det er frontend (betaling sider, som vores kunder ser);
- kernen af behandlingen;
- adapteren til at arbejde med betalingssystemer (banker, "MasterCard", "Visa"…).
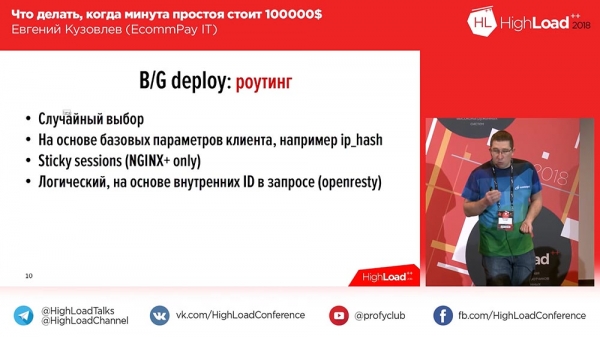
Og her er der en nuance – nuancen handler om routing mellem linjerne. Hvis du bare skifter 100% af trafikken, har du ikke disse problemer. Men hvis du vil skifte 2%, så opstår der spørgsmål: 'Hvordan gør man det?' Det simpleste, lige i ansigtet: du kan indstille det til tilfældig valg, Round Robin i nginx, og så har du 2% – til venstre, 98% – til højre. Men det passer ikke altid.
For os interagerer brugeren for eksempel med systemet ikke med én anmodning. Det er normalt: 2, 3, 4, 5 anmodninger – du kan have systemer, der er ligesådan. Og hvis det er vigtigt for dig, at alle anmodninger fra brugeren kommer til den samme linje, som den første anmodning kom til, eller (det andet punkt) at alle anmodninger fra brugeren kommer til en ny linje efter skiftet (brugeren kunne have begyndt at arbejde med systemet før skiftet) – så passer denne tilfældige fordeling ikke til dig. Så er der følgende muligheder:
Den første mulighed, den simpleste – baseret på brugerens grundlæggende parametre (IP Hash). Du har en IP, og du opdeler til højre-venstre baseret på IP-adressen. Så vil det fungere som det andet scenarie, jeg har beskrevet, hvor der er sket en deployment, brugeren allerede kunne begynde at arbejde med dit system, og fra tidspunktet for deployment vil alle anmodninger gå til den nye linje (til den samme, lad os sige).Hvis dette af en eller anden grund ikke passer dig, og du nødvendigvis skal sende anmodninger til den linje, som den primære, indledende anmodning fra brugeren kom til, så har du to muligheder…
Den første mulighed: du kan tage en betalt nginx+. Der findes en mekanisme for Sticky sessions, som ved den primære anmodning fra brugeren opretter en session for brugeren og knytter den til en eller anden upstream. Alle efterfølgende anmodninger fra brugeren i løbet af sessionens levetid vil blive sendt til den samme upstream, som sessionen blev tildelt.Det fungerede ikke for os, fordi vi allerede havde almindelig nginx. At skifte til nginx+ – det er ikke, fordi det er dyrt, det var mere smertefuldt for os og ikke helt rigtigt. 'Sticky sessions' fungerede ikke for os, fordi de simpelthen ikke giver mulighed for at route efter 'Enten-eller'. Der kan man indstille, at vi laver 'Sticky sessions', for eksempel baseret på IP-adressen eller på IP-adressen og cookies eller på postparametre, men 'Enten-eller' – der er det allerede mere kompliceret.
Derfor er vi kommet frem til den fjerde mulighed. Vi har taget nginx på "steroider" (det er openresty) – det er det samme nginx, der yderligere understøtter inkludering af last-scripts. Du kan skrive et last-script, indsætte det i denne "openresty", og dette last-script vil blive udført, når der kommer en brugerforespørgsel.
Og vi har faktisk skrevet sådan et lille script, sat openresty op, og i dette script gennemgår vi 6 forskellige parametre ved konkatenering med "eller". Afhængig af tilstedeværelsen af den eller den anden parameter ved vi, at brugeren er kommet til den ene eller den anden side, til den ene eller den anden linje.
Blue/Green deploy. Fordele og ulemper
Selvfølgelig kunne man måske have gjort det lidt simplere (bruge de samme "Sticky Sessions"), men vi har også det aspekt, at der ikke kun er brugeren, der interagerer med os i løbet af en enkelt rækkefølge... Men der interagerer også betalingssystemerne med os: efter vi har behandlet transaktionen (ved at sende en forespørgsel til betalingssystemet), modtager vi et callback.
Og lad os sige, at hvis vi kan sende brugerens IP-adresse i alle forespørgsler inde i vores netværk og basere opdelingen på bruger-IP-adressen, så vil vi ikke sige til den samme "Visa": "Hej folk, vi er en slags retro-virksomhed, vi er nogenlunde internationale (på websitet og i Rusland)... Men kunne I sende os brugerens IP-adresse i et yderligere felt, jeres standardiserede protokol!" Det er klart, de vil ikke gå med til det.
Derfor passede det ikke til os – vi lavede openresty. Så vores routing ser således ud:Blue/Green deploy har naturligvis sine fordele, som jeg allerede har nævnt, og sine ulemper.
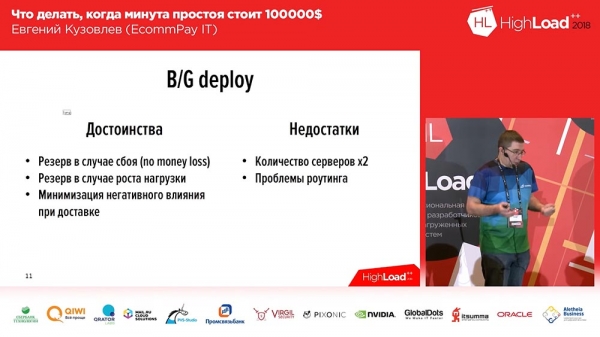
Der er to ulemper:
- du skal have styr på routingen;
- den anden hovedulempe er omkostningerne.
Du skal have to gange så mange servere, du skal have to gange så mange driftsressourcer, og du skal bruge to gange så meget kræfter på at holde hele denne zoologiske have ved lige.
Forresten, blandt fordelene er der endnu en ting, jeg ikke har nævnt: du har en backup i tilfælde af stigende belastning. Hvis du oplever en eksplosiv stigning i belastningen, og mange brugere kommer ind, så aktiverer du bare den anden linje med en fordeling på 50/50 – og så har du straks dobbelte servere i dit cluster, indtil du løser problemet med serverne.
Hvordan laver man en hurtig deployment?
Vi har talt om, hvordan man kan minimere problemer og hurtigt rulle tilbage, men spørgsmålet står tilbage: 'Hvordan kan man deployere hurtigt'?
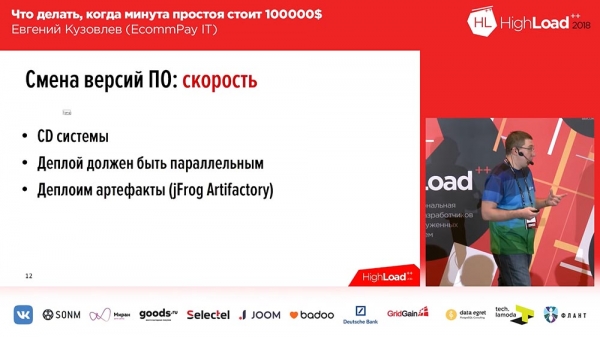
Her er det kort og enkelt.- Du skal have et CD-system (Continuous Delivery) – uden det kommer du ikke langt. Hvis du har én server, kan du deployere manuelt. Vi har cirka halvandet tusinde servere, og manuelle deployment er selvfølgelig ikke en mulighed – vi ville skulle ansætte et team på størrelse med denne sal, kun for at foretage deployment.
- Deployment skal være parallelt. Hvis dit deployment er sekventielt, så er det skidt. Én server – det går, men deployerer du halvandet tusinde servere, vil det tage hele dagen.
- Igen, for at fremskynde processen, er det måske ikke nødvendigt. Ved deployment udføres der normalt en projektbygning. Har du et webprojekt, er der frontendent delen (du laver webpack, samlet med npm – noget i den retning), og denne proces tager grundlæggende ikke lang tid – måske 5 minutter, men disse 5 minutter kan være kritiske. Derfor gør vi for eksempel ikke på den måde: vi har fjernet de 5 minutter, vi deployerer artefakter.
Hvad er et artefakt? Et artefakt er en samlet bygning, hvor hele byggeprocessen allerede er udført. Dette artefakt opbevarer vi i et artefaktlager. Tidligere havde vi to sådanne lagre – Nexus og nu jFrog Artifactory. Vi brugte oprindeligt 'Nexus', fordi vi begyndte at praktisere denne tilgang i Java-applikationer (den var velegnet til dette). Senere inkluderede vi også nogle applikationer skrevet i PHP; og 'Nexus' var ikke længere passende, så vi valgte jFrog Artifactory, som kan håndtere næsten alt. Vi kom endda til det punkt, at vi opbevarer egne binære pakker, som vi samler til serverne, i dette artefaktlager.
Eksplosiv stigning i belastningen
Vi har talt om at skifte version af softwaren. Det næste, vi har, er en eksplosiv stigning i belastningen. Her, formentlig, forstår jeg ikke helt det, som jeg mener med en eksplosiv stigning i belastningen…
Vi har skrevet et nyt system – det er serviceorienteret, moderne og smukt, med arbejdere overalt, køer overalt, asynkronitet overalt. I sådanne systemer kan data følge forskellige flow. For den første transaktion kan den 1. , 3. og 10. arbejder være involveret, mens den anden transaktion kan involvere 2., 4. og 5. arbejder. Og i dag, lad os sige, at dataflowet om morgenen involverer de første tre arbejdere, og om aftenen ændres det dramatisk, og alle involverer de andre tre arbejdere.
Og her bliver det sådan, at du på en eller anden måde skal skalere arbejderne, du skal på en eller anden måde skalere dine tjenester, men samtidig undgå at blæse ressourcerne op.
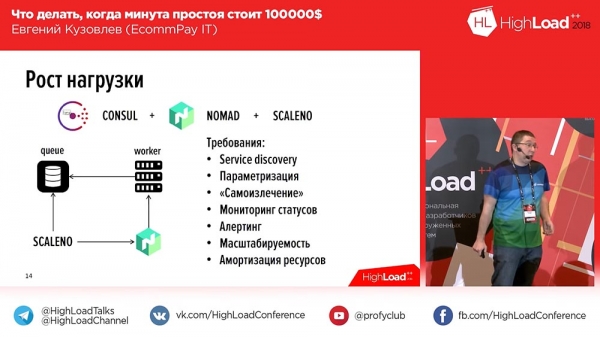
Vi har defineret vores krav. Disse krav er temmelig enkle: der skal være service discovery, parameterisering – alt er standard for opbygning af sådanne skalerbare systemer, bortset fra ét punkt – det er amortisering af ressourcer. Vi har sagt, at vi ikke er klar til at amortisere ressourcerne, så serverne ikke bare varmer luften. Vi tog "Consul", vi tog "Nomad", som styrer vores arbejdere.Hvorfor er dette et problem for os? Lad os tage et skridt tilbage. Vi har nu omkring 70 betalingssystemer bag os. Om morgenen går trafikken gennem "Sberbank", så falder "Sberbank", for eksempel, og vi skifter til et andet betalingssystem. Vi havde 100 arbejdere fungerende før "Sberbank", og efter det skal vi hurtigt øge til 100 arbejdere for det andet betalingssystem. Og dette skal helst ske uden menneskelig indblanding. Fordi, hvis der er menneskelig indblanding – der skal sidde en ingeniør, som udelukkende beskæftiger sig med det 24/7, fordi sådanne nedbrud, når 70 systemer er bag dig, sker regelmæssigt.
Derfor så vi på "Nomad", som har en åben IP, og vi skrev vores eget værktøj Scale-Nomad – ScaleNo, som gør omtrent følgende: det overvåger væksten af køen og reducerer eller øger antallet af arbejdere afhængigt af den dynamiske ændring i køen. Da vi gjorde det, tænkte vi: "Måske skal vi open-source det?" Så kiggede vi på det – det er simpelt som to øre.
Indtil nu har vi ikke open-source det, men hvis du efter foredraget, efter at have indset, at du har brug for et sådan værktøj, har behov for det, er mine kontaktoplysninger på den sidste slide – venligst skriv til mig. Hvis vi samler mindst 3-5 personer – så open-source vi det.
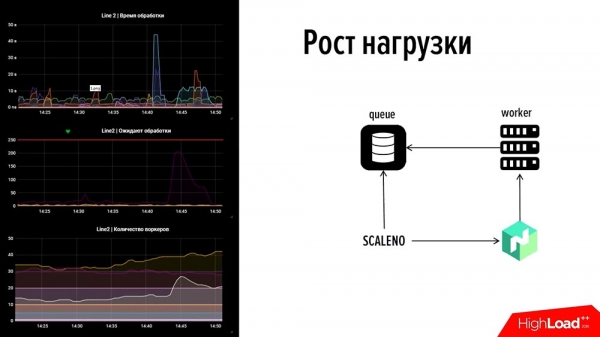
Hvordan fungerer det? Lad os tage et kig! For at forudsige: til venstre er der et stykke af vores overvågning: det er en linje, øverst – behandlingstid for hændelser, i midten – antal transaktioner, nederst – antal arbejdere.Hvis vi kigger, er der et nedbrud på dette billede. I den øverste graf er en af graferne steget over 45 sekunder – et af betalingssystemerne gik ned. Straks blev der præsenteret trafik for 2 minutter, og der kom en stigning i køen i et andet betalingssystem, hvor der ikke var arbejdere (vi udnyttede ikke ressourcerne – tværtimod, vi udnyttede ressourcen korrekt). Vi ønskede ikke at overbelaste – der var et minimum antal, omkring 5-10 arbejdere, men de kunne ikke klare opgaven.
I den sidste graf ses en "bump", som netop viser, at "Skaleno" fordoblede dette antal. Og så, da grafen faldt lidt, blev det reduceret en smule – antallet af arbejdere blev ændret automatisk. Sådan fungerer denne ting. Vi talte om punkt nr. 2 – "Hvordan hurtigt fjerne årsagerne".
Overvågning. Hvordan hurtigt opdage et problem?
Nu er det første punkt – "Hvordan hurtigt opdage et problem?" Overvågning! Vi skal hurtigt forstå bestemte ting. Hvilke ting skal vi hurtigt forstå?
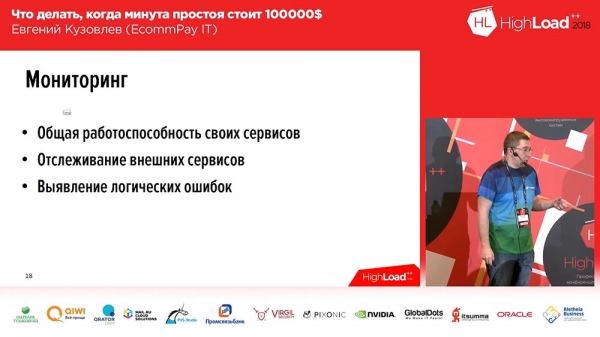
Tre ting!- Vi skal hurtigt forstå og hurtigt opfatte tilgængeligheden af vores egne ressourcer.
- Vi skal hurtigt forstå nedbrud, overvåge tilgængeligheden af de systemer, der er eksterne for os.
- Tredje punkt – identificere logiske fejl. Det er når systemet fungerer, alle indikatorer er normale, men noget går galt.
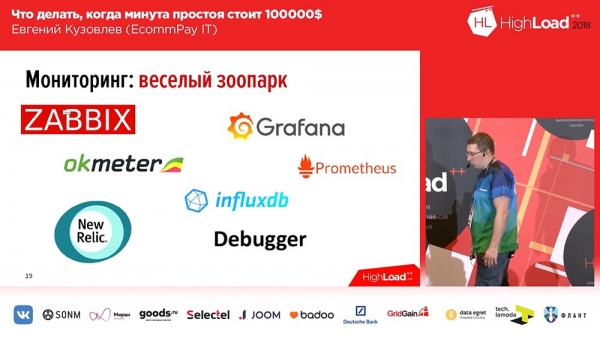
Her vil jeg nok ikke fortælle noget særligt spændende. Jeg vil være kaptajn Åbenbaring. Vi har set, hvad der findes på markedet. Vi har fået en "sjov zoologisk have". Sådan en zoologisk have har vi nu:
Vi bruger "Zabbix" til overvågning af "hardwaren", til overvågning af de grundlæggende indikatorer for serverne. "Okmeter" bruger vi til databaser. "Grafana" og "Prometheus" bruger vi til alle de andre indikatorer, der ikke hørte til de første to, hvoraf en del – med "Grafana" og "Prometheus", en del – "Grafana" med "Influx" og Telegraf.For et år siden overvejede vi at bruge New Relic. Det er et fantastisk værktøj, det kan alt. Men i takt med at det kan alt, er det også meget dyrt. Da vi voksede til 1.500 servere, kom en sælger til os og sagde: "Lad os indgå en kontrakt til næste år". Vi kiggede på prisen og sagde nej, det kommer vi ikke til at gøre. Nu fraskriver vi os "New Relic", vi har omkring 15 servere tilbage, der er monitoreret af "New Relic". Prisen viste sig at være helt vanvittig.
Og der er et værktøj, som vi har implementeret selv – det er Debugger. Først kaldte vi det "Bagger", men så fik vi besøg af vores engelsklærer, som grinede højlydt, og vi omdøbte det til "Debugger". Hvad er det? Det er et værktøj, der i realiteten kører tests på hvert komponent indenfor 15-30 sekunder, som en "sort boks" i systemet, for at kontrollere komponentens generelle funktionalitet.
For eksempel, hvis det er en ekstern side (betalingssiden) – den åbner simpelthen siden og ser, hvordan den skal se ud. Hvis det er behandling, sender den en test-transaktion – og ser, at den transaktion når frem. Hvis det handler om kommunikation med betalingssystemerne – så sender vi en testanmodning, hvor vi kan, og ser, at alt fungerer som det skal.
Hvilke målinger er vigtige for overvågningen?
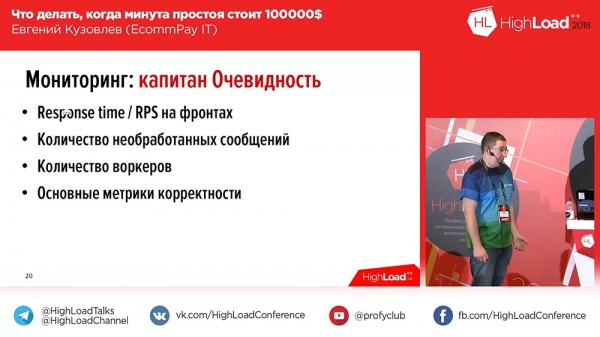
Hvad overvåger vi hovedsageligt? Hvilke målinger er vigtige for os?
- Respons tid / RPS på front-end – en meget vigtig måling. Det indikerer straks, at noget er galt.
- Antallet af behandlede meddelelser i alle køer.
- Antallet af arbejdere.
- Hovedmetrikker for korrekthed.
Det sidste punkt er en "forretningsmæssig" metrik. Hvis du ønsker at overvåge det samme, skal du definere en eller to metrikker, der er dine vigtigste indikatorer. Vi har sådan en metrik – det er gennemstrømning (forholdet mellem antallet af succesfulde transaktioner til den samlede strøm af transaktioner). Hvis der sker ændringer i denne over en periode på 5-10-15 minutter – så har vi problemer (hvis der sker en markant ændring).
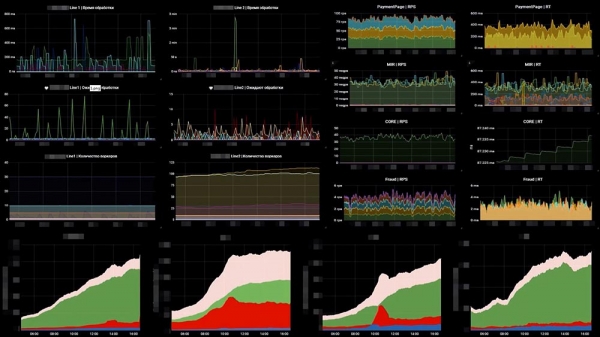
Sådan ser det ud for os – et eksempel på en af vores dashboards:
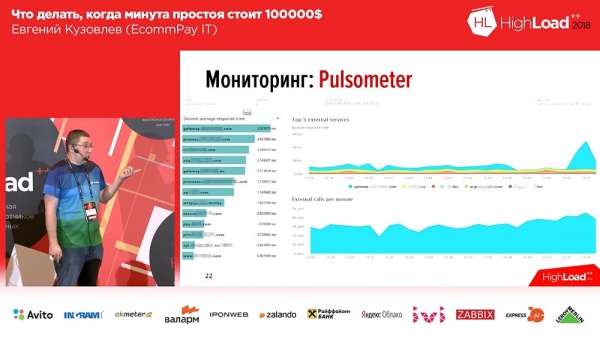
Til venstre – 6 grafer, som viser antal medarbejdere og antal beskeder i køen. Til højre – RPS, RTS. Nederst – den såkaldte "business"-metrik. Og på "business"-metriken kan vi straks se, at der er noget galt på de to mellemste grafer… Det er netop et system, der er faldet ud, som står bag os.Det andet, vi skulle gøre – var at overvåge nedbrud i eksterne betalingssystemer. Her tog vi OpenTracing – en mekanisme, standard, paradisk der muliggør sporing af distribuerede systemer; og vi ændrede det lidt. Den standard OpenTracing-paradigme siger, at vi bygger en sporing for hver enkelt anmodning. Det havde vi ikke brug for, så vi pakkede det ind i en samlet, aggregeret sporing. Vi lavede et værktøj, som gør det muligt for os at overvåge hastigheden hos de systemer, der står bag os.
Grafen viser os, at et af betalingssystemerne begynder at svare efter 3 sekunder – vi får problemer. Samtidig reagerer dette system, når problemerne opstår, inden for et interval på 20-30 sekunder.Og den tredje klasse af overvågningsfejl, der findes – er logisk overvågning.
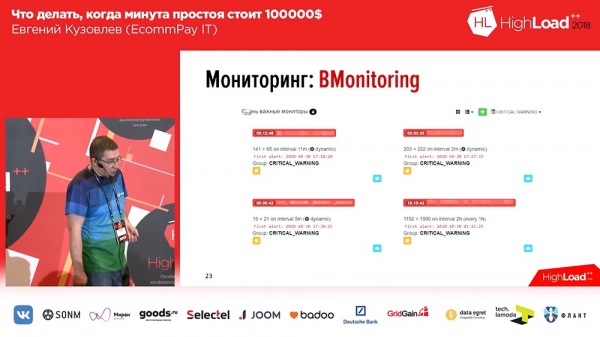
Ærligt talt, vidste jeg ikke, hvad jeg skulle tegne på dette slide, fordi vi længe har søgt på markedet efter noget, der ville passe os. Vi fandt intet, så vi måtte gøre det selv.
Hvad mener jeg med logisk overvågning? Tænk på det sådan: du laver et system (for eksempel en klon af "Tinder"); du har oprettet det, lanceret det. Den succesfulde manager Vasja Pupkin har installeret det på sin telefon, ser en pige, kan lide hende… men 'liket' går ikke til pigen – det går til sikkerhedsvagten Mikhailych fra det samme kontorcentrum. Manageren går ned, og så undrer han sig: "Hvorfor smiler denne sikkerhedsvagt Mikhailych så venligt til ham?"I sådanne situationer... For os lyder denne situation lidt anderledes, fordi (jeg skrev) det er et sådan omdømmetab, der indirekte fører til økonomiske tab. Vi har det modsatte problem: vi kan blive ramt af direkte økonomiske tab – for eksempel hvis vi gennemfører en transaktion som succesfuld, men den faktisk var mislykket (eller omvendt). Vi var nødt til at skrive et eget værktøj, der holder øje med antal succesfulde transaktioner i dynamik over tid. Vi fandt ikke noget på markedet! Det var lige præcis den tanke, jeg ville fremhæve. Til løsning af denne slags opgaver findes der ikke noget på markedet.
Det var i forhold til spørgsmålet om, hvordan man hurtigt identificerer et problem.
Hvordan fastslår man årsagerne til deployment
Den tredje gruppe opgaver, vi løser – er efter vi har identificeret problemet, og efter vi har løst det, så er det godt at forstå årsagen til udvikling, til testning og gøre noget ved det. Derfor skal vi undersøge, vi skal hente logs.
Hvis vi taler om logs (hovedårsagen – logs), så ligger hovedparten af vores logs i ELK Stack – næsten alle har det sådan. Nogen har måske ikke ELK, men hvis du skriver logs i gigabyte, så vil du før eller siden komme til ELK. Vi skriver dem i terabyte.
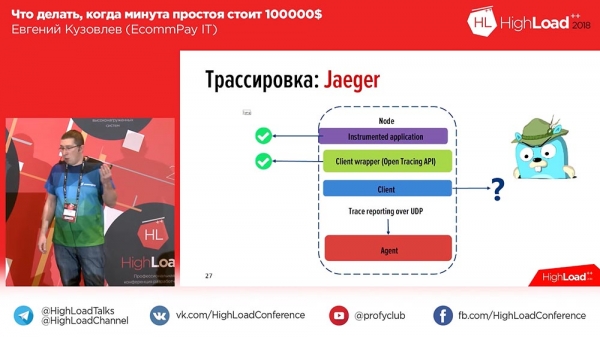
Her er der et problem. Vi har rettet en fejl for brugeren, og begyndte at grave i, hvad der skete, dykker ind i 'Kibana', indtaster transaktionsid'et og får sådan et statsligt udtræk (viser meget). Og i dette udtræk er der ikke noget forståeligt. Hvorfor? Fordi det ikke er klart, hvilken del der hører til hvilken worker, hvilken del der hører til hvilken komponent. Og i det øjeblik indså vi, at vi havde brug for tracing – det samme OpenTracing, som jeg talte om.Vi tænkte på dette for et år siden, rettede blikket mod markedet, og der var to værktøjer – Zipkin og Jaeger. Jaeger er i virkeligheden en ideologisk efterfølger, en ideologisk fortsætter af Zipkin. Alt i Zipkin er godt, bortset fra at det ikke kan aggregere, det kan ikke inkludere logs i tracing, kun tids tracing. Og Jaeger støttede dette.
Vi kiggede på 'Eger': man kan instrumentere applikationer, man kan skrive til API'et (API-standarden for PHP på det tidspunkt var dog ikke godkendt – det var for et år siden, og nu er den allerede godkendt), og der var slet ingen klient. 'Okay', tænkte vi, og skrev vores egen klient. Hvordan ser det ud? Sådan ser det cirka ud:
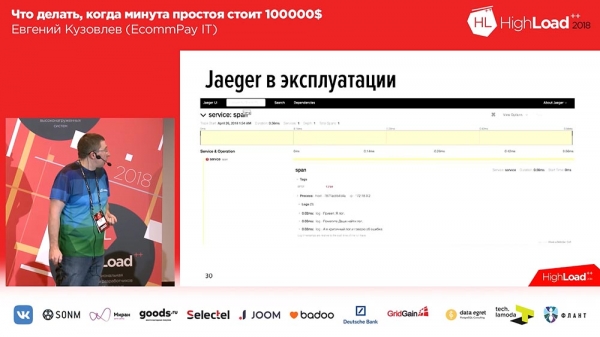
I 'Eger' oprettes der span'er for hver besked. Det vil sige, når brugeren åbner systemet, ser han en eller to blokke for hver indkommende forespørgsel (1-2-3 – så mange indkommende forespørgsler som brugeren har, så mange blokke er der). For at gøre det lettere for brugerne har vi tilføjet tags til loggene og tidsregistreringen. Derfor mærker vores applikation loggen med tagget Error i tilfælde af en fejl. Man kan filtrere ved hjælp af tagget Error, og kun de span'er, der indeholder den blok med fejlen, vil blive vist. Sådan ser det ud, hvis vi folder span'en ud:
Inde i span'en er der et sæt traces. I dette tilfælde er der tre testtraces, og den tredje trace fortæller os, at der opstod en fejl. Her ser vi også tidsregistreringen: vi har en tidslinje øverst, og vi kan se, hvilken tidsinterval loggen blev optaget.Derfor gik det virkelig godt. Vi skrev vores eget udvidelse, og vi har open-sourcet det. Hvis du vil arbejde med tracing, hvis du vil arbejde med 'Eger' i PHP – har vi vores udvidelse, welcome to use, som man siger:
Vores udvidelse er en klient til at arbejde med OpenTracing API, lavet som en php-extention, det vil sige, du skal samle det og inkludere det i systemet. For et år siden var der ikke noget andet. Nu er der også andre klienter, der fungerer som komponenter. Det er op til dig: enten downloader du komponenterne med Composer, eller du bruger udvidelsen, op til dig.Virksomhedsstandarder
Vi talte om de tre bud. Det fjerde bud – er at standardisere tilgange. Hvad handler det om? Det handler cirka om dette:
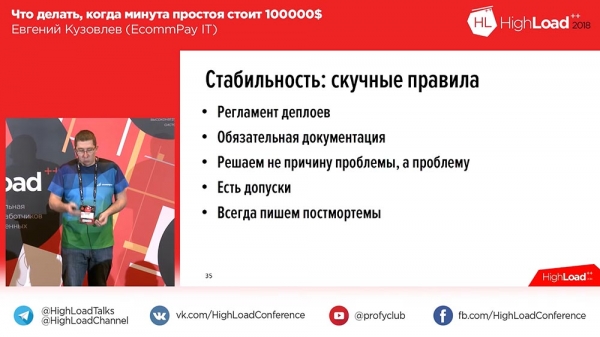
Hvorfor er der ordet 'virksomheds'? Ikke fordi vi er en stor eller bureaukratisk virksomhed, nej! Ordet 'virksomheds' ønskede jeg at bruge i den kontekst, at hver virksomhed, hvert produkt skal have sine egne standarder, og det skal I også have. Hvilke standarder har vi?- Vi har en deploy-regulering. Uden den bevæger vi os ikke, vi kan ikke. Vi deployer cirka 60 gange om ugen, så vores deployer sker næsten konstant. Derudover har vi for eksempel et tabu mod deploys om fredagen – grundlæggende, vi deployer ikke.
- Vi har obligatorisk dokumentation. Ingen nye komponenter kommer i produktion uden dokumentation, selv hvis de er skabt af vores RnD-teams. Vi kræver en udrulningsguide, et overvågningskort og en cirka beskrivelse (ja, som programmører kan skrive) af, hvordan denne komponent fungerer, og hvordan man fejlretter den.
- Vi løser ikke årsagen til problemet, men problemet – som jeg allerede har nævnt. Det er vigtigt for os at beskytte brugeren mod problemer.
- Vi har tolerancer. For eksempel betragter vi ikke et downtime, hvis vi i to minutter har mistet 2 % af trafikken. Det kommer i princippet ikke ind i vores statistik. Hvis det er mere i procent eller tid, betragter vi det.
- Og vi skriver altid post-mortems. Uanset hvad der sker, enhver situation, der opfører sig unormalt i produktionen, vil blive afspejlet i post-mortemet. Et post-mortem er et dokument, hvor du beskriver, hvad der skete, detaljeret tidslinje, hvad du gjorde for at rette det og (dette er et obligatorisk afsnit!) hvad du vil gøre for at forhindre, at det sker i fremtiden. Dette er obligatorisk og nødvendigt for efterfølgende analyse.
Hvad betragtes som downtime?
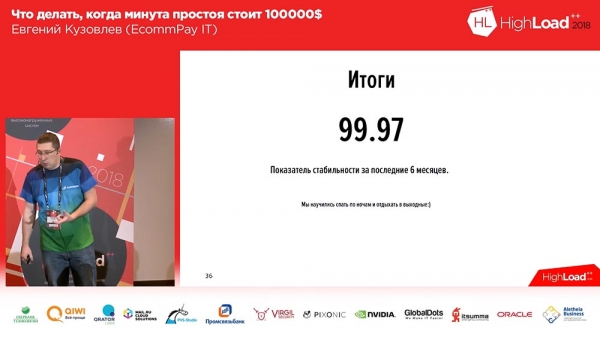
Hvad førte det hele til?Det førte til, at (vi havde visse problemer med stabilitet, som ikke tilfredsstillede hverken kunderne eller os) i løbet af de sidste 6 måneder har vores stabilitetsprocent været 99,97. Man kan sige, at det ikke er særlig meget. Ja, vi har noget at stræbe efter. Ca. halvdelen af denne procentdel er stabilitet, som egentlig ikke er vores, men vores web application firewall, som står foran os og bruges som en tjeneste, men kunderne har ikke meget at gøre med det.
Vi har lært at sove om natten. Endelig! For seks måneder siden kunne vi ikke. Og på denne note med resultaterne vil jeg gerne tilføje en bemærkning. I går aftes var der en fantastisk præsentation om styringssystemet til et atomreaktor. Hvis der er folk til stede, der skrev dette system – glem venligst det, jeg sagde om '2% – det er ikke downtime'. For jer er 2% downtime, selvom det kun er i to minutter!
Det var alt! Dine spørgsmål.
Om load balancere og database-migrationer
Spørgsmål fra publikum (herefter – S): – God aften. Mange tak for den informative præsentation! Et kort spørgsmål vedrørende jeres load balancere. I nævnte, at I har en WAF, så vidt jeg forstår, bruger I en ekstern balancer...
EK: – Nej, vi bruger vores egne tjenester som balancer. I dette tilfælde er WAF udelukkende et værktøj til beskyttelse mod DDoS.
Q: – Kan I sige et par ord om balancere?
EK: – Som jeg har nævnt, er det en gruppe servere i openresty. Vi har i øjeblikket 5 grupper af reserverede servere, der udelukkende håndterer… altså serveren, der udelukkende kører openresty, den proxy’ere trafik. For at give en forståelse, hvor meget trafik vi håndterer: vores nuværende faste trafikstrøm ligger på flere hundrede megabit. De klarer det, og de har det godt, de knokler ikke engang.
Q: – Også et enkelt spørgsmål. Vi har Blue/Green deployment. Hvad gør I for eksempel med database-migrationer?
EK: – Godt spørgsmål! Se, vi har i vores Blue/Green deployment separate køer til hver linje. Så hvis vi taler om hændelseskøer, der går fra arbejder til arbejder, så er der separate køer for blue-linjen og green-linjen. Når vi taler om selve databasen, har vi bevidst indsnævret den, så meget vi kunne, og flyttet næsten alt til køerne; databasen gemmer kun transaktionsstakken. Og transaktionsstakken er fælles for alle linjer. Med databasen i denne kontekst: vi deler ikke blue og green, fordi begge kodeversioner skal vide, hvad der sker med transaktionen.
Venner, jeg har også en lille præmie til at motivere jer – en bog. Jeg vil gerne give den til den, der stiller det bedste spørgsmål.
Q: – Hej. Tak for præsentationen. Spørgsmål: I overvåger betalinger, I overvåger de tjenester, I kommunikerer med… Men hvordan overvåger I, at en person på en eller anden måde er kommet til jeres betalingsside, har gennemført betalingen, og at projektet har tilføjet penge til deres konto? Med andre ord, hvordan overvåger I, at merchant er tilgængelig og har accepteret jeres callback?
EK: – 'Merchant' er for os i dette tilfælde en eksternt service som betalingssystemet. Vi overvåger svartiden fra 'merchant'.
Om kryptering af databasen
Q: – Hej. Jeg har lige et spørgsmål. I har følsomme data i henhold til PCI DSS. Jeg vil gerne vide, hvordan I opbevarer PAN'er i køer, som I skal videresende? Bruger I nogen form for kryptering? Og heraf det andet spørgsmål: Ifølge PCI DSS er det nødvendigt at genkryptere databasen periodisk i tilfælde af ændringer (afskedigelse af administratorer osv.) – hvordan håndteres tilgængeligheden i sådanne tilfælde?
EK: – Fantastisk spørgsmål! For det første opbevarer vi ikke PAN'er i køer. Vi har ikke lov til at opbevare PAN i åben form, så vi bruger en særlig service (som vi kalder "Keydemon") – det er en service, der kun gør én ting: den tager en besked ind og returnerer den krypteret. Og vi opbevarer alt i den krypterede besked. Så længden af vores nøgle er under en kilobyte for at sikre, at det er meget solidt og pålideligt.Q: – Skal det nu være 2 kilobyte?
EK: – Var det ikke 256 i går… Hvor skal vi hen ellers?!
Så det er det første. Og for det andet, hvordan beslutningen er, understøtter det proceduren for genkryptering – der er to par "KEK'er" (nøgler), som giver "DEK'er", der krypterer (key – det er nøgler, dek – det er afledte fra nøglerne, der krypterer). Hvis proceduren initieres (den gennemføres regelmæssigt, fra 3 måneder til ± nogle), så uploader vi et nyt par "KEK'er", og vi udfører genkryptering af dataene. Vi har separate tjenester, der trækker alle dataene ud og krypterer dem på ny; til dataene opbevares en identifikator for den nøgle, som de er krypteret med. Så snart dataene er krypteret med de nye nøgler, sletter vi de gamle nøgler.
Nogle gange skal betalinger foretages manuelt…
Q: – Så hvis der kommer en tilbagebetaling for en eller anden transaktion, så dekrypterer I den med den gamle nøgle?
EK: – Ja.
Q: – Så har jeg et lille spørgsmål mere. Når der opstår en fejl, et nedbrud, en hændelse, så er det nødvendigt at skubbe transaktionen manuelt. Sådan en situation kan opstå.
EK: – Ja, det sker.
Q: – Hvor får I disse data fra? Går I selv håndgribeligt ind i det lager?
EK: – Nej, det er klart – vi har et slags back-office-system, som indeholder en grænseflade for vores support. Hvis vi ikke ved, i hvilken status transaktionen er (for eksempel, indtil betalingssystemet timeoutede), så ved vi grundlæggende ikke, det vil sige, vi tildeler den endelige status kun ved fuld sikkerhed. I dette tilfælde placerer vi transaktionen i en særlig status for manuel behandling. Om morgenen næste dag, så snart supporten får information om, at betalingssystemet har disse transaktioner tilbage, behandler de dem manuelt i denne grænseflade.
Q: – Jeg har et par spørgsmål. Et af dem er vedrørende PCI DSS-zonen: hvordan håndterer I loggene fra deres kontur? Jeg stiller spørgsmålet, fordi udvikleren kunne have lagt hvad som helst i loggene! Det andet spørgsmål: hvordan implementerer I hotfixes? Håndtilgang i databasen – det er en mulighed, men der kan være gratis hotfixes – hvad er proceduren der? Og det tredje spørgsmål, som nok er relateret til RTO, RPO. I har haft tilgængelighed på 99,97, næsten fire neuner, men jeg forstår det sådan, at I også har det andet datacenter, det tredje datacenter og det femte datacenter… Hvordan håndterer I deres synkronisering, replikation, alt det andet?EK: – Lad os starte med det første. Var det første spørgsmål om loggene? Når vi genererer loggene, er der et lag, der maskerer alle følsomme data. Det ser på masken og på de yderligere felter. Derfor kommer vores logs ud med allerede maskerede data og konturen for PCI DSS. Dette er en af de regelmæssige opgaver, der er pålagt testafdelingen. De er forpligtede til at kontrollere hver opgave inklusiv de logs, de skriver, og dette er en af de regelmæssige opgaver under kodegennemgang for at kontrollere, at udvikleren ikke har skrevet noget. Den efterfølgende kontrol udføres regelmæssigt af informationssikkerhedsafdelingen cirka en gang om ugen: tilfældigt udtages logs fra den seneste dag, og de køres gennem en speciel scanner-analysemaskine fra testserverne for at kontrollere det hele.
Om hotfixes. Dette er inkluderet i vores deploy-regler. Vi har en separat sektion om hotfixes. Vi mener, at vi deployer hotfixes 24/7, når vi har brug for det. Så snart versionen er samlet, så snart den er testet, og når vi har artefakten, så bliver vores vagt-systemadministrator kaldt af support, og han deployer det i det øjeblik, det er nødvendigt.Om "fire neger": Det tal, vi har nu, er faktisk opnået, og vi har stræbt efter det i et andet datacenter. Nu har vi et andet datacenter, og vi begynder at rute imellem dem. Spørgsmålet om tværdatacenter-replikation er virkelig en ikke triviel problemstilling. Vi har forsøgt at løse det på forskellige måder: vi prøvede at bruge Taran, hvilket ikke fungerede for os, så jeg siger det med det samme. Derfor besluttede vi at lave en manuel bestilling af "Senser". Hver applikation kører i det faktiske asynkrone synkroniserings "change - done" mellem datacentrene.
Q: – Hvis I har fået et andet, hvorfor er der så ikke kommet et tredje? Fordi Split-brain…
EK: – Vi har ikke "Split-brain". Fordi hver applikation kører multimaster, er det ikke vigtigt, hvilket center anmodningen kommer til. Vi er forberedt på, at hvis ét datacenter falder (det tager vi højde for), og brugerens anmodning skifter til det andet datacenter midt i anmodningen, er vi villige til at miste denne bruger; men det vil virkelig kun være enkelte, absolutte enheder.
Q: – God aften. Tak for din præsentation. Du talte om din debugger, som kører nogle testtransaktioner i produktion. Kan du fortælle mig om testtransaktionerne? Hvor dybt går det?
EK: – Det gennemgår hele cyklussen for komponenten. For komponenten er der ingen forskel mellem testtransaktionen og den faktiske. Set fra et logisk perspektiv er det blot et separat projekt i systemet, hvor kun testtransaktioner køres.
Q: – Hvor stopper du den? Core har sendt…
EK: – Vi følger "Core" i dette tilfælde for testtransaktioner… Vi har et koncept, som hedder routing: "Core" ved, hvilken betalingssystem det skal sende til – vi sender til et falsk betalingssystem, som bare giver http-respons og det er det hele.
Q: – Kan du venligst fortælle, om jeres applikation er skrevet som én stor monolit, eller har I opdelt den i nogle tjenester eller endda mikrotjenester?
EK: – Vi har ikke en monolit, selvfølgelig, vi har en serviceorienteret applikation. Vi har en sjov bemærkning om, at vi har service fra monolitter – de er faktisk ret store. Man kan slet ikke kalde det mikrotjenester, men det er bestemt tjenester, som har workere fra distribuerede maskiner.
Hvis tjenesten på serveren er kompromitteret…
Q: – Så har jeg det næste spørgsmål. Selv hvis det var en monolit, sagde du stadig, at I har mange af disse instant-servere, og de behandler generelt data, så spørgsmålet er: "I tilfælde af kompromittering af en af instant-serverne eller applikationen, et bestemt led, har de en eller anden form for adgangskontrol? Hvad kan de gøre? Hvem kan de kontakte for hvilke data?
EK: – Ja, uden tvivl. Sikkerhedskravene er ganske strenge. For det første har vi åbne dataforflytninger, og porte er kun de, som vi på forhånd forventer trafik til. Hvis en komponent kommunikerer med databasen (lad os sige, med 'MySQL') over 5-4-3-2, vil den kun have adgang til 5-4-3-2, og andre porte, andre trafikretninger vil ikke være tilgængelige. Derudover skal man forstå, at vi i produktion har omkring 10 forskellige sikkerhedskonturer. Og selv hvis applikationen på en eller anden måde var kompromitteret, Gud forbyde, så vil en angriber ikke kunne få adgang til serverens administrationskonsol, fordi det er en anden sikkerhedszone.Q: – Jeg er mere interesseret i det punkt, at I har nogle kontrakter med tjenesterne – hvad de kan gøre, hvilke 'handlinger' de kan kontakte hinanden gennem… I et normalt flow anmoder nogle bestemte tjenester om en række 'handlinger' fra den anden. I normaltilstanden henvender de sig ikke til andre, og de har andre ansvarsområder. Hvis en af dem bliver kompromitteret, vil den så kunne trigge 'handlingerne' fra den tjeneste…?
EK: – Jeg forstår. Hvis kommunikationen med en anden server normalt er tilladt, så ja. I henhold til SLAaftalen overvåger vi ikke, at du kun har tilladelse til de første 3 "handlinger", og at 4. "handling" ikke er tilladt. Det ville nok være overflødigt for os, fordi vi allerede har et 4-niveau beskyttelsessystem for konturer generelt. Vi foretrækker at beskytte os ved hjælp af konturer frem for at gøre det på niveauet af de indre komponenter.
Hvordan Visa, MasterCard og "Sberbank" fungerer
Q: – Jeg vil gerne præcisere et punkt angående skift af bruger fra et datacenter til et andet. Så vidt jeg ved, arbejder "Visa" og "MasterCard" efter den binære synkrone protokol 8583, der er mikser tilsluttet. Jeg ville gerne vide, om skiftet her henviser til "Visa" og "MasterCard" direkte, eller til betalingssystemerne, til processeringen?
EK: – Det gælder mikserne. Mikserne er placeret i et datacenter.
Q: – For at sige det groft, har I én tilslutningspunkt?
EK: – Ja, til "Visa" og "MasterCard". Bare fordi "Visa" og "MasterCard" kræver betydelige investeringer i infrastrukturen for at indgå separate kontrakter for at få et ekstra sæt mikser, for eksempel. De er reserveret inden for et datacenter, men hvis vores datacenter, Gud forbyde det, skulle falde ud, hvor mikserne til tilslutning til "Visa" og "MasterCard" er placeret, så vil forbindelsen til "Visa" og "MasterCard" være tabt...
Q: – Hvordan kan de være reserveret? Jeg ved, at "Visa" i princippet kun tillader én forbindelse!
EK: – De leverer selv udstyret. I hvert fald har vi modtaget udstyr, der er internt reserveret.
Q: – Så er det rack fra deres Connects Orange..?
EK: – Ja.
Q: – Hvad så i dette tilfælde: hvis dit datacenter forsvinder, hvordan anvender man det derefter? Eller stopper trafikken bare?
EK: – Nej. I dette tilfælde vil vi bare skifte trafikken til en anden kanal, som naturligvis vil være dyrere for os, dyrere for kunderne. Men trafikken vil ikke gå gennem vores direkte tilslutning til "Visa", "MasterCard", men gennem en betinget "Sberbank" (meget forenklet).
Jeg undskylder meget, hvis jeg har ramt ansatte hos "Sberbank". Men ifølge vores statistik falder "Sberbank" oftest blandt de russiske banker. Der går ikke en måned uden, at "Sberbank" har noget, der falder ud.

Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
