

Den næste HighLoad++ konference finder sted den 6. og 7. april 2020 i Sankt Petersborg. Detaljer og billetter . HighLoad++ Moskva 2018. Sal "Moskva". 9. november, 15:00. Resumé og .
* Overvågning – online og analyse.
* Primære begrænsninger ved ZABBIX platformen.
* Løsning til skalerbar analyseopbevaring.
* Optimering af ZABBIX serveren.
* Optimering af UI.
* Erfaring med systemdrift med belastninger over 40k NVPS.
* Kort konklusion.
Mikhail Makurov (herefter – MM): – Hej alle sammen!
Maksim Chernetsov (herefter – MCh): – Goddag!
MM: – Tillad mig at præsentere Maksim. Maks – en talentfuld ingeniør, den bedste netværksekspert, jeg kender. Maksim arbejder med netværk og services, deres udvikling og drift.
MCh: – Og jeg vil gerne fortælle om Mikhail. Mikhail – en udvikler i C. Han har skrevet flere højtydende løsninger til trafikbehandling for vores virksomhed. Vi lever og arbejder i Ural, i byen med de hårde mænd, Tjeljabinsk, i firmaet "Intersvyaz". Vores firma er en udbyder af internet- og kabel-tv-services til en million mennesker i 16 byer.
MM: – Og det skal siges, at "Intersvyaz" er meget mere end bare en udbyder, det er et IT-firma. Størstedelen af vores løsninger er udviklet af vores IT-afdeling.
A: fra servere, der behandler trafik, til callcenter og mobilapplikation. IT-afdelingen har nu cirka 80 medarbejdere med meget forskellige kompetencer.
Om Zabbix og dets arkitektur
MCh: – Og nu vil jeg forsøge at sætte personlig rekord og på et minut fortælle, hvad Zabbix (herefter – "Zabbix") er.
"Zabbix" positionerer sig som et enterprise overvågningssystem "out of the box". Det har mange funktioner, der gør livet lettere: avancerede eskalationsregler, API til integration, gruppering og automatisk opdagelse af værter og metrikker. I "Zabbix" er der såkaldte skaleringsværktøjer – proxyer. "Zabbix" er et open source system.
Kort om arkitekturen. Man kan sige, at den består af tre komponenter:
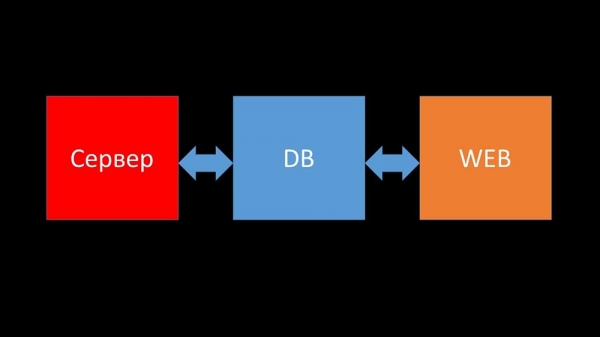
- Server. Skrevet i C. Med rimeligt kompleks behandling og overførsel af information mellem tråde. Al behandling sker her: fra modtagelse til lagring i database.
- Alle data opbevares i databasen. "Zabbix" understøtter MySQL, PostgreSQL og Oracle.
- Webgrænsefladen er skrevet i PHP. Den leveres som regel med Apache-serveren, men fungerer mere effektivt i kombination med nginx + php.
I dag vil vi gerne fortælle en historie fra vores virksomhed, der handler om 'Zabbix'…
En historie fra virksomheden 'Intersvyaz'. Hvad har vi, og hvad har vi brug for?
For 5 eller 6 måneder siden. En dag efter arbejde…
MCh: – Misha, hej! Glad for at jeg fik fat i dig – jeg har noget at tale om. Vi har igen haft problemer med overvågningen. Under en stor nedetid gik alt i stå, og der var ingen information om netværkets tilstand. Desværre sker det ikke for første gang. Jeg har brug for din hjælp. Lad os sørge for, at vores overvågning fungerer under alle omstændigheder!
MM: – Men lad os først synkronisere os. Jeg har ikke kigget derovre i et par år. Hvis jeg husker korrekt, så skiftede vi fra Nagios til 'Zabbix' for omkring 8 år siden. Og nu har vi, virker det som om, 6 kraftige servere og omkring et dusin proxies. Jeg blander ikke noget sammen?
MCh: – Næsten. 15 servere, hvoraf nogle er virtuelle maskiner. Det vigtigste er, at det ikke redder os i det øjeblik, hvor vi har brug for det mest. Hver gang der er en nedetid, hænger serverne, og vi ser ingenting. Vi har forsøgt at optimere konfigurationen, men det giver ikke et optimalt løft i ydeevnen.
MM: – Forståeligt. Har I allerede kigget på noget, eller har I fundet noget i diagnostikken?
MCh: – Det første, vi skal tage fat på, er faktisk databasen. MySQL er konstant belasted med at gemme nye målinger, og når 'Zabbix' begynder at generere en masse hændelser, går databasen bogstaveligt talt i stå i flere timer. Jeg har allerede fortalt dig om optimeringen af konfigurationen, men vi opdaterede faktisk hardwaren i år: serverne har over hundrede gigabyte RAM, og der er SSD RAID-array på disken – der er ikke nogen mening i at vokse det lineært. Hvad skal vi gøre?
MM: – Forståeligt. Generelt set er MySQL en LTP-database. Det ser ud til, at den ikke længere egner sig til at gemme arkivet af målinger i vores størrelse. Lad os finde ud af det.
MCh: – Lad os gøre det!
Integration af Zabbix og Clickhouse som resultat af hackathonen
Efter noget tid fik vi interessante data:
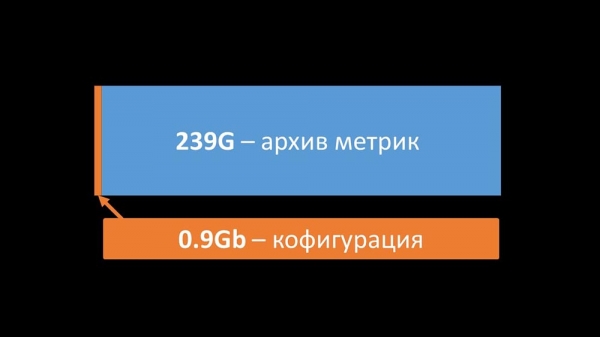
Størstedelen af pladsen i vores database var optaget af metrics-arkivet, og mindre end 1 % blev brugt til konfiguration, skabeloner og indstillinger. På det tidspunkt havde vi allerede anvendt en Big Data-løsning baseret på Clickhouse i over et år. Retningen for os var klar. På vores forår 'Hackathon' skrev jeg en integration mellem Zabbix og Clickhouse for serveren og frontend. På det tidspunkt havde Zabbix allerede støtte til ElasticSearch, og vi besluttede at sammenligne dem.
Sammenligning af Clickhouse og Elasticsearch
MM: – Til sammenligningen genererede vi en belastning svarende til den, som Zabbix-serveren skaber, og så på, hvordan systemerne ville klare sig. Vi skrev data i mellem 1000 rækker pr. gang og brugte CURL. Vi formodede på forhånd, at Clickhouse ville være mere effektiv til den belastningsprofil, som Zabbix skaber. Resultaterne overraskede os endda:
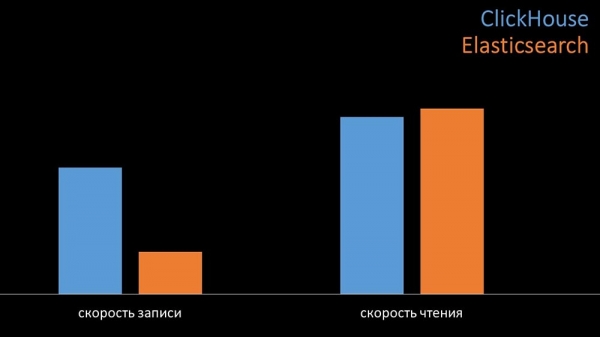
Under ens betingelser skrev Clickhouse tre gange så mange data under testen. Begge systemer brugte meget få ressourcer til at læse data. Men ElasticSearch krævede betydeligt flere CPU-ressourcer ved skrivning:
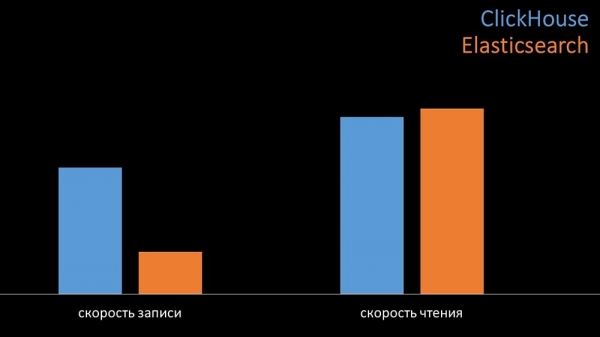
Generelt overgik Clickhouse ElasticSearch betydeligt både i CPU-forbrug og hastighed. Desuden bruger Clickhouse 11 gange mindre plads på harddisken takket være datakompression og udfører omtrent 30 gange færre diskoperationer:
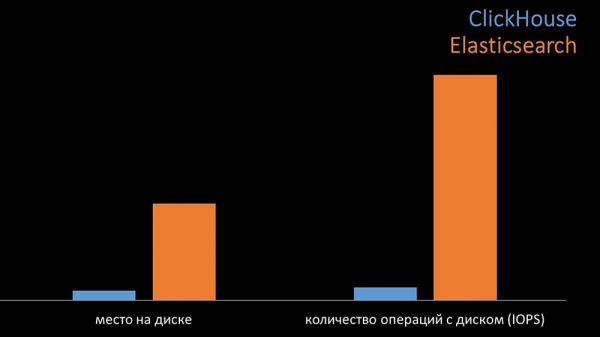
MCh: – Ja, arbejdet med disksystemet i Clickhouse er meget effektivt. Store SATA-diske kan bruges til databaser og opnå skrivehastigheder på hundredtusinder af rækker pr. sekund. Systemet understøtter 'out of the box' sharding, replikering og er meget nemt at konfigurere. Vi er mere end tilfredse med driften i et år.
For at optimere ressourcerne kan Clickhouse installeres ved siden af den eksisterende hoveddatabase, hvilket sparer meget CPU-tid og diskoperationer. Vi har flyttet metrics-arkivet til allerede eksisterende Clickhouse-klynger:
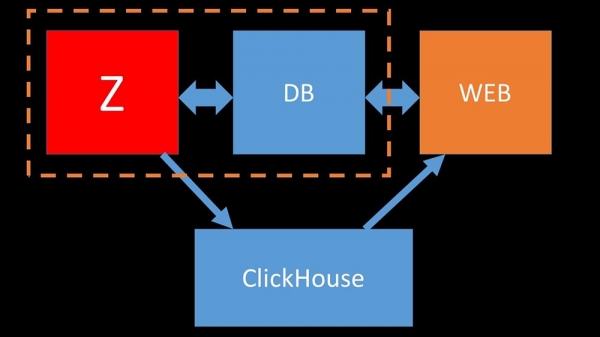
Vi har lettet den primære MySQL-database så meget, at vi kunne kombinere den på én maskine med Zabbix-serveren og undgå at have en dedikeret server til MySQL.
Hvordan fungerer polling i Zabbix?
4 måneder siden
MM: – Nå, kan vi glemme problemerne med databasen?
MCh: – Det er helt rigtigt! En anden opgave, vi skal løse, er langsom datainsamling. Nu er alle vores 15 proxy-servere overbelastede med SNMP-processer og polling. Vi har ikke andet valg end at anskaffe nye servere igen og igen.
MM: – Fantastisk. Men fortæl mig først, hvordan polling fungerer i 'Zabbix'?
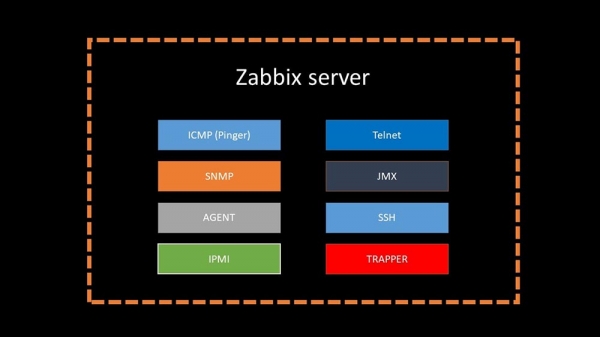
MCh: – Kort sagt er der 20 typer metric og ti måder at indsamle dem på. 'Zabbix' kan samle data enten i 'request – response' tilstand, eller vente på nye data via 'Trapper Interface'.
Det er værd at bemærke, at denne metode (Trapper) i den originale 'Zabbix' er den hurtigste.
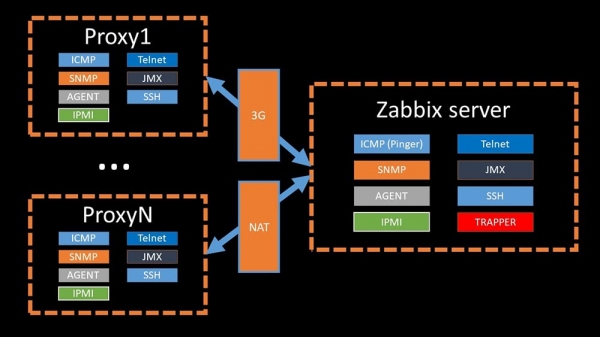
Der findes proxy-servere til belastningsfordeling:
Proxy kan udføre de samme indsamlingfunktioner som 'Zabbix'-serveren ved at modtage opgaver fra den og sende de indsamlede metrics via Trapper-interfacet. Dette er den officielt anbefalede metode til at fordele belastningen. Proxy'er er også nyttige til at overvåge fjerna infrastrukturen, der arbejder gennem NAT eller en langsom forbindelse:
MM: – Arkitekturen er forstået. Vi skal kigge på kildekoden…
Et par dage senere
Sagnet om, hvordan nmap fping besejrede
MM: – Det ser ud til, at jeg har fundet noget.
MCh: – Fortæl!
MM: – Jeg har opdaget, at 'Zabbix' ved tilgængelighedskontroller kun tjekker maksimalt 128 værter samtidigt. Jeg prøvede at øge dette tal til 500 og fjernede inter-pakke intervallet i deres ping – det fordoblede hastigheden. Men jeg vil gerne have større tal.
MCh: – I mit arbejde må jeg nogle gange kontrollere tilgængeligheden af tusinder af værter, og jeg har ikke set noget hurtigere end nmap til dette. Jeg er sikker på, at det er den hurtigste metode. Lad os prøve det! Vi skal markant øge antallet af værter ad gangen.
MM: – Tjekke mere end fem hundrede? 600?
MCh: – Minimum et par tusinde.
MM: – Okay. Det vigtigste, jeg gerne vil sige: jeg fandt ud af, at det meste af polling i 'Zabbix' bliver udført synkront. Vi skal helt sikkert ændre det til asynkront. Så kan vi dramatisk øge antallet af metrics, der indsamles af pollere, især hvis vi øger antallet af metrics per iteration.
MCh: – Det lyder godt! Og hvornår?
MM: – Som sædvanligt, i går.
MCh: – Vi sammenlignede begge versioner af fping og nmap:
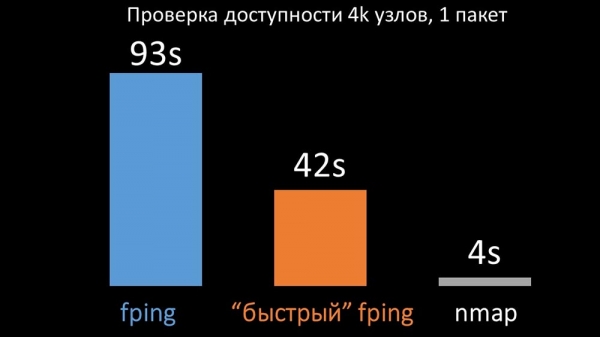
På et stort antal værter var nmap forventeligt op til fem gange mere effektivt. Da nmap kun tjekker for tilgængelighed og svartid, har vi flyttet tabstælling til triggere og betydeligt forkortet intervallerne for tilgængelighedstjek. Det optimale antal værter til nmap, fandt vi, lå omkring 4000 pr. iteration. Nmap har gjort det muligt for os at reducere CPU-omkostningerne til tilgængelighedstjek med tre gange og forkorte intervallet fra 120 sekunder til 10.
Optimering af polling
MM: – Derefter tog vi fat på pollere. Vi var især interesserede i SNMP-aflæsninger og agenter. I "Zabbix" er polling lavet synkront, og der er truffet særlige foranstaltninger for at øge systemets effektivitet. I det synkrone regime forårsager utilgængelighed af værter betydelig nedgradering af polling. Der findes et helt system af tilstande og specielle processer – såkaldte unreachable-pollere, som kun arbejder med utilgængelige værter:

Dette er en kommentar, der demonstrerer tilstandsmatrixen, hele kompleksiteten af de overgange, der kræves for at systemet kan forblive effektivt. Derudover er selve den synkrone polling ret langsom:
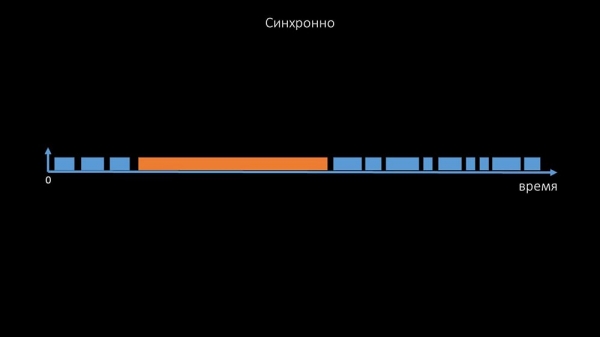
Netop derfor kunne tusinder af pollertråde på et dusin proxies ikke samle det nødvendige antal data til os. Den asynkrone implementering løste ikke kun problemerne med antallet af tråde, men forenklede også betydeligt systemet for tilstande af utilgængelige værter, fordi uanset hvor mange der blev tjekket i én polling-iteration, var den maksimale ventetid 1 timeout:
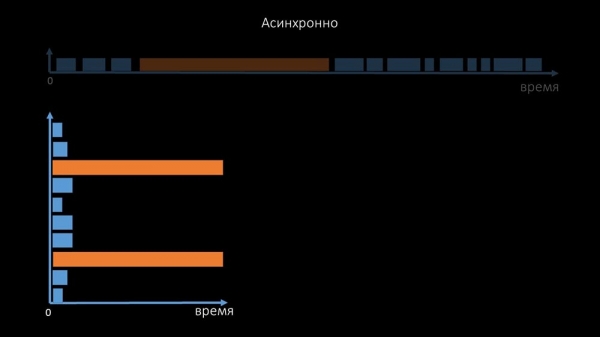
Derudover modificerede og forbedrede vi polling-systemet for SNMP-forespørgsler. Problemet er, at de fleste ikke kan svare på flere SNMP-forespørgsler samtidigt. Derfor lavede vi en hybridtilstand, hvor SNMP-polling af den samme vært udføres asynkront:
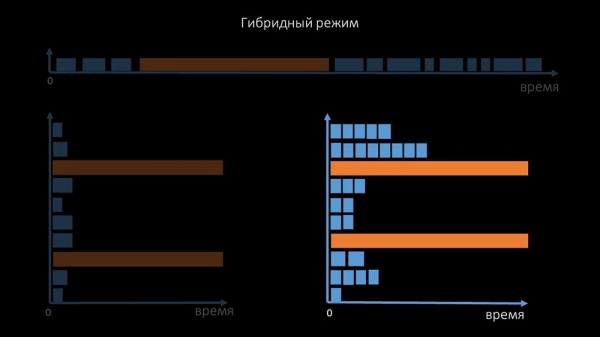
Dette gøres for en hel bunke værter. Denne tilstand er i sidste ende ikke langsommere end den helt asynkrone, da forespørgslen af 150 SNMP-værdier stadig er meget hurtigere end 1 timeout.
Vores eksperimenter viste, at det optimale antal forespørgsler pr. iteration er omkring 8000 ved SNMP-polling. Samlet set har overgangen til den asynkrone tilstand gjort det muligt at fremskynde pollingens ydeevne med 200 gange, i flere hundrede gange.
MCh: – De optimeringer af polling har vist, at vi ikke kun kan slippe af med alle proxies, men også forkorte intervallerne for mange kontroller, så proxies ikke længere er nødvendige som en metode til belastningsfordeling.
For cirka tre måneder siden
Ændr arkitekturen – øg belastningen!
MM: – Nå, Max, er det tid til produktion? Jeg har brug for en kraftfuld server og en god ingeniør.
MCh: – Godt, lad os planlægge det. Det er på høje tid at komme videre fra de 5.000 metrics i sekundet.
Morgen efter opgraderingen
MCh: – Misha, vi er blevet opgraderet, men til morgen er vi tilbage igen… Gæt hvilken hastighed vi nåede?
MM: – Maksimalt 20.000.
MCh: – Aha, 25! Desværre er vi der, hvor vi startede.
MM: – Hvad er der galt? Har I foretaget nogen diagnose?
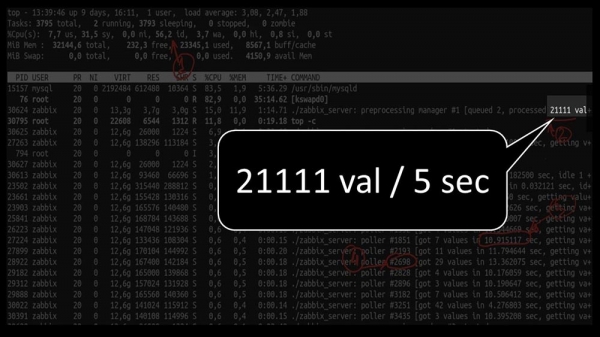
MCh: – Ja, selvfølgelig! Her, for eksempel, et interessant top:
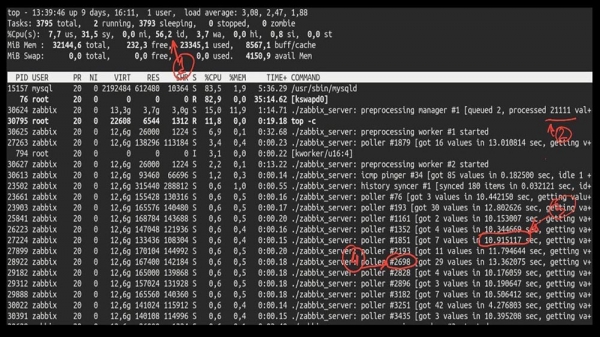
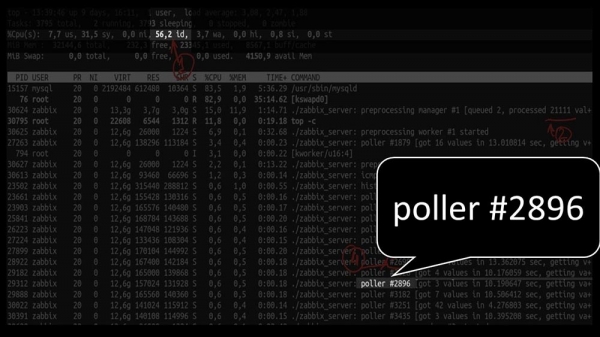
MM: – Lad os tage et kig. Jeg kan se, at vi har forsøgt med en enorm mængde polling-tråde:
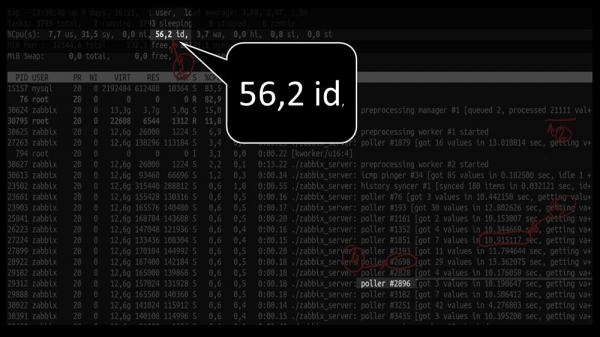
Men samtidig kunne vi ikke engang udnytte systemet halvt:
Og den samlede ydeevne er ret lav, omkring 4.000 metrics i sekundet:
Er der noget andet?
MCh: – Ja, strace fra en af pollerne:
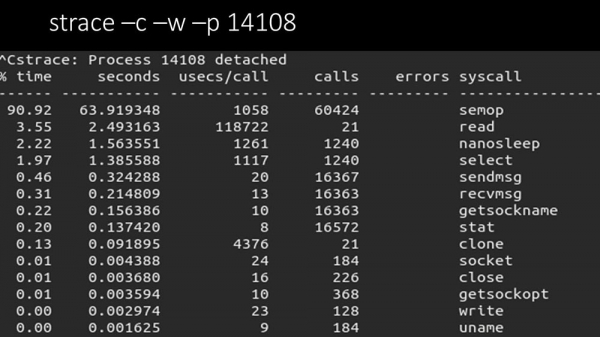
MM: – Her kan man tydeligt se, at polling-processen venter på 'semaforer'. Det er låsninger:
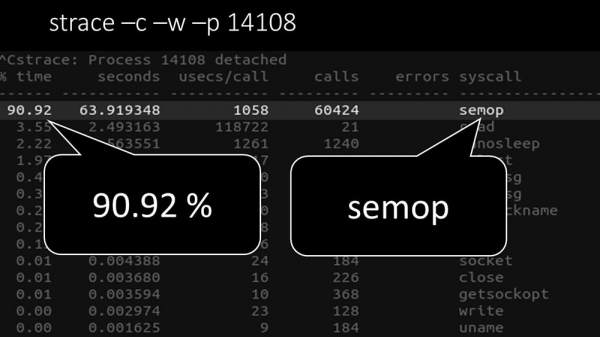
MCh: – Uforståeligt.
MM: – Se, det ligner en situation, hvor en masse tråde forsøger at arbejde med en ressource, som kun én kan arbejde med ad gangen. Så alt, hvad de kan gøre, er at dele denne ressource over tid:
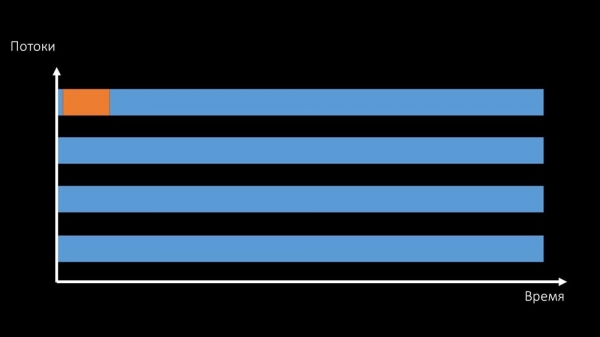
Og den samlede ydeevne ved arbejde med en sådan ressource er begrænset af hastigheden på én kerne:
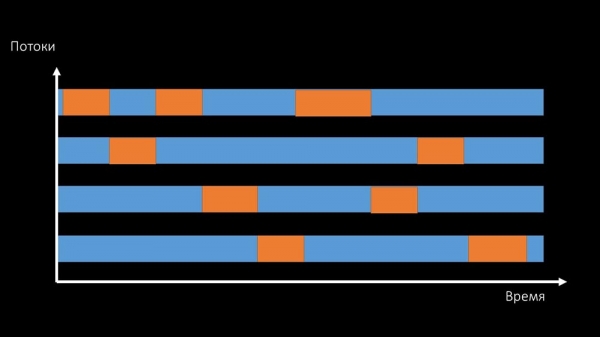
Sådan et problem kan løses på to måder.
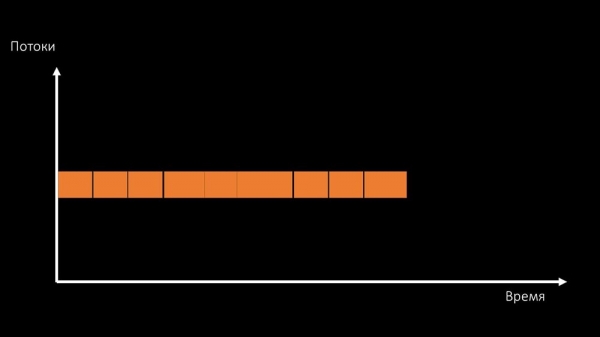
Opgradere maskinens hardware, skifte til hurtigere kerner:
Eller ændre arkitekturen og samtidig – belastningen:
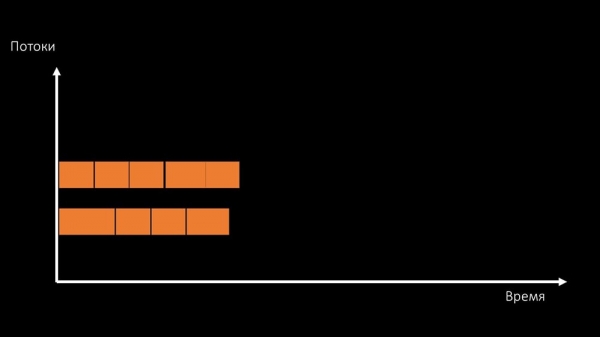
MCh: – For øvrigt, på den testmaskine bruger vi færre kerner end på den produktionsmaskine, men de er 1,5 gange hurtigere i frekvens pr. kerne!
MM: – Forstået? Vi må se på serverkoden.
Dataflowet i Zabbix-serveren
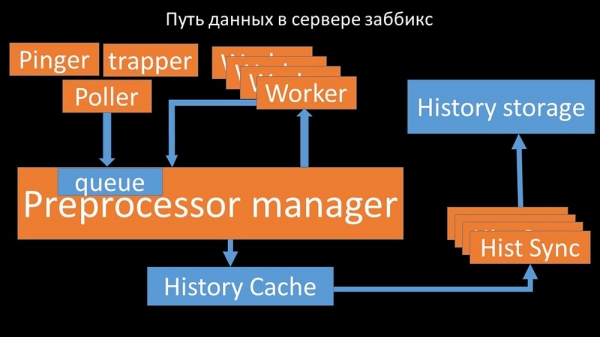
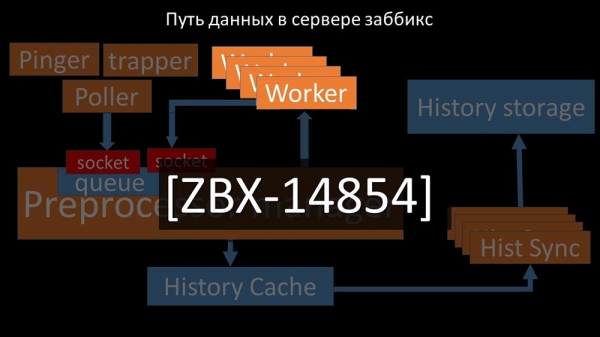
MCh: – For at finde ud af det, begyndte vi at analysere, hvordan data overføres inden i 'Zabbix'-serveren:
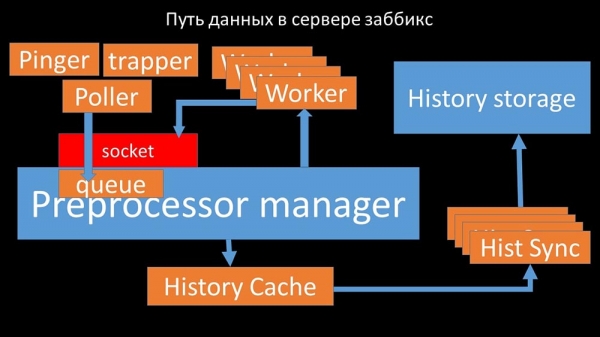
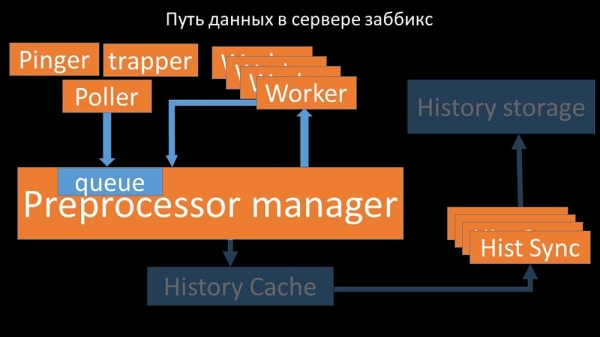
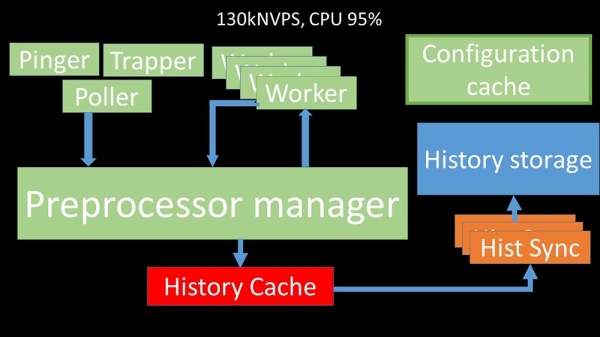
En flot illustration, ikke? Lad os se på den trin for trin for at gøre det mere klart. Der er tråde og tjenester, der er ansvarlige for indsamling af data:
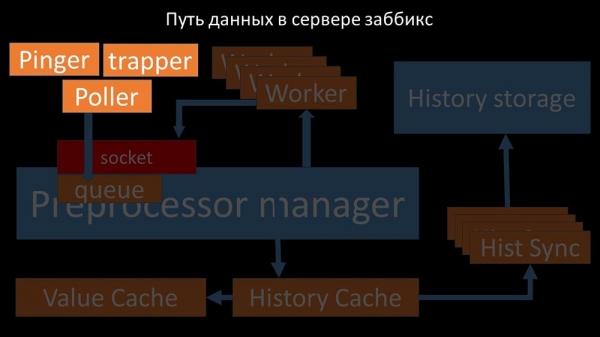
De indsamlede metrics sendes via en socket til Preprocessor manager, hvor de gemmes i en kø:
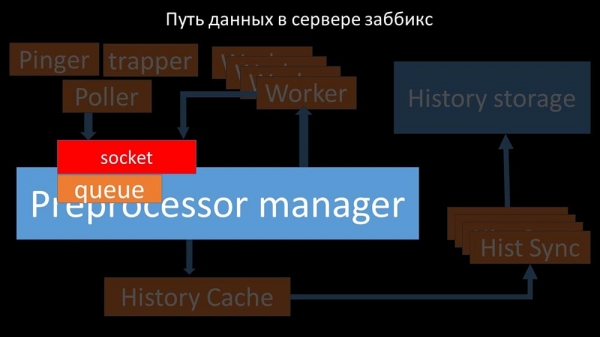
Preprocessor manageren sender dataene til sine arbejdere, som udfører forbehandlingsinstruktionerne og sender dem tilbage gennem den samme socket:
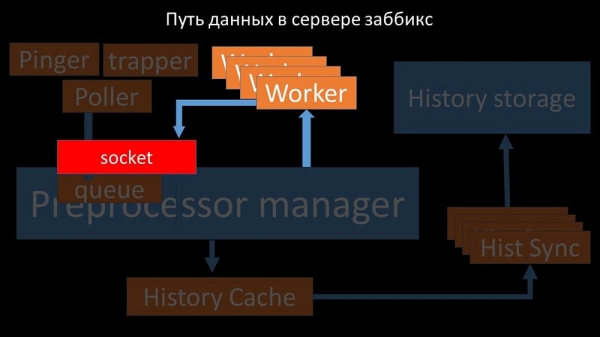
Efter dette gemmer forbehandlingschefen dem i historikens cache:
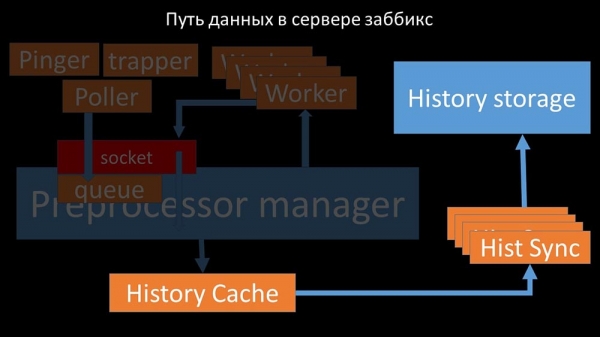
Derfra hentes de af historik-synkere, der udfører en hel del funktioner: for eksempel trigonometrisk beregning, udfyldning af cacheværdier og, vigtigst af alt, lagring af målinger i historiklagringen. Generelt er processen kompleks og ret forvirrende.
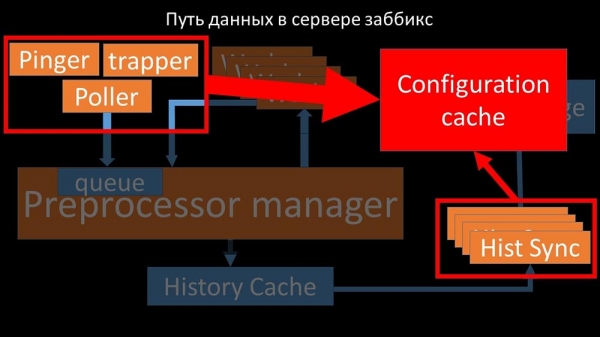
MM: – Det første, vi så, var, at de fleste tråde konkurrerede om den såkaldte "konfigurationscache" (et hukommelsesområde, hvor alle serverkonfigurationer opbevares). Især mange låsninger stammer fra tråde, der er ansvarlige for at hente data:
…da konfigurationen ikke kun indeholder målinger med deres parametre, men også køer, hvorfra pollere henter information om, hvad de skal gøre næste gang. Når der er mange pollere, og en låser konfigurationen, venter de andre på anmodninger:
Pollere må ikke konflikte
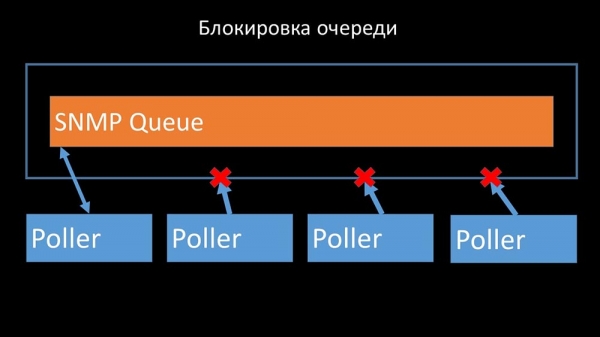
Så det første, vi gjorde, var at opdele køen i 4 dele og tillade pollerne at låse disse køer, disse dele samtidigt under sikre forhold:
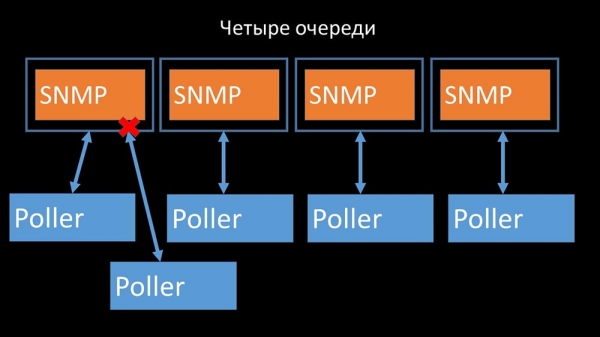
Dette fjernede konkurrencen om konfigurationscachen, og pollernes hastighed steg betydeligt. Men derefter stødte vi på, at forbehandlingschefen begyndte at opbygge en pulje af opgaver:
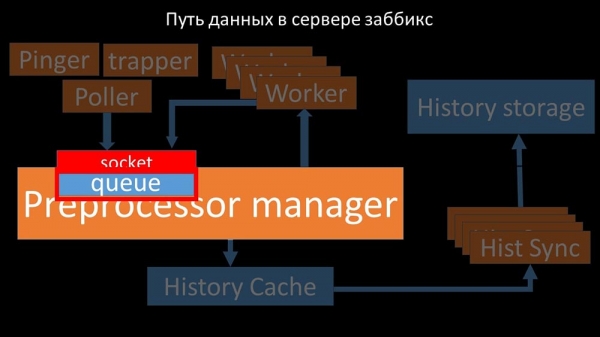
Forbehandlingschefen skal kunne prioritere
Dette skete i tilfælde, hvor han manglede ydeevne. Så alt, hvad han kunne gøre, var at samle anmodninger fra dataindsamlingsprocesserne og lægge dem i en buffer indtil han fyldte al hukommelsen og gik ned:
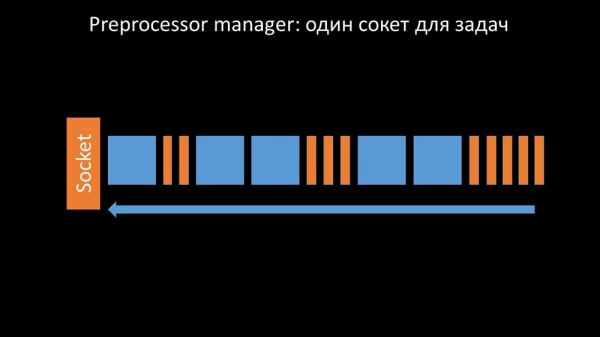
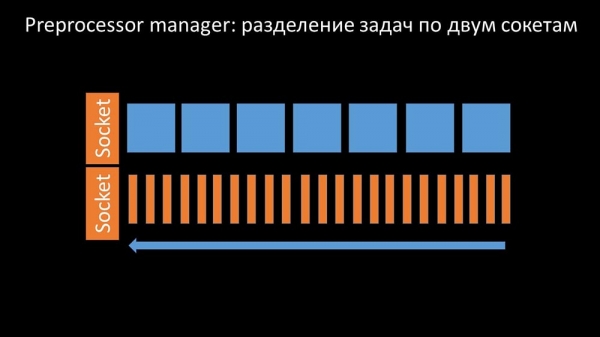
For at løse dette problem tilføjede vi en anden sokkel, der var dedikeret specifikt til arbejderne:
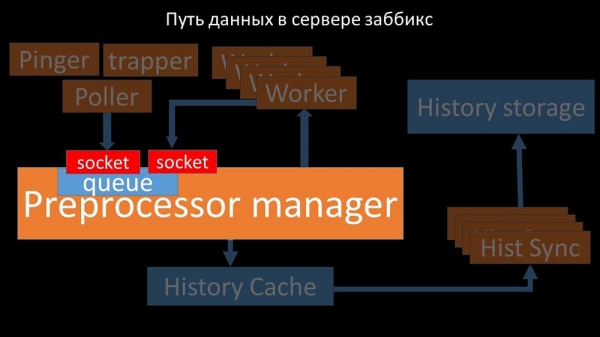
Dermed fik forbehandlingschefen mulighed for at prioritere sit arbejde, og i tilfælde af at bufferen voksede, ville opgaven bremse indsamlingen og give arbejderne mulighed for at tage bufferen:
Derefter opdagede vi, at en af årsagerne til bremserne var selve arbejderne, da de konkurrerede om en ressource, der ikke var vigtig for deres arbejde. Dette problem blev løst med en bug-fix, og i de nye versioner af "Zabbix" er det allerede afhjulpet:
Vi øger antallet af sokler – vi får resultater
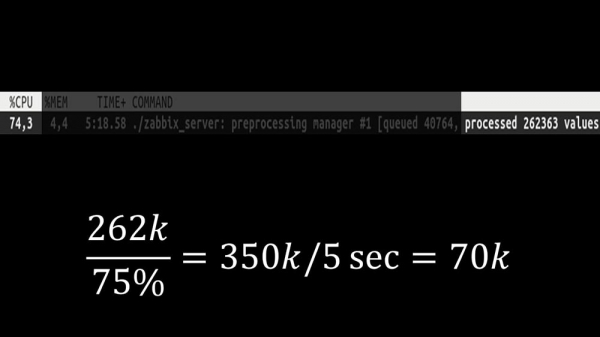
Dernæst blev selve forbehandlingschefen et snævert punkt, da det er en enkelt tråd. Den ramte hastigheden af kernen, hvilket gav en maksimal hastighed på cirka 70.000 målinger pr. sekund:
Derfor har vi lavet fire, med fire sæt af stik, arbejdere:
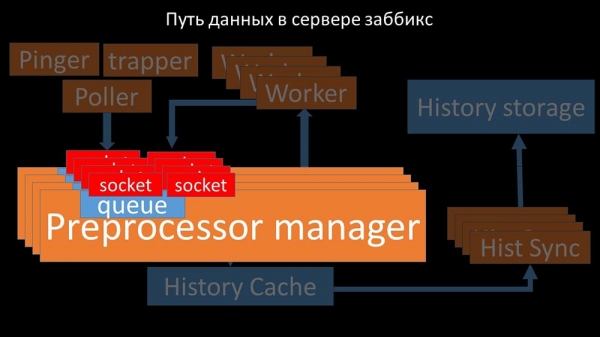
Og det har gjort det muligt at øge hastigheden til cirka 130.000 metrikker:
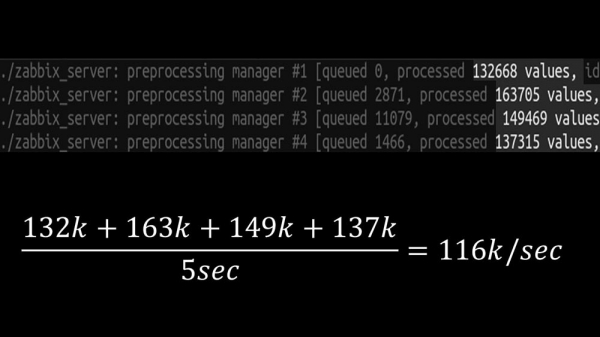
Den ikke-lineære vækst skyldes, at der er kommet konkurrence om cache-historikken. Fire præprocessormanager og history-synkere konkurrerede om det. På det tidspunkt opnåede vi omkring 130.000 metrikker pr. sekund på testmaskinen, og udnyttede den cirka 95 % på CPU'en:
For omkring 2,5 måneder siden
Afskaffelse af snmp-community øgede NVP'erne med halvanden gang
MM: – Max, jeg har brug for en ny testmaskine! Vi passer ikke længere ind i den nuværende.
MCh: – Hvad har vi nu?
MM: – Lige nu – 130k NVP'er og CPU'en "i stedet".
MCh: – Wow! Fantastisk! Vent, jeg har to spørgsmål. Ifølge mine beregninger har vi brug for omkring 15-20.000 metrikker pr. sekund. Hvorfor har vi brug for mere?
MM: – Jeg vil gerne gøre arbejdet helt færdigt. Jeg vil gerne se, hvor meget vi kan presse ud af dette system.
MCh: – Men…
MM: – Men det er ubrugeligt for forretningen.
MCh: – Forstået. Og det andet spørgsmål: kan vi selv vedligeholde det, vi har nu, uden hjælp fra udvikleren?
MM: – Jeg tror ikke det. Ændring af arbejdet med konfigurationscachen er et problem. Det involverer ændringer i de fleste strømme og er ret komplekst at vedligeholde. Det vil sandsynligvis være meget svært at vedligeholde.
MCh: – Så skal vi find en alternativ løsning.
MM: – Der er en mulighed. Vi kan skifte til hurtige kerner, samtidig med at vi opgiver det nye låsesystem. Vi vil stadig opnå en ydeevne på 60-80.000 metrikker. Samtidig kan vi bevare al anden kode. 'ClickHouse', asynkron polling vil fungere. Og det vil være nemt at vedligeholde.
MCh: – Fantastisk! Jeg foreslår, at vi stopper her.
Efter optimeringen af serverdelen kunne vi endelig lancerer den nye kode i produktion. Vi opgav nogle ændringer til fordel for overgangen til en maskine med hurtige kerner og minimalisering af antallet af ændringer i koden. Vi forenklede også konfigurationen og opgav makroer i datakomponenterne, når det var muligt, da de er kilden til yderligere blokeringer.
For eksempel har afskaffelsen af den makro, der ofte findes i dokumentationen og eksemplerne, snmp-community, i vores tilfælde tilladt yderligere at accelerere NVP'erne med cirka 1,5 gang.
Efter to dage i produktion
Vi fjerner pop op-vinduerne for hændelseshistorik
MCh: – Misha, vi har brugt systemet i to dage, og det fungerer. Men kun når det fungerer! Vi havde planlagt vedligeholdelse med flytning af et ret stort netværkssegment, og vi kontrollerede manuelt, hvad der var oppe, og hvad der ikke var.
MM: – Det kan ikke være muligt! Vi har tjekket det 10 gange. Serveren håndterer selv en komplet netværksnedbrud øjeblikkeligt.
MCh: – Jeg forstår det hele: server, database, top, austat, logs – alt går hurtigt… Men vi kigger på webgrænsefladen, og der er CPU'en "i hvile" på serveren, og så er der dette:
MM: – Forstået. Lad os kigge på web'en. Vi opdagede, at i situationer med mange aktive hændelser, begyndte de fleste operativwidgetter at køre meget langsomt:
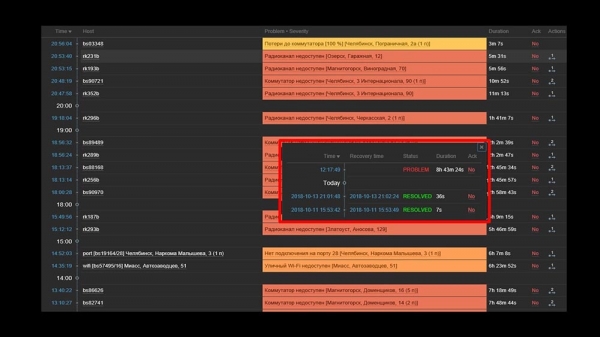
Årsagen var genereringen af pop-up vinduer med hændelseshistorik, der genereres for hvert element i listen. Derfor stoppede vi med at generere disse vinduer (vi kommenterede 5 linjer i koden), og det løste vores problemer.
Indlæsningstiden for widgetter selv ved komplet nedbrud reduceredes fra flere minutter til acceptable 10-15 sekunder for os, og historien kan stadig ses med et klik på tiden:
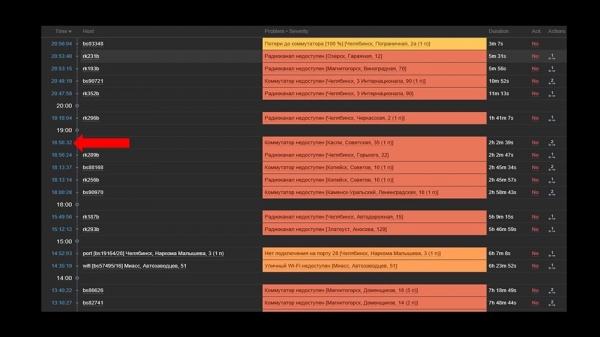
Efter arbejdet. For 2 måneder siden
MCh: – Misha, går du? Vi skal tale.
MM: – Jeg havde ikke tænkt mig det. Er der igen noget med "Zabbix"?
MCh: – Nej, slap af! Jeg ville bare sige: alt fungerer, tak! Øl på mig.
Zabbix er effektivt
"Zabbix" er et ret universelt og rigt system og funktion. Det kan sagtens bruges til små installationer "out of the box", men med voksende behov skal det optimeres. Brug et passende lager til at opbevare et stort arkiv af målinger:
- du kan bruge de indbyggede værktøjer i form af integration med "Elasticsearch" eller eksportere historikken til tekstfiler (tilgængeligt fra fjerde version);
- du kan dra nytte af vores erfaring og integration med "ClickHouse".
For at radikalt øge hastigheden af dataindsamling, saml dem med asynkrone metoder og overfør dem via trapper-interface til "Zabbix"-serveren; eller du kan bruge en patch til asynkronitet for selve "Zabbix"'s pollere.
«Zabbix» er skrevet i C og er ret effektiv. Nogle løsninger på smalle arkitektoniske steder gør det muligt at øge dens ydeevne yderligere, og efter vores erfaring kan man få mere end 100.000 metrikker på en enkeltprocessor-maskine.
Den samme Zabbix-patch
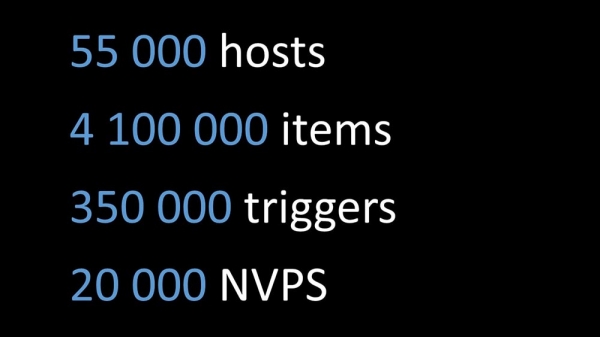
MM: – Jeg vil gerne tilføje et par punkter. Hele den nuværende præsentation, alle testene, tallene er givet for den konfiguration, vi bruger. Fra den tager vi nu cirka 20.000 metrikker i sekundet. Hvis du forsøger at forstå, om det vil fungere for dig – kan du sammenligne. Det, vi har præsenteret i dag, er tilgængeligt på GitHub som en patch:
Patchen inkluderer:
- fuld integration med «ClickHouse» (både Zabbix-servere og frontend);
- løsning af problemer med præprocessor-manageren;
- asynkron polling.
Patchen er kompatibel med hele version 4, inklusive lts. Sandsynligvis vil den fungere med minimale ændringer på version 3.4.
Tak for opmærksomheden.
Spørgsmål
Spørgsmål fra publikum (herefter – A): – Goddag! Kan I fortælle mig, om I har planer om intenst samarbejde med Zabbix-teamet eller de med jer, så dette ikke vil være en patch, men et normalt adfærd for «Zabbix»?
MM: – Ja, nogle ændringer vil vi helt sikkert commite. Nogle ting vil blive, som de er, i patchen.
A: – Tusind tak for en fremragende præsentation! Kan I fortælle mig, efter anvendelse af patchen, vil støtten fra «Zabbix» forblive, og hvordan kan man derefter opgradere til højere versioner? Vil det være muligt at opgradere «Zabbix» til 4.2, 5.0 efter jeres patch?
MM: – Om support kan jeg ikke sige. Hvis jeg var support for «Zabbix», ville jeg sandsynligvis sige nej, fordi det er anden parts kode. Hvad angår kodebasen 4.2, er vores position sådan: «Vi vil følge med tiden og selv opgradere til den næste version». Derfor vil vi i et stykke tid udgive patchen til de opdaterede versioner. Jeg sagde allerede i præsentationen: Antallet af ændringer mellem versionerne er indtil videre ret lille. Jeg tror, at overgangen fra 3.4 til 4 tog os cirka 15 minutter. Der ændrede sig lidt, men ikke noget vigtigt.
A: – Så I planlægger at støtte jeres patch, og man kan trygt installere det i produktionen, og senere få opdateringer på en eller anden måde?
MM: – Vi anbefaler det kraftigt. Det løser mange problemer for os.
MCh: – Jeg vil endnu engang understrege, at ændringer, der ikke vedrører arkitekturen og ikke involverer blokeringer eller køer, de er modulerede, de er i separate moduler. Selv ved mindre ændringer kan de holdes ret nemt.
MM: – Hvis du er interesseret i detaljerne, så bruger «Klikhaus» det såkaldte historiebibliotek. Det er adskilt – det er en kopi af «Elastix»'s støtte, det vil sige, det kan konfigureres. Polling ændrer kun pollere. Vi mener, at det vil fungere i lang tid.
A: – Mange tak. Kan du fortælle, om der findes nogen dokumentation for de foretagne ændringer?
MM: – Dokumentationen er et patch. Det er åbenlyst, at med introduktionen af «Klikhaus», med indførelsen af nye typer pollere, opstår der nye konfigurationsmuligheder. Der er et kort beskrivelser i linket fra den sidste slide, om hvordan man bruger dette.
Om udskiftning af fping med nmap
A: – Hvordan har I i sidste ende implementeret dette? Kan du give konkrete eksempler: bruger I strappere og et eksternt script? Hvad kontrollerer så hurtigt et så stort antal værter? Hvordan får I de værter? Skal man på en eller anden måde fodre nmap med dem, få dem fra et sted, lægge dem ind, starte noget op?..
MM: – Fedt. Meget relevant spørgsmål! Essensen er denne. Vi har modificeret biblioteket (ICMP ping, en del af «Zabbix») til ICMP-tjek, hvor antallet af pakker er én (1), og koden forsøger at bruge nmap. Så det er Zabbix' interne arbejde, det er blevet til pingers interne arbejde. Derfor kræves der ingen synkronisering eller brug af en trapper. Dette blev gjort bevidst for at bevareystemet intakt og undgå at synkronisere to systemer, som skal kontrolleres, uploads via polleren, og om vores upload er brudt?.. Det er meget enklere.
A: – Gælder dette også for proxy?
MM: – Ja, men vi har ikke testet det. Koden til polling er den samme i både Zabbix og serveren. Det burde fungere. Jeg vil endnu en gang understrege: systemets ydeevne er sådan, at vi ikke har brug for en proxy.
MCh: – Det rigtige svar på spørgsmålet er: «Hvorfor har I brug for en proxy med et sådant system?» Kun på grund af NAT eller for at overvåge gennem en langsom kanal…
A: – Og bruger I «Zabbix» som alerter, hvis jeg har forstået det korrekt? Eller er grafikkerne (hvor det arkiverede lag er) flyttet til et andet system, som Grafana? Eller bruger I ikke denne funktion?
MM: – Jeg vil endnu en gang understrege: vi har gennemført fuld integration. Vi sender historikken til ‘Clickhouse’, men har samtidig ændret PHP-frontenden. PHP-frontenden henter data fra ‘Clickhouse’ og laver alle grafer derfra. Ærligt talt har vi også en del, der bygger data i andre grafiske systemer baseret på de samme data fra ‘Zabbix’.
MCh: – Inkluderet i ‘Grafana’.
Hvordan blev beslutningen om tildeling af ressourcer truffet?
A: – Del lidt af den interne proces. Hvordan blev beslutningen om at tildele ressourcer til en seriøs omarbejdning af produktet truffet? Det indebærer jo visse risici. Og fortæl mig venligst i forhold til at I planlægger at støtte nye versioner: hvordan retfærdiggøres denne beslutning i forhold til ledelsen?
MM: – Tilsyneladende har vi ikke fortalt dramaet i historien særlig godt. Vi befandt os i en situation, hvor der skulle gøres noget, og vi gik i praksis med to parallelle teams:
- Det ene arbejdede på at lancere et overvågningssystem med nye metoder: overvågning som en service, et standard sæt af open source-løsninger, som vi kombinerer og derefter forsøger at ændre forretningsprocesserne for at arbejde med det nye overvågningssystem.
- Samtidig havde vi en entusiastisk programmør, der beskæftigede sig med det (om sig selv). Det viste sig, at han vandt.
A: – Og hvad er teamets størrelse?
MCh: – De står foran jer.
A: – Så som altid er der brug for en passioneret leder?
MM: – Jeg ved ikke, hvad en passioneret leder er.
A: – I det tilfælde, ser det ud til, at det er dig. Mange tak, I er fantastiske.
MM: – Tak.
Om patches til Zabbix
A: – For et system, der bruger proxy (for eksempel i nogle distribuerede systemer), er det muligt at tilpasse og patch dine løsninger, lad os sige, pullere, proxy og delvist præprocessor for selve ‘Zabbix’; og deres interaktion? Er det muligt at optimere de eksisterende løsninger til et system med flere proxyer?
MM: – Jeg ved, at ‘Zabbix’-serveren bygges med hjælp fra proxy (kompileres og koden genereres). Vi har ikke testet dette i produktion. Jeg er ikke sikker på det, men efter min mening bruges præprocessor-manager ikke i proxy. Proxyens opgave er at tage et sæt metric fra ‘Zabbix’, indsamle dem (den registrerer også konfigurationen, den lokale database) og sende dem tilbage til ‘Zabbix’-serveren. Præprocesseringen vil blive udført af serveren selv, når den modtager dataene.
Interessen for proxy er forståelig. Vi vil undersøge det. Det er et interessant emne.
A: – Ideen var, at hvis man kan patche pollere, kan man patche dem til proxy og tilpasse interaktionen med serveren, og preprocessoren kun tilpasse disse formål på serveren.
MM: – Jeg tror, det er faktisk enklere. Du tager koden, anvender patchen, konfigurerer som du ønsker – samler proxy-servere (for eksempel med ODBC) og distribuerer den patcherede kode til systemerne. Hvor det er nødvendigt, samler du proxy, hvor det er nødvendigt, server.
A: – Skal man ikke også patch overførslen af proxy til serveren, sandsynligvis?
MCh: – Nej, det er standard.
MM: – Faktisk lød det ikke som en af idéerne. Vi har altid stræbt efter at opretholde en balance mellem ideernes eksplosion og antallet af ændringer, nemhedsgraden ved vedligeholdelse.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
