

I denne artikel præsenterer jeg mine tanker om historien og fremtiden for internettet, centraliserede og decentraliserede netværk, og som resultat — den mulige arkitektur for et decentraliseret netværk af næste generation.
Der er noget galt med internettet
Jeg blev første gang bekendt med internettet i 2000. Selvfølgelig er det langt fra begyndelsen — nettet havde allerede eksisteret før dette, men den tid kan kaldes internettets første blomstring. World Wide Web — et genialt opfindelse af Tim Berners-Lee, web1.0 i sin klassiske kanoniske form. Mange hjemmesider og sider, der linker til hinanden via hyperlinks. Ved første øjekast — en simpel, som alt genialt, arkitektur: decentraliseret og frit. Jeg vil — rejse rundt på andres hjemmesider ved at klikke på hyperlinks; jeg vil — oprette min egen hjemmeside, hvor jeg deler det, jeg finder interessant — for eksempel mine artikler, billeder, programmer, hyperlinks til interessante sider for mig. Og andre placerer links til mig.
Det synes som — et idyllisk billede? Men du ved allerede, hvordan det hele endte.
Antallet af sider blev for stort, og det blev en ret kompliceret opgave at finde information. De hyperlinks, der var oprettet af forfattere, kunne simpelthen ikke strukturere denne enorme mængde information. Først kom der kataloger, fyldt manuelt, og derefter kæmpe søgemaskiner, der begyndte at bruge snedige heuristiske rangordningsalgoritmer. Hjemmesider blev oprettet og droppet, information blev duplikeret og forvansket. Internettet blev hastigt kommercialiseret og bevægede sig længere væk fra det ideelle akademiske netværk. Markup-sproget blev hurtigt til et formateringssprog. Reklame opstod, grimme, generende bannere, og teknologien til promovering og bedrageri af søgemaskiner — SEO. Nettet blev hurtigt fyldt med informationsaffald. Hyperlinks stoppede med at være et værktøj til logisk forbindelse og blev et værktøj til promovering. Hjemmesider blev lukket inde, blev selvforsynende, forvandlede sig fra åbne "sider" til hermetiske "apps" og blev kun midler til indtjening.
Allerede dengang havde jeg en følelse af, at "der er noget galt her". En masse forskellige hjemmesider, fra primitive personlige sider med blændende design til "megaportaler", der er overfyldt med blinkende bannere. Selvom hjemmesiderne var om det samme emne, var de slet ikke forbundet, hver med sit eget design, sin egen struktur, irriterende bannere, dårligt fungerende søgning, problemer med at downloade (ja, jeg ville have information offline). Allerede dengang begyndte internettet at blive noget, der mindede om tv, hvor nyttigt indhold blev spikret sammen med al slags pynt.
Decentralisering er blevet et mareridt.
Hvad ønsker jeg?
Paradoxalt nok, allerede dengang, uden at vide noget om web 2.0 eller p2p, havde jeg som bruger ikke brug for decentralisering! Når jeg tænker tilbage på mine ubekymrede overvejelser fra dengang, er jeg kommet til den konklusion, at jeg havde brug for... en samlet database! En, hvor en forespørgsel ville returnere alle resultater, i stedet for de mest passende til rangeringsalgoritmen. En, hvor alle disse resultater ville være præsenteret ensartet og stiliseret efter mit eget ensartede design, og ikke med de blændende, hjemmelavede designs fra utallige Vasya Pupkin. En, som jeg kunne gemme offline uden at frygte, at hjemmesiden forsvandt, og informationen ville gå tabt for altid. En, hvor jeg kunne indtaste mine egne oplysninger — som kommentarer og tags. En, hvor jeg kunne udføre søgning, sortering og filtrering med mine egne personlige algoritmer.
Web 2.0 og sociale medier
I mellemtiden trådte konceptet Web 2.0 ind på scenen. Formuleret i 2005 af Tim O'Reilly som "metoden til at designe systemer, der bliver bedre, jo flere der bruger dem", og som indebærer aktiv involvering af brugerne i kollektiv skabelse og redigering af indholdet på nettet. Uden overdrivelse blev sociale medier højdepunktet og triumfen af dette koncept. Kæmpe platforme, der forener milliarder brugere og opbevarer hundredevis af petabyte data.
Hvad har vi fået i sociale medier?
- ensartning af grænsefladen; det viste sig, at brugerne ikke har brug for alle mulighederne for at skabe en række forskellige blændende designs; alle brugeres sider har det samme design, og det er de tilfredse med, og det er endda praktisk; kun indholdet er forskelligt.
- ensartning af funktionaliteten; den mangfoldighed af scripts viste sig også at være unødvendig. 'Nyhedsfeed', venner, albums... funktionaliteten har stabiliseret sig mere eller mindre over tid i sociale medier og vil næppe ændre sig: funktionaliteten er bestemt af menneskers aktivitetsformer, og mennesker ændrer sig praktisk talt ikke.
- én database; det viste sig at være meget lettere at arbejde med en sådan database end med mange adskilte sider; søgning blev meget simplere. I stedet for konstant at scanne en lang række svagt forbundne sider, cache alle disse, rangordne efter komplekse heuristiske algoritmer — en relativt simpel ensartet forespørgsel til en enkelt database med kendt struktur.
- feedback-grænseflade — likes og delinger; i den almindelige webverden kunne selv Google ikke få feedback fra brugerne efter at de havde klikket på et link i søgeresultaterne. I sociale medier viste denne forbindelse sig at være simpel og naturlig.
Hvad har vi mistet? Vi har mistet decentralisering, og dermed — frihed.. Det antages, at vores data nu ikke tilhører os. Tidligere kunne vi placere en personlig hjemmeside på enhver computer, men nu overgiver vi alle vores data til internettets giganter.
Derudover, i takt med internettets udvikling, er regeringer og virksomheder blevet interesserede, hvilket har givet anledning til problemer med politisk censur og copyright-restriktioner. Vores sider på sociale medier kan blive blokeret og slettet, hvis indholdet ikke overholder visse regler for sociale medier; for et uforsigtigt indlæg — kan man blive draget til ansvar både administrativt og endda kriminelt.
Og nu tænker vi igen: Skal vi ikke have decentralisering tilbage? Men i en anden form, fri for første forsøg's mangler?
P2P-netværk
De første p2p-netværk dukkede op længe før web 2.0 og udviklede sig parallelt med webens fremgang. Den mest klassiske anvendelse af p2p er fildeling; de første netværk blev udviklet til at dele musik. De første netværk (såsom Napster) var i sin essens centraliserede, og derfor blev de ret hurtigt lukket af rettighedshaverne. Efterfølgere gik i retning af decentralisering. I 2000 dukker protokollerne ED2K (den første klient eDokney) og Gnutella op, i 2001 — protokollen FastTrack (klienten KaZaA). Gradvist voksede graden af decentralisering, teknologierne blev forbedret. I stedet for systemer med
Imidlertid har p2p-netværkene mange ulemper. Udover de tekniske mangler, der er knyttet til hver enkelt implementering af protokollen og klienten, kan man for eksempel nævne en ret generel ulempe — vanskelighederne ved søgning (dvs. alt det, som Web 1.0 har oplevet, men i en endnu mere kompleks variant). Her er der ikke noget Google med sin allestedsnærværende og øjeblikkelige søgning. Og hvis det for fildelingsnetværkene stadig er muligt at benytte søgning efter filnavn eller metadata, er det ret vanskeligt at finde noget i overlay-netværkene onion eller i2p, hvis overhovedet muligt.
Generelt set, hvis man drager paralleller til det klassiske internet, så sidder de fleste decentraliserede netværk fast et sted på niveau med FTP. Forestil dig et internet, hvor der ikke er noget andet end FTP: ingen moderne hjemmesider, ingen web2.0, ingen YouTube... Sådan er decentraliserede netværk nogenlunde. Og på trods af enkelte forsøg på at ændre noget, er der indtil videre få ændringer.
Indhold
Lad os se på en anden vigtig del af dette puslespil - indholdet. Indhold er det centrale problem for enhver internetressource, især for decentraliserede. Hvor skal man hente det fra? Selvfølgelig kan man stole på en gruppe entusiaster (som det er tilfældet med de eksisterende p2p-netværk), men så vil udviklingen af netværket være ret langvarig, og der vil være lidt indhold.
Arbejdet med almindeligt internet handler om at finde og studere indhold. Nogle gange - gemme det (hvis indholdet er interessant og nyttigt, så gemmer mange, især dem der kom til nettet i dial-up tiden - heriblandt mig - fornuftigt det offline, så det ikke går tabt; for internettet er noget, vi ikke kan kontrollere, i dag er der et site, i morgen er det væk, i dag er der en video på YouTube - i morgen er den slettet, osv.
Og for torrents (som vi betragter mere som et middel til levering end som et p2p-netværk) indebærer opbevaring faktisk. Og det er forresten et af problemerne med torrents: en fil, der er downloadet én gang, er svær at flytte til et mere brugervenligt sted (som regel skal man manuelt regenerere delingen) og kan slet ikke omdøbes (man kan lave et hardlink, men det kender virkelig kun meget få).
Generelt gemmer mange på en eller anden måde indhold. Hvad sker der med det efterfølgende? Normalt ender gemte filer et eller andet sted på drevet, i en mappe som Downloads, i en stor bunke, og ligger der sammen med mange tusinde andre filer. Det er dårligt - og det er skidt for brugeren selv. Hvis internettet har søgemaskiner, så har brugerens lokale computer ikke noget lignende. Det er godt, hvis brugeren er ordentlig og vant til at sortere „indgående“ downloadede filer. Men langt fra alle er sådan...
Faktisk er der nu også mange, der ikke gemmer noget, men kun stoler på online. Men i p2p-netværk antages det, at indholdet opbevares lokalt på brugerens enhed og deles med andre deltagere. Er det muligt at finde en løsning, der kan involvere begge kategorier af brugere i et decentraliseret netværk, uden at ændre deres vaner, og endda - lettet deres liv?
Ideen er ret simpel: hvad hvis vi laver et middel til nem og gennemsigtig gemning af indhold fra det almindelige internet, men smart opbevaring - med semantisk metadata, og ikke i en samlet bunke, men i en bestemt struktur med mulighed for videre struktureret opbevaring, samtidig med at vi distribuerer det gemte indhold i et decentraliseret netværk?
Lad os starte med gemning
Vi vil ikke overveje det praktiske brug af internettet til at se vejrudsigter eller flytider. Vi er mere interesserede i selvforsynende og mere eller mindre uforanderlige objekter - artikler (fra tweets/posts på sociale medier til større artikler som dem her på Habré), bøger, billeder, programmer, lyd- og videooptagelser. Hvor kommer informationen mest fra? Normalt er det
- sociale medier (forskellige nyheder, små notater - "tweets", billeder, lyd og video)
- artikler på tematiske ressourcer (som Habré); der er ikke så mange gode ressourcer, normalt er disse ressourcer også bygget på princippet om sociale medier
- nyhedssider
Som regel er der standardfunktioner: "like", "del", "del på sociale medier" osv.
Lad os forestille os et browser-plugin, der på en særlig måde vil gemme alt det, vi har givet et like, delt, gemt i "favoritter" (eller trykket på en speciel knap i pluginet, der er vist i browserens menu - i tilfælde af at webstedet ikke har en like-/del-funktion/tilføje til bogmærker). Hovedideen er, at du blot giver et like - som du har gjort en million gange før, og systemet gemmer artiklen, billedet eller videoen i et specielt offline-lager, og denne artikel eller dette billede bliver tilgængeligt - både for dig til offline-visning gennem grænsefladen i det decentraliserede klient og i selve det decentraliserede netværk! Synes jeg er meget praktisk. Ingen unødvendige handlinger, og vi løser straks mange opgaver:
- gemme værdifuldt indhold, der kan gå tabt eller blive slettet
- hurtig fyldning af det decentraliserede netværk
- aggregering af indhold fra forskellige kilder (du kan være registreret på dusinvis af internetressourcer, og alle likes/delinger vil strømme ind i en samlet lokal database)
- strukturerer interessant indhold for dig dine reglerne
Det er åbenlyst, at browser-plugin'et skal tilpasses strukturen af hver hjemmeside (det er helt muligt — der findes allerede plugins til at gemme indhold fra Youtube, Twitter, VK osv.). Antallet af hjemmesider, for hvilke det giver mening at lave personlige plugins, er ikke så mange. Som regel er det udbredte sociale netværk (der er næppe mere end et dusin), samt et begrænset antal høj-kvalitets temahjemmesider som Habr (der er også få af dem). Med åben kildekode og specifikation bør udviklingen af et nyt plugin baseret på en skabelon ikke tage lang tid. For de øvrige hjemmesider kan man anvende en universel gemme-knap, der gemmer hele siden i mhtml — måske efter først at have renset siden for reklamer.
Nu om strukturen
Med "smart" gemning mener jeg som minimum gemning med metadata: kilden til indholdet (URL), sættet af tidligere likes, tags, kommentarer, deres identifikatorer osv. For ved almindelig gemning går disse informationer tabt... Kilden kan forstås ikke kun som den direkte URL, men også den semantiske komponent: for eksempel en gruppe på et socialt netværk eller en bruger, der har delt et indlæg. Plugin'et kan være smart nok til at bruge disse informationer til automatisk at strukturere og tagge. Derudover skal det forstås, at brugeren altid kan tilføje en vis metadata til det gemte indhold, og der bør derfor være maksimalt brugervenlige grænseflader til dette (jeg har mange ideer til, hvordan det kan gøres).
Dermed løses spørgsmålet om strukturering og organisering af brugerens lokale filer. Det er allerede en nyttig ressource, som man kan få glæde af, selv uden enhver p2p. Bare en slags offline database, der ved, hvad, hvorfra og i hvilken kontekst vi har gemt, og tillader små undersøgelser. For eksempel, at finde brugere på et eksternt socialt netværk, der har givet flest likes på de samme indlæg som dig. Er der mange sociale netværk, der tillader dette åbent?
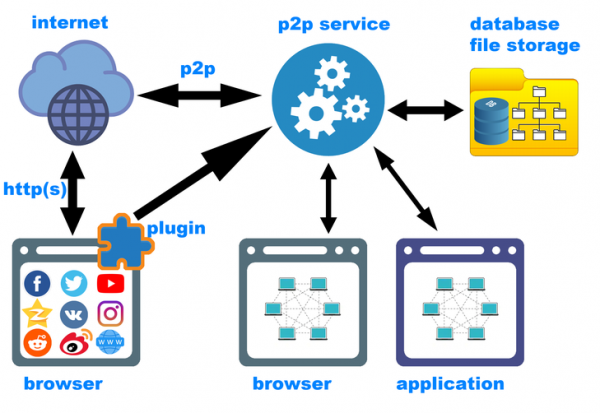
Her bør det nævnes, at en browser-plugin selvfølgelig ikke er nok alene. Den anden vigtigste komponent i systemet er en decentraliseret netværkstjeneste, der kører i baggrunden og håndterer både p2p-netværket (forespørgsler fra nettet og fra klienten) samt opbevaringen af nyt indhold ved hjælp af plugin'en. Tjenesten, der arbejder sammen med plugin'en, vil placere indholdet det rigtige sted, beregne hashes (og muligvis bestemme, om dette indhold allerede er blevet gemt før), og tilføje den nødvendige metainformation til den lokale database.
Interessant nok ville systemet allerede være nyttigt i denne form, uden nogen p2p. Mange bruger web-clippere, der tilføjer interessant indhold fra nettet til f.eks. Evernote. Den foreslåede arkitektur er en udvidet version af en sådan clipper.
Og endelig, p2p udveksling
Det mest behagelige er, at information og metainformation (både indfanget fra nettet og egen) kan deles. Konceptet for et socialt netværk overføres perfekt til p2p-arkitekturen. Man kan sige, at sociale netværk og p2p næsten er skabt for hinanden. Enhver decentraliseret netværk bør ideelt set være bygget som et socialt netværk; kun da vil det fungere effektivt. "Venner", "Grupper" — det er de sværmer, der skal have stabile forbindelser, og sådanne forbindelser opstår fra en naturlig kilde — brugernes fælles interesser.
Principperne for opbevaring og deling af indhold i et decentraliseret netværk er fuldstændig identiske med principperne for opbevaring (indfangning) af indhold fra det almindelige internet. Hvis du bruger noget indhold fra nettet (og dermed har gemt det), kan alle bruge dine ressourcer (disk og båndbredde), der er nødvendige for at hente netop dette indhold.
Likes er det simpleste værktøj til opbevaring og deling. Hvis jeg giver et like — uanset om det er på internettet eller inden for det decentraliserede netværk — betyder det, at jeg kan lide indholdet, og derfor er jeg villig til at have det gemt lokalt og dele det med andre deltagere i det decentraliserede netværk.
- Indholdet vil ikke "gå tabt"; det er nu gemt lokalt hos mig, jeg kan vende tilbage til det senere, når som helst, uden at bekymre mig om, at nogen sletter det eller blokerer det.
- Jeg kan (straks eller senere) kategorisere det, tagge, kommentere, associere med andet indhold, kort sagt gøre noget meningsfuldt med det - lad os kalde det «skabelse af metadata».
- Jeg kan dele disse metadata med andre deltagere i netværket.
- Jeg kan synkronisere mine metadata med metadata fra andre deltagere.
Det giver nok mening at afskaffe dislike-funktionen: hvis jeg ikke kan lide indholdet, er det logisk, at jeg ikke ønsker at bruge min diskplads på at gemme det og mit internetforbrug på at distribuere dette indhold. Derfor passer dislikes ikke ind i decentraliseringen (selvom det nogle gange faktisk kan være nyttigt). ).
Bogmærker.
«» (eller «Favoritter») - jeg udtrykker ikke min holdning til indholdet, men gemmer det i min lokale bogmærkebase. Ordet «favoritter» passer ikke helt i betydningen (til dette er der likes og deres efterfølgende kategorisering), mens «bogmærker» (bookmarks) passer helt. Indhold i «bogmærker» distribueres også - hvis du «skal bruge» det (dvs. du på en eller anden måde «bruger» det), er det logisk, at det også kan være «nødvendigt» for andre. Hvorfor ikke bruge dine ressourcer til det?Funktionen «
venner« er ret åbenlys. Det er fester, mennesker med lignende interesser, og dermed dem, der sandsynligvis vil finde interessant indhold. I et decentraliseret netværk betyder det først og fremmest at abonnere på nyhedsfeeds fra venner og have adgang til deres kataloger (albums) med det indhold, de har gemt.På samme måde er funktionen «
» - nogen kollektive feeds, eller fora, eller noget i den stil, som også kan abonneres på - og dermed modtage alle gruppens materialer og distribuere dem. Måske bør «grupper», ligesom store fora, være hierarkiske - det ville gøre det muligt bedre at strukturere gruppens indhold samt begrænse informationsstrømmen og undgå at modtage/distribuere det, der ikke er særlig interessant for dig.grupperAlt andet.
Alt andet
Det skal bemærkes, at en decentral arkitektur altid er mere kompleks end en centraliseret. I centraliserede ressourcer er der et strengt diktat fra serverkoden. I decentraliserede løsninger er der behov for forhandling mellem mange lige deltagere. Selvfølgelig kan man ikke undgå kryptografi, blockchains og andre fremskridt, som primært er blevet udviklet i forbindelse med kryptovalutaer.
Jeg antager, at der kan være behov for nogle kryptografiske gensidige tillidsvurderinger, der dannes af deltagerne i netværket for hinanden. Arkitekturen skal muliggøre effektiv bekæmpelse af botnet, som i et cloud-miljø kan f.eks. manipulere deres egne vurderinger. Jeg håber meget, at virksomheder og botnet-farme, trods deres teknologiske overlegenhed, ikke får kontrol over et sådant decentralt netværk; at dets primære ressourcer vil være levende mennesker, der kan producere og strukturere indhold, som er interessant og nyttigt for andre levende mennesker.
Jeg ønsker også, at et sådant netværk skal drive civilisationen fremad mod fremskridt. Jeg har mange ideer om dette, som ikke passer ind i rammerne for denne artikel. Jeg vil blot sige, at på en eller anden måde skal videnskabeligt, teknisk, medicinsk og lignende indhold have prioritet over underholdningsindhold, hvilket vil kræve en form for moderation. Selve moderationen af et decentralt netværk er en ikke-triviel, men løselig opgave (dog er ordet „moderation“ her helt ukorrekt og reflekterer slet ikke essensen af processen - hverken udenpå eller indeni... og jeg har ikke engang fundet på et passende navn for denne proces).
Det vil sikkert være overflødigt at nævne behovet for at sikre anonymitet - både med indbyggede midler (som i i2p eller Retroshare) og ved at lede al trafik gennem TOR eller VPN.
Og til sidst, softwarearkitekturen (skematisk tegnet på billedet til artiklen). Som tidligere nævnt er det første komponent i systemet en browser-plugin, der fanger indhold med metadata. Den anden vigtigste komponent er et p2p-service, der kører i baggrunden (‘backend’). Nettets funktionalitet bør åbenlyst ikke afhænge af, om browseren er åben. Den tredje komponent er klientsoftware – frontend. Dette kan være en lokal webservice (i dette tilfælde kan brugeren arbejde med det decentrale netværk uden at forlade sin yndlingsbrowser) eller en separat GUI-applikation til et specifikt operativsystem (Windows, Linux, MacOS, Android, iOS osv.). Jeg kan meget godt lide ideen om, at alle former for frontend kan eksistere samtidig. Dette vil også kræve en mere stringent arkitektur for backend'en.
Der er mange aspekter, der ikke er inkluderet i denne artikel. Tilslutning til eksisterende filopbevaringssystemer (dvs. når du allerede har et par terabyte downloadet, og du lader klienten scanne dette, få hashes, sammenligne dem med det, der er inde i netværket, og slutte sig til distributionen, samt få metadata om sine egne filer fra netværket – normale navne, beskrivelser, vurderinger, anmeldelser osv.), tilslutning af eksterne kilder til metadata (såsom Libgen-databaser), valgfri brug af diskplads til opbevaring af andres krypterede indhold (som i Freenet), integration med eksisterende decentrale netværk (her er det virkelig et mørkt område), ideen om medieh hashing (brug af specielle perceptuelle hashes til medieindhold – billeder, lyd og video, der gør det muligt at sammenligne medier med samme betydning, der adskiller sig i størrelse, opløsning osv.) og meget mere.
Kort resumé af artiklen
1. I decentrale netværk findes der ikke Google med sin søgning og rangering – men der er derimod et fællesskab af rigtige mennesker. Et socialt netværk med dets feedbackmekanismer (likes, delinger…) og sociale graf (venner, grupper…) – den ideelle model for anvendelsesniveauet i et decentralt netværk.
2. Hovedideen, jeg bringer med denne artikel, er automatisk at gemme interessant indhold fra det almindelige internet ved at like/reposte; dette kan være nyttigt uden p2p, bare til at føre et personligt arkiv over interessant information.
3. Dette indhold kan også automatisk fylde et decentralt netværk.
4. Princippet om automatisk gemme af interessant indhold fungerer også ved likes/reposts i det mest decentrale netværk.
Kilde: habr.com
