

Den 26. februar afholdt vi et meetup om Apache Ignite GreenSource, hvor bidragydere fra open source-projektet talte. En vigtig begivenhed i dette fællesskabs liv var omlægningen af komponenten , som muliggør udrulning af brugerdefinerede mikrotjenester direkte i Ignite-klusteret. Om denne udfordrende proces talte , softwareingeniør og allerede i mere end to år bidragyder til Apache Ignite.
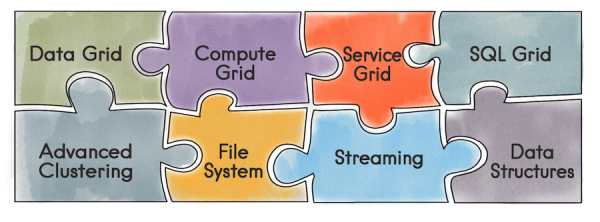
Lad os starte med, hvad Apache Ignite egentlig er. Det er en database, der fungerer som et distribueret Key/Value-lager med støtte til SQL, transaktionalitet og caching. Derudover muliggør Ignite udrulning af brugerdefinerede tjenester direkte i Ignite-klusteret. Udvikleren får adgang til alle de værktøjer, som Ignite tilbyder — distribuerede datastrukturer, messaging, streaming, compute og data grid. For eksempel, når man bruger Data Grid, slipper man for at administrere en separat infrastruktur til datalageret, og dermed de deraf følgende omkostninger.
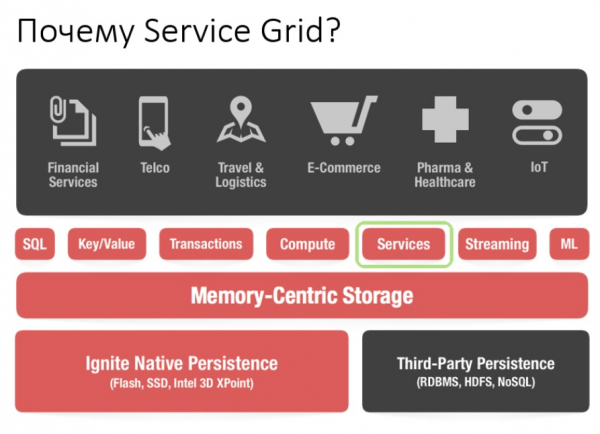
Ved at bruge Service Grid API'en kan man deployere en tjeneste blot ved at angive deployskemaet i konfigurationen og selve tjenesten.
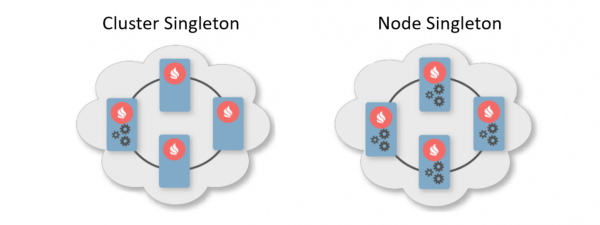
Typisk er deployskemaet en angivelse af antallet af instanser, der skal udrulles på klusterknudepunkterne. Der er to typiske deployskemaer. Den første er Cluster Singleton: på ethvert givent tidspunkt vil der i klusteret garanteret være én tilgængelig instans af den brugerdefinerede tjeneste. Den anden er Node Singleton: på hver knude i klusteret er der udrullet én instans af tjenesten.
Brugeren kan også angive antallet af instanser af tjenesten i hele klusteret og definere et prædikat til filtrering af passende knudepunkter. I dette scenario vil Service Grid selv beregne den optimale fordeling for udrulning af tjenester.
Desuden findes der en funktion kaldet Affinity Service. Affinity er en funktion, der bestemmer forbindelsen mellem nøgler og partitioner samt forbindelsen mellem partitioner og knudepunkter i topologien. Ud fra nøglen kan man identificere primary-knuden, hvor dataene opbevares. På denne måde kan man associerere sin egen service med en nøgle og cache-affinity-funktionen. I tilfælde af ændringer i affinity-funktionen vil der ske en automatisk redeployering. Således vil servicen altid være placeret nær de data, den skal håndtere, hvilket nødig vil reducere omkostningerne ved at få adgang til informationen. En sådan opsætning kan betegnes som en form for kolloideret beregning.
Nu hvor vi har gennemgået fordelene ved Service Grid, vil vi fortælle om dens udviklingshistorie.
Hvad skete der før
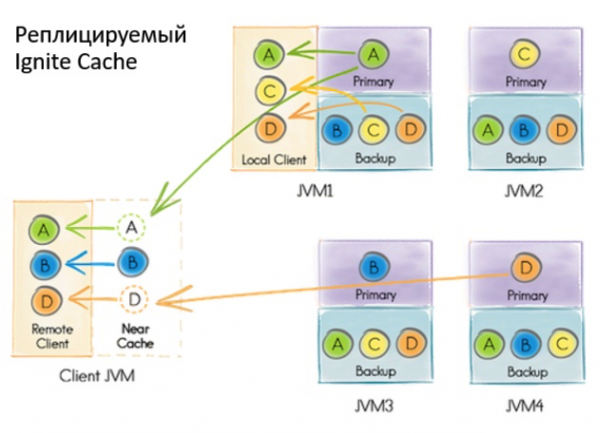
Den tidligere implementering af Service Grid var baseret på et transaktionelt replikeret systemcache Ignite. Med ordet "cache" henvises der til et lager i Ignite. Det vil sige, det er ikke noget midlertidigt som man kunne tro. Selvom cachen er replikeret, og hver knude indeholder hele datasættet, har cachen internt en partitioneret præsentation. Dette skyldes optimering af lagersystemerne.
Hvad skete der, når en bruger ønskede at deployere en service?
- Alle noder i klyngen tilmeldte sig opdateringer af data i lageret ved hjælp af den indbyggede mekanisme Continuous Query.
- Initiatornoden oprettede en post i databasen under en read-committed transaktion, der indeholdt servicekonfigurationen, inklusive den serialiserede instans.
- Ved modtagelse af underretningen om den nye post beregnede koordinatoren fordelingen baseret på konfigurationen. Det opnåede objekt blev skrevet tilbage til databasen.
- Hvis noden var en del af fordelingen, skulle koordinatoren deployere den.
Hvad var vores utilfredshed
På et tidspunkt kom vi frem til, at det ikke var muligt at arbejde sådan med tjenester. Der var flere grunde til dette.
Hvis der opstod en fejl under deployment, kunne man kun finde ud af det fra loggen på den knude, hvor det hele skete. Der eksisterede kun en asynkron deployment, så når kontrol blev givet tilbage til brugeren fra deploymentmetoden, var der behov for lidt ekstra tid til at starte servicen — og i den tid kunne brugeren ikke administrere noget. For at videreudvikle Service Grid, implementere nye funktioner, tiltrække nye brugere og gøre livet lettere for alle, var der behov for ændringer.
Når vi designede det nye Service Grid, var vores primære mål at sikre synkron deployment: så snart brugeren har fået kontrol tilbage fra API'et, kan de straks bruge tjenesterne. Vi ønskede også at give initiatoren mulighed for at håndtere deployment-fejl.
Derudover ønskede vi at lette implementeringen, specifikt ved at fjerne transaktioner og rebalancering. Selvom cachen er replikeringen og der ikke er nogen balancering, opstod der problemer under store deployment'er med mange noder. Når topologien ændres, skal noderne udveksle information, og under store deployment'er kan disse data veje meget.
Når topologien var ustabil, skulle koordinatoren genberegne fordelingen af tjenesterne. Generelt, når man skal arbejde med transaktioner på en ustabil topologi, kan dette føre til svært forudsigelige fejl.
Problemer
Hvilke globale ændringer kommer uden tilhørende problemer? Den første af dem var ændringen af topologien. Man skal forstå, at på ethvert tidspunkt, selv under deployment af en tjeneste, kan en node tilslutte sig eller forlade klyngen. Desuden, hvis en node tilslutter sig klyngen under deployment, skal al information om tjenesterne overføres til den nye node på en konsekvent måde. Det handler ikke kun om det, der allerede er blevet implementeret, men også om nuværende og fremtidige deployment'er.
Dette er kun et af problemerne, som kan samles i en separat liste:
- Hvordan deployer man statisk konfigurerede tjenester ved opstart af en node?
- Hvad skal man gøre, hvis en node forlader klyngen og har hostet tjenester?
- Hvad skal man gøre, hvis koordinatoren skifter?
- Hvad skal man gøre, hvis klienten genopretter forbindelsen til klyngen?
- Skal man behandle aktiverings-/deaktiveringsanmodninger, og hvordan?
- Hvad hvis destruktionen af cachen bliver kaldt, men vi har affinitetstjenester bundet til den?
Og det er langt fra alt.
Løsning
Som mål valgte vi en Event Driven tilgang med implementering af proceskommunikation via beskeder. I Ignite er der allerede implementeret to komponenter, der gør det muligt for noder at sende beskeder til hinanden: communication-spi og discovery-spi.
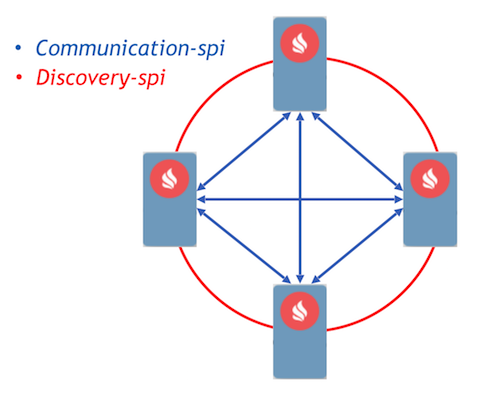
Communication-spi giver noder mulighed for at kommunikere direkte og sende beskeder. Det er velegnet til at overføre store datamængder. Discovery-spi gør det muligt at sende en besked til alle noder i klyngen. I den standardmæssige implementering gøres dette i en "ring"-topologi. Der er også integration med Zookeeper, hvor der i det tilfælde anvendes en "stjerne"-topologi. Det er også vigtigt at bemærke, at discovery-spi giver garantier for, at beskeden sikkert vil blive leveret i den rigtige rækkefølge til alle noder.
Lad os se på deploymentsprotokollen. Alle brugerforespørgsler til deployment og undeployment sendes via discovery-spi. Dette giver følgende garantier:
- Forespørgslen vil blive modtaget af alle noder i klyngen. Dette muliggør fortsat behandling af forespørgslen ved skift af koordinator. Det betyder også, at hver node vil have alle nødvendige metadata for en enkelt besked, såsom tjenestekonfiguration og dens serialiserede instans.
- Den strenge rækkefølge for levering af beskeder muliggør håndtering af konflikter mellem konfigurationer og konkurrede forespørgsler.
- Da indtræden af noder i topologien også behandles via discovery-spi, vil den nye node modtage alle nødvendige data for at arbejde med tjenesterne.
Ved modtagelse af en forespørgsel validerer noderne i klyngen den og danner opgaver til behandling. Disse opgaver placeres i en kø og behandles derefter i en anden tråd af en separat worker. Det er implementeret på denne måde, fordi deployment kan tage betydelig tid, og det ville være uacceptabelt at forsinke den dyre discovery-strøm.
Alle forespørgsler fra køen behandles af deployment-manageren. Den har en speciel worker, der trækker en opgave fra denne kø og initialiserer den for at påbegynde deployment. Herefter sker følgende handlinger:
- Hver node beregner selv fordelingen takket være den nye deterministiske tildelingsfunktion.
- Noderne danner en besked med resultaterne af deployment og sender den til koordinatoren.
- Koordinatoren aggregerer alle beskeder og danner resultatet af hele deploymentsprocessen, som sendes via discovery-spi til alle noder i klyngen.
- Ved modtagelse af resultatet afsluttes deploymentsprocessen, hvorefter opgaven fjernes fra køen.
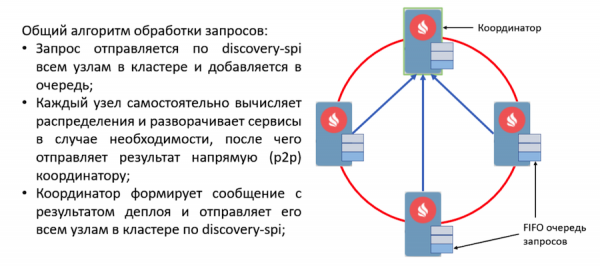
Ny event-drevet design: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Hvis der opstod en fejl under implementeringen, inkluderer knuden straks denne fejl i meddelelsen, som sendes til koordinatoren. Efter aggregering af meddelelserne vil koordinatoren have information om alle fejl under deployment og sende denne besked via discovery-spi. Fejlinformation vil være tilgængelig på enhver knude i klyngen.
Denne arbejdsmetode behandler alle vigtige begivenheder i Service Grid. For eksempel er ændringen af topologien også en meddelelse via discovery-spi. Samlet set, når man sammenligner med det, der var, er protokollen blevet ganske lettilgængelig og pålidelig. Så meget, at den kan håndtere enhver situation under deployment.
Hvad vil der ske videre
Nu til planerne. Enhver større forbedring i projektet Ignite udføres som en initiativ til forbedring af Ignite, kaldet IEP. Redesign af Service Grid har også et IEP - med det sjove navn 'Udskiftning af olie i Service Grid'. Men reelt set har vi ikke skiftet olie i motoren, men motoren helt.
Vi har delt opgaverne i IEP i 2 faser. Den første - en stor fase, som handler om omarbejdning af deploy-protokollen. Den er allerede integreret i masteren, man kan prøve den nye Service Grid, der vil komme i version 2.8. Den anden fase omfatter mange andre opgaver:
- Hot redeploy
- Versionering af services
- Forbedring af fejltolerance
- Tynd klient
- Overvågningsværktøjer og beregning af forskellige metrikker
Til sidst kan vi anbefale Service Grid til at opbygge fejltolerante systemer med høj tilgængelighed. Og vi inviterer dig til vores og for at dele din erfaring. Din erfaring er virkelig vigtig for samfundet, den vil hjælpe med at forstå, hvilken retning vi skal bevæge os i fremover, og hvordan vi kan udvikle komponenten.
Kilde: habr.com
