

In-Memory — et sæt af koncepter til datalagring, hvor data gemmes i applikationens RAM, mens disken bruges til backup. I klassiske tilgange opbevares data på disken, og RAM fungerer som cache. For eksempel anmoder en webapplikation med en backend til databehandling om data fra lagringen: den modtager dem, transformer dem, og der overføres store mængder data over netværket. I In-Memory sendes beregninger til dataene — til lagringen, hvor de behandles, og netværket belastet mindre.

Hvilke andre muligheder er tilgængelige med In-Memory, og hvad er denne tilgang, vil fortælle Vladimir Pligin — ingeniør hos GridGain. Dette oversigtsmateriale vil være nyttigt for backend-udviklere af webapplikationer, der ikke har arbejdet med In-Memory og ønsker at prøve det, eller som er interesserede i moderne udviklingstrends og arkitekturdesign.
Bemærk. Artiklen er baseret på en transskription af Vladimir's præsentation på konferencen #GetIT Conf. Inden indførelsen af selvisolering afholdt vi regelmæssigt meetups og konferencer for udviklere i Moskva og Sankt Petersborg: vi diskuterede trends, relevante udviklingsspørgsmål, problemer og deres løsninger. Nu kan vi ikke afholde konferencer, men det er det perfekte tidspunkt at dele nyttige materialer fra fortiden.
Hvem og hvordan bruger In-Memory
In-Memory bruges oftest dér, hvor hurtig brugerinteraktion eller behandling af store datamængder er nødvendig.
- Banker bruger In-Memory, for eksempel for at reducere forsinkelser, når kunder bruger applikationer, eller til at analysere kunder før udstedelse af lån.
- Fintech bruger In-Memory til at forbedre ydeevnen af tjenester og applikationer for banker, der outsourcer databehandling og analyse.
- Forsikringsselskaber: til at beregne risici, for eksempel ved at analysere kundedata over flere år.
- Logistikfirmaer. De håndterer store mængder data, for eksempel for at beregne optimale ruter for gods- og passagertransport med tusindvis af parametre og spore forsendelsens status.
- Detailhandel. In-Memory løsninger hjælper med hurtigere kundeservice og behandling af store mængder information: forsendelser, fakturaer, transaktioner, tilgængeligheden af tusindvis af varer på lager, forberedelse af analytiske rapporter.
- I IoT In-Memory erstatter traditionelle databaser.
- Farmaceutiske virksomheder bruger In-Memory, for eksempel til at gennemgå kombinationer af lægemiddelkompositioner.
Jeg vil give nogle eksempler på, hvordan vores kunder bruger In-Memory løsninger, og hvordan du kan implementere dem hos dig.
In-Memory som primært lager
En af vores kunder er en stor leverandør af medicinsk videnskabeligt udstyr fra USA. De bruger In-Memory løsningen som det primære datalager. Alle data opbevares på disk, mens et undersæt af de data, der bruges aktivt, holdes i RAM. Adgangsmetoderne til lageret er standard — GDBC (Generic Database Connector) og SQL forespørgselsprog.
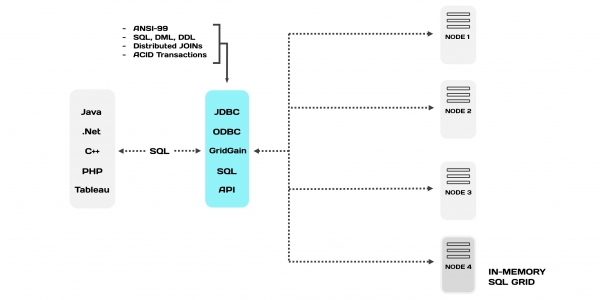
Alt dette kaldes In-Memory Database (IMDB) eller Memory-Centric Storage. Denne klasse løsninger har mange navne, og det er ikke de eneste.
Egenskaber ved IMDB:
- Data, der gemmes i In-Memory og er tilgængelige via SQL, er de samme som i andre tilgange. De er synkroniserede; det er kun måden at præsentere og få adgang til dem, der adskiller sig. Der er transaktionalitet mellem dataene.
- IMDB er hurtigere end relationelle databaser, fordi det er hurtigere at hente information fra RAM end fra disk.
- De interne optimeringsalgoritmer har færre instruktioner.
- IMDB'er er velegnede til data- og hændelsesstyring samt transaktioner i applikationer.
IMDB understøtter delvist ACID: atomaritet, konsistens og isolering. Men de understøtter ikke «holdbarhed» — ved strømafbrydelse bliver alle data væk. For at løse dette problem kan man bruge snapshots — et «billede» af databasen, svarende til en backup af databasen på harddisken, eller optage transaktioner (logs) for at kunne gendanne data efter genstart.
For at skabe robuste applikationer
Lad os se på en klassisk arkitektur for et fejltolerant web-applikation. Den fungerer således: en web-balanceur fordeler alle anmodninger mellem serverne. Dette system er robust, fordi serverne duplikerer hinanden og tager over ved hændelser.
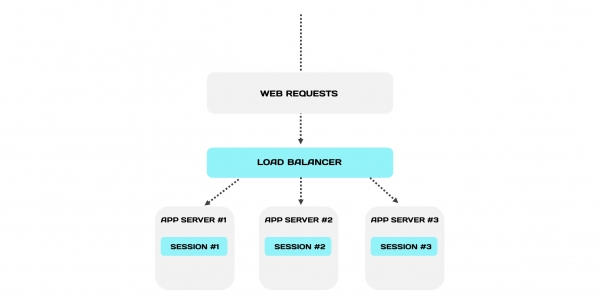
Balanceuren dirigerer alle anmodninger fra én session strengt til én server. Dette er mekanismen for sticky-sessions: hver session knyttes til server, hvor den lagres og behandles lokalt.
Hvad sker der, når en af servere?
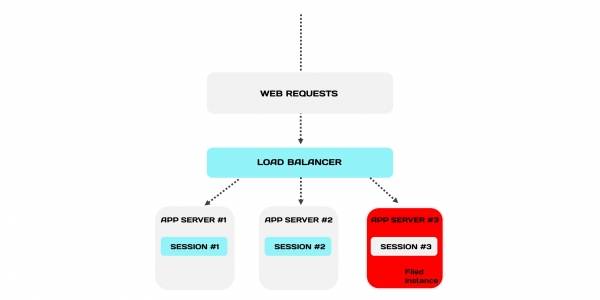
Serveren ikke vil lide skade, fordi arkitekturen er duplikeret. Men vi mister et subset af sessionerne fra den afdøde server. Samtidig også de brugere, der er knyttet til disse sessioner. For eksempel, hvis en kunde bestiller og pludselig bliver smidt ud af sin konto. Han vil være utilfreds, når han logger ind igen og opdager, at han skal bestille alt igen.
Det kræves af web-applikationen at understøtte et stort antal brugere og ikke «stoppe» for at de kan arbejde komfortabelt. Men ved en fejl, vil tiden for hver efterfølgende anmodning til sessionstorage stige. Dette øger den gennemsnitlige latens for de øvrige brugere. Men de ønsker ikke at vente længere, end de er vant til.
Dette problem kan løses, som en anden af vores kunder — en stor PaaS-udbyder fra USA. De bruger In-Memory til at klusterere web-sessioner. Til dette opbevarer de dem ikke lokalt, men centralt — i et In-Memory cluster. I dette tilfælde er sessionerne tilgængelige meget hurtigere, fordi de allerede er i RAM.
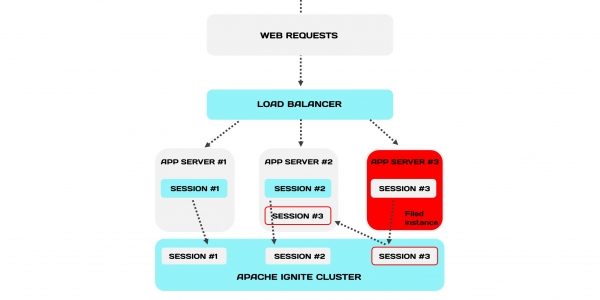
Når serveren falder, sender balanceuren anmodningerne fra den faldne server til andre servere, ligesom i den klassiske arkitektur. Men der er en vigtig forskel: sessionerne opbevares i et In-Memory cluster og serverne har adgang til sessionerne fra den faldne server.
Denne arkitektur forbedrer systemets fejltolerance. Desuden er det muligt helt at opgive mekanismen for sticky sessions.
Hybrid transaktionel-analyse behandling (HTAP)
Normalt set holdes transaktionelle og analytiske systemer adskilt. Når de opdeles, påvirkes hoveddatabasen af belastningen. Til analytisk behandling kopieres data til en replica, så den analytiske behandling ikke forstyrrer transaktionsprocesserne. Men kopieringen sker med en forsinkelse — uden forsinkelse er det umuligt at replikere. Hvis vi gør det synkront, vil det også bremse hoveddatabasen, og vi vil ikke opnå nogen fordel.
I HTAP fungerer alt anderledes — det samme datalager bruges til transaktionel belastning fra applikationer og til analytiske forespørgsler, der kan tage lang tid at udføre. Når dataene ligger i hukommelsen, udføres analytiske forespørgsler hurtigere, og databasen belastes mindre (i gennemsnit).
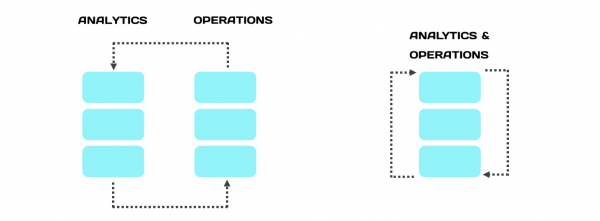
Den hybride tilgang "bryder muren" mellem transaktionsbehandling og analyse. Hvis vi udfører analyse på det samme lager, køres analytiske forespørgsler på data fra hukommelsen. De er meget mere præcise, mere fortolkelige og relevante.
Integration af In-Memory-løsninger
En relativt simpel måde — udvikle alt fra bunden.. Vi opbevarer data på disken, mens de varme data opbevares i hukommelsen. Dette hjælper med at overleve servergenstarter eller nedbrud.
Her fungerer to hovedscenarier, når data opbevares på disken. I det første vil vi overleve nedbrud eller planlagte genstarter af klyngen eller dens dele — vi vil bruge det som en simpel database. I det andet scenarie, når der er for mange data, er en del af dem i hukommelsen.
Hvis det ikke er muligt at bygge alt fra bunden, kan In-Memory integreres i en allerede eksisterende arkitektur.. Men ikke alle In-Memory-løsninger er egnede til dette. Der er tre obligatoriske betingelser. In-Memory-løsningen skal understøtte:
- en standard måde at forbinde til en database, der skal ligge under den (f.eks. MySQL);
- en standard forespørgsels-sprog, så man ikke skal omskrive og ændre logikken i interaktionen med lageret;
- transaktionalitet — for at bevare interaktionssemantikken.
Hvis alle tre betingelser er opfyldt, er integration mulig. Vi placerer In-Memory Data Grid mellem applikationen og databasen. Nu vil skriveforespørgsler blive delegateret til den underliggende database, mens læseforespørgsler skal sendes til databasen, hvis data ikke findes i cachen.
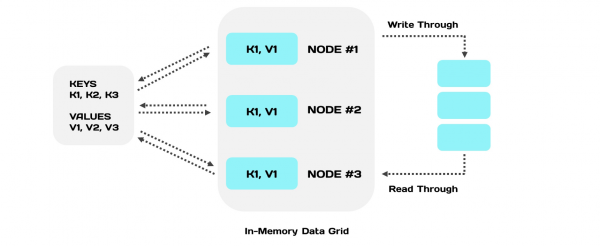
Hvis hurtig adgang til data og deres behandling er vigtige for dig, f.eks. til forretningsanalyse, kan du overveje at implementere In-Memory. Til implementeringen kan du bruge begge metoder, når du designer en ny arkitektur.
Kilde: habr.com
