

Hello, Habr!
Elsker du at flyve med fly? Jeg elsker det, men under selvisoleringen har jeg også fået en passion for at analysere data om flybilletter fra en velkendt tjeneste — Aviasales.
I dag vil vi gennemgå arbejdet med Amazon Kinesis, opbygge et streamingsystem med realtidsanalyse, implementere en NoSQL-database, Amazon DynamoDB, som det primære dataopbevaringssted og opsætte SMS-notifikationer om interessante billetter.
Alle detaljer findes nedenfor! Lad os komme i gang!
Introduktion
Til eksemplet har vi brug for adgang til . Adgang til det gives gratis og uden begrænsninger, man skal blot registrere sig i afsnittet 'For udviklere' for at få sin API-token til dataadgang.
Hovedformålet med denne artikel er at give en generel forståelse af brugen af streaminginformation i AWS; vi overser, at de data, der returneres af det anvendte API, ikke er strengt aktuelle og overføres fra et cache, der dannes på baggrund af søgeresultater fra brugerne af Aviasales.ru og Jetradar.com inden for de sidste 48 timer.
De data om flybilletter, der indsamles via API'et, vil Kinesis-agenten installeret på producer-maskinen automatisk analysere og sende til den relevante stream via Kinesis Data Analytics. Den rå version af denne stream vil blive skrevet direkte til opbevaringssystemet. Det opsatte opbevaringssystem i DynamoDB for 'rå' data vil muliggøre dybere analyse af billetter gennem BI-værktøjer som f.eks. AWS Quick Sight.
Vi vil overveje to muligheder for deployment af hele infrastrukturen:
- Manuel — gennem AWS Management Console;
- Infrastruktur fra Terraform-kode — for de dovne automatisatorer;
Arkitekturen for det udviklede system
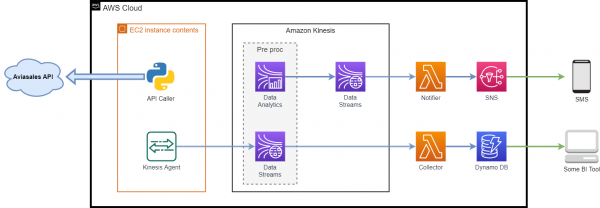
Brugte komponenter:
- — de data, der returneres af dette API, vil blive brugt til hele den efterfølgende operation;
- — en almindelig virtuel maskine i skyen, hvor den indgående datastream vil blive genereret:
- — dette er en Java-applikation, der installeres lokalt på maskinen og giver en enkel måde at indsamle og sende data til Kinesis (Kinesis Data Streams eller Kinesis Firehose). Agenten overvåger konstant en række filer i de angivne mapper og sender nye data til Kinesis;
- — et Python-script, der foretager forespørgsler til API'et og gemmer svaret i en mappe, som Kinesis Agent overvåger;
- — realtids streamingtjeneste med omfattende skaleringsmuligheder;
- — en serverløs tjeneste, der forenkler analysen af realtidsdata. Amazon Kinesis Data Analytics konfigurerer ressourcerne til applikationer og skalerer automatisk for at håndtere enhver mængde indkommende data;
- — en tjeneste, der gør det muligt at køre kode uden forudbestilling og opsætning af servere. Alle beregningsressourcer skalerer automatisk i forhold til hvert kald;
- — en nøgle-værdi- og dokumentdatabase, der sikrer en latency på mindre end 10 millisekunder i enhver skala. Brug af DynamoDB kræver ikke, at du fordeler nogen servere, installerer opdateringer eller administrerer dem. DynamoDB skalerer automatisk tabellerne ved at justere de tilgængelige ressourcer og opretholde høj ydeevne. Ingen systemadministration er nødvendig;
- — en fuldt administreret beskedafsendelsestjeneste baseret på ’public-subscribe’ (Pub/Sub) modellen, som gør det muligt at isolere mikrotjenester, fordelte systemer og serverløse applikationer. SNS kan bruges til at sende information til slutbrugere ved hjælp af mobile push-notifikationer, SMS-beskeder og e-mails.
Indledende forberedelse
For at emulere dataflowet beslutede jeg mig for at bruge oplysninger om flybilletter, der returneres af Aviasales API. I et ret omfattende udvalg af forskellige metoder, lad os tage en af dem - 'Månedens pris kalender', som returnerer priserne for hver dag i måneden grupperet efter antal skift. Hvis der ikke sendes en søgemåned i anmodningen, vil informationen for den måned, der følger efter den nuværende, blive returneret.
Så vi registrerer os, får vores token.
Et eksempel på anmodning nedenfor:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIDen ovenfor beskrevne måde at hente data fra API'et ved at angive token i anmodningen vil fungere, men jeg foretrækker at videregive adgangstokenet via headeren, så vi vil bruge denne metode i skriptet api_caller.py.
Eksempel på svar:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
I den ovenstående API-svarses eksempel vises en billet fra Sankt Petersborg til Phuket… Åh, hvorfor drømme…
Da jeg er fra Kazan, og Phuket lige nu kun er en drøm, lad os finde billetter fra Sankt Petersborg til Kazan.
Det antages, at du allerede har en konto på AWS. Jeg vil gerne påpege, at Kinesis og afsendelse af meddelelser via SMS ikke er inkluderet i det årlige . Men selv med dette i tankerne, kan man for et par dollars bygge det foreslåede system og lege med det. Og selvfølgelig skal man huske at fjerne alle ressourcer, når de ikke længere er nødvendige.
Heldigvis vil DynamoDb og Lambda-funktioner være omkostningsfrie for os, hvis vi holder os inden for de månedlige gratis grænser. For eksempel for DynamoDB: 25 GB lager, 25 WCU/RCU og 100 millioner forespørgsler. Og en million Lambda-funktion kald om måneden.
Manuel deployment af systemet
Konfiguration af Kinesis Data Streams
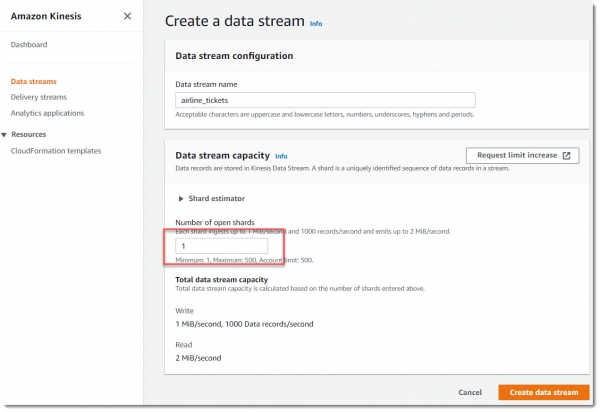
Lad os gå til Kinesis Data Streams-tjenesten og oprette to nye streams med én shard hver.
Hvad er en shard?
En shard er den grundlæggende enhed til overførsel af data i Amazon Kinesis-streamen. Én shard muliggør overførsel af inddata med en hastighed på 1 MB/s og overførsel af uddata med en hastighed på 2 MB/s. Én shard understøtter op til 1000 PUT-forespørgsler pr. sekund. Ved oprettelse af en datastream skal der angives det ønskede antal shards. For eksempel kan man oprette en datastream med to shards. Denne datastream vil muliggøre inddataoverførsel med en hastighed på 2 MB/s og uddataoverførsel med en hastighed på 4 MB/s med mulighed for op til 2000 PUT-forespørgsler pr. sekund.
Jo flere shards der er i din stream — desto højere er dens båndbredde. Generelt skaleres streams ved at tilføje shards. Men jo flere shards du har, desto højere er prisen. Hver shard koster 1,5 cent i timen og yderligere 1,4 cent for hver million PUT-operationer.
Lad os oprette en ny stream med navnet airline_tickets, én shard vil være tilstrækkelig:
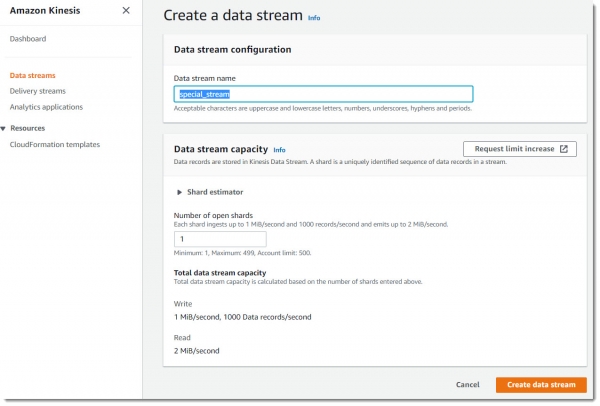
Nu lad os oprette endnu en stream med navnet special_stream:
Konfiguration af producenten
Som dataprocessor til opgaven er det tilstrækkeligt at bruge en almindelig EC2-instans. Det skal ikke være en kraftfuld dyr virtuel maskine, en t2.micro spot-instans vil være helt passende.
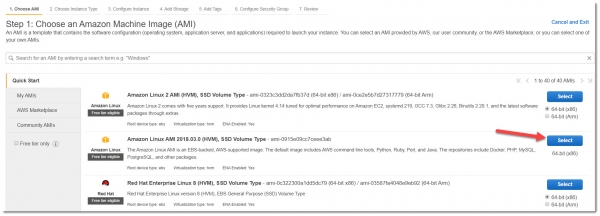
Vigtig bemærkning: Som eksempel skal du bruge image – Amazon Linux AMI 2018.03.0, som kræver færre indstillinger for hurtig opstart af Kinesis Agent.
Lad os gå til EC2-servicen, oprette en ny virtuel maskine, vælge den ønskede AMI med typen t2.micro, som er en del af Free Tier:
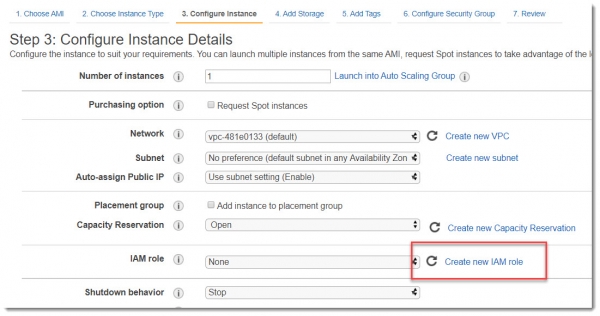
For at den nyoprettede virtuelle maskine kan interagere med Kinesis-servicen, er det nødvendigt at give den de rette tilladelser. Den bedste måde at gøre dette på er ved at tildele en IAM Role. Derfor skal vi på skærmen Step 3: Configure Instance Details vælge Opret ny IAM Role:
Oprettelse af IAM-rolle til EC2
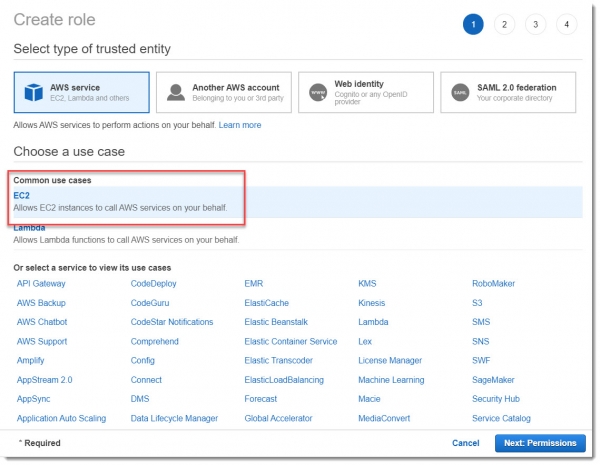
I det åbne vindue vælger vi, at den nye rolle oprettes til EC2, og vi går videre til sektionen Tilladelser:
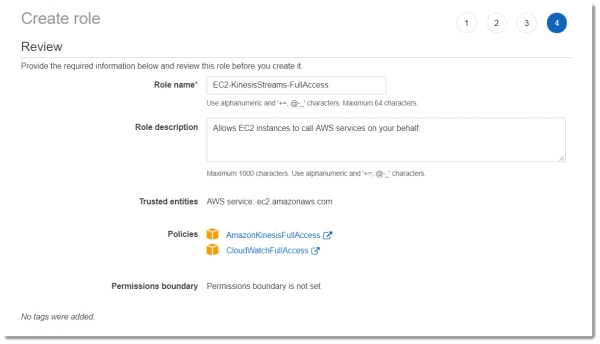
I dette læringseksempel behøver vi ikke dykke ned i alle detaljerne i den granulære tildeling af ressourcetilladelser, så vi vælger de forudindstillede Amazon-politikker: AmazonKinesisFullAccess og CloudWatchFullAccess.
Lad os give denne rolle et meningsfuldt navn, for eksempel: EC2-KinesisStreams-FullAccess. Resultatet skal være det samme som angivet på billedet nedenfor:
Efter oprettelsen af denne nye rolle må vi ikke glemme at knytte den til den oprettede virtuelle maskine:
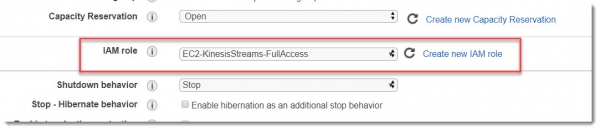
Vi ændrer ikke noget mere på denne skærm og går videre til de næste vinduer.
Diskparametrene kan efterlades som standard, tags også (selvom det er en god praksis at bruge tags, i det mindste for at give instansen et navn og angive miljøet).
Nu er vi på fanen Step 6: Configure Security Group, hvor vi skal oprette en ny eller angive en eksisterende Security group, som tillader forbindelse via ssh (port 22) til instansen. Vælg Source → My IP, og så kan du starte instansen.
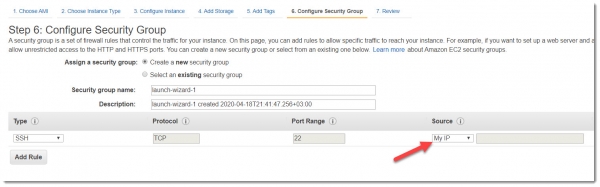
Så snart den skifter til status running, kan du forsøge at logge ind via ssh.
For at få mulighed for at arbejde med Kinesis Agent, skal du efter succesfuld forbindelse til maskinen indtaste følgende kommandoer i terminalen:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Lad os oprette en mappe til opbevaring af API-svarene:
sudo mkdir /var/log/airline_ticketsFør agenten kan startes, er det nødvendigt at konfigurere dens konfiguration:
sudo vim /etc/aws-kinesis/agent.jsonIndholdet af filen agent.json skal have følgende format:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "\/var\/log\/airline_tickets\/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Som det fremgår af konfigurationsfilen, vil agenten overvåge filer med .log-udvidelse i biblioteket \/var\log\/airline_tickets\/, parse dem og overføre dem til strømmen airline_tickets.
Vi genstarter tjenesten og sikrer os, at den er startet korrekt:
sudo service aws-kinesis-agent restartNu downloader vi Python-skriptet, som vil anmode om data fra API'en:
REPO_PATH=https:\/\/raw.githubusercontent.com\/igorgorbenko\/aviasales_kinesis\/master\/producer

wget $REPO_PATH\/api_caller.py -P \/home\/ec2-user\/
wget $REPO_PATH\/requirements.txt -P \/home\/ec2-user\/
sudo chmod a+x \/home\/ec2-user\/api_caller.py
sudo \/usr\/local\/bin\/pip3 install -r \/home\/ec2-user\/requirements.txt
Skriptet api_caller.py anmoder data fra Aviasales og gemmer det modtagne svar i det bibliotek, som Kinesis-agenten scanner. Implementeringen af dette script er ret standard, der er en klasse kaldet TicketsApi, som gør det muligt at asynkront forespørge API'en. Til denne klasse sender vi en header med token og forespørgselsparametre:
class TicketsApi:
    """API kalders klasse."""

    def __init__(self, headers):
        """Init metode."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Hent data fra API forespørgsel."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Respons status %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Ups! Der opstod en HTTP-fejl: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Ups! Der opstod en fejl: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Returner headers og forespørgsel til API-anmodning."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Kør koden."""
    if len(sys.argv) != 2:
        print('Brug: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API har returneret %s emner', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s rækker er blevet gemt i %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Ups! Anmodningens resultat blev ikke gemt i filen. %s',
                         str(e))
    else:
        LOGGER.error('Ups! API-anmodningen var ikke succesfuld %s!', response)
For at teste korrektheden af indstillingerne og funktionaliteten af agenten vil vi lave en testkørsel af scriptet api_caller.py:
sudo ./api_caller.py TOKEN 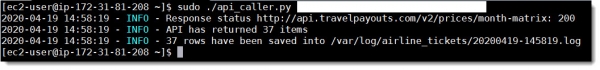
Og vi ser resultatet af arbejdet i loggene for Agenten og på fanen Monitoring i datastreamen airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 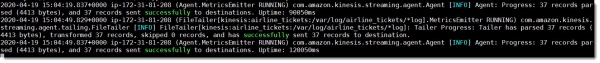
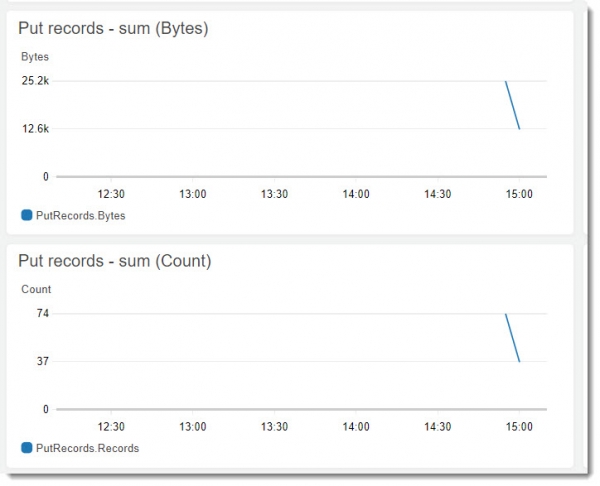
Som det ses, fungerer alt, og Kinesis Agent sender data til strømmen. Nu er vi klar til at konfigurere forbrugeren.
Opsætning af Kinesis Data Analytics
Lad os gå til det centrale komponent i hele systemet - vi opretter en ny applikation i Kinesis Data Analytics med navnet kinesis_analytics_airlines_app:
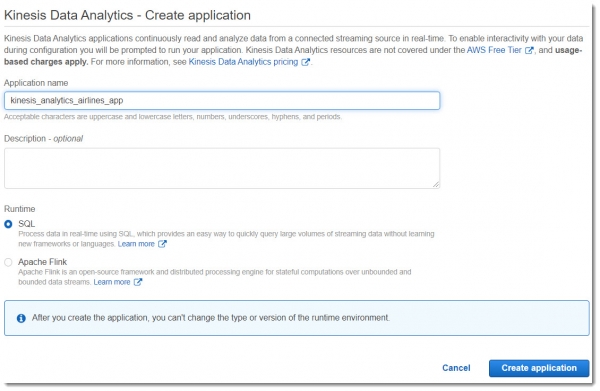
Kinesis Data Analytics muliggør realtidsdataanalyse fra Kinesis Streams ved hjælp af SQL-sprog. Dette er en fuldstændig autoskalerbar tjeneste (i modsætning til Kinesis Streams), der:
- muliggør oprettelse af nye streams (Output Stream) baseret på forespørgsler til de oprindelige data;
- giver en fejldata stream, der opstår under kørsel af applikationer (Error Stream);
- kan automatisk bestemme strukturen af inddata (den kan manuelt overstyres om nødvendigt).
Dette er en dyr service - 0,11 USD pr. arbejdstime, så den skal bruges omhyggeligt, og den skal fjernes, når arbejdet er afsluttet.
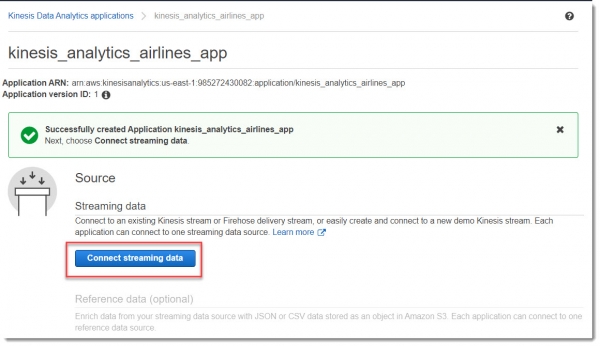
Vi tilslutter applikationen til datakilden:
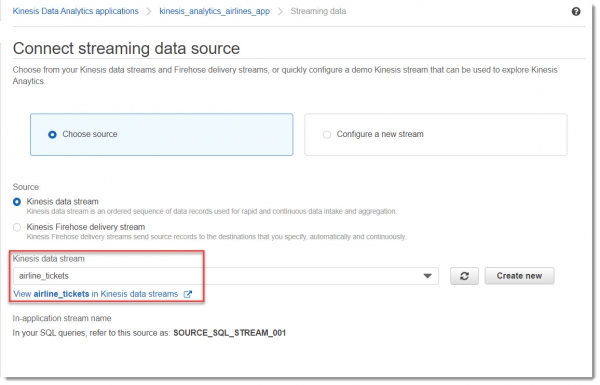
Vælg strømmen, som vi ønsker at tilslutte til (airline_tickets):
Derefter skal vi vedhæfte en ny IAM-rolle, så applikationen kan læse fra strømmen og skrive til strømmen. Det er nok ikke at ændre noget i blokken Adgangstilladelser:
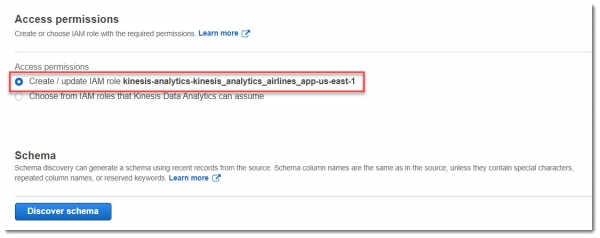
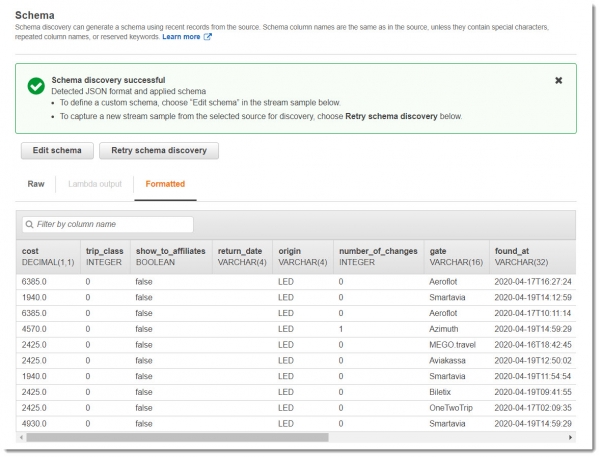
Nu anmoder vi om at opdage dataskemaet i strømmen, for dette klikker vi på knappen 'Opdag skema'. Som resultat vil den opdatere (oprette en ny) IAM-rolle, og der vil blive påbegyndt opdagelse af skemaet baseret på dataene, der allerede er kommet til strømmen:
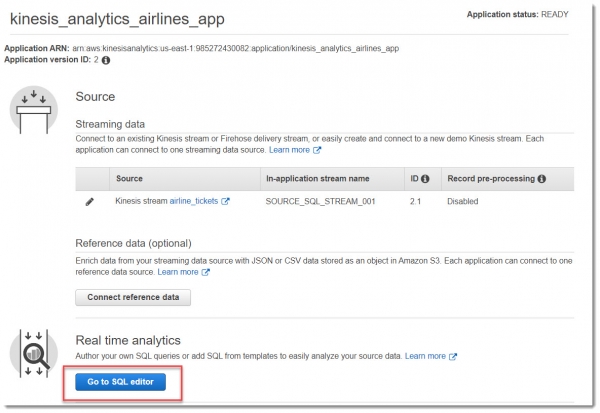
Vi skal nu gå til SQL-editoren. Når du klikker på denne knap, vises et vindue med spørgsmålet om at starte applikationen - vælg hvad du ønsker at starte:
Indsæt denne enkle forespørgsel i SQL-editorvinduet og klik på Gem og Kør SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
I relationelle databaser arbejder du med tabeller, ved at bruge INSERT-operatorer til at tilføje poster og SELECT-operatoren til at forespørge data. I Amazon Kinesis Data Analytics arbejder du med strømme (STREAM) og 'pumper' (PUMP) - kontinuerlige indsættelsesforespørgsler, der indsætter data fra en strøm i applikationen til en anden strøm.
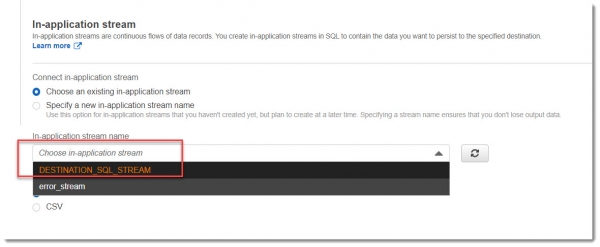
I den SQL-forespørgsel, der er præsenteret ovenfor, sker der en søgning efter Aeroflot-billetter med en pris under fem tusinde rubler. Alle poster, der opfylder disse betingelser, vil blive placeret i strømmen DESTINATION_SQL_STREAM.
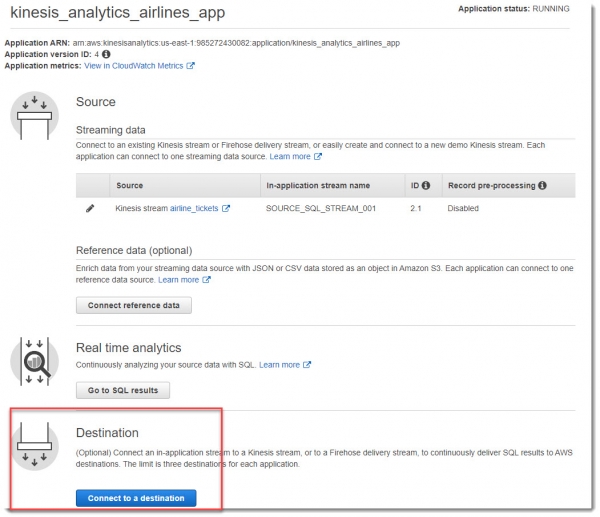
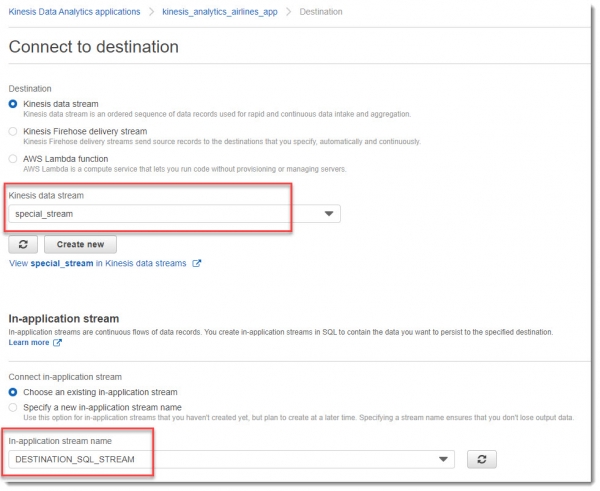
I blokken Destination vælger vi strømmen special_stream, og i rullemenuen In-application stream name DESTINATION_SQL_STREAM:
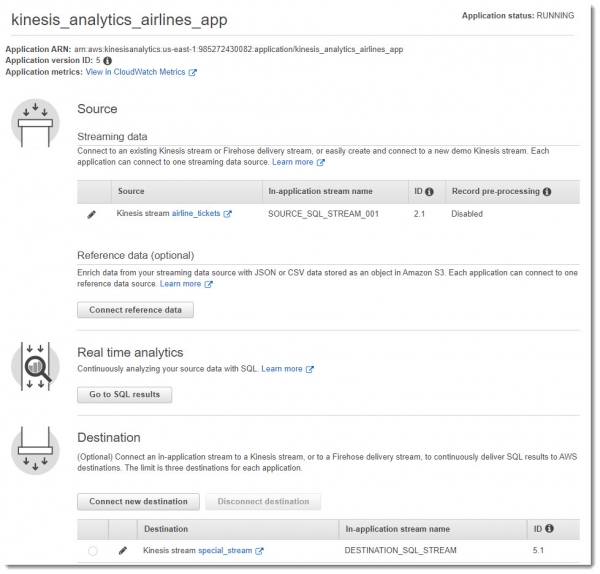
Som resultat af alle manipulationer skal vi ende op med noget, der ligner billedet nedenfor:
Oprettelse og abonnement på SNS-emne
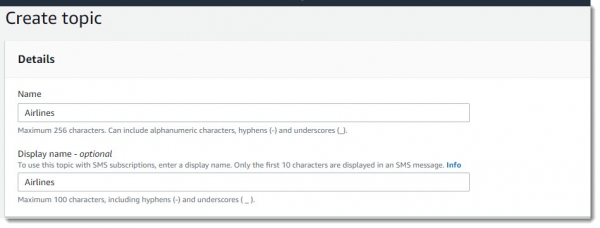
Vi går til tjenesten Simple Notification Service og opretter et nyt emne med navnet Airlines:
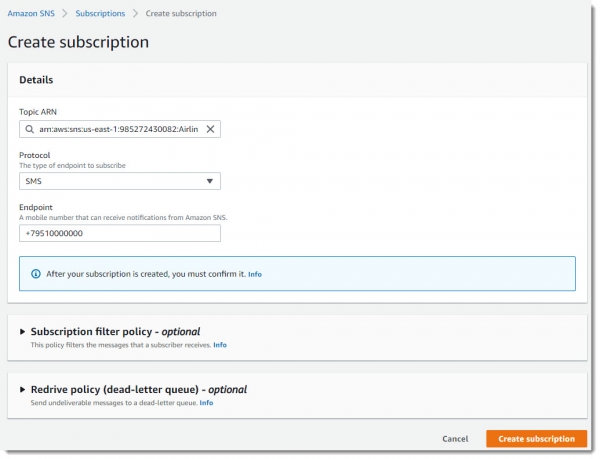
Vi opretter et abonnement på dette emne, hvor vi angiver telefonnummeret, som SMS-notifikationer vil blive sendt til:
Oprettelse af tabel i DynamoDB
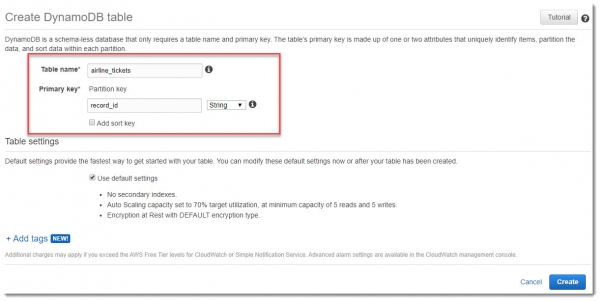
For at gemme de ubehandlede data fra strømmen airline_tickets, opretter vi en tabel i DynamoDB med samme navn. Som primær nøgle vil vi bruge record_id:
Oprettelse af lambda-funktion collector
Vi opretter en lambda-funktion kaldet Collector, hvis opgave vil være at afspille strømmen airline_tickets og, hvis der findes nye poster, indsætte disse poster i DynamoDB-tabellen. Det er klart, at denne lambda udover standardadgang også skal have læserettigheder til Kinesis datastrømmen og skriveadgang til DynamoDB.
Oprettelse af en IAM-rolle til lambda-funktionen collector
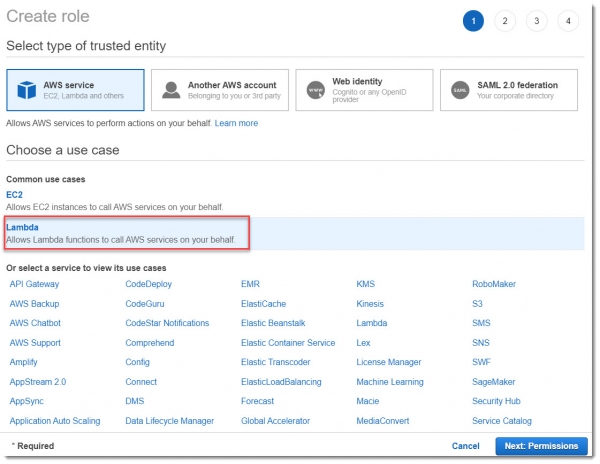
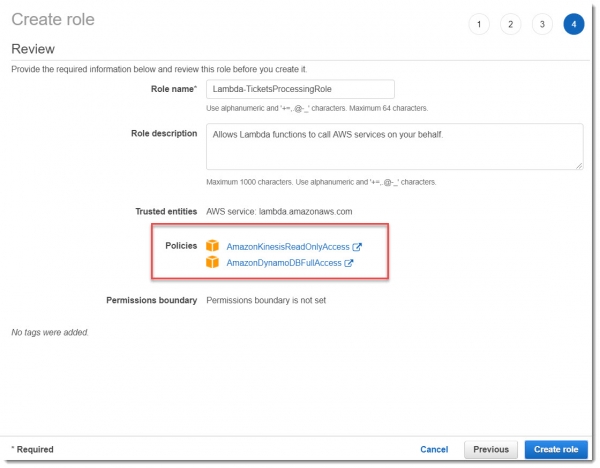
For at begynde opretter vi en ny IAM-rolle til lambdaen med navnet Lambda-TicketsProcessingRole:
Til testformål vil de forudkonfigurerede politikker AmazonKinesisReadOnlyAccess og AmazonDynamoDBFullAccess være tilstrækkelige, som vist på billedet nedenfor:
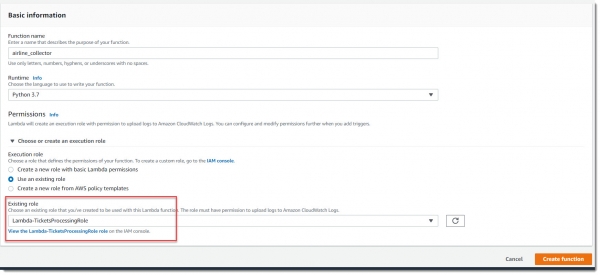
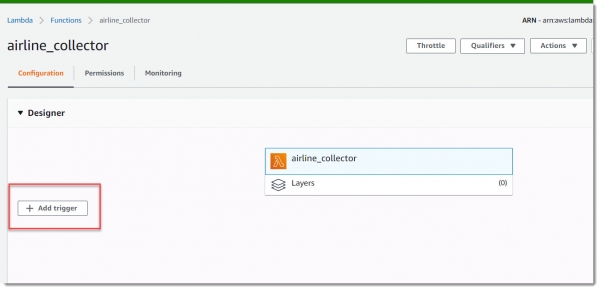
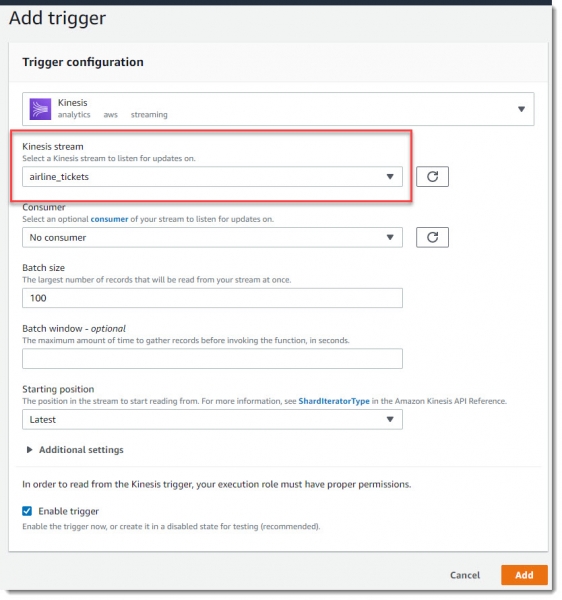
Denne lambda skal aktiveres af en trigger fra Kinesis, når der kommer nye poster i strømmen airline_stream, så vi skal tilføje en ny trigger:
Det er nu tilbage at indsætte koden og gemme lambdaen.
"""Analyse af strømmen og indsættelse i DynamoDB-tabellen."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Analyse af oplysninger fra strømmen."""

    def __init__(self, table_name, records):
        """Init-metode."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Returner deserialiserede data fra strømmen."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Forbehandling af json-data."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Batchindsætning i tabellen."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Der er blevet tilføjet ', len(self.json_data), ' poster')

def lambda_handler(event, context):
    """Analyser strømmen og indsæt i DynamoDB-tabellen."""
    print('Modtog begivenhed:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Oprettelse af lambda-funktionen notifier
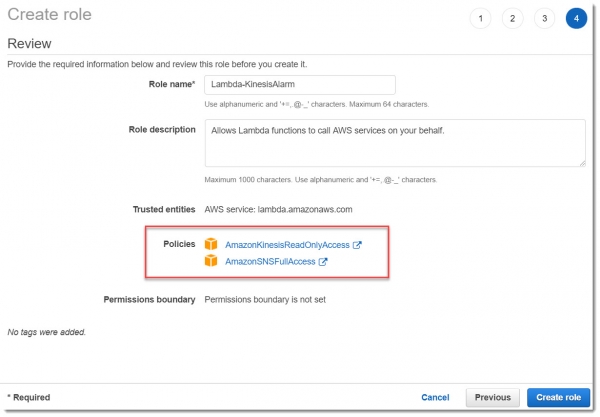
Den anden lambda-funktion, der skal overvåge den anden strøm (special_stream) og sende notifikationer til SNS, oprettes på samme måde. Derfor skal denne lambda have læsetilgang fra Kinesis og kunne sende beskeder til den angivne SNS-topik, som SNS-tjenesten derefter vil sende til alle abonnenter på denne topik (e-mail, SMS osv.).
Oprettelse af IAM-rolle
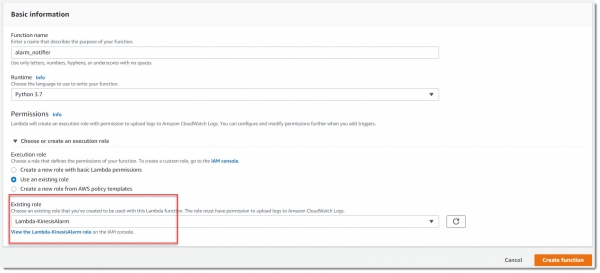
Vi opretter først IAM-rollen Lambda-KinesisAlarm for denne lambda, og derefter tildeler vi denne rolle til den oprettede lambda alarm_notifier:
Denne lambda skal være knyttet til en trigger for nye poster i strømmen special_stream, så det er nødvendigt at konfigurere triggeren på samme måde, som vi gjorde for lambdaen Collector.
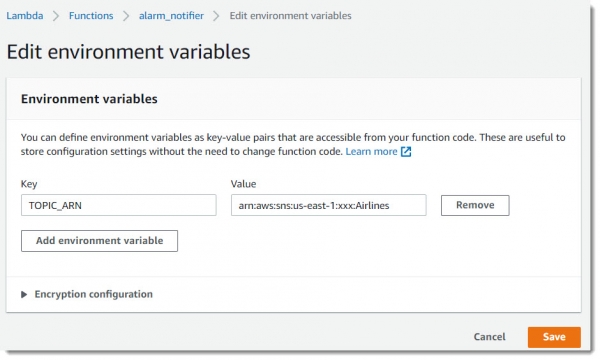
For at lette konfigurationen af denne lambda, introducerer vi en ny miljøvariabel — TOPIC_ARN, hvor vi placerer ANR (Amazon Resource Names) for topikken Airlines:
Og vi indsætter lambda-koden, som er ganske enkel:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Hej! Jeg har fundet noget interessant!',
                           Subject='Airline billetter alarm')
        print('Alarmbesked er blevet leveret med succes')
    except Exception as err:
        print('Leveringsfejl', str(err))
Det ser ud til, at den manuelle opsætning af systemet er afsluttet. Nu er det kun tilbage at teste og sikre, at vi har konfigureret alt korrekt.
Deployment fra Terraform-kode
Nødvendig forberedelse
— et meget praktisk open-source værktøj til deployment af infrastruktur fra kode. Det har sin egen syntaks, som er nem at lære, samt mange eksempler på, hvordan og hvad man kan deploye. I editoren Atom eller Visual Studio Code er der mange nyttige plugins, der kan lette arbejdet med Terraform.
Distributionspakken kan downloades . En detaljeret gennemgang af alle mulighederne i Terraform overskrider rammerne for denne artikel, så vi vil kun begrænse os til de grundlæggende punkter.
Sådan starter du
Den fulde projektkode ligger . Klon repository'et til din maskine. Før du starter, skal du sikre dig, at AWS CLI er installeret og konfigureret, da Terraform vil lede efter legitimationsoplysninger i filen ~/ .aws / credentials.
Det er god praksis at køre kommandoen plan, før du deployer hele infrastrukturen, for at se, hvad Terraform vil generere i skyen:
terraform.exe planDu vil blive bedt om at indtaste dit telefonnummer for at modtage notifikationer. På dette trin er det ikke nødvendigt at indtaste det.
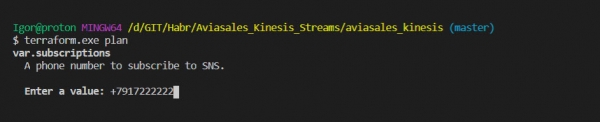
Efter at have analyseret programmets arbejdsplan kan vi begynde at oprette ressourcer:
terraform.exe applyEfter at have sendt denne kommando vil der igen blive bedt om at indtaste telefonnummeret, indtast "yes", når spørgsmålet om faktisk at udføre handlingerne vises. Dette vil tillade at oprette hele infrastrukturen, foretage de nødvendige indstillinger af EC2, implementere lambda-funktioner osv.
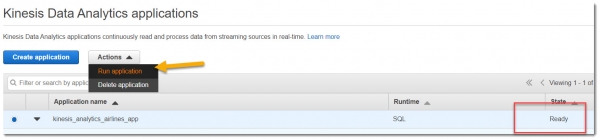
Når alle ressourcer er blevet oprettet med succes gennem Terraform-koden, skal man gå ind i detaljerne for Kinesis Analytics-applikationen (desværre kunne jeg ikke finde ud af, hvordan dette gøres direkte fra koden).
Lad os starte applikationen:
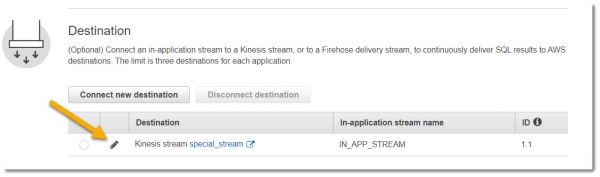
Derefter skal du tydeligt angive in-application stream name ved at vælge fra droppdown-menuen:
Nu er alt klar til brug.
Test af applikationens funktionalitet
Uanset hvordan du har implementeret systemet, manuelt eller via Terraform-kode, vil det fungere ens.
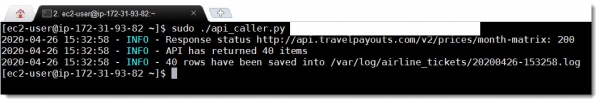
Log ind via SSH på den virtuelle EC2-maskine, hvor Kinesis Agent er installeret, og kør scriptet api_caller.py
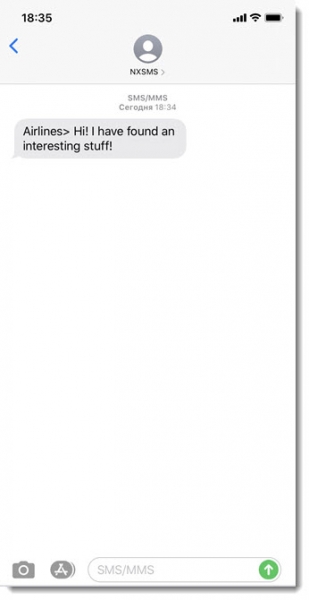
sudo ./api_caller.py TOKENNu er det bare at vente på en SMS til dit nummer:
SMS - beskeden kommer til telefonen næsten efter 1 minut:
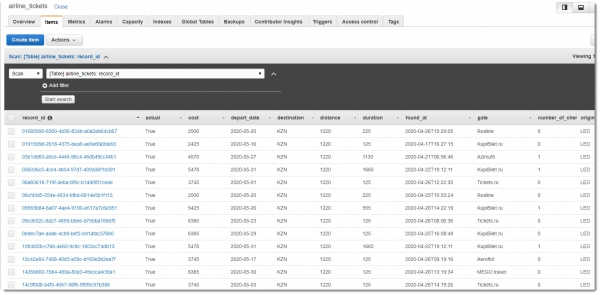
Det er tid til at se, om optegnelserne er gemt i DynamoDB-databasen til senere, mere detaljeret analyse. Tabellen airline_tickets indeholder cirka disse data:
Konklusion
I løbet af det udførte arbejde blev der bygget et system til online databehandling baseret på Amazon Kinesis. Der blev overvejet muligheder for at bruge Kinesis Agent sammen med Kinesis Data Streams og real-time analytik Kinesis Analytics ved hjælp af SQL-kommandoer, samt interaktion mellem Amazon Kinesis og andre AWS-tjenester.
Det ovenfor beskrevne system blev implementeret på to måder: en relativt lang manuel metode og en hurtigere metode gennem Terraform-koden.
Hele projektets kildekode er tilgængelig , jeg foreslår, at du ser nærmere på det.
Jeg ser frem til gerne at diskutere artiklen, og jeg venter på dine kommentarer. Jeg håber på konstruktiv kritik.
Jeg ønsker dig held og lykke!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish