

Industriel udvikling af softwaresystemer kræver stor opmærksomhed på den endelige produkts fejltolerance samt hurtig reaktion på fejl og nedbrud, hvis de skulle opstå. Overvågning hjælper naturligvis med at reagere på fejl og nedbrud mere effektivt og hurtigere, men det er ikke tilstrækkeligt. For det første er det meget svært at holde styr på et stort antal servere – der kræves en stor mængde folk. For det andet er det nødvendigt at have en god forståelse af, hvordan applikationen fungerer, for at kunne forudsige dens tilstand. Følgelig kræves der mange personer, der har en god forståelse af de systemer, vi udvikler, deres indikatorer og karakteristika. Antag, at det er muligt at finde et tilstrækkeligt antal folk, der ønsker at beskæftige sig med dette, så kræves der stadig en god mængde tid til at uddanne dem.
Hvad skal vi så gøre? Her kommer kunstig intelligens os til hjælp. Denne artikel handler om (predictive maintenance). Denne tilgang vinder aktivt frem. Der er skrevet et stort antal artikler, herunder på Habré. Store virksomheder bruger allerede denne tilgang til at støtte deres serveres driftssikkerhed. Efter at have gennemgået et stort antal artikler, besluttede vi os for at prøve at anvende denne tilgang. Hvad kom der ud af det?
Introduktion
Det udviklede softwaresystem går før eller siden i drift. Det er vigtigt for brugeren, at systemet fungerer uden nedbrud. Hvis en nødsituation alligevel opstår, skal den rettes med minimale forsinkelser.
For at forenkle den tekniske support af softwaresystemet, især når der er mange servere, anvendes der normalt overvågningsprogrammer, der indsamler målinger fra det kørende softwaresystem, giver mulighed for at diagnosticere dets tilstand og hjælper med at bestemme, hvad der præcist forårsagede nedbruddet. Denne proces kaldes overvågning af softwaresystemet.
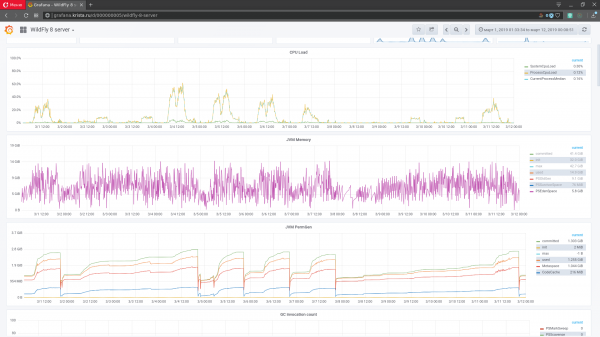
Figur 1. Interface til overvågning grafana
Metrikker er forskellige målemetoder for software-systemet, omgivelserne det kører i, eller den fysiske computerenhed, som systemet er hostet på, med et tidsstempel for det tidspunkt, hvor målingerne blev indsamlet. I den statiske analyse kaldes målingsdataene for tidsserier. For at overvåge tilstanden af software-systemet præsenteres metrikkerne i grafisk form: med tid på X-aksen og værdier på Y-aksen (figur 1). Et fungerende software-system kan generere flere tusinde metrikker (fra hver node). De danner et metrikrum (flerdimensionale tidsserier).
Da komplekse software-systemer genererer et stort antal metrikker, bliver manuel overvågning en udfordrende opgave. For at reducere mængden af data, som administratoren skal analysere, indeholder overvågningsværktøjer funktioner til automatisk at opdage mulige problemer. For eksempel kan man indstille en trigger, der aktiveres, når det ledige diskplads falder til et angivet niveau. Man kan også automatisk diagnosticere serverstop eller kritisk nedsat servicerate. I praksis klarer overvågningsværktøjer sig godt med at opdage allerede indtrufne fejl eller identificere enkle symptomer på fremtidige fejl, men generelt forbliver forudsigelsen af mulige nedbrud en stor udfordring for dem. Forudsigelse gennem manuel analysere af metrikker kræver kvalificerede specialister og er ineffektiv. De fleste potentielle fejlfunktioner kan forblive uopdagede.
For tiden vinder den såkaldte predictive maintenance af software-systemer stadig mere popularitet blandt store IT-virksomheder, der udvikler software. Essensen af denne tilgang er at finde problemer, der fører til systemdegradering på et tidligt stadium, før det fejler, ved hjælp af kunstig intelligens. Denne tilgang udelukker ikke fuldstændig manuel overvågning af systemet, men fungerer som et supplement til den overordnede overvågningsproces.
Hovedværktøjet til implementering af predictive maintenance er opgaven med at finde anomalier i tidsserier, da når der opstår en anomali i dataene, er der stor sandsynlighed for, at der efter noget tid der vil opstå en fejl eller nedbrud. En anomali er en afvigelse i indikatorerne for det softwarebaserede system, såsom opdageren af nedgang i responstiden for en bestemt type forespørgsel eller et fald i det gennemsnitlige antal håndterede anmodninger ved et konstant niveau af kundesessioner.
Opgaven med at finde anomalier i softwarebaserede systemer har sin egen specifik. I teorien kræver hver softwarebaseret system udvikling eller tilpasning af de eksisterende metoder, da anomalidetektering er meget afhængig af de data, hvori den udføres, og dataene for softwarebaserede systemer varierer meget afhængigt af implementeringsværktøjerne, helt ned til hvilken beregningsmaskine den kører på.
Metoder til opdagelse af anomalier ved forudsigelse af fejl i softwarebaserede systemer
Først og fremmest er det værd at nævne, at ideen om forudsigelse af fejl blev inspireret af artiklen . For at teste effektiviteten af tilgangen med automatisk anomaliopdagelse blev det softwarebaserede system «Web-Konsolidering» valgt, som er et af projekterne fra NPO «Krista». Tidligere blev der udført manuel overvågning baseret på de modtagne metrikker. Da systemet er ret komplekst, indsamles der et stort antal metrikker for det: JVM-metrikker (garbage collection-belastning), OS-metrikker, hvorunder koden udføres (virtuel hukommelse, % CPU-belastning), netværksmetrikker (netværksbelastning), serverens egne metrikker (CPU- og hukommelsesbelastning), wildfly-metrikker og egne applikationsmetrikker i alle kritiske undersystemer.
Alle metrikker indsamles fra systemet ved hjælp af graphite. Oprindeligt blev whisper-database brugt som standardløsning til grafana, men med væksten af kundebasen kunne graphite ikke længere klare det og udtømte diskens I/O kapacitet. Derefter blev der truffet beslutning om at finde en mere effektiv løsning. Valget faldt på , hvilket gjorde det muligt at reducere belastningen på diskens subsystem med en orden og reducere det optagne diskplads med fem til seks gange. Nedenfor præsenteres diagrammet for mekanismen til indsamling af metrikker med brug af graphite+clickhouse (figur 2).
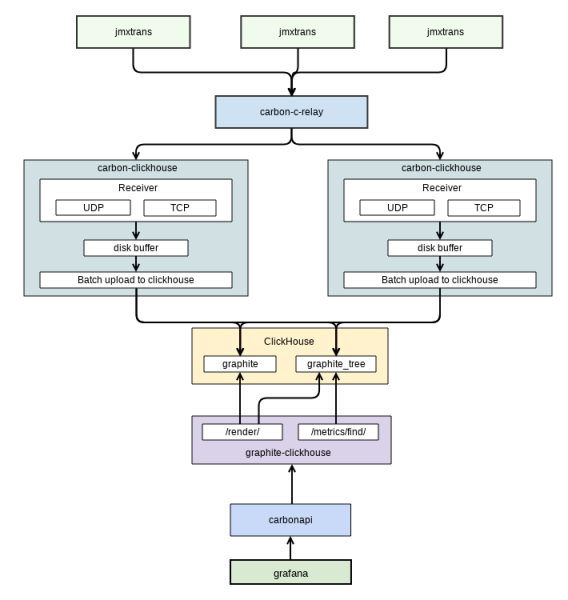
Figur 2. Diagram for indsamling af metrikker
Diagrammet er hentet fra intern dokumentation. Den viser dataudvekslingen mellem grafana (brugergrænsefladen til overvågning, som vi bruger) og graphite. Indhentning af metrikker fra applikationen udføres af et separat software – . Det leverer også dataene til graphite.
Systemet "Web-Konsolidering" har en række særlige kendetegn, der skaber problemer for fejlprognoser:
- der sker ofte en ændring i tendenserne. For dette software system frigives der forskellige versioner. Hver version medfører ændringer i den softwaremæssige del af systemet. Følgelig kan udviklerne direkte påvirke metrikkerne for dette system og forårsage ændringer i tendenserne;
- den specifikke implementering samt mål for anvendelse fra kunderne af dette system medfører ofte anomalier uden forudgående nedgang;
- procentdelen af anomalier i forhold til hele datasettet er lav (< 5%);
- der kan opstå afbrydelser i dataindsamlingen fra systemet. I nogle korte tidsintervaller kan overvågningssystemet ikke indhente metrikker. For eksempel, hvis serveren er overbelastet. Dette er kritisk for at træne neurale netværk. Der opstår behov for at fylde hullerne syntetisk;
- Sager med anomalier er ofte relevante kun for et specifikt tal/måned/tid (sæsonbestemt). Dette system har klare retningslinjer for brug fra dets brugere. Følgelig er metrikkerne kun relevante for et bestemt tidspunkt. Systemet kan ikke bruges konstant, men kun i nogle måneder: selektivt afhængigt af året. Der opstår situationer, hvor den samme metrikadfærd i et tilfælde kan føre til fejl i software systemet, mens det i et andet ikke gør.
Først blev metoderne til at opdage anomalier i overvågningsdata for software systemer analyseret. I artikler om dette emne, når anomalierne udgør en lav procentdel af det øvrige datasæt, foreslås det oftest at bruge neurale netværk.
Den primære logik til at finde anomalier ved hjælp af data fra neurale netværk er skildret i figur 3:
Figur 3. Søgning efter anomalier ved hjælp af et neuralt netværk
I resultatet af prognosen eller gendannelsen af vinduet for den aktuelle strøm af metrics beregnes afvigelsen fra de værdier, der er opnået fra det fungerende softwaresystem. I tilfælde af store forskelle mellem de indsamlede metrics fra softwaresystemet og den neurale netværk kan man konkludere, at den aktuelle datasektion er unormal. Der opstår en række problemer ved brugen af neurale netværk:
- for at fungere korrekt i streamingtilstand skal dataene til træningen af neurale netværksmodeller kun inkludere "normale" data;
- det er nødvendigt at have en aktuel model for korrekt opdagelse. Skift i trends og sæsonbetonede variationer i metrics kan forårsage et stort antal falske positiver fra modellen. For at opdatere modellen er det nødvendigt præcist at bestemme tidspunktet, hvor modellen er forældet. Hvis modellen opdateres for sent eller for tidligt, vil det sandsynligvis resultere i mange falske positiver.
Man må heller ikke glemme at finde og forhindre hyppig opståen af falske positiver. Det forventes, at de oftest vil opstå i usædvanlige situationer. Men de kan også være et resultat af fejl i det neurale netværk på grund af utilstrækkelig træning. Det er nødvendigt at minimere antallet af falske positiver. Ellers vil falske prognoser spilde meget tid for administratoren, der er beregnet til at overvåge systemet. Før eller siden vil det ende med, at administratoren simpelthen vil stoppe med at reagere på det "paranoide" overvågningssystem.
Recurrent Neural Network
For at opdage anomalier i tidsserier kan man anvende med LSTM-hukommelse. Problemet er blot, at det kun kan anvendes til forudsigelige tidsserier. I vores tilfælde er ikke alle metrics forudsigelige. Forsøget på at anvende RNN LSTM til tidsserien er præsenteret i figur 4.
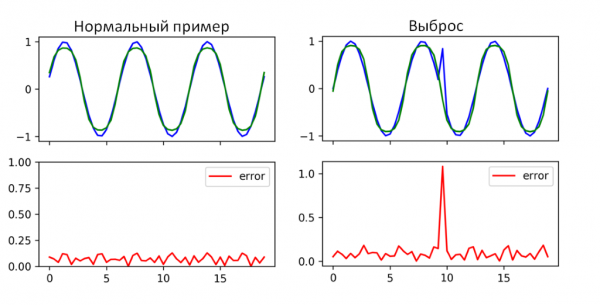
Figur 4. Eksempel på arbejdet med et recurrent neural network med LSTM-hukommelsesceller
Som det fremgår af figur 4, var RNN LSTM i stand til at håndtere anomalidetektion på dette tidsafsnit. Der, hvor resultatet har en høj prognosefejl (medianfejl), opstod der faktisk en anomali i målingerne. At bruge kun én RNN LSTM vil åbenlyst være utilstrækkeligt, da den kun kan anvendes til et begrænset antal målinger. Den kan bruges som en supplerende metode til anomalidetektion.
Autokoderen til fejlfrekvensprognoser
– er i sin essens et kunstigt neuralt netværk. Indgangslaget – encoder, udgangslaget – decoder. Ulempen ved alle neurale netværk af denne type er, at de dårligt lokaliserer anomalier. Arkitekturen af en synkron autokoder blev valgt.
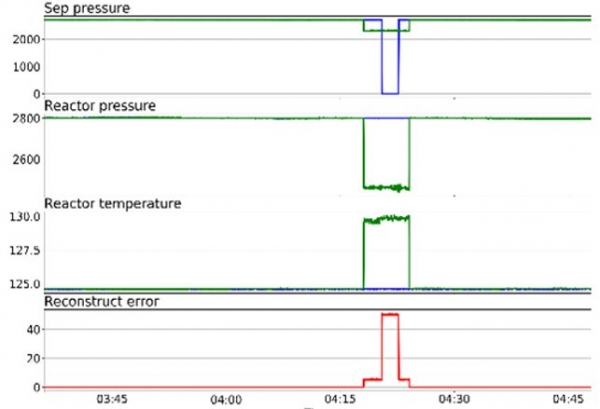
Figur 5. Eksempel på autokoderen i funktion
Autokodere trænes på normale data og finder derefter anomalier i de data, der behandles af modellen. Dette er præcis det, vi har brug for til denne opgave. Det er kun nødvendigt at vælge, hvilken autokoder der passer til denne opgave. Den arkitektonisk mest simple form for autokoder er en direkte, irreversible neuralt netværk, der minder meget om (multilayer perceptron, MLP), med et indgangsniveau, et udgangsniveau samt en eller flere skjulte lag, der forbinder dem.
Forskellene mellem autokodere og MLP ligger dog i, at i autokoderen har udgangsniveauet samme antal noder som indgangsniveauet, og at i stedet for at lære at forudsige en målværdi Y, givet indgang X, lærer autokoderen at rekonstruere sine egne X. Derfor er autokodere ikke-overvågede læringsmodeller.
Opgaven for autokoderen er at finde tidsindekserne r0 … rn, der svarer til de anomale elementer i indgangsvektoren X. Denne effekt opnås ved at søge efter kvadratiske fejl.
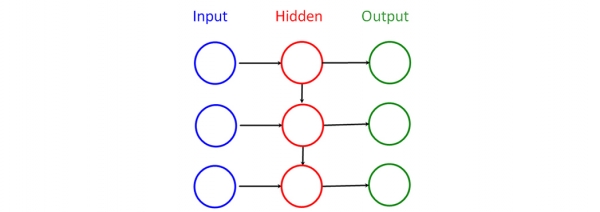
Figur 6. Synkron autokoder
For autokoderen blev der valgt en . Dens fordele: mulighed for at anvende streamingbehandling og relativt færre parametre i det neurale netværk sammenlignet med andre arkitekturer.
Mekanismen til at minimere falske alarmer
Da der der opstår forskellige unormale situationer, og der muligvis er situationer med utilstrækkelig træning af neurale netværk, blev der truffet beslutning om nødvendigheden af at udvikle en mekanisme til at minimere falske alarmer for den udviklede model til opdagelse af anomalier. Denne mekanisme er baseret på en skabelondatabase, som klassificeres af administratoren.
(DTW-algoritmen, fra engelsk dynamic time warping) gør det muligt at finde optimal korrespondance mellem tidssekvenser. Den blev første gang anvendt i talegenkendelse: det blev brugt til at bestemme, hvordan to taleoptagelser repræsenterer den samme udtalte sætning. Senere blev det fundet anvendelse i andre områder.
Hovedprincippet for at minimere falske alarmer er at indsamle en database af standarder ved hjælp af en operatør, som klassificerer mistænkelige tilfælde opdaget ved hjælp af neurale netværk. Herefter sammenlignes den klassificerede standard med det tilfælde, som systemet har opdaget, og der drages konklusioner om, hvorvidt tilfældet tilhører de falske eller fører til en fejl. Det er netop til sammenligning af to tidsserier, at DTW-algoritmen anvendes. Det primære værktøj til minimisering er dog klassificering. Det antages, at efter indsamlingen af et stort antal standardiserede tilfælde, vil systemet spørge operatøren mindre på grund af ligheden mellem de fleste tilfælde og fremkomsten af lignende.
Som resultat af de beskrevne metoder til neurale netværk er der blevet udviklet et eksperimentelt program til forudsigelse af fejl i systemet "Web-Konsolidering". Formålet med dette program var at vurdere effektiviteten af denne tilgang til vores software-systemer ved at bruge den eksisterende overvågningsdataarkiv og information om allerede opståede fejl. Programmet er beskrevet nedenfor i figur 7.
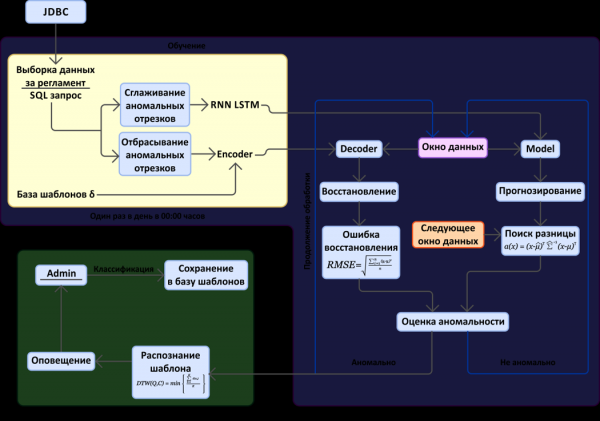
Figur 7. Diagram for forudsigelse af fejl baseret på analyse af metricsrum
I diagrammet kan der skelnes mellem to hovedblokke: søgning efter anomale tidssegmenter i dataovervågningsstrømmen (metrics) og mekanismen til at minimere falske alarmer. Note: Til eksperimentelle formål hentes dataene gennem JDBC-forbindelsen fra den database, hvor de gemmes i graphite.
Her præsenteres brugergrænsefladen for det udviklede overvågningssystem (figur 8).
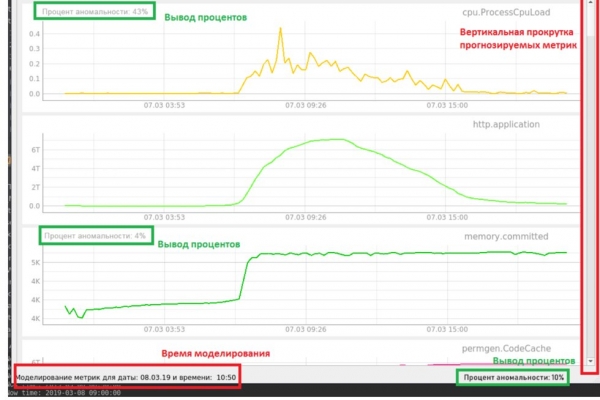
Figur 8. Brugergrænseflade for det eksperimentelle overvågningssystem
På brugergrænsefladen vises procentdelen af anomalier baseret på de modtagne målinger. I vores tilfælde simuleres indhentningen. Vi har allerede data for flere uger og indlæser dem gradvist for at kontrollere en situation med en anomali, der fører til svigt. I den nederste statuslinje vises den samlede procentdel af anomalier for de aktuelle data, som bestemmes ved hjælp af en autoencoder. Derudover vises en separat procentdel for de forudsigte målinger, som beregnes af RNN LSTM.
Eksempel på anomaliopdagelse for CPU-målinger ved hjælp af RNN LSTM (figur 9).
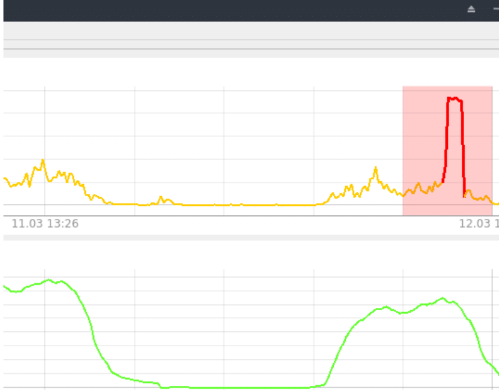
Figur 9. Opdagelse med RNN LSTM
Et ret simpelt tilfælde, faktisk en almindelig outlier, men som fører til systemfejl, blev med succes identificeret ved hjælp af RNN LSTM. Anomaliprocenten i dette tidsinterval var 85 – 95%, alt, der er over 80% (grænsen blev fastsat eksperimentelt), betragtes som en anomali.
Eksempel på anomaliopdagelse, når systemet ikke kunne starte efter en opdatering. Denne situation detekteres af autoencoderen (figur 10).
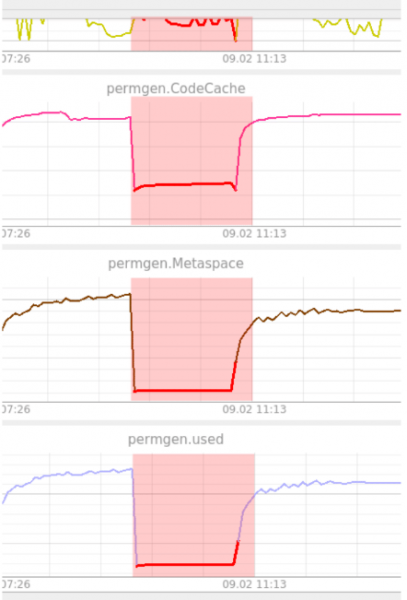
Figur 10. Eksempel på opdagelse af autoencoder
Som det ses i figuren, hang PermGen på et niveau. Autoencoderen fandt det usædvanligt, da den tidligere ikke havde set noget lignende. Her holdes anomalien konstant på 100% indtil systemet igen bliver operationelt. Anomalien vises for alle målinger. Som nævnt tidligere kan autoencoderen ikke lokalisere anomalier. Operatøren er ansvarlig for at udføre denne funktion i disse situationer.
Konklusion
PC 'Web-Konsolidering' er blevet udviklet i flere år. Systemet er i en tilstrækkelig stabil tilstand, og antallet af registrerede hændelser er begrænset. Ikke desto mindre har det været muligt at finde anomalier, der førte til svigt 5 – 10 minutter før svigtet opstod. I nogle tilfælde ville forudsigelserne om svigt have hjulpet med at spare den planlagte tid, der er afsat til 'reparations'-arbejde.
På de eksperimenter, der er blevet udført, er det stadig for tidligt at drage endelige konklusioner. I øjeblikket er resultaterne modstridende. På den ene side viser det sig, at algoritmer baseret på neurale netværk er i stand til at finde "nyttige" anomalier. På den anden side er der stadig en stor procentdel af falske positiver, og ikke alle anomalier, der identificeres af en kvalificeret specialist, kan det neurale netværk opdage. En ulempe er også, at neurale netværk i øjeblikket kræver supervisioneret læring for at fungere optimalt.
For at videreudvikle systemet til fejlfinding og bringe det til en tilfredsstillende tilstand kan flere veje overvejes. Det inkluderer en mere detaljeret analyse af tilfælde med anomalier, der fører til fejl, ved at udvide listen over vigtige metrikker, der har stor indflydelse på systemets tilstand, og fjerne de unødvendige, der ikke påvirker det. Derudover, hvis man følger denne retning, kan der gøres forsøg på at specialisere algoritmer konkret til vores tilfælde med anomalier, der fører til fejl. Der er også en anden vej. Det er forbedringen af arkitekturer for neurale netværk og derved øge nøjagtigheden af opdagelser med kortere træningstid.
Jeg vil gerne takke kollegerne, der har hjulpet mig med at skrive og holde denne artikel aktuel: og Sergey Finogenov.
Kilde: habr.com
