

er et kolonnebaseret databasesystem til online behandling af analytiske forespørgsler (OLAP) med åben kildekode, skabt af Yandex. Det bruges af Yandex, CloudFlare, VK.com, Badoo og andre tjenester over hele verden til at gemme virkelig store datamængder (indføring af tusindvis af rækker per sekund eller petabytes af data gemt på disk).
I en almindelig, 'rækkebaseret' database, som MySQL, Postgres, MS SQL Server, gemmes data i følgende rækkefølge:
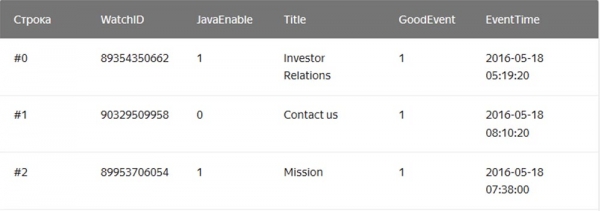
Her opbevares værdier, der tilhører en række, fysisk tæt på hinanden. I kolonnebaserede databaser opbevares værdier fra forskellige kolonner separat, mens data fra én kolonne opbevares sammen:
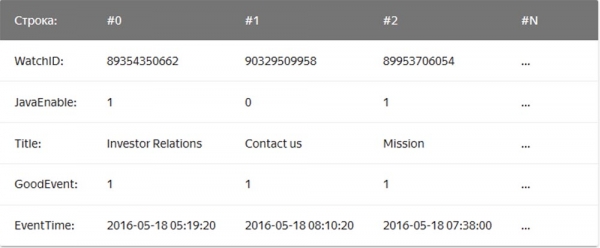
Eksempler på kolonnebaserede databaser inkluderer Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Virksomhed – mailforwarder begyndte at bruge Clickhouse i 2018 til at generere rapporter og var meget imponeret over dens enkelhed, skalerbarhed, SQL-support og hastighed. Hastigheden på denne database grænsede til magi.
Simplicity
Clickhouse installeres i Ubuntu med én enkelt kommando. Hvis du kender SQL, kan du straks begynde at bruge Clickhouse til dine behov. Dette betyder dog ikke, at du kan udføre 'show create table' i MySQL og kopiere SQL direkte ind i Clickhouse.
I forhold til MySQL er der vigtige forskelle i datatyper i definitionerne af tabelskemaer i denne database, så for en behagelig oplevelse skal du alligevel bruge noget tid på at ændre tabelskemaerne og lære tabelmotorerne at kende.
Clickhouse fungerer godt uden noget ekstra software, men hvis du ønsker at bruge replikering, skal du installere ZooKeeper. Analyse af forespørgselsydelsen viser fremragende resultater — systemtabeller indeholder al information, og alle data kan opnås ved hjælp af den gamle og kedelige SQL.
Ydeevne
- sammenligninger af Clickhouse med Vertica og MySQL på serverkonfigurationen: to sokler Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 på 8 6TB SATA HDD, ext4.
- sammenligninger af Clickhouse med Amazon RedShift cloud datalager.
- Uddrag fra bloggen :
ClickHouse-databasen har et meget simpelt design - alle noder i klyngen har den samme funktionalitet og bruger kun ZooKeeper til koordinering. Vi opbyggede en lille klynge bestående af flere noder og gennemførte test, hvor vi opdagede, at systemet har en ret imponerende ydeevne, der svarer til de angivne fordele i benchmarks for analytiske DBMS. Vi besluttede at undersøge konceptet bag ClickHouse nærmere. Den første hindring for forskningen var fraværet af værktøjer og det lille ClickHouse-fællesskab, så vi dykkede ned i designet af denne DBMS for at forstå, hvordan den fungerer.
ClickHouse understøtter ikke direkte modtagelse af data fra Kafka, da det kun er en database, så vi skrev vores egen adapter-service i Go. Den læste de kodede Cap’n Proto-beskeder fra Kafka, omformede dem til TSV og indsatte dem i ClickHouse i pakker via HTTP-grænsefladen. Senere omskrev vi denne service for at bruge Go-biblioteket sammen med vores eget ClickHouse-grænseflade for at forbedre ydeevnen. Ved vurdering af ydeevnen ved modtagelse af pakker fandt vi en vigtig ting - ClickHouse's ydeevne er meget afhængig af pakkestørrelsen, det vil sige antallet af indsatte rækker på én gang. For at forstå, hvorfor dette sker, undersøgte vi, hvordan ClickHouse gemmer data.
Den primære motor, eller rettere sagt, motorfamilien for tabeller, der anvendes af ClickHouse til datalagring, er MergeTree. Denne motor er konceptuelt lignende LSM-algoritmen anvendt i Google BigTable eller Apache Cassandra, men undgår at opbygge et midlertidigt hukommelsestabel og skriver data direkte til disken. Dette giver den fremragende skrivekapacitet, da hver indsat pakke kun sorteres efter “primærnøglen” primary key, komprimeres og skrives til disken for at danne et segment.
Fraværet af en hukommelsestabel eller noget koncept om "frezhed" af data betyder også, at de kun kan tilføjes; ændring eller sletning understøttes ikke af systemet. I dag er den eneste måde at slette data på at gøre det måned for måned, da segmenter aldrig krydser grænsen for måneden. ClickHouse-teamet arbejder aktivt på at gøre denne funktion konfigurerbar. På den anden side gør dette optagelse og sammenlægning af segmenter konfliktfri, så båndbredden til optagelse skalerer lineært med antallet af parallelle indstillinger, indtil I/O eller kernerne bliver mættede.
Men denne omstændighed betyder også, at systemet ikke er velegnet til små pakker, så der bruges Kafka-tjenester og insertionsværktøjer til at bufferdata. Desuden fortsætter ClickHouse i baggrunden med konstant at udføre sammenlægning af segmenter, så mange små informationsstykker vil blive samlet og skrevet flere gange, hvilket dermed øger skriveintensiteten. Herudover vil for mange usammenhængende dele forårsage aggressiv throttling af indstillinger, indtil sammenlægningen er færdig. Vi har fundet ud af, at den bedste kompromis mellem realtidsdatamodtagelse og modtageydelse er at acceptere et begrænset antal indstillinger pr. sekund til tabellen.
Nøglen til læseydelse af tabeller er indeksering og placering af data på disken. Uanset hvor hurtigt behandlingen er, når motoren skal scanne terabyte af data fra disken og kun bruge en del af dem, vil det tage tid. ClickHouse er et kolonnebaseret lager, så hver sektion indeholder en fil for hver kolonne med sorterede værdier for hver række. På denne måde kan hele kolonner, der ikke er til stede i forespørgslen, først springes over, og så kan flere celler behandles parallelt med vektorisering. For at undgå fuld scanning har hver sektion en lille indeksfil.
Da alle kolonner er sorteret efter "primærnøgle", indeholder indeksfilen kun mærker (fangne rækker) for hver N-te række, så de kan opbevares i hukommelsen, selv for meget store tabeller. For eksempel kan standardindstillingerne fastsættes til "at mærke hver 8192. række", så "sparsom" indeksering af en tabel med 1 billion rækker, som let kan opbevares i hukommelsen, kun vil tage 122.070 tegn.
Systemudvikling
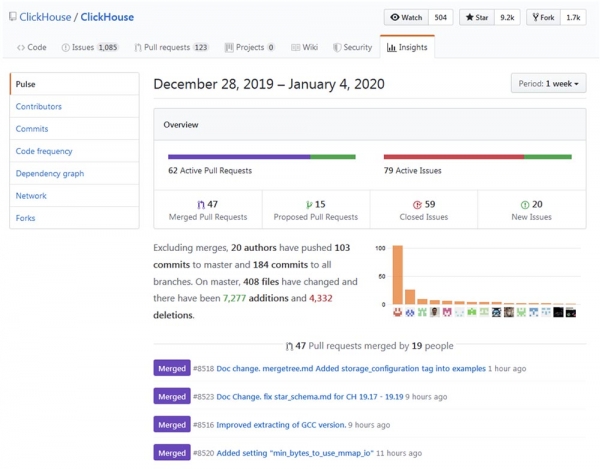
Udviklingen og forbedringen af Clickhouse kan spores på og bekræfte, at "vækst"-processen sker i imponerende tempo.
Popularitet
Det ser ud til, at populariteten af Clickhouse vokser eksponentielt, især i det russisksprogede samfund. Sidste års High Load 2018-konference (Moskva, 8-9 november 2018) viste, at sådanne kæmper som vk.com og Badoo bruger Clickhouse, hvilket muliggør indsættelse af data (f.eks. logs) fra titusinder af servere samtidig. I en 40-minutters video . Snart vil vi uploade transskriptionen til Habr for at lette arbejdet med materialet.
Anvendelsesområder
Efter at have brugt lidt tid på forskning, tror jeg, at der er områder, hvor ClickHouse kan være nyttigt eller helt erstatte andre, mere traditionelle og populære løsninger som MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot og Druid. Her er detaljer om brugen af ClickHouse til at modernisere eller helt erstatte de nævnte DBMS.
Udvidelse af mulighederne i MySQL og PostgreSQL
For nylig udskiftede vi delvist MySQL med ClickHouse til platformen for informationsnyhedsbreve Problemet var, at MySQL på grund af en uhensigtsmæssig design registrerede hver sendte e-mail og hvert link i denne e-mail med en base64-hash, hvilket skabte en enorm MySQL-tabel (email_stats). Efter at have sendt 10 millioner e-mails til abonnenterne fyldte denne tabel 150 GB diskplads, og MySQL begyndte at 'slæbe' ved simple forespørgsler. For at løse problemet med diskplads brugte vi med succes InnoDB-komprimering af tabellen, hvilket reducerede dens størrelse med 4. Men det giver ikke mening at gemme over 20-30 millioner e-mails i MySQL blot for at læse historikken, da enhver simpel forespørgsel, der af en eller anden grund skal udføre en fuld scanning, fører til swapping og stor I/O-belastning, hvilket ofte førte til advarsler fra Zabbix.
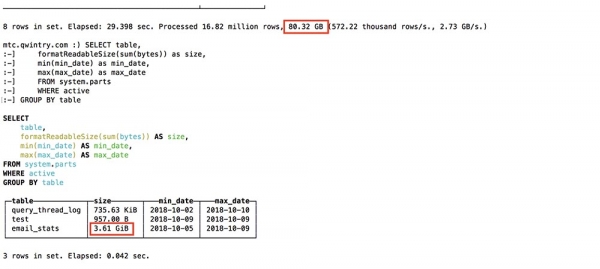
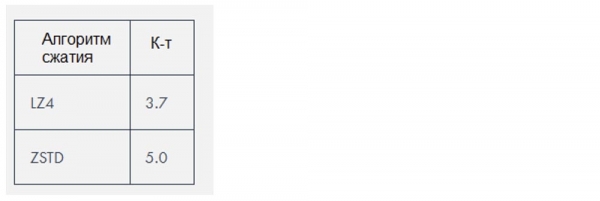
Clickhouse bruger to komprimeringsalgoritmer, der reducerer datamængden med cirka , men i dette konkrete tilfælde var dataene særligt lette at komprimere.
Erstatning af ELK
Baseret på egne erfaringer kræver ELK-stakken (ElasticSearch, Logstash og Kibana, i dette specifikke tilfælde ElasticSearch) langt flere ressourcer til drift, end hvad der er nødvendigt for opbevaring af logs. ElasticSearch er en fremragende motor, hvis du har brug for god fuldtekst-søgning i logs (og jeg mener ikke, at du virkelig har brug for det), men jeg undrer mig over, hvorfor det de facto er blevet standardmotoren til logføring. Dens modtagelsesydelse i kombination med Logstash skabte problemer selv ved ret små belastninger og krævede mere og mere RAM og diskplads. Som database er Clickhouse bedre end ElasticSearch af følgende grunde:
- Understøttelse af SQL-dialekt;
- Bedre komprimeringsgrad af gemte data;
- Understøttelse af regulære udtryks søgninger i stedet for fuldtekst-søgning;
- Forbedret forespørgselsplanlægning og højere samlet ydeevne.
I øjeblikket er den største udfordring ved at sammenligne ClickHouse med ELK manglen på løsninger til logudladning samt manglen på dokumentation og vejledninger om emnet. Samtidig kan enhver bruger konfigurere ELK ved hjælp af Digital Ocean-guiden, hvilket er meget vigtigt for hurtig implementering af sådanne teknologier. Der er en DB-motor her, men der er stadig ikke noget Filebeat til ClickHouse. Ja, der er og og system til logstyring , findes der et værktøj til at indtaste logfilsdata i ClickHouse, men alt dette kræver mere tid. Alligevel er ClickHouse stadig førende på grund af sin enkelhed, så selv begyndere kan let installere det og begynde at bruge det fuldt ud inden for 10 minutter.
Idet jeg foretrækker minimalistiske løsninger, forsøgte jeg at bruge FluentBit, et værktøj til at sende logs med meget lav hukommelsesforbrug, sammen med ClickHouse, og jeg forsøgte at undgå brugen af Kafka. Men det er nødvendigt at fjerne små inkompatibiliteter som , før det kan gøres uden et proxy-lag, der konverterer data fra FluentBit til ClickHouse.
Som et alternativ til Kibana kan ClickHouse bruges som backend . Så vidt jeg forstår, kan der opstå problemer med ydeevnen ved rendering af enorme mængder datapunkter, især med ældre versioner af Grafana. Hos Qwintry har vi ikke prøvet dette endnu, men klager over dette opstår fra tid til anden på ClickHouse's supportkanal i Telegram.
Erstatning for Google Big Query og Amazon RedShift (løsning for store virksomheder)
Den ideelle anvendelse af BigQuery er at uploade 1 TB JSON-data og udføre analytiske forespørgsler på dem. Big Query er et fremragende produkt, hvis skalerbarhed er svær at overvurdere. Det er en langt mere kompleks software end ClickHouse, der kører på interne klynger, men set fra kundens perspektiv har det meget til fælles med ClickHouse. BigQuery kan hurtigt 'blive dyrt', så snart du begynder at betale for hver SELECT, så det er en rigtig SaaS-løsning med alle dens fordele og ulemper.
ClickHouse er det bedste valg, når du udfører mange ressourcekrævende forespørgsler. Jo flere SELECT-forespørgsler du udfører hver dag, desto mere meningsfuldt er det at erstatte Big Query med ClickHouse, fordi en sådan udskiftning kan spare dig tusindvis af dollars, hvis vi taler om mange terabytes behandlet data. Dette gælder ikke for lagrede data, hvor behandlingen i Big Query er relativt billig.
I artiklen fra medstifteren af Altinity, Alexander Zaitsev, beskrives fordelene ved en sådan migrationsdatabase.
Erstatning for TimescaleDB
TimescaleDB er et udvidelse til PostgreSQL, som optimerer arbejdet med tidsserier i en almindelig database (, ).
Selvom ClickHouse ikke er en seriøs konkurrent inden for tidsserier, så er dets kolonnestruktur og vektorbearbejdning i de fleste tilfælde hurtigere end TimescaleDB, når det kommer til analytiske forespørgsler. Samtidig er ClickHouse's ydeevne ved modtagelse af batchdata cirka tre gange højere, og det bruger 20 gange mindre diskplads, hvilket er virkelig vigtigt for behandling af store mængder historiske data:.
I modsætning til ClickHouse er den eneste måde at spare lidt diskplads i TimescaleDB på at bruge ZFS eller lignende filsystemer.
De kommende opdateringer af ClickHouse vil sandsynligvis indføre delta-komprimering, som vil gøre det endnu mere egnet til behandling og opbevaring af tidsseriedata. TimescaleDB kan blive det bedste valg i forhold til "ren" ClickHouse i følgende tilfælde:
- små installationer med meget begrænset RAM (<3 GB);
- et stort antal små INSERTs, som du ikke ønsker at buffer i store fragmenter;
- bedre konsistens, ensartethed og ACID-krav;
- PostGIS-support;
- integration med eksisterende PostgreSQL-tabeller, da TimescaleDB i bund og grund er PostgreSQL.
Konkurrence med Hadoop og MapReduce
Hadoop og andre MapReduce-produkter kan udføre mange komplekse beregninger, men de arbejder typisk med enorme forsinkelser. ClickHouse løser dette problem ved at behandle terabyte af data og næsten øjeblikkeligt levere resultater. Derfor er ClickHouse meget mere effektiv til hurtig, interaktiv analytisk forskning, hvilket burde interessere dataanalytikere.
Konkurrence med Pinot og Druid
De nærmeste konkurrenter til ClickHouse er kolonne-baserede, lineært skalerbare open-source produkter Pinot og Druid. En grundig sammenligning af disse systemer er offentliggjort i artiklen den 1. februar 2018.
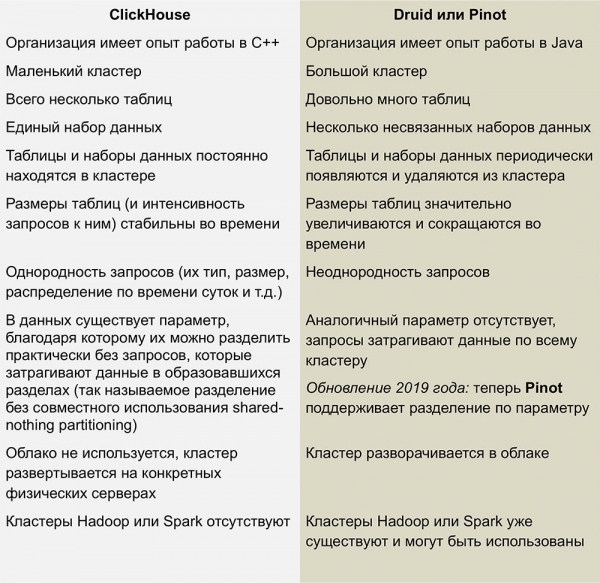
Denne artikel kræver opdatering – den angiver, at ClickHouse ikke understøtter UPDATE og DELETE-operationer, hvilket ikke er helt korrekt i forhold til de nyeste versioner.
Vi har ikke tilstrækkelig erfaring med disse databaser, men jeg er bestemt ikke tilfreds med den kompleksitet af infrastrukturen, der kræves for at køre Druid og Pinot — der er en hel del 'bevægelige dele', der er omkranset af Java fra alle sider.
Druid og Pinot er Apache-inkubatorprojekter, hvis udvikling detaljeres af Apache på deres GitHub-projekt-sider. Pinot kom ind i inkubatoren i oktober 2018, mens Druid blev født 8 måneder tidligere — i februar.
Manglen på information om, hvordan AFS fungerer, rejser nogle, muligvis dumme, spørgsmål for mig. Jeg undrer mig over, om skaberne af Pinot har bemærket, at Apache Foundation er mere tilbøjelige til Druid, og om denne indstilling til konkurrenten har skabt jalousi? Vil udviklingen af Druid stagnere, mens udviklingen af Pinot vil accelerere, hvis sponsorerne, der støtter den første, pludselig bliver interesserede i den anden?
Ulemper ved ClickHouse
Umodenhed: det er åbenlyst, at dette stadig er en spændende teknologi, men hvad angår dette, ses der ikke noget lignende i andre kolonneorienterede databaser.
Små indlæsninger fungerer dårligt ved høj hastighed: indlæsninger skal opdeles i store portioner, fordi ydeevnen for små indlæsninger falder i forhold til antallet af kolonner i hver række. Sådan lagres data i ClickHouse på disken — hver kolonne svarer til 1 eller flere filer, så for at indsætte 1 række, der indeholder 100 kolonner, er det nødvendigt at åbne og skrive til mindst 100 filer. Derfor kræves der en mellemmand til buffering af indlæsninger (medmindre klienten selv sørger for buffering) — det er normalt Kafka eller et eller andet køhåndteringssystem. Det er også muligt at bruge Buffer-table-motoren til senere at kopiere store datastykker ind i MergeTree-tabeller.
Tabel-forbindelser er begrænset af serverens RAM, men de er i det mindste til stede! For eksempel har Druid og Pinot slet ingen sådanne forbindelser, da det er svært at implementere direkte i distribuerede systemer, der ikke understøtter flytning af store datastykker mellem noder.
Konklusioner
I de kommende år planlægger vi at anvende ClickHouse bredt i Qwintry, da denne DBMS tilbyder en fremragende balance mellem ydeevne, lave omkostninger, skalerbarhed og enkelhed. Jeg er næsten sikker på, at den hurtigt vil begynde at sprede sig, så snart ClickHouse-fællesskabet finder flere anvendelsesmuligheder for den i små og mellemstore installationer.
Lidt reklame 🙂
Tak fordi du bliver hos os. Kan du lide vores artikler? Ønsker du at se flere interessante materialer? Støt os ved at bestille eller anbefale os til dine bekendte, , en unik analog til entry-level servere, som vi har designet til dig: (tilgængelige muligheder med RAID1 og RAID10, op til 24 kerner og op til 40 GB DDR4).
Dell R730xd til halv pris i datacenteret Equinix Tier IV i Amsterdam? Kun hos os i Holland! Dell R420 - 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB - fra 99 $! Læs om hvordan
Kilde: habr.com
