

I dag findes der færdige (propriety) løsninger til overvågning af IP(TS)-strømme, for eksempel og , de har et ret omfattende funktionssæt, og sådanne løsninger findes normalt hos større operatører, der arbejder med tv-tjenester. I denne artikel beskrives en løsning baseret på open source-projektet , som er designet til minimal kontrol af IP(TS)-strømme ved hjælp af CC (continuity counter) og bitrate. En mulig anvendelse er kontrol af pakketab eller hele strømmen via en lejet L2-kanal (hvor man ikke har mulighed for ordentlig overvågning, for eksempel ved at læse tabstællere i køer).
Kort om TSDuck
TSDuck er open source (2-Clause BSD-licens) software (et sæt kommandolinjeværktøjer og et bibliotek til udvikling af egne værktøjer eller plugins) til manipulation af TS-strømme. Som input kan den arbejde med IP (multicast/unicast), http, hls, dvb-tunere, dektec dvb-asi demodulator, den har en intern TS-strømmegenerator og læser fra filer. Som output kan den gemme til fil, IP (multicast/unicast), hls, dektec dvb-asi og HiDes modulatore, spillere (mplayer, vlc, xine) og drop. Mellem input og output kan der indsættes forskellige trafikprocessorer, for eksempel PID-mapping, scrambling/descrambling, analyse af CC-tællere, bitrate-beregning og andre typiske operationer for TS-strømme.
I denne artikel vil IP-strømme (multicast) blive brugt som input, og trafikprocessorerne bitrate_monitor (det fremgår af navnet, hvad det er) og continuity (analyse af CC-tællere) vil blive anvendt. Uden større problemer kan man erstatte IP multicast med en anden indgangstype, som TSDuck understøtter.
Der findes af TSDuck til de fleste moderne OS. For Debian findes de ikke, men det var muligt at samle uden problemer til Debian 8 og Debian 10.
Den anvendte version af TSDuck er 3.19-1520, og operativsystemet, der anvendes, er Linux (til forberedelse af løsningen blev Debian 10 brugt, til den faktiske anvendelse — CentOS 7)
Forberedelse af TSDuck og OS
Før du overvåger de reelle strømme, skal du sikre dig, at TSDuck fungerer korrekt, og at der ikke er drop på netværkskortet eller OS'et (sockets). Dette er nødvendigt for at undgå at spekulere på, hvor dropsene opstod — i netværket eller 'inde i serveren'. For at tjekke drops på netværkskortet kan du bruge kommandoen ethtool -S ethX, tuning foretages også med ethtool (normalt skal RX-bufferen (-G) øges, og nogle gange skal visse offloads (-K) deaktiveres). En generel anbefaling er at bruge en separat port til at modtage den analyserede trafik, hvis det er muligt; dette minimerer falske alarmer forårsaget af, at der opstod drop netop på analysatorens port på grund af anden trafik. Hvis dette ikke er muligt (brug af en mini-computer/NUC med én port), er det meget ønskeligt at konfigurere prioritering af den analyserede trafik i forhold til resten på enheden, som analysatoren er tilsluttet. I forbindelse med virtuelle miljøer skal man være forsigtig og være i stand til at finde packet drops fra den fysiske port til applikationen inde i den virtuelle maskine.
Generering og modtagelse af strøm inden for værten
Som et første skridt i forberedelsen af TSDuck skal vi generere og modtage trafik inden for en enkelt vært ved hjælp af netns.
Forbereder miljøet:
ip netns add P #opretter netns P, hvor trafikanalysen vil finde sted
ip link add type veth #opretter en veth-par - veth0 forbliver i netns som standard (trafikken vil blive genereret til denne grænseflade)
ip link set dev veth1 netns P #veth1 - placeres i netns P (trafikken vil blive modtaget på denne grænseflade)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #aktiverer IP på veth1, hvilken specifik IP er ligegyldig
ip netns exec P ip ro add default via 192.0.2.2 #konfigurerer standardruten inden for netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #deaktiverer IPv6 på veth0 - dette gøres for at undgå, at ikke-relevant trafik tælles med i TX
ifconfig veth0 up #aktiverer grænsefladen veth0
ip route add 239.0.0.1 dev veth0 #opretter en rute, så OS sender trafik til 239.0.0.1 via veth0
Miljøet er klar. Starter trafikanalysatoren:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
hvor "-p 1 -t 1" betyder, at bitrate skal beregnes hvert sekund og information om bitrate outputtes hvert sekund
Starter trafikgeneratoren med en hastighed på 10 Mbit/s:
tsp -I craft
 -P reguler -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
hvor «-p 7 -e» betyder, at der skal pakkes 7 TS-pakker i 1 IP-pakke og gøre det strengt (-e), dvs. altid vente på 7 TS-pakker fra den seneste processor, før IP-pakken sendes.
Analyseren begynder at udskrive de forventede meddelelser:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, TS bitrate: 9.970.016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, TS bitrate: 10.022.656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, TS bitrate: 9.980.544 bits/s
Nu tilføjer vi lidt drops:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPog der dukker meddelelser af denne type op:
* 2020/01/03 14:57:11 - continuity: pakkeblad index: 80.745, PID: 0x0000, mangler 7 pakker
* 2020/01/03 14:57:11 - continuity: pakkeblad index: 83.342, PID: 0x0000, mangler 7 pakker
som er forventeligt. Vi slukker for pakke tab (ip netns exec P iptables -F) og prøver at øge generatorens bitrate til 100 Mbit/s. Analyseren rapporterer en masse CC-fejl og cirka 75 Mbit/s i stedet for 100. Vi forsøger at finde ud af, hvem der er skyld i det — er det generatoren, der ikke kan følge med, eller er problemet ikke i den, for dette kører vi generationen af et fast antal pakker (700000 TS-pakker = 100000 IP-pakker):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Som det ses, blev der genereret præcist 100000 IP-pakker (151925460-151825460). Så lad os finde ud af, hvad der sker med analysator, og for dette sammenligner vi med RX-tælleren på veth1, som er nøjagtigt lig med TX-tælleren på veth0, derefter ser vi, hvad der sker på socketniveau:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Her er antallet af drops = 24355. I TS-pakker er det 170485 eller 24,36% af 700000, således ser vi, at de 25% tabte bitrate er drops i UDP-socket. Drops i UDP-socket opstår normalt på grund af buffer mangel, så lad os se, hvad standard bufferstørrelsen for socket er, og den maksimale bufferstørrelse for socket:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Således, hvis applikationer ikke specifikt anmoder om bufferstørrelsen, oprettes sockets med en bufferstørrelse på 208 Kb, men hvis de beder om mere, får de ikke det ønskede. Da man i tsp for IP-indgange kan angive bufferstørrelsen (—buffer-size), vil vi ikke røre ved standard socket-størrelse, men blot angive den maksimale socket-buffer størrelse og angive bufferstørrelsen eksplicit gennem tsp argumenter:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Med denne justering af socket-bufferen er den rapporterede bitrate nu cirka 100 Mbit/s, der er ingen CC-fejl.
I CPU-forbruget fra selve applikationen tsp. I forhold til en i5-4260U CPU @ 1,40 GHz vil en 10 Mbit/s strøm kræve 3-4% CPU, 100 Mbit/s — 25%, 200 Mbit/s — 46%. Når der angives en % tab af pakker, øges CPU-belastningen næsten ikke (men kan falde).
På mere kraftfuldt hardware kunne der uden problemer genereres og analyseres strømme over 1 Gbit/s.
Testning på virkelige netværkskort
Efter testning på en veth-par skal der tages to værter eller to porte på én vært, og portene skal forbindes. På den ene skal generatoren køre, og på den anden analyseren. Her blev der ikke nogen overraskelser, men i virkeligheden afhænger alt af hardwaren; jo svagere, jo mere interessant bliver det her.
Brug af de indhentede data i overvågningssystemet (Zabbix)
tsp har ikke noget machine-readable API som SNMP eller lignende. CC-beskeder skal aggregeres mindst hver 1 sekund (ved høj procent af pakker der går tabt, kan der være hundrede/tusinder/tusindvis i sekundet, afhængigt af bitrate).
Så for at gemme både information og tegne grafer over CC-fejl og bitrate og lave nogle yderligere hændelser kunne følgende muligheder være:
- Parse og aggregere (efter CC) output fra tsp, dvs. konvertere det til den ønskede form.
- Tilpasse selve tsp og/eller CPU-plugins som bitrate_monitor og continuity, så resultatet gives i machine-readable form, der er egnet til overvågningssystemet.
- Skrive en egen applikation oven på tsduck-biblioteket.
Det er tydeligt, at i forhold til arbejdsindsats er mulighed 1 den enkleste, især når man overvejer, at selve tsduck er skrevet i et lavniveau (i moderne forstand) sprog (C++).
En simpel prototype af parser+aggregator skrevet i bash viste, at ved en strøm på 10 Mbit/s og 50% pakke tab (den værste situation) forbrugte bash-processen 3-4 gange mere CPU end selve tsp-processen. Denne udvikling er uacceptabel. Faktisk er et stykke af denne prototype nedenfor.
Noodle på bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Udover at det fungerer uacceptabelt langsomt, mangler bash normale tråde, bash-jobs er selvstændige processer, og det var nødvendigt at lave en optagelse af værdien missingPackets en gang i sekundet ved en sideeffekt (når der modtages meddelelser om bitrate, som kommer hver sekund). I sidste ende blev bash ladt i fred, og det blev besluttet at skrive en wrapper (parser + aggregator) i golang. CPU-forbruget af tilsvarende kode i golang er 4-5 gange mindre end selve tsp-processen. Accelerationen af wrapperen ved at erstatte bash med golang blev cirka 16 gange, og samlet set er resultatet acceptabelt (CPU-overhead på 25% i værste fald). Den oprindelige fil i golang findes .
Start af wrapperen
For at starte wrapperen er der lavet en meget simpel service-skabelon til systemd (). Det antages, at selve wrapperen er kompileret til en binær fil (go build tsduck-stat.go), placeret i /opt/tsduck-stat/. Det antages, at golang med støtte for monotonic clock (>=1.9) anvendes.
For at oprette en service-instans skal kommandoen systemctl enable tsduck-stat@239.0.0.1:1234 køres, og derefter startes den med systemctl start tsduck-stat@239.0.0.1:1234.
Discovery fra Zabbix
For at Zabbix kan udføre discovery af de kørende tjenester, er der lavet en (discovery.sh) i det format, der er nødvendigt til Zabbix discovery, og det antages, at den ligger der samme sted - i /opt/tsduck-stat. For at køre discovery via zabbix-agenten skal du tilføje til konfigurationsmappen for zabbix-agenten for at tilføje brugerparameteren.
Zabbix-skabelon
(tsduck_stat_template.xml) indeholder en auto-discovery-regel, prototype-elementer til data, grafer og triggere.
Kort tjekliste (hvis nogen skulle beslutte at bruge den)
- Sørg for, at tsp ikke dropper pakker under 'ideelle' forhold (generator og analyzer er direkte tilsluttet); hvis der er drops, se punkt 2 eller teksten i artiklen om dette.
- Optimér den maksimale socket-buffer (net.core.rmem_max=8388608).
- Kompilér tsduck-stat.go (go build tsduck-stat.go).
- Læg service-skabelonen i /lib/systemd/system.
- Start tjenesterne med systemctl, og kontroller, at tællerne begynder at dukke op (grep '' /dev/shm/tsduck-stat/*). Antallet af tjenester svarer til antallet af multicast-strømme. Her kan det være nødvendigt at oprette en rute til multicast-gruppen, muligvis deaktivere rp_filter eller oprette en rute til source ip.
- Kør discovery.sh, og sørg for, at den genererer json.
- Indsæt zabbix-agentens konfiguration, genstart zabbix-agenten.
- Upload a template to Zabbix, apply it to the host being monitored with Zabbix agent installed, wait about 5 minutes, and check for new data items, graphs, and triggers.
Resultat
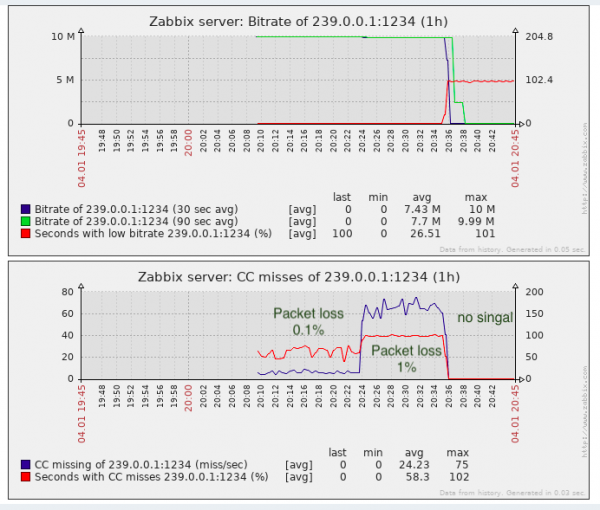
For the task of detecting packet loss, this is almost sufficient; in fact, it's better than having no monitoring at all.
In fact, CC 'losses' can occur when video fragments are stitched together (as far as I know, that's how inserts are made at local TV centers in Russia, i.e., without recalculating the CC counter), and this should be kept in mind. In proprietary solutions, this issue is partially bypassed by detecting SCTE-35 markers (if they are added by the stream generator).
From the perspective of transport quality monitoring, there is a lack of jitter (IAT) monitoring, since TV equipment (be it modulators or end devices) has requirements for this parameter and one cannot always inflate the jitbuffer indefinitely. Jitter can worsen when transit uses equipment with large buffers and QoS for transmitting such real-time traffic is not set up or not set up well enough.
Kilde: habr.com
