

Hello, Habr!
Vi fortsætter med at udforske emnet og , herunder på database-niveau. I dag tilbyder vi at læse om, hvorfor strukturen af databasen, snarere end Java-koden, bør have afgørende betydning, når man designer store applikationer, hvordan dette gøres, og hvilke undtagelser der eksisterer til denne regel.
I denne ret forsinkede artikel vil jeg forklare, hvorfor jeg mener, at data-modellen i en applikation i næsten alle tilfælde skal designes "ud fra databasen", snarere end "ud fra Java’s kapaciteter" (eller et andet klientsprog, du arbejder med). Ved at vælge den anden tilgang træder du ind på en lang vej fyldt med smerte og lidelse, så snart dit projekt begynder at vokse.
Artiklen er skrevet ud fra inspiration fra , stillet på Stack Overflow.
Interessante diskussioner på reddit i sektionerne og .
Kodegenerering
Hvor overrasket blev jeg ikke over, at der er en så lille gruppe brugere, der, efter at have lært jOOQ at kende, er oprørte over det faktum, at når man arbejder med jOOQ, lægges der stor vægt på genereringen af kildekode. Ingen forhindrer dig i at bruge jOOQ, som du ønsker, og ingen tvinger dig til at bruge kodegenerering. Men som standard (som beskrevet i vejledningen) fungerer arbejdet med jOOQ således: du starter med en (arvet) database-skitse, udfører dens reverse engineering ved hjælp af jOOQs kodegenerator for dermed at få et sæt klasser, der repræsenterer dine tabeller, og derefter skriver du typesikre forespørgsler til disse tabeller:
	for (Record2 record : DSL.using(configuration)
//   ^^^^^^^^^^^^^^^^^^^^^^^ Typeoplysningerne er deduceret fra
//   den genererede kode, som der henvises til i den
//   efterfølgende SELECT-betingelse

       .select(ACTOR.FIRST_NAME, ACTOR.LAST_NAME)
//           vvvvv ^^^^^^^^^^^^  ^^^^^^^^^^^^^^^ genererede navne
       .from(ACTOR)
       .orderBy(1, 2)) {
    // ...
}
Koden genereres enten manuelt uden for build-processen, eller manuelt ved hver build. For eksempel kan en sådan regenerering finde sted umiddelbart efter .
Generering af kildekode
Med sådanne tilgange til kodegenerering – både manuelle og automatiserede – er der forskellige filosofier, fordele og ulemper, som jeg ikke vil gå nærmere ind i i denne artikel. Men alt i alt handler genereret kode om, at den gør det muligt at reproducere den 'sandhed', vi accepterer som given, enten inden for vores system eller udenfor. På en måde gør compilere det samme ved at generere bytekode, maskinkode eller en anden form for kode baseret på kildetekster – vi får vores 'sandhed' præsenteret på et andet sprog, uanset de specifikke årsager.
Der findes mange sådanne kodegeneratorer. For eksempel, . Princippet er altid det samme:
- Der eksisterer en vis sandhed (intern eller ekstern) – for eksempel en specifikation, datamodel osv.
- Vi har brug for en lokal repræsentation af denne sandhed på vores programmeringssprog.
Og det er næsten altid fornuftigt at generere sådan en repræsentation – for at undgå overdreven kompleksitet.
Typeudbydere og behandling af annotationer
Til note: en anden, mere moderne og specifik tilgang til kodegenerering for jOOQ vedrører brugen af typeudbydere, . I så fald genereres koden af compileren, faktisk på kompileringstidspunktet. I form af kildetekster eksisterer denne kode grundlæggende ikke. I Java findes der lignende, omend mindre elegante værktøjer – det er annotationsprocessorer, for eksempel, .
I en vis forstand sker der de samme ting her som i det første tilfælde, undtagen for:
- Du ser ikke den genererede kode (måske synes denne situation ikke så frastødende for nogen?)
- Du skal sikre, at typer kan stilles til rådighed, det vil sige, 'sandheden' skal altid være tilgængelig. Det er let i tilfælde af Lombok, der annoterer 'sandheden'. Lidt sværere med databaser, hvis funktion afhænger af et konstant tilgængeligt aktivt forbindelses.
Hvad er problemet med kodegenerering?
Ud over det snedige spørgsmål om, hvordan man bedst starter koden generering – manuelt eller automatisk, må man også nævne, at der er folk, der mener, at koden generering slet ikke er nødvendig. Begrundelsen for dette synspunkt, som jeg oftest har set, er, at det så bliver svært at konfigurere build-pipelinen. Ja, det er faktisk svært. Der opstår ekstra infrastrukturelle omkostninger. Hvis du er ny i arbejdet med et bestemt produkt (uanset om det er jOOQ, JAXB, Hibernate osv.), tager det tid at sætte arbejdsomgivelserne op, som du helst ville bruge på at lære API'et at kende, så du senere kan få værdi ud af det.
Hvis omkostningerne til at forstå generatorens indretning er for store – så har API'et virkelig ikke gjort et godt stykke arbejde med brugervenligheden af kodegeneratoren (og det viser sig senere, at brugerdefineringen i den også er vanskelig). Brugervenlighed bør have højeste prioritet i ethvert sådant API. Men det er kun ét argument imod kodegenerering. Ellers skal man helt klart skrive en lokal repræsentation af indre eller ydre sandheder manuelt.
Mange vil sige, at de ikke har tid til alt det. De har stramme deadlines for deres Super-Produkt. Senere kan vi tage os af build-pipelinerne. Jeg vil svare dem:
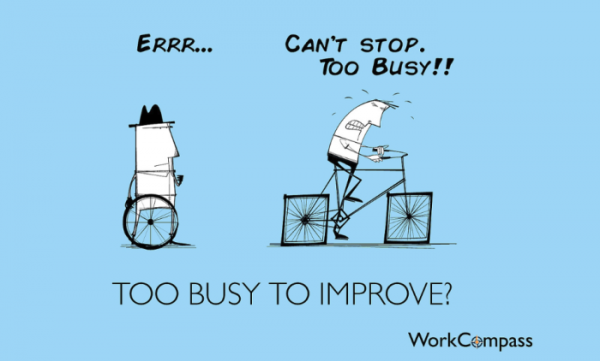
,
Men i Hibernate / JPA er det så let at skrive kode "til Java".
Det er sandt. For Hibernate og dets brugere er det både en velsignelse og en forbandelse. I Hibernate kan man let skrive et par entiteter, sådan her:
	@Entity
class Book {
  @Id
  int id;
  String title;
}
Og næsten alt er klar. Nu er Hibernates opgave – at generere de komplekse "detaljer", hvordan netop denne entitet vil blive defineret i DDL'en af din "dialekt" SQL:
	CREATE TABLE book (
  id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
  title VARCHAR(50),

  CONSTRAINT pk_book PRIMARY KEY (id)
);

CREATE INDEX i_book_title ON book (title);
… og vi begynder at køre applikationen. Det er en virkelig fantastisk mulighed for hurtigt at komme i gang og prøve forskellige ting.
Men vent lidt. Jeg har ikke været helt ærlig.
- Og vil Hibernate faktisk anvende definitionen af denne navngivne primære nøgle?
- Og vil Hibernate skabe en indeks i TITLE? – jeg ved bestemt, vi får brug for det.
- Og vil Hibernate helt sikkert gøre denne nøgle identificerende i Identity Specification?
Næppe. Hvis du udvikler dit projekt fra bunden, er det altid nemt bare at smide den gamle database væk og generere en ny, så snart du har tilføjet de nødvendige annotationer. Sådan vil entiteten Book i sidste ende tage form:
	@Entity
@Table(name = "book", indexes = {
  @Index(name = "i_book_title", columnList = "title")
})
class Book {
  @Id
  @GeneratedValue(strategy = IDENTITY)
  int id;
  String title;
}
Fedt. Generer det på ny. Igen, i så fald vil det være meget nemt i starten.
Men senere vil du skulle betale for det.
Tidspunktet vil komme, hvor du skal gå i produktion. Netop da vil denne model stoppe med at fungere. Fordi:
I produktionen vil du ikke længere kunne smide den gamle database væk og starte fra en ren tavle. Din database vil blive arvet.
Fra nu af og for evigt vil du være nødt til at skrive . Hvad vil der i så fald ske med dine entiteter? Du kan enten tilpasse dem manuelt (og dermed fordoble dit arbejdsvolumen), eller du kan bede Hibernate om at generere dem for dig (hvordan står chancerne for, at det genererede vil leve op til dine forventninger?) Du vil i hvert fald tabe.
Så snart du går i produktion, vil du have brug for hotfixes. Og de skal hurtigt sendes i produktion. Da du ikke har forberedt dig og ikke har organiseret en glat konveyerisering af dine migrationer til produktion, vil du patch'e det hele hæftigt. Og så vil du ikke have tid til at gøre det rigtigt. Og du beskylder Hibernate, eftersom enhver anden er skyld i det, bortset fra dig...
I stedet kunne alt fra starten have været gjort helt anderledes. For eksempel kunne du have sat runde hjul på cyklen.
Først databasen.
Den virkelige 'sandhed' i skemaet for din database og 'suverænitet' over det ligger inde i databasen. Skemaet defineres kun i selve databasen og ingen andre steder, og hver af kunderne har en kopi af dette skema, så det giver fuldstændig mening at håndhæve skemaets overholdelse og integritet direkte i databasen - der hvor informationen opbevares.
Det er en gammel og endda slidt visdom. Primære og unikke nøgler er gode. Udenlandske nøgler er gode. Kontrol af begrænsninger er gode. – er gode.
Og det er ikke alt. For eksempel, når du bruger Oracle, ønsker du sandsynligvis at angive:
- I hvilket tablespace din tabel findes
- Hvad dens PCTFREE-værdi er
- Hvad størrelsen på cachen i din sekvens (efter ID) er
Måske er alt dette ikke vigtigt i små systemer, men du behøver ikke vente på at overgå til området med "big data" — du kan begynde at drage fordel af de dataopbevaringsoptimeringer, som udbyderen tilbyder, meget tidligere, som nævnt ovenfor. Ingen af de ORM'er, jeg har set (herunder jOOQ), giver adgang til det komplette sæt af DDL-muligheder, som du måske vil bruge i din database. ORM'er tilbyder nogle værktøjer, der hjælper med at skrive DDL.
Men i sidste ende er en godt designet skema manuelt skrevet i DDL. Enhver genereret DDL er kun en tilnærmelse af det.
Hvad med klientskemaet?
Som nævnt ovenfor, har du brug for en kopi af skemaet for din database på klienten, en klientvisning. Unødvendigt at nævne, at denne klientvisning skal være synkroniseret med den faktiske model. Hvordan opnår man dette bedst? Ved hjælp af en kodegenerator.
Alle databaser giver deres metainformation via SQL. Her er hvordan du får alle tabeller fra din database på forskellige SQL-dialekter:
	-- H2, HSQLDB, MySQL, PostgreSQL, SQL Server
SELECT table_schema, table_name
FROM information_schema.tables

-- DB2
SELECT tabschema, tabname
FROM syscat.tables

-- Oracle
SELECT owner, table_name
FROM all_tables

-- SQLite
SELECT name
FROM sqlite_master

-- Teradata
SELECT databasename, tablename
FROM dbc.tables
Disse forespørgsler (eller lignende, afhængigt af om visninger, materialiserede visninger eller tabular værdifunktioner også skal tages i betragtning) udføres også ved at kalde fra JDBC, eller ved hjælp af jOOQ's meta-modul.
Ud fra resultaterne af sådanne forespørgsler er det relativt nemt at generere en hvilken som helst klientvisning af din databases model, uanset hvilken teknologi du bruger på klienten.
- Hvis du bruger JDBC eller Spring, kan du oprette et sæt strengkonstanter
- Hvis du bruger JPA, kan du generere selve enhederne
- Hvis du bruger jOOQ, kan du generere jOOQ's meta-model
Afhængigt af hvilke muligheder der tilbydes via dit klient-API (f.eks. jOOQ eller JPA), kan den genererede meta-model være virkelig rig og detaljeret. Lad os tage muligheden for implicitte joins som et eksempel, , som bygger på den genererede metainformation om forholdet mellem de udenlandske nøgler, der gælder mellem dine tabeller.
Nu vil enhver ændring i databasen automatisk føre til en opdatering af klientkoden. Forestil dig for eksempel:
ALTER TABLE book RENAME COLUMN title TO book_title;Vil du virkelig gøre dette arbejde to gange? Overhovedet ikke. Vi registrerer blot DDL, kører det gennem dit build-pipeline og får en opdateret enhed:
@Entity
@Table(name = "book", indexes = {

  // Har du overvejet dette?
  @Index(name = "i_book_title", columnList = "book_title")
})
class Book {
  @Id
  @GeneratedValue(strategy = IDENTITY)
  int id;

  @Column("book_title")
  String bookTitle;
}
Eller den opdaterede jOOQ-klasse. De fleste DDL-ændringer afspejles også i semantikken, ikke kun i syntaksen. Derfor er det ofte nyttigt at se på den kompilerede kode for at finde ud af, hvilken kode der vil (eller kan) blive påvirket af ændringen i din database.
Den eneste sandhed
Uanset hvilken teknologi du bruger, er der altid én model, der er den eneste sandhedskilde for et bestemt subsystem - eller i det mindste bør vi stræbe efter dette og undgå den enterprise-forvirring, hvor "sandheden" er overalt og ingen steder. Det kan være meget simplere. Hvis du blot udveksler XML-filer med et andet system, så brug XSD. Se på INFORMATION_SCHEMA-meta-modellen fra jOOQ i XML-format:
- XSD er let at forstå
- XSD markerer indholdet i XML meget godt og tillader validering på alle klientsprog
- XSD er let at versionere og har god bagudkompatibilitet
- XSD kan oversættes til Java-kode ved hjælp af XJC
Den sidste punkt er vigtigt. Når vi kommunikerer med et eksternt system ved hjælp af XML-beskeder, vil vi være sikre på, at vores beskeder er gyldige. Dette kan nemt opnås ved hjælp af JAXB, XJC og XSD. Det ville være helt vanvittigt at regne med, at når vi designer "Java først", hvor vi laver vores beskeder som Java-objekter, kan de på nogen måde blive klart kortlagt til XML og sendt til konsum i et andet system. XML genereret på denne måde ville være af meget dårlig kvalitet, dårligt dokumenteret og svært at udvikle. Hvis der var en service level agreement (SLA) for et sådant interface, ville vi straks have ødelagt det.
Ærligt talt, det er præcis det, der konstant sker med API'er på JSON, men det er en anden historie, næste gang vil jeg klage…
Databaser: det er det samme
Når man arbejder med databaser, forstår man, at de alle i princippet ligner hinanden. En database ejer sine data og skal styre skemaet. Enhver ændring, der foretages i skemaet, skal implementeres direkte i DDL, så den eneste sandheds kilde opdateres.
Når kildeopdateringen er sket, skal alle klienter også opdatere deres kopi af modellen. Nogle klienter kan være skrevet i Java ved hjælp af jOOQ og Hibernate eller JDBC (eller alle på én gang). Andre klienter kan være skrevet i Perl (god fornøjelse med det), mens tredje kan være i C#. Det er ligegyldigt. Hovedmodellen er i databasen. Modeller genereret med ORM er typisk af dårlig kvalitet, dårligt dokumenteret og svære at udvikle.
Så lad være med at lave fejl. Lav ikke fejl fra starten. Arbejd ud fra databasen. Byg en deploymentspipeline, som kan automatiseres. Inkluder kodegeneratorer, så det er nemt at kopiere modellen fra din database og distribuere den til klienter. Og stop med at bekymre dig om kodegeneratorer. De er gode. Med dem bliver du mere produktiv. Man skal bare bruge lidt tid i starten på at konfigurere dem – og derefter venter mange års øget produktivitet, som vil udgøre historien om dit projekt.
Lad være med at takke nu, senere.
Forklaring
For clarity: This article in no way advocates for bending the entire system (i.e., subject area, business logic, etc.) to fit your database model. In this article, I’m saying that the client-side code interacting with the database should operate based on the database model so that it doesn’t replicate the database model as a ‘first class’ citizen. Such logic usually resides at the data access level on your client.
In two-tier architectures, which still exist in some places, such a system model may be the only possible one. However, in most systems, the data access level seems to me to be a ‘subsystem’, encapsulating the database model.
Undtagelser
There are exceptions to every rule, and I’ve already mentioned that the approach with database primacy and code generation can sometimes be unsuitable. Here are a couple of such exceptions (there are likely more):
- When the schema is unknown and needs to be uncovered. For example, you are a tool provider helping users navigate any schema. Ugh. This is without code generation. But still – the database comes first.
- When the schema must be generated on the fly to solve some task. This example seems a bit like an extravagant version of the , meaning you really don’t have a clearly defined schema. In this case, it’s often even impossible to be sure that a relational database management system (RDBMS) will be suitable for you.
Exceptions are exceptional by nature. In most cases involving the use of an RDBMS, the schema is known in advance, it resides within the RDBMS and is the only source of ‘truth’, while all clients must acquire copies derived from it. Ideally, a code generator should be utilized in this scenario.
Kilde: habr.com
