

Helligdage er forbi, og vi er tilbage med vores andet indlæg i serien om Istio Service Mesh.
Dagens emne er Circuit Breaker, som på dansk betyder 'automatisk afbryder' – også kaldet 'beskyttelsesautomat'. I Istio fungerer denne automat ved ikke at afbryde en kortslutning eller overbelastning, men ved at deaktivere defekte containere.
Hvordan det bør fungere i teorien
Når mikrotjenester styres af Kubernetes, som for eksempel inden for OpenShift-platformen, skaleres de automatisk op og ned afhængigt af belastningen. Da mikrotjenesterne kører i pod'er, kan der være flere instanser af en containeriseret mikrotjeneste på en enkelt end-point, og Kubernetes vil dirigere anmodninger og fordele belastningen imellem dem. Og – ideelt set – bør alt dette fungere glimrende.
Vi husker, at mikrotjenester er små og kortvarige. Den kortvarighed, der her menes, henviser til den enkle opståen og forsvinden, og den undervurderes ofte. Fødslen og døden af en given instans af mikrotjenesten i en pod er noget, man kan forvente; OpenShift og Kubernetes håndterer dette godt, og alt fungerer godt – men igen, det er i teorien.
Hvordan det fungerer i praksis
Forestil dig nu, at en bestemt instans af mikrotjenesten – altså en container – er blevet defekt: enten svarer den ikke (fejl 503), eller – hvad der er mere ubehageligt – reagerer den, men for langsomt. Med andre ord, den kan have problemer eller svarer ikke på anmodninger, men den fjernes automatisk ikke fra puljen. Hvad skal man gøre i dette tilfælde? Gentage forsøget? Fjerne den fra routing-skemaet? Og hvad betyder 'for langsomt' – hvor mange sekunder er det, og hvem bestemmer det? Måske bare give den en pause og prøve igen senere? Hvis ja, hvor længe senere?
Hvad er Pool Ejection i Istio
Og her kommer Istio til undsætning med sine beskyttelsesautomater Circuit Breaker, som midlertidigt fjerner defekte containere fra routing- og belastningsbalanceringsressourcer, hvilket implementerer Pool Ejection-proceduren.
Ved at bruge strategien for afvigelsesdetektering (outlier detection) registrerer Istio de skæve pod'er, der skiller sig ud fra det generelle billede, og fjerner dem fra ressourcerne i en given periode, der kaldes 'søvnvinduet' (sleep window).
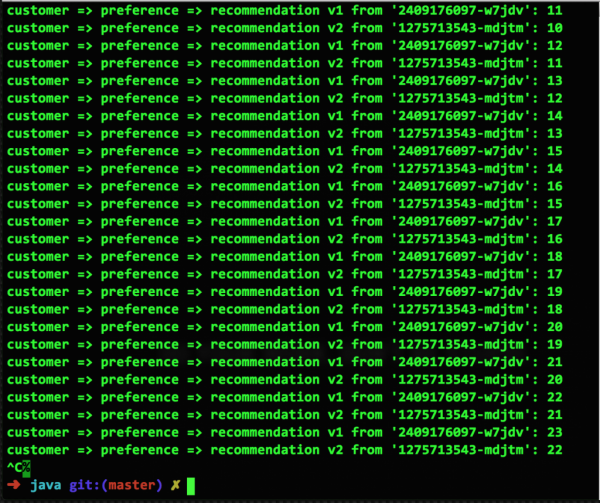
For at vise, hvordan dette fungerer i Kubernetes på OpenShift-platformen, lad os starte med et screenshot af de velfungerende mikroservices fra eksemplet i repositoryet . Her har vi to pods, v1 og v2, hvor hver kører en enkelt container. Når Istio-routingregler ikke bruges, anvender Kubernetes som standard jævnt balanceret cyklisk routing:
Forbereder os på fejl
Før vi udfører Pool Ejection, skal der oprettes en Istio-routingregel. Lad os sige, at vi ønsker at fordele anmodningerne mellem pods i forholdet 50/50. Desuden vil vi øge antallet af v2-containere fra én til to, sådan her:
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Nu opretter vi en routingregel, så trafikken fordeles mellem pods i forholdet 50/50.
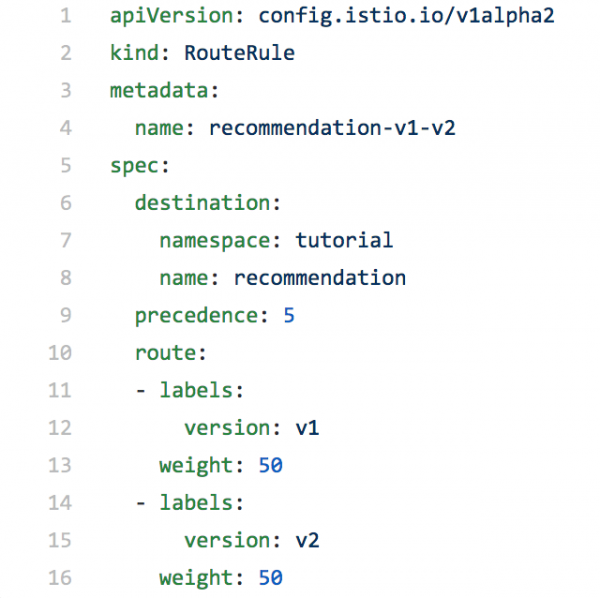
Her er, hvordan resultatet af denne regel ser ud:
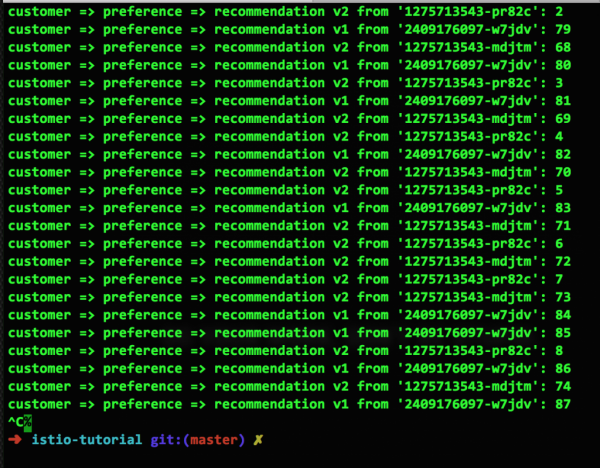
Man kan påpege, at dette screenshot ikke viser 50/50, men 14:9, men situationen vil rette sig over tid.
Forårsager fejl
Lad os nu tage en af de to v2-containere ud af drift, så vi har én fungerende v1-container, én fungerende v2-container og én defekt v2-container:
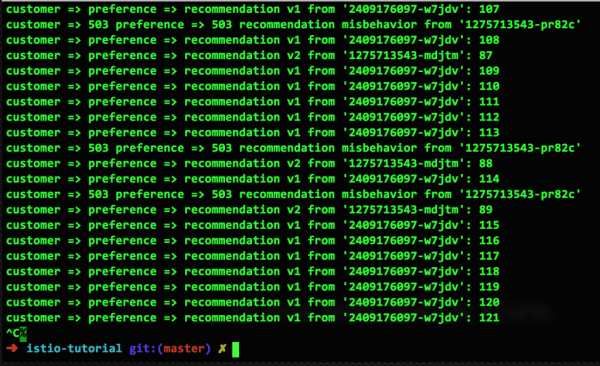
Retter fejlen
Så vi har en defekt container, og det er tid til Pool Ejection. Med en meget enkel konfiguration vil vi udelade denne defekte container fra enhver routing i 15 sekunder i forventning om, at den selv vil vende tilbage til en fungerende tilstand (enten ved at genstarte eller genoprette ydeevnen). Her er, hvordan denne konfiguration ser ud, samt resultaterne af dens anvendelse:
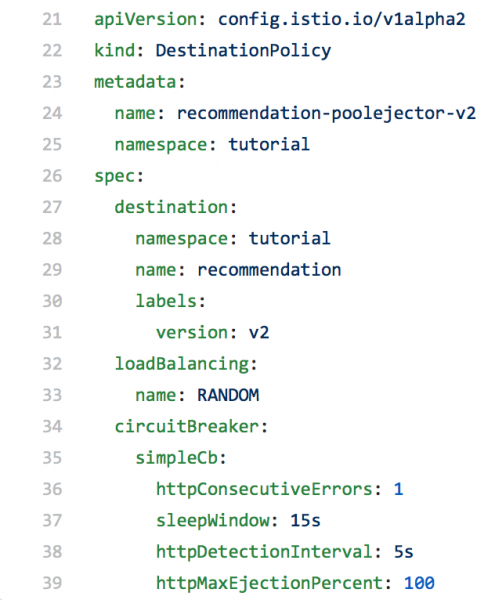
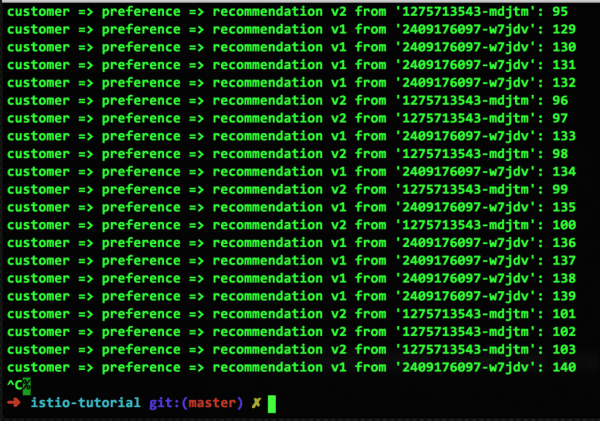
Som det ses, bliver den defekte v2-container ikke længere brugt til routing af anmodninger, da den er blevet fjernet fra puljen. Men efter 15 sekunder vil den automatisk komme tilbage til puljen. Faktisk har vi netop vist, hvordan Pool Ejection fungerer.
Vi begynder at opbygge arkitekturen
Pool Ejection kombineret med Istios overvågningskapaciteter gør det muligt at begynde at etablere en ramme for automatisk udskiftning af defekte containere, for at reducere nedetid og fejl.
NASA har et berømt slogan – Failure Is Not an Option, som tilskrives flight director . På dansk kan det oversættes som «Nederlag er ikke en mulighed», og meningen heri er, at alt kan fås til at fungere, hvis man har tilstrækkelig vilje. Men i det virkelige liv sker der ikke blot fejl; de er uundgåelige, overalt og i alt. Hvordan skal man så håndtere dem i tilfælde af mikrotjenester? Efter vores opfattelse er det bedre at stole på containeres muligheder i stedet for viljestyrke. , , og .
Istio, som vi allerede har nævnt, implementerer et koncept for automatiske afbrydere, der har vist sig effektivt i den fysiske verden. Ligesom en elektrisk afbryder afbryder den problematiske del af kredsløbet, afbryder software Circuit Breaker i Istio forbindelsen mellem anmodningsstrømmen og den problematiske container, når der er noget galt med slutpunktet, for eksempel når serveren er nede eller begynder at hænge.
Og i det andet tilfælde er der endnu flere problemer, da en forsinkelse i én container ikke kun medfører en kaskade af forsinkelser i de tjenester, der henvender sig til den, og derved sænker systemets samlede ydeevne, men også medfører gentagne anmodninger til den allerede langsomt funktionerende tjeneste, hvilket kun forværre situationen.
Circuit Breaker i teorien
Circuit Breaker er en proxy, der kontrollerer anmodningsstrømmen til slutpunktet. Når dette punkt holder op med at fungere, eller – afhængigt af de indstillede parametre – begynder at hænge, afbryder proxyen forbindelsen til containeren. Trafikken omdirigeres derefter til andre containere, blot af hensyn til load balancing. Forbindelsen forbliver åben (open) i en angivet hvileperiode, lad os sige to minutter, og derefter betragtes den som halvåben (half-open). Et forsøg på at sende den næste anmodning afgør den fremtidige tilstand af forbindelsen. Hvis alt er i orden med tjenesten, genoprettes forbindelsen til en aktiv tilstand og bliver igen lukket (closed). Hvis der derimod fortsat er problemer med tjenesten, forbliver forbindelsen afbrudt og hvileperioden genstartes. Her er en forenklet diagram af tilstandsændringerne for Circuit Breaker:
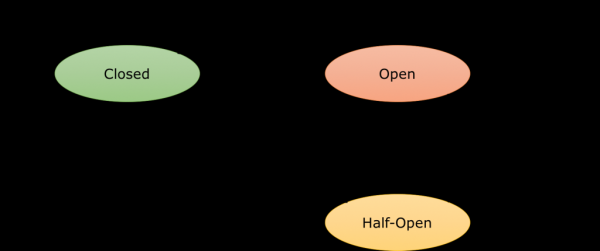
Det er vigtigt at bemærke, at alt dette foregår på et niveau, lad os sige, systemarkitektur niveau. Derfor vil du på et tidspunkt skulle lære dine applikationer at arbejde med Circuit Breaker, for eksempel ved at returnere en standardværdi som svar eller, hvis det er muligt, ignorere eksistensen af tjenesten. Dette kræver brug af bulkhead-mønsteret, men det ligger uden for rammerne af denne artikel.
Circuit Breaker i praksis
Som eksempel vil vi køre to versioner af vores anbefalingsmikroservice på OpenShift. Version 1 vil fungere normalt, mens vi i v2 vil indføre en forsinkelse for at simulere nedbremsninger på serveren. For at se resultaterne bruges værktøjet :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
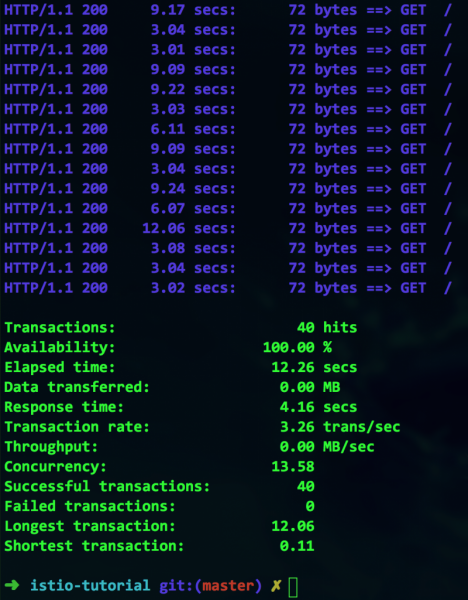
Alt ser ud til at fungere, men til hvilken pris? Ved første øjekast har vi 100 % tilgængelighed, men se nærmere – den maksimale varighed af transaktionen er hele 12 sekunder. Dette er klart et flaskehals, som skal løses.
For dette vil vi med hjælp fra Istio udelukke henvisninger til langsomme containere. Her er hvordan den relevante konfiguration ser ud med brug af Circuit Breaker:
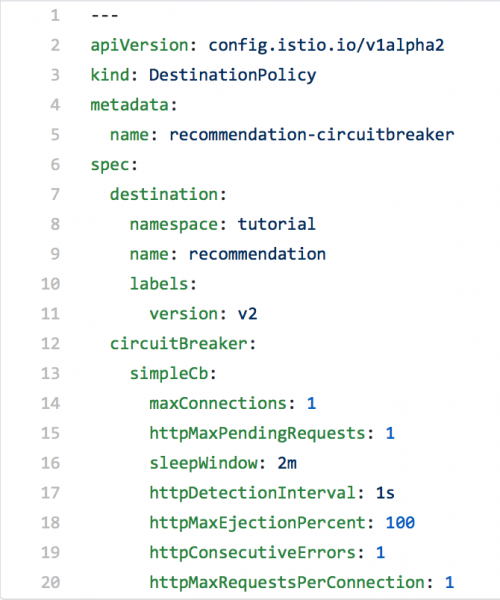
Den sidste linje med parameteren httpMaxRequestsPerConnection signalerer, at forbindelsen skal brydes, når der forsøges at oprette endnu en - anden - forbindelse ud over den allerede eksisterende. Da vores container simulerer en sløvende tjeneste, vil sådanne situationer periodisk opstå, og så vil Istio returnere en fejl 503, mens siege viser:
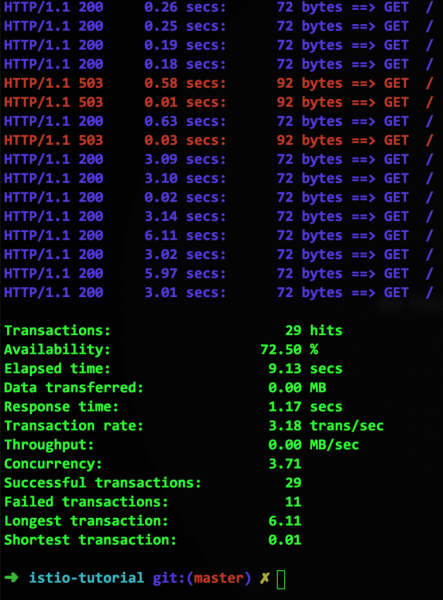
Okay, vi har en Circuit Breaker, hvad nu?
Så vi har implementeret automatisk frakobling uden at røre ved selve servicekoden. Ved at bruge Circuit Breaker og den ovenfor beskrevne procedure Pool Ejection kan vi fjerne de sløvende containere fra ressourcepuljen, indtil de er tilbage til normal, og kontrollere deres tilstand med en given hyppighed - i vores eksempel er det to minutter (parameteren sleepWindow).
Bemærk, at evnen til applikationen til at reagere på fejl 503 stadig defineres i niveauet af dens kildekode. Der findes mange strategier til at arbejde med Circuit Breaker, der anvendes afhængigt af situationen.
I næste indlæg: vil vi fortælle om tracing og overvågning, som allerede er indbygget eller let kan tilføjes til Istio, samt hvordan man med vilje introducerer fejl i systemet.
Kilde: habr.com
