

Fra Google Blogs redaktør: Har du nogensinde spekuleret på, hvordan ingeniører fra Google Cloud Technical Solutions (TSE) håndterer dine supportanmodninger? Ingeniørernes ansvar inden for teknisk support TSE omfatter at opdage og løse de problemer, som brugerne angiver. Nogle af disse problemer er ret simple, men nogle gange opstår der en anmodning, der kræver opmærksomhed fra flere ingeniører. I denne artikel vil en af TSE's medarbejdere fortælle os om et meget komplekst problem fra sin seneste erfaring — . Gennem denne fortælling vil vi se, hvordan ingeniørerne formåede at løse situationen, og hvad de lærte under fejlfindingen. Vi håber, at denne historie ikke kun vil fortælle dig om en dybt rodfæstet fejl, men også give indsigt i de processer, der foregår, når man indgiver en anmodning til Google Cloud support.
Fejlfinding er både en videnskab og en kunst. Det begynder med at bygge en hypotese om årsagen til systemets usædvanlige adfærd, som derefter testes. Men før vi kan formulere en hypotese, skal vi klart definere og præcist formulere problemet. Hvis spørgsmålet lyder for uklart, er du nødt til at analysere det grundigt; det er det, der udgør 'kunsten' i fejlfinding.
Under Google Cloud er sådanne processer meget mere komplicerede, da Google Cloud stræber efter at garantere brugernes fortrolighed. Derfor har TSE's ingeniører hverken adgang til at redigere dine systemer eller mulighed for at se konfigurationerne så omfattende som brugerne. Derfor kan vi (ingeniører) ikke hurtigt ændre systemet for at teste en af vores hypoteser.
Nogle brugere tror, at vi kan løse alt som mekanikere i et værksted, og sender os blot id'et på den virtuelle maskine, mens processen i virkeligheden foregår som en samtale: indsamling af information, dannelse og bekræftelse (eller afkræftelse) af hypoteser, og i sidste ende opbygges løsningen på problemet gennem kommunikation med kunden.
Det betragtede problem
I dag har vi en historie med en god afslutning. En af årsagerne til den vellykkede løsning af den foreslåede sag er en meget detaljeret og præcis beskrivelse af problemet. Nedenfor kan du se en kopi af den første ticket (redigeret for at skjule fortrolige oplysninger):
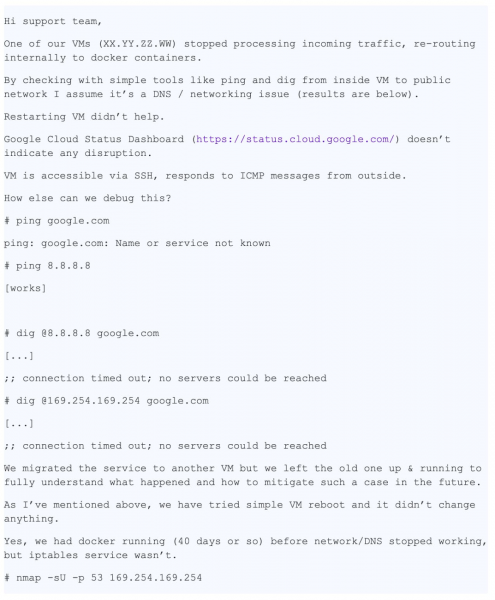
I denne meddelelse er der mange nyttige oplysninger for os:
- En specifik VM er angivet
- Problemet er angivet - DNS fungerer ikke
- Det er angivet, hvor problemet viser sig - VM og container
- Brugerens skridt til at identificere problemet er angivet
Henvendelsen blev registreret som "P1: Kritisk Indvirkning - Tjeneste ubrugelig i produktion", hvilket betyder konstant overvågning af situationen 24/7 i et "Follow the Sun"-schema (du kan læse mere om ), med overførsel fra et teknisk supportteam til et andet ved hver tidszoneændring. I realiteten, på det tidspunkt hvor problemet nåede vores team i Zürich, havde det allerede omgået kloden. På dette tidspunkt havde brugeren truffet foranstaltninger for at mindske konsekvenserne, men frygtede en gentagelse af situationen i produktionen, da den primære årsag stadig ikke var blevet opdaget.
Da ticketen nåede Zürich, havde vi allerede følgende information:
- Indhold.
/etc/hosts - Indhold.
/etc/resolv.conf - Output
iptables-save - Indsamlet af teamet
ngreppcap filen
Med disse data var vi klar til at påbegynde "undersøgelses"- og fejlfindingstrinnet.
Vores første skridt
Først kontrollerede vi loggene og status for metadata-serveren og bekræftede, at den fungerede korrekt. Metadata-serveren svarer til IP-adressen 169.254.169.254 og, udover det, står den for kontrol over domænenavne. Vi dobbelttjekkede også, at firewallen fungerer korrekt med VM og ikke blokerer pakker.
Det var et underligt problem: nmap-checken afviste vores primære hypotese om tab af UDP-pakker, så vi tænkte over flere alternative muligheder og måder at teste dem på:
- Forsvinder pakkerne selektivt? => Tjek iptables-reglerne
- Er det for lille ? => Проверить вывод
ip a show - Berører problemet kun UDP-pakker, eller også TCP? => Kør
dig +tcp - Bliver de genererede dig-pakker returneret? => Kør
tcpdump - Fungerer libdns korrekt? => Kør
stracefor at kontrollere overførslen af pakker i begge retninger
Her beslutter vi at ringe til brugeren for at fejlsøge live.
Under samtalen får vi mulighed for at tjekke flere ting:
- Efter flere kontroller udelukker vi iptables-regler fra listen over årsager
- Vi tjekker netværksgrænseflader og routingtabeller, samt kontrollerer korrektheden af MTU
- Vi opdager at
dig +tcp google.com(TCP) fungerer som det skal, mendig google.com(UDP) virker ikke - Ved at køre
tcpdumpviser sig at fungeredig, opdager vi at UDP-pakkerne bliver sendt tilbage - Vi kører
strace dig google.comog ser hvordan dig korrekt kaldersendmsg()ogrecvmsg(), men den anden afbrydes på grund af timeout
Desværre slutter arbejdsdagen, og vi må overdrage problemet til næste tidszone. Henvendelsen har dog vakt interesse i vores team, og en kollega foreslår at oprette det originale DNS-pakke ved hjælp af Python-modulet scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Dette fragment opretter en DNS-pakke og sender en anmodning til metadata-serveren.
Brugeren kører koden, DNS-svaret returneres, og applikationen modtager det, hvilket bekræfter at der ikke er noget problem på netværksniveau.
Efter endnu en "verden rundt" returnerer anmodningen til vores team, og jeg tager den fuldt ud over, idet jeg antager at brugeren vil finde det lettere, hvis anmodningen stopper med at cirkulere.
I mellemtiden er brugeren venlig nok til at give et snapshot af systemet. Dette er meget gode nyheder: muligheden for selv at teste systemet fremskynder fejlfindingsprocessen betydeligt, da jeg ikke længere skal bede brugeren om at køre kommandoer, sende mig resultaterne og analysere dem, jeg kan gøre det hele selv!
Mine kolleger begynder at misunde mig lidt. Til frokost diskuterer vi anmodningen, men ingen har nogen idé om, hvad der sker. Heldigvis har brugeren allerede taget skridt til at lindre situationen og har ikke travlt, så vi har tid til at dissekere problemet. Og da vi har et billede, kan vi udføre de tests, vi ønsker. Fantastisk!
Tilbage til et skridt før
Et af de mest populære spørgsmål til interviews for stillinger som systemingeniør lyder: "Hvad sker der, når du pinger ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
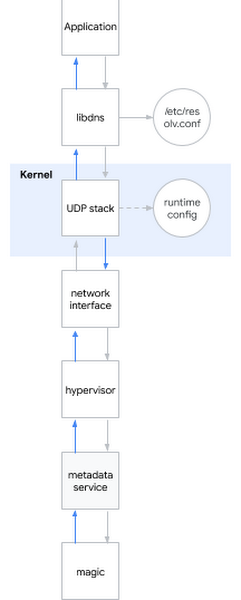
Jeg beslutter at anvende dette H.R.-spørgsmål på den aktuelle problemstilling. Kort sagt, når du forsøger at bestemme DNS-navnet, sker der følgende:
- Applikationen kalder et systembibliotek, som f.eks. libdns
- libdns kontrollerer systemkonfigurationen for, hvilken DNS-server den skal henvende sig til (på diagrammet er det 169.254.169.254, metadata-serveren)
- libdns bruger systemopkald til at oprette en UDP-sokkel (SOCK_DGRAM) og sende UDP-pakker med DNS-forespørgsler tilbage og frem
- Gennem sysctl-interface kan UDP-stakken konfigureres på kernniveau
- Kernen interagerer med hardwaren for at transmittere pakker over netværket via netværksinterfacet
- Hypervisoren fanger og sender pakken til metadata-serveren, når den kontakter den
- Metadata-serveren afgør DNS-navnet gennem sin magi og returnerer svar ved samme metode
Lad mig minde om, hvilke hypoteser vi allerede har haft mulighed for at overveje:
Hypotese: Bibliotekerne er ødelagte
- Test 1: køre strace i systemet, kontrollere at dig kalder de korrekte systemopkald
- Resultat: de korrekte systemopkald kaldes
- Test 2: gennem srapy kontrollere om vi kan bestemme navne uden at bruge systembibliotekerne
- Resultat: vi kan
- Test 3: køre rpm –V på libdns-pakken og md5sum af biblioteksfilerne
- Resultat: bibliotekets kode er helt identisk med koden i det fungerende operativsystem
- Test 4: montere brugerens root-systembillede på en VM uden denne adfærd, køre chroot, se om DNS fungerer
- Resultat: DNS fungerer korrekt
Konklusion baseret på tests: problemet ligger ikke i biblioteket
Hypotese: Der er en fejl i DNS-indstillingerne
- Test 1: kontrollere tcpdump og observere om DNS-pakker sendes og modtages korrekt efter at have kørt dig
- Resultat: pakkerne sendes korrekt
- Test 2: dobbelttjekke på serveren
/etc/nsswitch.confog/etc/resolv.conf - Resultat: alt er korrekt
Konklusion baseret på tests: problemet ligger ikke i DNS-konfigurationen
Hypotese: kernen er beskadiget
- Test: installere en ny kerne, tjekke signaturen, genstarte
- Resultat: lignende adfærd
Konklusion baseret på tests: kernen er ikke beskadiget
Hypotese: forkert opførsel af brugernetværket (eller hypervisors netværksinterface)
- Test 1: kontrollere firewall-indstillingerne
- Resultat: firewallen tillader DNS-pakker både på værten og på GCP
- Test 2: opsnappe trafikken og følge korrektheden af overførsel og tilbagevenden af DNS-forespørgsler
- Resultat: tcpdump bekræfter, at værten modtager de omvendte pakker
Konklusion baseret på tests: problemet ligger ikke i netværket
Hypotese: metadata-serveren fungerer ikke
- Test 1: kontrollere metadata-serverens logs for anomalier
- Resultat: der er ingen anomalier i loggene
- Test 2: omgå metadata serveren via
dig @8.8.8.8 - Resultat: opløsningen fejler selv uden brug af metadata serveren
Konklusion baseret på tests: problemet ligger ikke hos metadata serveren
Konklusion: vi har testet alle delsystemer undtagen runtime konfigurationer!
Dykker ned i indstillingerne for kernens runtime
For at konfigurere kernens runtime kan du bruge kommandolinjeindstillinger (grub) eller sysctl-grænsefladen. Jeg kiggede ind i /etc/sysctl.conf og tro kun, jeg fandt flere tilpassede indstillinger. Følte jeg næsten havde fat i noget, fjernede jeg alle ikke-netværk eller ikke-tcp indstillinger, og efterlod mig med en bunke indstillinger net.core. Så gik jeg til den placering, hvor VM har host-tilladelser, og begyndte at anvende indstillingerne en efter en fra den beskadigede VM, indtil jeg fandt synderen:
net.core.rmem_default = 2147483647Her er den, DNS konfigurationen der ødelægger det! Jeg fandt gerningsvåbnet. Men hvorfor sker det? Jeg havde stadig brug for et motiv.
Konfigurationen af den basale størrelse på DNS pakke-bufferen sker via net.core.rmem_default. En typisk værdi varierer omkring 200KiB, men hvis din server modtager mange DNS pakker, kan du øge bufferstørrelsen. Hvis bufferen er fuld ved modtagelsen af en ny pakke, for eksempel fordi applikationen ikke behandler den hurtigt nok, vil du begynde at miste pakker. Vores klient havde korrekt øget bufferstørrelsen, da de frygtede datatab, fordi de brugte en metrics indsamling applikation via DNS pakker. Den værdi, de indstillede, var den maksimalt mulige: 231-1 (hvis du sætter 231, vil kernen returnere «INVALID ARGUMENT»).
Pludselig indså jeg, hvorfor nmap og scapy virkede korrekt: de brugte rå sockets! Rå sockets adskiller sig fra almindelige: de omgår iptables og de buffes ikke!
Men hvorfor får «for stor buffer» problemer? Det fungerer åbenlyst ikke som tiltænkt.
På dette tidspunkt kunne jeg reproducere problemet på flere kerner og mange distributioner. Problemet blev allerede vist på kernel 3.x og nu også på kernel 5.x.
Faktisk, når jeg kørte
sysctl -w net.core.rmem_default=$((2**31-1))stopper DNS med at fungere.
Jeg begyndte at søge efter fungerende værdier via en simpel algoritme til binær søgning og opdagede, at systemet fungerede med 2147481343, men dette tal var for mig en meningsløs række cifre. Jeg foreslog kunden at prøve dette tal, og han svarede, at systemet fungerede med google.com, men stadig gav en fejl med andre domæner, så jeg fortsatte min efterforskning.
Jeg installerede , et værktøj, jeg burde have brugt tidligere: det viser, hvor i kernen pakken præcist lander. Den skyldige var funktionen udp_queue_rcv_skb. Jeg downloadede kildekoden til kernen og tilføjede et par for at spore, hvor pakken præcist går hen. Jeg opdagede hurtigt den nødvendige betingelse if, og i et stykke tid stirrede jeg bare på den, for det var netop der, alt endelig faldt på plads: 231-1, et meningsløst tal, et ikke-fungerende domæne… Det drejede sig om et stykke kode i __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Bemærk venligst:
rmemer af typen intstørrelseer af typen u16 (unsigned 16-bit int) og gemmer størrelsen på pakkensk->sk_rcybufer af typen int og gemmer størrelsen på bufferen, som per definition er lig med værdien inet.core.rmem_default
Når sk_rcvbuf nærmer sig 231, og summen af pakkens størrelse kan føre til . Og da det er int, bliver værdien negativ, hvilket gør betingelsen sand, når den bør være falsk (mere om dette kan findes i ).
Fejlen rettes på en triviel måde: ved at caste til unsigned int. Jeg anvendte rettelsen og genstartede systemet, hvorefter DNS fungerede igen.
Smagen af sejr
Jeg sendte mine fund til kunden og sendte kernepatchen. Jeg er glad: hvert stykke af puslespillet faldt på plads, jeg kan præcist forklare, hvorfor vi oplevede det, vi oplevede, og vigtigst af alt, vi var i stand til at finde en løsning på problemet takket være vores samarbejde!
Det må indrømmes, at sagen viste sig at være sjælden, og heldigvis modtager vi sjældent så komplekse henvendelser fra brugerne.
Kilde: habr.com
