

Hej alle, mit navn er Sergey Emelyanchik. Jeg er leder af virksomheden Audit-Telecom, hovedudvikler og forfatter til systemet Veliam. Jeg besluttede at skrive en artikel om, hvordan min ven og jeg oprettede et outsourcingfirma, udviklede software til vores behov og derefter begyndte at distribuere det til interesserede gennem en SaaS-model. Om hvordan jeg kategorisk ikke troede, det var muligt. Artiklen vil ikke kun være en fortælling, men også tekniske detaljer om, hvordan produktet Veliam blev skabt. Inklusive nogle stykker kildekode. Jeg vil fortælle om de fejl, vi begik og hvordan vi rettede dem. Jeg havde mine tvivl om, hvorvidt jeg skulle offentliggøre en sådan artikel. Men jeg tænkte, at det ville være bedre at gøre det, få feedback og rette op på det, end ikke at offentliggøre artiklen og undre mig over, hvad der kunne være sket, hvis...
Background
Jeg arbejdede som IT-medarbejder i et stort firma. Virksomheden var ganske stor med en kompleks netværksstruktur. Jeg vil ikke fokusere på mine arbejdsopgaver, kun sige, at udvikling af noget bestemt ikke var en del af dem.
Vi havde overvågning, men af rent akademisk interesse ville jeg gerne prøve at skrive min egen enkle. Ideen var at den skulle være tilgængelig på web, så man nemt kunne tilgå den uden installation af klienter og se, hvad der sker med netværket fra enhver enhed, inklusive mobilenheder via Wi-Fi. Desuden ville jeg gerne hurtigt kunne forstå, hvilket rum udstyret, der var "sygt", befandt sig i, da der var strenge krav til reaktionstiden på sådanne problemer. Til sidst blev der lavet en plan om at skrive en simpel webside, hvor der var et JPEG-baggrundsbillede med netværksdiagrammet, og på dette billede skære selve enhederne ud med deres IP-adresser og vise dynamisk indhold i de nødvendige koordinater i form af grønne eller blinkende røde IP-adresser. Opgaven er sat, lad os begynde.
Tidligere har jeg arbejdet med programmering i Delphi, PHP, JS og meget overfladisk C++. Jeg kender netværk rimeligt godt. VLAN, Routing (OSPF, EIGRP, BGP), NAT. Dette var tilstrækkeligt til at kunne skrive en prototype af en primitiv overvågning selv.
Jeg skrev det, jeg havde planlagt, i PHP. Serveren Apache og PHP kørte på Windows, da Linux på det tidspunkt var noget uforståeligt og meget svært for mig. Som det senere viste sig, tog jeg fejl; mange steder er Linux langt nemmere end Windows. Men det er et andet emne, og vi ved alle, hvor mange diskussioner der er om dette. Windows-opgaveplanlæggeren kørte med et lille interval (jeg kan ikke huske det præcist, men noget i retning af én gang hvert tredje sekund) et PHP-script, der pinge alle objekter og gemte status i en fil.
system("ping -n 3 -w 100 {$ip_address}");
Ja ja, arbejde med databaser var også nyt for mig på det tidspunkt. Jeg vidste ikke, at man kunne køre processer parallelt, og gennemgangen af alle noder i netværket tog lang tid, da dette skete i én tråd. Især opstod der problemer, når flere noder var utilgængelige, da hver af dem forsinkede scriptet med 300 ms. På klientsiden var der en simpel loop-funktion, der hvert par sekunder hentede opdateret information fra serveren via en Ajax-anmodning og opdaterede brugergrænsefladen. Og efter 3 mislykkedes pings i træk, hvis der var åbnet en webside med overvågning på computeren, blev der spillet en glad melodi.
Da alt fungerer, blev jeg meget inspireret af resultaterne og tænkte, at jeg kunne tilføje mere (i kraft af mine kundskaber og muligheder). Men jeg har altid ikke brudt mig om systemer med millioner af grafer, som jeg dengang mente, og stadig mener i dag, i de fleste tilfælde er unødvendige. Jeg ville kun tilføje det, der virkelig kunne hjælpe mig i mit arbejde. Denne princip har indtil i dag været grundlæggende i udviklingen af Veliam. Derefter indså jeg, at det ville være fantastisk, hvis jeg ikke skulle holde monitoreringen åben og være opmærksom på problemerne, men i stedet, når de opstår, kunne åbne siden for at se, hvor den problematiske netværksnode befinder sig, og hvad jeg skulle gøre ved det. Jeg læste på det tidspunkt ikke noget e-mail, da jeg simpelthen ikke brugte det. Jeg stødte på internettet til SMS-gateways, som man kunne sende GET eller POST-anmodninger til, og de ville sende mig en SMS med den tekst, jeg skrev, til min mobiltelefon. Jeg forstod straks, at jeg virkelig ønskede dette. Og jeg begyndte at studere dokumentationen. Efter noget tid lykkedes det, og nu modtog jeg SMS'er om problemer på netværket på min mobil med navnet på den "nedlagte objekt". Selvom systemet var primitivt, var det skrevet af mig selv, og det, der motiverede mig til at udvikle det, var det faktum, at det var et praktisk program, der virkelig hjalp mig i mit arbejde.
Og så kom dagen, hvor en af internetkanalerne faldt på arbejdet, og min monitorering gav mig ikke nogen besked om dette. Google DNS blev stadig pinget fint. Det var tid til at tænke på, hvordan man kan overvåge, om kommunikationskanalen er aktiv. Der var forskellige idéer til, hvordan man kunne gøre det. Jeg havde ikke adgang til alt udstyr. Jeg måtte finde ud af, hvordan jeg kunne forstå, hvilken af kanalerne der var aktiv, men uden at have mulighed for at se dette på det faktiske netværksudstyr. På det tidspunkt foreslog en kollega, at det måske var muligt, at traceroute til offentlige servere kunne variere afhængigt af, hvilken kommunikationskanal der blev brugt til at få adgang til internettet. Jeg tjekkede, og det viste sig at være sandt. Der var forskellige ruter under traceroute.
system(“tracert -d -w 500 8.8.8.8”);
Sådan opstod der endnu et script, eller rettere, en sporingsfunktion blev tilføjet i slutningen af det samme script, der pinger alle enheder i netværket. Det var endnu en lang proces, der blev udført i samme tråd og bremste hele scriptets funktion. Men dengang var det ikke så åbenlyst. Uanset hvad, gjorde det sit arbejde; det var strengt defineret i koden, hvordan hver kanal skulle spores. Sådan blev systemet til, der allerede overvågede (godt sagt, da der ikke blev indsamlet nogen metrikker, blot pings) netværksenheder (routere, switches, wi-fi osv.) og kommunikationskanaler til den ydre verden. SMS-beskeder kom uden problemer, og på diagrammet var det altid let at se, hvor problemet lå.
Derefter, i det daglige arbejde, måtte jeg beskæftige mig med krydsning. Og det blev trættende at skulle logge ind på Cisco-switchene for at finde ud af, hvilken interface der skulle bruges. Tænk hvis jeg kunne klikke på overvågningen og se en liste over dens interfaces med beskrivelser. Det ville spare mig tid. Desuden skulle jeg ikke starte Putty eller SecureCRT, indtaste brugernavne og kommandoer. Jeg kunne bare klikke i overvågningen, se hvad jeg skulle og gå tilbage til mit arbejde. Jeg begyndte at lede efter måder at interagere med switchene på. Jeg fandt hurtigt to muligheder: SNMP eller logge ind på switchen via SSH, indtaste de nødvendige kommandoer og parse resultatet. Jeg opgav SNMP på grund af kompleksiteten i implementeringen; jeg havde ikke tålmodighed til at vente på resultatet. Med SNMP skulle jeg bruge lang tid på at grave i MIB for at danne data om interfaces baseret på disse data. Der er en fantastisk kommando i CISCO.
show interface statusDet viser præcis det, jeg har brug for til krydsreferencer. Hvorfor bøvle med SNMP, når jeg bare vil se resultatet af denne kommando, tænkte jeg. Efter noget tid realiserede jeg denne mulighed. Jeg klikkede på objektet på websiden. Der blev udløst en hændelse, hvor AJAX-klienten henvendte sig til serveren, som så etablerede en SSH-forbindelse til den switch, jeg havde brug for (credentials var hardcoded i koden, jeg havde ikke lyst til at forfine det, lave separate menuer til at ændre legitimationsoplysninger fra grænsefladen, jeg ville bare have resultaterne hurtigt) indsendte den ovennævnte kommando og returnerede det til browseren. Sådan begyndte jeg at få information om interfaces med ét museklik. Det var ekstremt praktisk, især når jeg skulle se denne information på flere switches samtidig.
Overvågning af kanaler baseret på sporingsmetoder viste sig ikke at være den bedste idé, da der undertiden blev udført arbejde på netværket, og sporing kunne ændre sig, hvilket fik overvågningen til at råbe mig op om, at der var problemer med kanalen. Men efter at have brugt en masse tid på analyse, indså jeg, at alle kanaler fungerede, mens min overvågning narrede mig. Til sidst bad jeg kollegaer, der styrede kanal-dannende switches, om blot at sende mig syslog, når synligheden for naboer ændrede sig. Det var meget enklere, hurtigere og mere præcist end tracking. En hændelse som 'neighbor lost' kom, og jeg lavede straks en meddelelse om kanalens nedbrud.
Derefter dukkede der op ordninger for klik på objektet med flere kommandoer, og SNMP blev tilføjet til indsamling af nogle målinger, og på dette punkt var der ikke meget mere. Systemet udviklede sig ikke yderligere. Det gjorde alt, hvad jeg havde brug for, det var et godt værktøj. Mange læsere vil måske sige, at der er masser af software på internettet til at løse disse opgaver. Men i virkeligheden fandt jeg ikke gratis produkter dengang, og jeg ønskede meget at udvikle mine programmeringsfærdigheder, og hvad kan bedre motivere det end en virkelig praktisk opgave. Den første version af overvågningen var derfor færdig og blev ikke modificeret yderligere.
Oprettelse af virksomhed Audit-Telecom
Som tiden gik, begyndte jeg at tage arbejde ved siden af i andre virksomheder, heldigvis tillod arbejdsplanen mig dette. Når man arbejder i forskellige virksomheder, udvikler man hurtigt sine færdigheder inden for forskellige områder, og ens syn på tingene udvider sig. Der er virksomheder, hvor man, som det siges, både er skrædder, høstmand og spiller på blokfløjte. På den ene side er det svært, men på den anden side, hvis man ikke er doven, bliver man en alsidig specialist, og det gør det muligt at løse opgaver hurtigere og mere effektivt, fordi man ved, hvordan beslægtede områder fungerer.
Min ven Pavel (også IT-mand) har konstant forsøgt at motivere mig til at starte egen virksomhed. Der var utallige idéer med forskellige varianter af at starte noget for sig selv. Det blev drøftet i flere år. Og i sidste ende skulle det ikke føre til noget, fordi jeg er skeptisk, mens Pavel er fantasifuld. Hver gang han foreslog en idé, troede jeg aldrig på det og nægtede at deltage. Men vi havde virkelig trang til at åbne vores egen virksomhed.
Endelig lykkedes det os at finde en løsning, der tilfredsstillede os begge, og vi kunne beskæftige os med det, vi kunne. I 2016 besluttede vi at oprette et IT-selskab, der ville hjælpe virksomheder med deres IT-opgaver. Dette inkluderer implementering af IT-systemer (1C, terminalserver, mailserver osv.), deres vedligeholdelse, klassisk HelpDesk for brugere og netværksadministration.
Ærligt talt troede jeg ikke på virksomheden, da den blev grundlagt, omtrent 99,9% af tiden. Men på en eller anden måde fik Pavel mig til at prøve, og for at tage forskud på glæderne, havde han ret. Pavel og jeg investerede hver 300.000 rubler, registrerede det nye selskab "Audit-Telecom", lejde et lille kontor, fik lavet nogle flotte visitkort, ja, som de fleste uerfarne, nystartede iværksættere gjorde, og begyndte at søge kunder. Kundefindingsprocessen er en helt anden historie. Måske vil vi skrive en separat artikel til vores virksomhedsbog, hvis nogen er interesserede. Kolde opkald, flyers, og andet. Dette gav ingen resultater. Som jeg nu læser i mange erhvervshistorier, så afhænger meget på forskellige måder af held. Vi var heldige, og bogstaveligt talt et par uger efter virksomhedens oprettelse, henvendte min bror Vladimir sig til os, som bragte den første kunde til os. Jeg vil ikke udtrætte med detaljerne omkring arbejdet med kunderne, artiklen handler ikke om det, jeg vil blot sige, at vi tog ud til et audit, identificerede kritiske punkter, og disse punkter gik i stykker, mens beslutningen om, hvorvidt vi skulle samarbejde med os på en permanent basis som outsourcere, blev truffet. Herefter blev der straks truffet en positiv beslutning.
Dernæst, primært gennem mund-til-mund blandt bekendte, begyndte der at dukke andre virksomheder op i vores service. Helpdesk var i ét system. Forbindelser til netværksudstyr og servere i et andet, eller rettere sagt, hvordan den enkelte virksomhed gjorde det. Nogle gemte genveje, andre brugte RDP-adresselister. Overvågning var en helt anden system. Det er meget besværligt for teamet at arbejde i adskilte systemer. Vigtig information går tabt. For eksempel, hvis terminalserveren hos kunden bliver utilgængelig, kommer der straks anmodninger fra brugerne hos denne kunde. Supportmedarbejderen opretter en sag (den kom ind via telefon). Hvis hændelser og anmodninger blev registreret i ét system, ville supportmedarbejderen straks kunne se, hvad problemet var for brugeren og meddele dem om dette, samtidig med at de forbindes til den nødvendige enhed for at håndtere situationen. Alle er opdateret omkring den taktiske situation og arbejder koordineret. Vi fandt ikke et system, hvor alt dette var samlet. Det blev klart, at det var tid til at lave vores eget produkt.
Fortsættelse af arbejdet på vores eget overvågningssystem
Det var klart, at det system, der tidligere var skrevet, slet ikke passede til de nuværende opgaver. Hverken hvad angår funktionalitet eller kvalitet. Derfor blev der truffet beslutning om at skrive systemet fra bunden. Grafisk set skulle det allerede se helt anderledes ud. Det skulle være et hierarkisk system, som gjorde det muligt hurtigt og nemt at åbne det nødvendige objekt for den rette kunde. Skemaet fra den første version var i dette tilfælde helt ubegrundet, da kunderne var forskellige, og det slet ikke havde betydning, i hvilke lokaler udstyret stod. Dette var allerede blevet overført til dokumentationen.
Så opgaverne:
- Hierarkisk struktur;
- En eller anden serverdel, som kan placeres hos kunden i form af en virtuel maskine til indsamling af de nødvendige metrikker og sende dem til en central server, som vil opsummere det hele og vise os;
- Alarmer. Sådanne, som ikke må overses, da der på det tidspunkt ikke var mulighed for, at nogen sad og bare kiggede på en skærm;
- System til anmodninger. Der begyndte at komme kunder, hvor vi ikke kun betjente server- og netværksudstyr, men også arbejdsstationer;
- Mulighed for hurtigt at oprette forbindelse til servere og udstyr fra systemet;
Opgaverne er sat, vi går i gang med at skrive. Samtidig behandler vi anmodninger fra kunder. På det tidspunkt var vi allerede 4 personer. Vi begyndte med det samme at skrive begge dele, både den centrale server og serveren til installation hos kunderne. På dette tidspunkt var Linux allerede ikke ukendt for os, og det blev besluttet, at de virtuelle maskiner, der skulle stå hos kunderne, ville være på Debian. Der ville ikke være nogen installatører, vi laver bare projektet til serverdelen på én bestemt virtuel maskine, og derefter kloner vi den simpelthen til den ønskede kunde. Det var en ny fejl. Senere blev det klart, at mekanismen til opdateringer slet ikke var gennemtænkt i sådan et system. D.v.s. vi tilføjede en ny funktion, men derefter var der et helt problem med at sprede den til alle kundernes servere, men vi vender tilbage til dette senere, alt i rækkefølge.
Vi lavede den første prototype. Den kunne pinge de netværksenheder, vi havde brug for hos kunderne, og serverne og sende disse data til vores centrale server. Og denne opdaterede disse data i den samlede masse på den centrale server. Her vil jeg ikke kun skrive historien om, hvad der lykkedes, men også hvilke amatørfejl der blev begået, og hvordan man måtte betale med tid bagefter. Hele træet af objekter blev gemt i en enkelt fil som et serialiseret objekt. Indtil vi tilsluttede et par kunder til systemet, var alt mere eller mindre normalt, selvom der nogle gange opstod artefakter, der var helt uforståelige. Men da vi tilsluttede et dusin servere til systemet, begyndte der at ske mirakler. Nogle gange forsvandt alle objekter i systemet uden nogen åbenlys grund. Det er vigtigt at bemærke, at serverne, som kunderne havde, sendte data til den centrale server hver few sekunder via en POST-anmodning. Den opmærksomme læser og erfarne programmør har sikkert allerede gættet, at der opstod et problem med multiple adgang til den samme fil, hvor det serialiserede objekt blev gemt fra forskellige tråde samtidig. Og lige når dette skete, opstod der mirakler med forsvinden af objekter. Filen blev rett og slett tom. Men det hele blev ikke opdaget med det samme, men først under driften med flere servere. I løbet af den tid blev der tilføjet funktionalitet til scanning af porte (serverne sendte ikke kun oplysninger til den centrale om tilgængeligheden af enheder, men også om åbne porte på dem). Dette blev gjort ved at kalde kommandoen:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
resultaterne var ofte forkerte, og scanningen tog meget lang tid. Jeg glemte helt pingen, som blev udført via fping:
system("fping -r 3 -t 100 {$this->ip}");
Dette var også ikke paralleliseret, og derfor var processen meget lang. Senere blev hele listen over IP-adresser, der var nødvendige til kontrol, sendt til fping, og vi fik tilbage en færdig liste over dem, der svarede. I modsætning til os kunne fping parallelisere processerne.
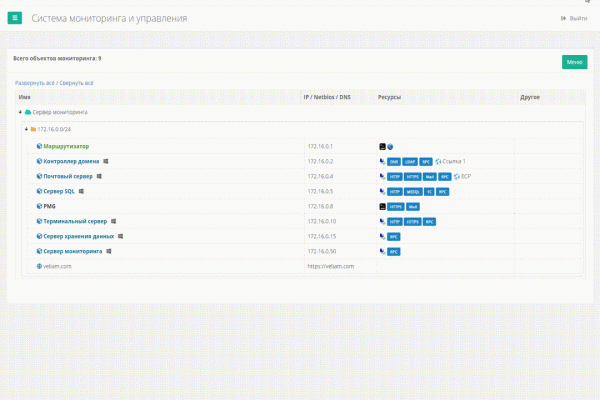
En anden almindelig rutineopgave var opsætningen af tjenesteydelser gennem WEB. For eksempel ECP fra MS Exchange. I realiteten er det kun et link. Vi besluttede, at vi skulle have mulighed for at tilføje sådanne links direkte i systemet, så vi ikke skulle lede i dokumentationen eller andre steder i bogmærkerne for at få adgang til ECP for en specifik kunde. Dette førte til introduktionen af ressourcelinks i systemet, som stadig er tilgængelige og har næsten ikke ændret sig.
Funktionaliteten af ressourcelinks i Veliam
Fjernforbindelser
Sådan ser det ud i praksis i den nuværende version af Veliam
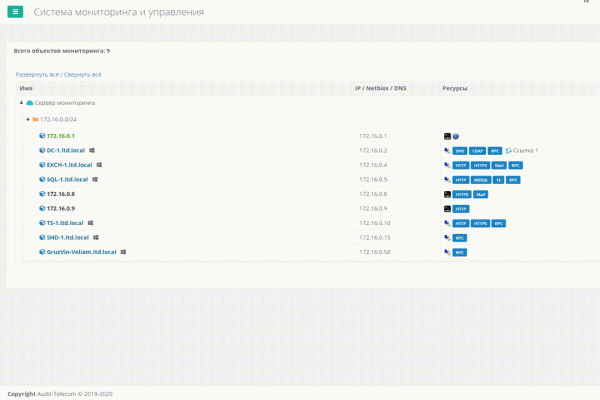
En af opgaverne var hurtigt og bekvemt at oprette forbindelse til servere, af hvilke der allerede var mange (mere end hundrede), og det var ekstremt uhensigtsmæssigt at gennemgå millioner af forudindstillede RDP-genveje. Der var behov for et værktøj. Der findes software på internettet, som fungerer som en adressebog til sådanne RDP-forbindelser, men de er ikke integreret med overvågningssystemet, og konti kan ikke gemmes. Hver gang man skal indtaste konti til forskellige kunder er en ren mareridt, når man på en dag opretter forbindelse til mange forskellige servere. Med SSH er det lidt bedre, da der findes god software, hvor man kan organisere sådanne forbindelser i mapper og gemme konti til dem. Men der er to problemer. For det første fandt vi ikke et program til RDP- og SSH-forbindelser. For det andet, hvis jeg på et tidspunkt ikke er ved min computer og skal hurtigt oprette forbindelse, eller hvis jeg lige har geninstalleret systemet, skal jeg lede i dokumentationen for at finde kundens konto. Det er uhensigtsmæssigt og spild af tid.
Vi havde allerede den nødvendige hierarkiske struktur for kundernes servere i vores interne produkt. Det eneste, der skulle gøres, var at finde ud af, hvordan vi kunne knytte hurtige forbindelser til det nødvendige udstyr, i det mindste inden for vores eget netværk.
Da browseren, der fungerede som klient i vores system, ikke havde adgang til lokale ressourcer på computeren for blot at starte den nødvendige applikation med en kommandolinje, blev det besluttet at implementere det hele gennem "Windows custom url scheme". Således opstod der en slags "plugin" til vores system, som blot integrerede Putty og Remote Desktop Plus og registrerede URI-schemata i Windows under installationen. Nu, når vi ville oprette forbindelse til et objekt via RDP eller SSH, kunne vi klikke på den handling i vores system, og Custom URI ville træde i kraft. Det standardiserede mstsc.exe, der er indbygget i Windows, eller putty, som kom med "pluginet", blev startet. Jeg sætter ordet plugin i citationstegn, fordi det ikke er et plugin til browseren i traditionel forstand.
Det var i det mindste noget. En praktisk adressebog. I tilfældet med Putty var alt helt fint, da man kunne angive både IP-adressen og login og adgangskode som inputparametre. Dvs. vi kunne allerede oprette forbindelse til Linux-servere i vores netværk med et enkelt klik uden at skulle indtaste adgangskoder. Men med RDP er det ikke så enkelt. I standard mstsc kan man ikke angive legitimationsoplysninger som parametre. Her kom Remote Desktop Plus til hjælp. Det gjorde det muligt. Nu klarer vi os uden det, men i lang tid var det en trofast hjælper i vores system. Med HTTP(S) websteder var det enkelt; sådanne objekter åbnede blot i browseren, og så var det det. Praktisk og effektivt. Men det var kun lykken inden for det interne netværk.
Da vi løste de fleste problemer eksternt fra kontoret, var det mest enkle at etablere VPN-forbindelser til kunderne. Så kunne vi oprette forbindelse til dem fra vores system. Men det var stadig lidt besværligt. For hver kunde skulle vi have en bunke gemte forbindelser på hver computer. VPN Og før vi oprettede forbindelse til en hvilken som helst, skulle den tilsvarende VPN aktiveres. Vi brugte denne løsning i en længere periode. Men antallet af kunder voksede, antallet af VPN-forbindelser voksede også, og det begyndte at blive belastende, og vi måtte finde en løsning. Især græd man over situationen efter systemgeninstallation, hvor man skulle indtaste dusinvis af VPN-forbindelser på en ny Windows-profil. Nok er nok, sagde jeg, og jeg begyndte at tænke på, hvad vi kunne gøre ved det.
Det er blevet sådan, at alle kunder har enheder fra det velkendte firma Mikrotik som routere. De er meget funktionelle og praktiske til næsten enhver opgave. Ulempen er, at de bliver "stjålet". Vi løste dette problem enkelt ved at lukke alle ekstern adgang. Men vi havde brug for at få adgang til dem uden at skulle besøge kunden, da det tager lang tid. Vi oprettede blot tunneller til hver Mikrotik og adskilte dem i en separat pulje, uden nogen routing, så vi ikke ville blande vores netværk med kundernes netværk og deres netværk indbyrdes.
Ideen opstod om, at når jeg trykkede på det ønskede objekt i systemet, skulle centralmonitoreringsserveren, som kendte SSH-legitimationsoplysningerne for alle kundernes Mikrotik-enheder, forbinde til den rigtige, oprette en port forwarding til den ønskede vært med den ønskede port. Her er der flere punkter. Løsningen er ikke universel - det vil kun fungere for Mikrotik, da syntaksen for kommandoer er forskellig for alle routere. Desuden skulle sådanne port forwardings slettes på en eller anden måde, og vores serversystem kunne i princippet ikke overvåge, om jeg var færdig med min RDP-session. Og sådan en forwarding er en sikkerhedssvaghed for kunden. Vi jagtede ikke efter universaldannelse, da produktet kun blev brugt internt i vores virksomhed, og vi havde ikke engang overvejet at gøre det offentligt.
Hver af problemerne blev løst på sin egen måde. Når en regel blev oprettet, var forwardingen kun tilgængelig for én specifik ekstern IP-adresse (den, der initierede forbindelsen). Så sikkerhedshullerne blev undgået. Men med hver sådan forbindelse blev der tilføjet en regel på Mikrotik til NAT-siden, og den blev ikke ryddet op. Det er velkendt, at jo flere regler der er, desto mere belastning på routerens processor. Og generelt kunne jeg ikke acceptere, at jeg en dag ville logge ind på en Mikrotik, og der ville være hundrede døde og unødvendige regler.
Da vores server ikke kan overvåge forbindelsestilstanden, lad MikroTik håndtere det selv. Jeg skrev et script, som konstant holdt øje med alle portforwarding-regler med en bestemt beskrivelse (description) og kontrollerede, om der var en TCP-forbindelse til den relevante regel. Hvis der ikke havde været nogen forbindelse i et stykke tid, var det sandsynligvis afsluttet, og portforwardingen kunne fjernes. Det hele fungerede, scriptet arbejdede godt.
Forresten, her er det:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Fjerner nat-regler tilføjet automatisk af atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Det kunne helt sikkert have været lavet pænere, hurtigere osv., men det fungerede, belastede ikke MikroTik'en, og klarede opgaven fremragende. Vi kunne endelig tilslutte os servere og klientens netværksudstyr med blot ét musetryk. Uden at skulle starte VPN eller indtaste adgangskoder. Systemet er blevet utrolig let at arbejde med. Tiden til vedligeholdelse blev reduceret, og vi har alle kunnet fokusere mere på arbejdet i stedet for at forene os med de nødvendige objekter.
Mikrotik Backup
Vi havde konfigureret backup af alle MikroTik'en på FTP, og generelt fungerede det godt. Men når vi havde brug for at hente en backup, var vi nødt til at åbne FTP'en og lede efter det. Vi havde systemet, hvor alle routerne var registreret, og vi vidste, hvordan vi skulle kommunikere med enhederne via SSH. Så hvorfor ikke lave et system, der automatisk skulle hente backups fra alle MikroTik'er hver dag, tænkte jeg. Og jeg begyndte at implementere det. Vi tilsluttede, lavede en backup og hentede den til lageret.
PHP scriptkode for at tage backup fra MikroTik:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Ventet på backup

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup fil
    $size = filesize("ssh2.sftp:\/$sftp\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/$sftp\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . ‘.backup’,$contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC fil
    $size = filesize("ssh2.sftp:\/$sftp\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/$sftp\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
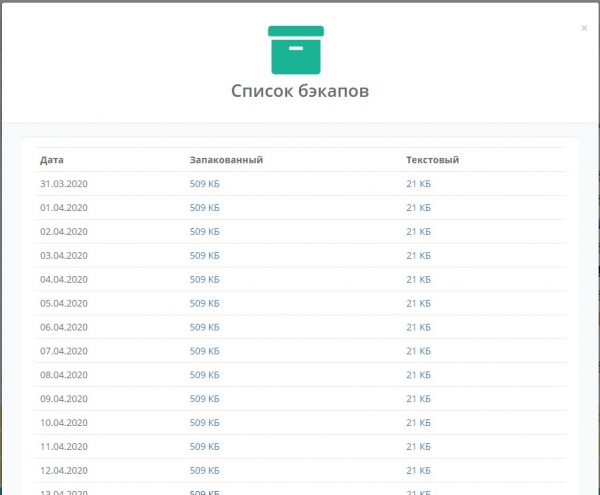
Backup gemmes i to former — binær og tekstkonfiguration. Binærfiler gør det hurtigt at gendanne den nødvendige konfiguration, mens tekstfiler giver en forståelse af, hvad der skal gøres, hvis der sker en tvungen udskiftning af hardware, og binærfilen ikke kan overføres. Vi har dermed fået endnu en praktisk funktionalitet i systemet. Når der tilføjes nye MikroTik-enheder, er der slet ikke brug for konfiguration, man tilføjer blot objektet i systemet og opretter en SSH-konto. Derefter klarer systemet automatisk backupoptagelsen. Denne funktionalitet er i øjeblikket ikke tilgængelig i den nuværende version af SaaS Veliam, men vi vil snart implementere den.
Screenshots af hvordan det så ud i det interne system
Overgang til normal opbevaring i databasen
Tidligere har jeg skrevet om de artefakter, der dukkede op. Nogle gange forsvandt hele listen over objekter i systemet, og nogle gange blev informationen ikke gemt, når jeg redigerede et objekt, hvilket betød, at jeg måtte omdøbe objektet tre gange. Det irriterede alle. Forsvindingen af objekter skete sjældent og kunne nemt genoprettes ved at gendanne den pågældende fil, men fejlen ved redigering af objekter skete ofte. Sandsynligvis gjorde jeg det ikke gennem databasen fra starten, fordi jeg ikke kunne forestille mig, hvordan man kunne holde et hierarkisk træ med alle relationer i en flad tabel. Den er flad, mens et træ er hierarkisk. Men en god løsning til samtidige adgangsproblemer og senere (ved kompleksitet i systemet) også transaktionelle problemer — det er en databasesystem. Jeg er helt sikkert ikke den første, der har mødt dette problem. Jeg begyndte at google. Det viste sig, at alt var allerede opfundet før mig, og der er flere algoritmer, der kan konstruere træet fra en flad tabel. Efter at have set på hver enkelt, implementerede jeg en af dem. Men det var en ny version af systemet, da det i bund og grund betød, at jeg måtte omskrive en del. Resultatet var naturligt; problemerne med systemets tilfældige adfærd forsvandt. Nogen vil måske sige, at fejlene er meget amatøragtige (enkelttrådede scripts, opbevaring af information, som havde mange samtidige adgangspunkter fra forskellige tråde i en fil osv.) inden for softwareudvikling. Måske er det sandt, men mit hovedfokus var administration, mens programmering var en hobby for sjælen, og jeg havde simpelthen ikke erfaring med at arbejde i et team af programmører, hvor sådanne elementære ting kunne have været påpeget af mere erfarne kolleger. Derfor fik jeg selv alle disse bumps, men jeg har lært materialet meget godt. Og derudover er mit arbejde også møder med kunder, handlinger rettet mod at forsøge at promovere firmaet, og en masse administrative spørgsmål internt i virksomheden og meget, meget mere. Men på den ene eller anden måde, det der eksisterede, var efterspurgt. Drenge og jeg selv brugte produktet i vores daglige arbejde. Der var også åbenlyst mislykkede ideer og løsninger, som der ikke blev brugt tid på, og som i sidste ende viste sig at være ikke-funktionelle værktøjer, ingen brugte, og som ikke kom ind i Veliam.
Support - HelpDesk
Det vil ikke skade at nævne, hvordan HelpDesk blev udviklet. Det er i virkeligheden en helt anden historie, da det i Veliam er den 3. helt nye version, som adskiller sig fra alle de tidligere. I øjeblikket er det et simpelt system, intuitivt og uden unødvendige finter og krummelurer, med mulighed for integration med domænet, samt muligheden for at få adgang til samme brugerprofil fra hvor som helst via et link i en email. Og det vigtigste af det hele er, at man fra enhver lokation (hjemme eller på kontoret) kan oprette forbindelse til anmelderen via VNC direkte fra anmeldelsen uden VPN eller port forwarding. Jeg vil fortælle, hvordan vi kom dertil, hvad der var før, og hvilke frygtelige løsninger vi havde.
Vi oprettede forbindelse til brugerne via det velkendte TeamViewer. På alle computerne, hos de brugere vi betjener, er TVA installeret. Det første, vi gjorde forkert og senere fjernede, var at knytte hver klients HWID til hardware. Hvordan logger brugeren ind i HW-systemet for at anmode om hjælp? Udover TVA var der installeret et specialprogram skrevet i Lazarus. (Mange vil rulle med øjnene, og måske endda søge efter, hvad det er, men det bedste kompilérbare sprog, jeg kender, er Delphi, og Lazarus er næsten det samme, bare gratis). Generelt starter brugeren en særlig batchfil, der kører dette program; det læser HWID'et på systemet, og derefter åbnes browseren, og login-processen finder sted. Hvorfor blev dette gjort? I nogle virksomheder tælles de betjente brugere enkeltvis, og prisen for service hver måned beregnes ud fra antallet af personer. Det er forståeligt, siger du, men hvorfor knytte det til hardware? Det er meget simpelt, nogle personer kom hjem og lavede en anmodning fra deres bærbare computer med ordlyden "gør det hele flot her." Udover at læse systemets HWID, trak programmet også den nuværende TeamViewer ID fra registreringsdatabasen og sendte det til os. TeamViewer har et API til integration. Og vi lavede denne integration. Men der var et problem. Gennem disse API’er kan man ikke oprette forbindelse til brugerens computer, medmindre de klart initierer denne session, og efter at have forsøgt at oprette forbindelse til dem, skal de også trykke "godkend". På det tidspunkt syntes det logisk for os, at uden brugerens samtykke skulle ingen oprette forbindelse, og da personen er ved computeren, bør de også initiere sessionen og positivt svare på anmodningen om fjernforbindelse. Alt viste sig dog ikke at være så enkelt. Ansøgerne glemte at initiere sessionen, og det måtte vi fortælle dem i telefonen. Det tog tid og nervepirrede begge parter i processen. Desuden er det ikke sjældent, at en person efterlader en anmodning, men kun giver tilladelse til at oprette forbindelse, når de går på frokost. Fordi problemet ikke er kritisk, ønsker de ikke at forstyrre deres arbejdsproces. Derudover trykker de ikke på nogen knapper for at give tilladelse til at oprette forbindelse. Så vi fik også en ekstra funktion ved godkendelse i HelpDesk - læsning af TeamViewer ID. Vi kendte den faste adgangskode, der blev brugt ved installationen af TeamViewer. Bedre sagt, kun systemet kendte den, da den var indbygget i installationsprogrammet og i vores system. Derfor var der en knap til forbindelse fra anmodningen, som, når der blev trykket på den, åbnede TeamViewer uden ventetid, og forbindelsen blev etableret. I sidste ende var der to mulige måder at oprette forbindelse på. Gennem TeamViewer's officielle API og vores hjemmelavede løsning. Til min overraskelse stoppede de næsten straks med at bruge den første, selvom det blev angivet, at den kun skulle bruges i særlige tilfælde og når brugeren selv giver tilladelse. Sikkerhed er nu det vigtigste. Men det viste sig, at ansøgerne ikke havde brug for det. De havde absolut intet imod, at man oprettede forbindelse til dem uden bekræftelsesknappen. Og derfor blev funktionen til at oprette forbindelse via API'en tidligt afskaffet, da den ikke længere var nødvendig.
Overgang til multithreading i Linux
Spørgsmålet om at fremskynde netværksscanneren for at tjekke et forudbestemt portliste og simpel ping af netværksobjekter har længe været aktuelt. Det første, der kommer i tankerne, er multithreading. Da hovedparten af tiden, der bruges på ping, er ventetid på at modtage pakken, og den næste ping ikke kan begynde, før den tidligere pakke er vendt tilbage, kan det blive ret langsomt i virksomheder med mere end 20 servere plus netværksudstyr. Problematikken er, at én pakke kan gå tabt, og det er ikke altid muligt at informere systemadministratoren straks. Han vil hurtigt stoppe med at reagere på sådanne spammeddelelser. Det betyder, at man skal ping hver objekt flere gange, før man drager konklusioner om utilgængelighed. Uden at gå alt for meget i detaljer, er det nødvendigt at parallelisere, fordi hvis ikke, vil systemadministratoren sandsynligvis høre om problemet fra kunden snarere end fra overvågningssystemet.
PHP understøtter ikke multithreading ud af boksen. Det understøtter multiprosessering, hvor man kan forgrene. Men jeg havde allerede udviklet et spørgemekanisme og ville gerne læse alle de nødvendige noder fra databasen én gang, pinge dem alle samtidigt, vente på svar fra hver og derefter straks skrive dataene. Det sparer på antallet af læseforespørgsler. Denne idé passede perfekt til multithreading. Der findes en PThreads-modul til PHP, der muliggør ægte multithreading, men det krævede en del arbejde at få det til at fungere på PHP 7.2, men det blev gjort. Portscanning og ping blev hurtigere. Tidligere tog det eksempelvis 15 sekunder pr. runde, nu tager det 2 sekunder til denne proces. Det var et fremragende resultat.
Hurtig revision af nye virksomheder
Hvordan blev funktionen til indsamling af forskellige metrikker og hardwarekarakteristika til? Det er simpelt. Vi modtager nogle gange bestillinger på en audit af den nuværende IT-infrastruktur. Og det samme er nødvendigt for at fremskynde auditprocessen for en ny kunde. Vi havde brug for noget, der hurtigt kunne give os et overblik over, hvad en mellemstor eller stor virksomhed har. Ping i det interne netværk blokeres, efter min mening, kun af dem, der ønsker at gøre deres liv sværere, og efter vores erfaring er der ikke mange af dem. Men de findes. Derfor kan vi hurtigt scanne netværket for tilstedeværelse af enheder med en simpel ping. Derefter kan de tilføjes og scannes for åbne porte, som vi er interesserede i. Faktisk var denne funktionalitet allerede til stede; det var kun nødvendigt at tilføje en kommando fra den centrale server til den underordnede, så den kunne scanne de angivne netværk og tilføje alt, den finder, til listen. Jeg glemte at nævne, at vi antog, at vi allerede havde et klart billede af det konfigurerede system (den underordnede overvågningsserver), som vi kunne rulle ud til kunden under audit og tilslutte det til vores cloud.
Men resultatet af auditeten inkluderer normalt en masse forskellig information, og en af dem er, hvilken slags enheder der overhovedet er i netværket. Først og fremmest var vi interesserede i Windows-servere og Windows-arbejdsstationer, der er en del af domænet. I mellemstore og store virksomheder er manglen på et domæne sandsynligvis en undtagelse fra reglen. For at tale et fælles sprog, i min optik er en gennemsnitlig virksomhed omkring 100+ personer. Vi måtte finde en måde at indsamle data fra alle Windows-maskiner og servere ved at kende deres IP-adresser og en domæneadministrators brugerkonto, men uden at installere nogen software på hver enkelt af dem. Hjælp kom fra WMI-grænsefladen. Windows Management Instrumentation (WMI) er, oversat direkte, windows administrationsværktøjer. WMI er en af de grundlæggende teknologier til centraliseret administration og overvågning af forskellige dele af computerinfrastruktur styret af Windows-platformen. Taget fra wiki. Derefter måtte jeg igen arbejdes med for at samle wmic (det er WMI-klienten) til Debian. Efter alt var klargjort, var det blot at forespørge de nødvendige noder om den ønskede information via wmic. Gennem WMI kan man næsten hente enhver information fra en Windows-computer, og desuden kan man også styre computeren, f.eks. ved at sende den til genstart. Således blev indsamlingen af information om Windows-stationer og servere en del af vores system. Derudover fik vi også aktuel information om systemets belastningsniveau. Vi anmoder om den information oftere, mens informationerne om hardware er sjældnere. Efter dette blev det lidt mere behageligt at udføre audtten.
Beslutning om distribution af software
Vi bruger selv systemet dagligt, og det er altid åbent for hver teknisk medarbejder. Og vi tænkte, at vi også kunne dele det, vi allerede har, med andre. Systemet var dog slet ikke klar til at blive distribueret. Det var nødvendigt at omarbejde meget, så den lokale version kunne blive til SaaS. Dette omfattede ændringer af forskellige tekniske aspekter i systemets funktion (fjernforbindelser, kundesupport), analyse af moduler med henblik på licensering, shardings af kundedata, skalering af hver service og udvikling af automatisk opdateringssystemer for alle dele. Men det vil blive dækket i artikelens anden del.
Opdater
Kilde: habr.com
