

Hej alle sammen. Det er Владислав Родин her. I øjeblikket er jeg leder af kurset "Arkitekt for højtydende systemer" hos OTUS, samt underviser i kurser, der omhandler softwarearkitektur.
Udover undervisningen, som I måske har bemærket, skriver jeg originalt indhold til OTUS-bloggen på Habr, og dagens artikel vil jeg dedikere til lanceringen af kurset , som i øjeblikket er åbent for tilmelding.
Introduktion
I Vi har talt om, at transaktioner i databaser tjener til at løse to opgaver: at sikre fejlmodstand og at give adgang til data i en konkurrencepræget miljø. For at disse opgaver kan udføres korrekt, skal en transaktion have ACID-egenskaber. I dag vil vi tale grundigt om bogstavet I (isolation) i denne forkortelse.
Isolation
Isolering løser problemet med dataadgang i et konkurrencepræget miljø ved faktisk at give beskyttelse mod race conditions. Ideelt set betyder isolering serialisering, hvilket er en egenskab, der sikrer, at resultatet af udførelsen af transaktioner parallelt er det samme som, hvis de blev udført sekventielt. Hovedproblemet med denne egenskab er, at den er meget vanskelig at sikre teknisk, og det rammer derfor systemets ydeevne hårdt. Derfor svækkes isoleringen ofte, idet man tager risici for visse anomalier, som vi vil tale om herunder. Muligheden for, at forskellige anomalier kan opstå, karakteriserer netop niveauet for isolering af transaktioner.
De mest kendte anomalier er: dirty read, non-repeatable read, phantom read, men der er faktisk 5 mere: dirty write, cursor lost update, lost update, read skew, write skew.
Dirty write
Kernen i anomalien er, at transaktioner kan overskrive ikke-committerede data.
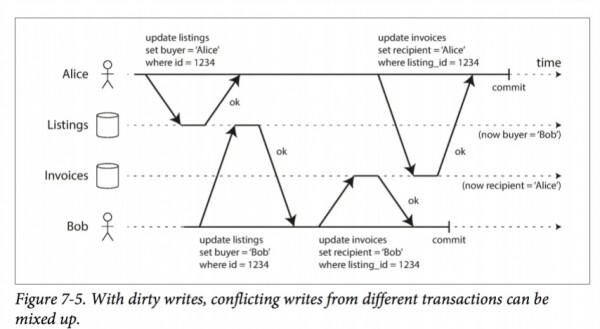
Denne anomalie er ikke kun farlig, fordi data kan konflikte efter commit af begge transaktioner (som på billedet), men også fordi den bryder atomariteten: da vi tillader at overskrive ikke-committerede data, er det uklart, hvordan vi kan rulle en transaktion tilbage uden at berøre en anden.
Anomalien behandles ret enkelt: vi sætter en lås på skrivning før vi begynder at skrive for at forhindre andre transaktioner i at ændre posten, indtil låsen er fjernet.
Dirty read
Dirty read betyder at læse uforpligtede data.
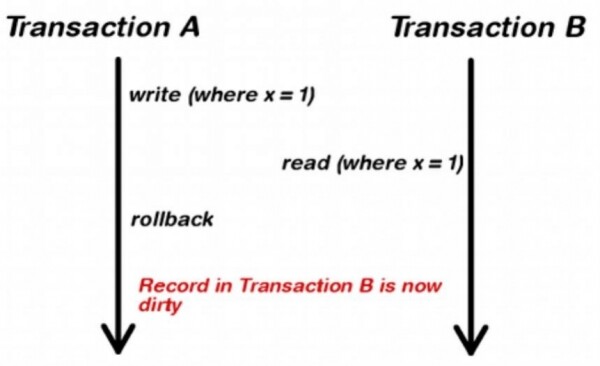
Problemer opstår, når der skal træffes beslutninger eller gennemføres handlinger baseret på denne sampling.
For at rette op på anomalien kan man låse læsningen, men det vil kraftigt påvirke ydelsen. Det er meget nemmere at sige, at for at rollback’e transaktionen skal den oprindelige tilstand af dataene (før skrivningen) absolut gemmes i systemet. Hvorfor ikke læse derfra? Det er ganske billigt, så de fleste databaser har dirty read deaktiveret som standard.
Lost update
Lost update betyder tabte opdateringer, og oversættelsen afspejler ganske præcist essensen af problemet:
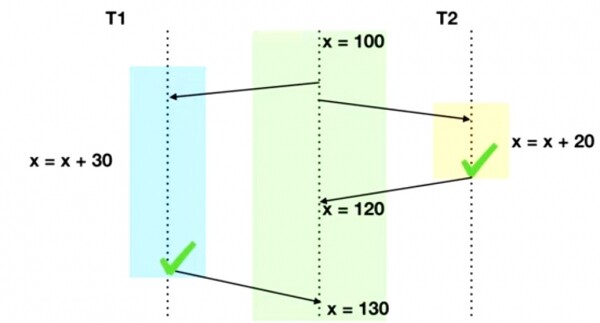
Faktisk blev resultatet af transaktionen T2 annulleret. Sådan en situation kan rettes med eksplicitte eller implicitte låsninger af posten. Det vil sige, at vi enten blot opdaterer posten, hvilket medfører en implicit låsning, eller vi udfører select for update, hvilket skaber en låsning på læsning og skrivning. Bemærk, at denne handling er ret farlig: med vores "uskyldige" læsning låser vi andre læsninger. Nogle databaser tilbyder en mere sikker select for share, som tillader læsning af data, men forhindrer ændringer.
Cursor lost update
For mere fin kontrol kan databaser tilbyde andre værktøjer, såsom en kursus. En kursus er en struktur, der indeholder et sæt rækker og muliggør iteration over dem. declare cursor_name for select_statement. Indholdet af kursoren beskrives af select'en.
Hvad er formålet med en kursus? Faktisk tilbyder nogle databaser låsning på alle poster valgt af select'en (read stability), eller kun på den post, som kursoren i øjeblikket befinder sig på (cursor stability). Ved cursor stability udføres en kort lås, hvilket reducerer antallet af låsninger, når vi itererer over et stort datasæt. Derfor fremhæves anomalien lost update særskilt for kursoren.
Non-repeatable read
Non-repeatable read indebærer, at under udførelsen af vores transaktion vil 2 på hinanden følgende læsninger af den samme post føre til forskellige resultater, fordi en anden transaktion har grebet ind mellem disse to læsninger, ændret vores data og er blevet committet.
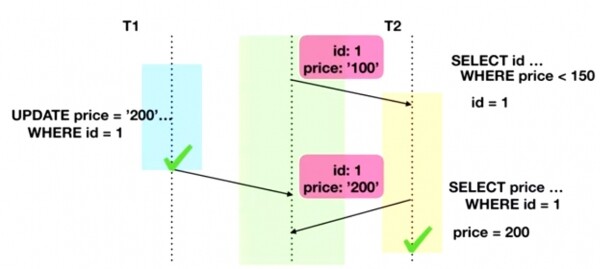
Hvorfor er det overhovedet et problem? Forestil dig, at målet for transaktionen T2 på billedet er at vælge alle varer, hvis pris er mindre end 150 enheder. Nogen har ændret prisen til 200 enheder. På denne måde virker den indstillede filter ikke.
Disse anomalier stopper med at opstå ved at tilføje to-fase låsning eller ved at bruge MVCC-mekanismen, som jeg gerne vil tale om separat.
Phantom read
En phantom-læsning kaldes det, når data læses, som er blevet tilføjet af en anden transaktion.
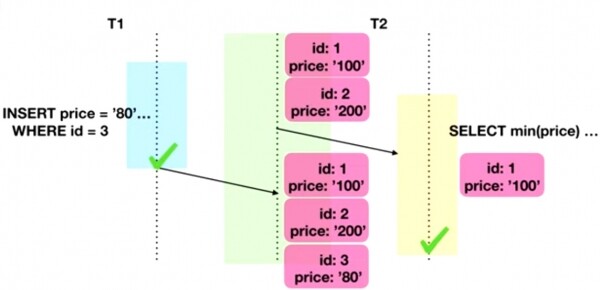
Som et eksempel kan vi observere en forkert udvælgelse af den billigste vare ved forekomsten af denne anomali.
At slippe af med phantom-læsninger er allerede ganske svært. Almindelig låsning er ikke nok, for vi kan ikke låse det, der endnu ikke findes. 2PL-systemer bruger predikativ låsning, mens MVCC-systemer lader transaktionsplanlæggeren annullere transaktioner, der kan blive forstyrret af en indtastning. Begge mekanismer er ret tunge.
Read skew
Read skew opstår, når vi arbejder med flere tabeller, hvis indhold skal ændre sig konsekvent.
Lad os antage, at der er tabeller, der repræsenterer indlæg og deres metadata:
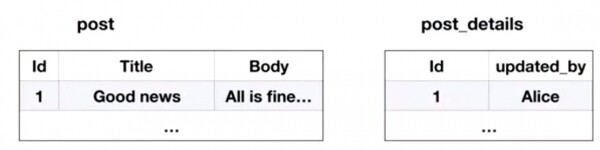
Én transaktion læser fra tabellerne, mens en anden ændrer dem:
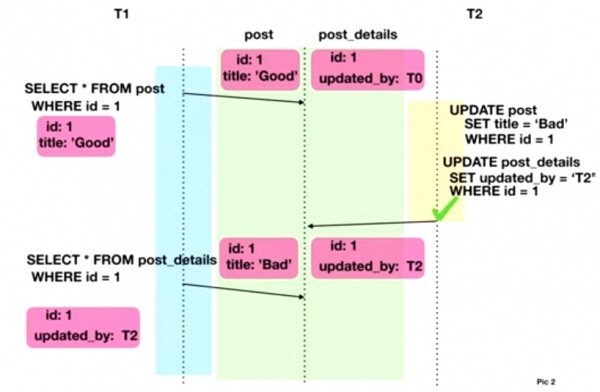
Som et resultat af udførelsen af transaktionen T1 har indlægget title = Good, og updated_by = T2, hvilket er en form for uoverensstemmelse.
Faktisk er dette en non-repeatable read, men inden for flere tabeller.
For at rette op på dette kan T1 lægge låse på alle de rækker, den vil læse, hvilket forhindrer transaktionen T2 i at ændre informationen. I tilfælde af MVCC vil transaktionen T2 blive annulleret. Beskyttelse mod denne anomali kan blive vigtig, hvis vi bruger markører.
Write skew
Denne anomali er også lettere at forklare med et eksempel: lad os antage, at der i vores system skal være mindst én læge på vagt, men begge læger besluttede at aflyse deres vagt:
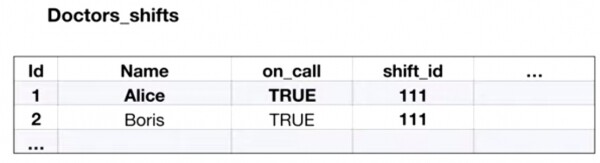
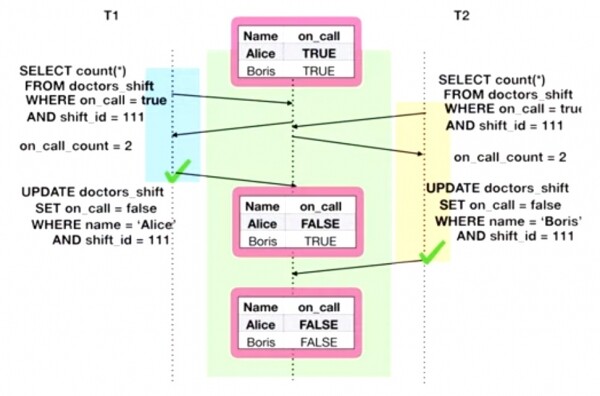
Anomalien førte til, at ingen af lægerne vil møde på vagt. Hvordan skete det? Fordi transaktionen kontrollerede en betingelse, der kan blive overtrådt af en anden transaktion, og på grund af isolation så vi ikke denne ændring.
Det er den samme non-repeatable read. Som en mulighed kan select'ene lægge låse på disse poster.
Write skew og read skew er kombinationer af de tidligere anomalier. Vi kan overveje write skew, som i bund og grund er en phantom read. Lad os overveje en tabel, der indeholder medarbejdernavne, deres løn og det projekt, de arbejder på:
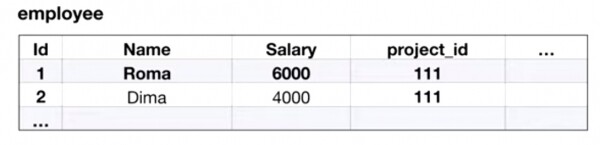
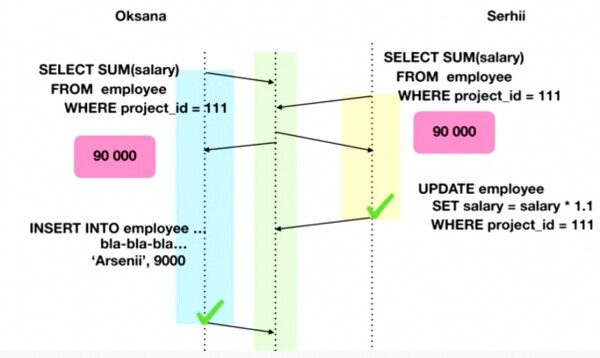
Resultatet er, at vi får følgende billede: hver leder troede, at hans ændring ikke ville føre til overskridelse af budgettet, så de lavede personaleændringer, der i alt førte til overskridelse.
Årsagen til problemet er den samme som ved phantom reads.
Konklusioner
Nedsættelse af niveauet for transaktionsisolering i databasen er en afvejning mellem sikkerhed og ydeevne, og valget af dette niveau bør overvejes ud fra de potentielle risici for virksomheden ved opståen af forskellige anomalier.
Kilde: habr.com
