

Hej alle sammen. I denne artikel vil jeg fortælle, hvorfor vi hos Avito for ni måneder siden valgte Kafka, og hvad det består af. Jeg vil dele en af de anvendelsessager, vi har — beskedbroker. Til sidst vil vi tale om de fordele, vi har fået ved at anvende Kafka som en service.
Problemet
Lad os starte med lidt kontekst. For nogen tid siden begyndte vi at bevæge os væk fra monolitisk arkitektur, og nu har Avito allerede flere hundrede forskellige tjenester. De har deres egne datalagre, deres egen teknologistak og er ansvarlige for deres del af forretningslogikken.
Et af problemerne med et stort antal tjenester er kommunikation. Tjeneste A vil ofte vide noget, som tjeneste B har information om. I dette tilfælde anmoder tjeneste A tjeneste B via et synkront API. Tjeneste V ønsker at vide, hvad der foregår hos tjenesterne G og D, som på deres side er interesseret i tjenesterne A og B. Når der bliver flere "nysgerrige" tjenester, bliver forbindelserne mellem dem til en forvirrende klasse.
Samtidig kan tjeneste A blive utilgængelig på ethvert tidspunkt. Hvad skal tjeneste B og alle de andre tjenester, der er afhængige af den, gøre i så fald? Og hvis der kræves en kæde af sekventielle synkrone opkald for at udføre en forretningsoperation, bliver sandsynligheden for at hele operationen fejler endnu højere (og den bliver højere, jo længere denne kæde er).
Valg af teknologi
Okay, problemerne er klarlagt. De kan løses ved at lave et centralt beskedsystem til kommunikation mellem tjenesterne. Nu behøver hver af tjenesterne kun at kende til dette beskedsystem. Derudover skal selve systemet være fejlretter og horisontalt skalerbart, samt i tilfælde af nedbrud kunne opbevare en buffer til senere behandling.
Lad os nu vælge en teknologi, som leveringen af beskederne vil blive implementeret på. For at gøre dette lad os først forstå, hvad vi forventer af den:
- beskeder mellem tjenesterne må ikke gå tabt;
- beskeder kan dubleres;
- beskeder kan opbevares og læses i flere dage (persistent buffer);
- tjenester kan abonnere på de data, de er interesseret i;
- flere tjenester kan læse de samme data;
- beskeder kan indeholde detaljeret, stor payload (event-carried state transfer);
- nogle gange er der brug for en garanti for rækkefølgen af beskeder.
Det var også kritisk for os at vælge et så skalerbart og pålideligt system som muligt med en høj båndbredde (mindst 100k beskeder på nogle få kilobyte i sekunder).
I dette trin sagde vi farvel til RabbitMQ (svært at holde stabilt ved høje rps), PGQ fra SkyTools (ikke hurtigt nok og dårligt skalerbart) og NSQ (ikke persistent). Alle disse teknologier bruges i vores virksomhed, men de var ikke egnede til opgaven.
Herefter begyndte vi at se på nye teknologier for os - Apache Kafka, Apache Pulsar og NATS Streaming.
Vi udelod først Pulsar. Vi besluttede, at Kafka og Pulsar er ret lignende løsninger. Og selvom Pulsar er testet af store virksomheder, er nyere og tilbyder lavere latency (i teorien), valgte vi at holde Kafka som de facto standard for sådanne opgaver. Vi vil sandsynligvis vende tilbage til Apache Pulsar i fremtiden.
Og nu var der kun to kandidater tilbage: NATS Streaming og Apache Kafka. Vi undersøgte begge løsninger grundigt, og begge passede til opgaven. Men til sidst var vi bekymrede over den relative ungdom af NATS Streaming (og det faktum, at en af hovedudviklerne, Tyler Treat, besluttede at forlade projektet og starte sit eget - Liftbridge). Samtidig gav NATS Streamings Clustering-tilstand ikke mulighed for stærk vandret skalering (det er sandsynligvis ikke længere et problem efter tilføjelsen af partitioneringstilstand i 2017).
Ikke desto mindre er NATS Streaming en fantastisk teknologi skrevet i Go og har støtte fra Cloud Native Computing Foundation. I modsætning til Apache Kafka kræver den ikke Zookeeper for at fungere (måske, ), da den internt implementerer RAFT. Samtidig er NATS Streaming lettere at administrere. Vi udelukker ikke, at vi i fremtiden også vender tilbage til denne teknologi.
Alligevel er Apache Kafka vores vinder i dag. I vores tests viste den sig at være hurtig nok (over én million beskeder i sekundet ved både læsning og skrivning med en beskedstørrelse på 1 kilobyte), ret pålidelig, godt skalerbar og testet i produktion af store virksomheder. Desuden understøtter Kafka mindst nogle store kommercielle virksomheder (for eksempel bruger vi Confluent-versionen), og Kafka har et udviklet økosystem.
Oversigt over Kafka
Før vi begynder, vil jeg straks anbefale en fremragende bog - «Kafka: The Definitive Guide» (der er også en russisk oversættelse, men terminologien kan være lidt forvirrende). Her kan du finde information, der er nødvendig for en grundlæggende forståelse af Kafka og endda lidt mere. Selve dokumentationen fra Apache og bloggen fra Confluent er også godt skrevet og let at læse.
Lad os tage et kig på, hvordan Kafka er opbygget fra fugleperspektiv. Den grundlæggende topologi af Kafka består af producer, consumer, broker og zookeeper.
Broker
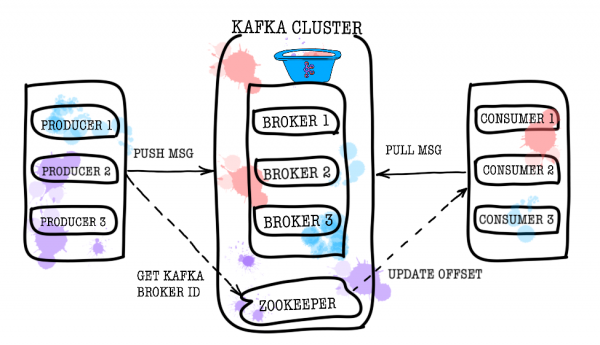
Det er brokerens ansvar at gemme dine data. Alle data opbevares i binært format, og broker ved meget lidt om, hvad de repræsenterer, og hvad deres struktur er.
Hver logisk type begivenheder findes typisk i sit eget separate emne (topic). For eksempel kan en oprettelsesbegivenhed for en annonce falde ind under emnet item.created, mens en ændringsbegivenhed kan falde ind under item.changed. Emner kan betragtes som klassifikatorer for begivenheder. På emneniveau kan man sætte konfigurationselementer som:
- mængden af gemte data og/eller deres alder (retention.bytes, retention.ms);
- datadupliceringsfaktor (replication factor);
- den maksimale størrelse af en enkelt meddelelse (max.message.bytes);
- det mindste antal accepterede replikaer, som data kan skrives til emnet (min.insync.replicas);
- muligheden for at gennemføre failover til en ikke-synkroniseret bagudgående replika med potentiel datatab (unclean.leader.election.enable);
- og mange andre ().
Hver emne opdeles i en eller flere partitioner (partition). Det er i partitionen, at begivenhederne til sidst lander. Hvis der er mere end én broker i klyngen, vil partitionerne blive fordelt jævnt over alle brokerne (så vidt muligt), hvilket gør det muligt at skalere belastningen for skrivning og læsning til et enkelt emne på flere brokere.
På disken gemmes data for hver partition i form af segmentfiler, som som standard er lige én gigabyte (kontrolleres gennem log.segment.bytes). En vigtig egenskab er, at fjernelse af data fra partitioner (ved aktivering af retention) sker i segmenter (man kan ikke fjerne én begivenhed fra en partition, kun fjerne et helt segment, og det kun hvis det er inaktivt).
Zookeeper
Zookeeper fungerer som datalager for metadata og koordinator. Det er ham, der kan sige, om brokerne er aktive (man kan se dette gennem zookeeper-shell med kommandoen ls /brokers/ids), hvilken af brokerne der er controller (get /controller), er partitionerne synkroniseret med deres replikaer (get /brokers/topics/topic_name/partitions/partition_number/state). Desuden vil producer og consumer først gå til zookeeper for at finde ud af, hvilken broker hvilke emner og partitioner gemmes på. I tilfælde, hvor replication factor for et emne er højere end 1, vil zookeeper angive, hvilke partitioner der er ledere (hvor der skrives til og læses fra). Ved et broker-nedbrud vil information om nye leder-partitioner blive registreret i zookeeper (asynkront siden version 1.1.0, ).
I ældre versioner af Kafka svarede zookeeper også for opbevaring af offsets, men nu gemmes de i et særligt emne __consumer_offsets på brokeren (selvom du stadig kan bruge zookeeper til disse formål).
Den nemmeste måde at forvandle dine data til græskar er faktisk at miste information fra zookeeper. I et sådant scenarie vil det være meget svært at forstå, hvad og hvor der skal læses.
Producer
Producer er oftest en service, der direkte skriver data til Apache Kafka. Producer vælger det emne, hvor hans tematiske beskeder skal gemmes, og begynder at skrive information til det. For eksempel kan en producer være en annonceservice. I så fald vil den sende hændelser som "annonce oprettet", "annonce opdateret", "annonce slettet" osv. i de tematiske emner. Hver hændelse repræsenterer et nøgle-værdi par.
Som standard distribueres alle hændelser jævnt på partitionerne i emnet round-robin, hvis nøglen ikke er angivet (hvilket mister rækkefølgen), og via MurmurHash (nøgle), hvis nøglen er tilstede (bevarer rækkefølge inden for én partition).
Her er det vigtigt at bemærke, at Kafka kun garanterer rækkefølgen af hændelser inden for én partition. Men i praksis er dette ofte ikke et problem. For eksempel kan man garantere, at alle ændringer af det samme annonce emne tilføjes til én partition (og dermed bevarer rækkefølgen af disse ændringer inden for annoncen). Man kan også overføre en sekvensnummer i et af felterne i hændelsen.
Consumer
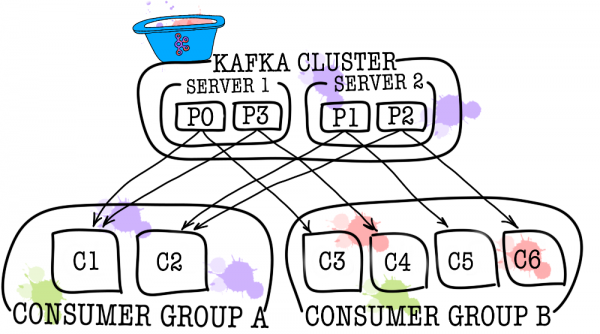
Forbrugeren er ansvarlig for at hente data fra Apache Kafka. Hvis vi vender tilbage til eksemplet ovenfor, kan forbrugeren være en modereringsservice. Denne service vil abonnere på emnet fra annonceservice, og når der opstår en ny annonce, vil den modtage den og analysere den for overensstemmelse med nogle specifikke politikker.
Apache Kafka husker, hvilke seneste begivenheder forbrugeren har modtaget (til dette bruges en systememne __consumer__offsets), hvilket garanterer, at forbrugeren ikke modtager den samme besked to gange efter en vellykket læsning. Men hvis man bruger indstillingen enable.auto.commit = true og overlader det til Kafka at holde styr på forbrugerens position i emnet, kan man miste data. I produktionskoden kontrolleres forbrugerens position ofte manuelt (udvikleren styrer, hvornår en commit af den læste begivenhed nødvendigvis skal finde sted). Testresultater
Her vil jeg ikke skrive meget forklarende tekst, jeg vil bare dele de opnåede resultater. Testningen blev udført på 3 fysiske maskiner (12 CPU, 384GB RAM, 15k SAS-DISK, 10GBit/s net), og enhederne broker og zookeeper blev udsat for lxc.
Ydeevnetest
Under testningen blev de følgende resultater opnået.
Skrivehastighed for beskeder på 1KB med 9 producenter samtidigt — 1300000 begivenheder i sekundet.
Læsehastighed for beskeder på 1KB med 9 forbrugere samtidigt — 1500000 begivenheder i sekundet.
- Test af fejltolerance
- Under testningen blev de følgende resultater opnået (3 enheder broker, 3 zookeeper).
En utilsigtet afslutning af en af enhederne broker stopper ikke eller gør klyngen utilgængelig. Arbejdet fortsætter i normal drift, men de resterende enheder broker må bære en større belastning.
En utilsigtet afslutning af en af enhederne broker stopper ikke eller gør klyngen utilgængelig. Arbejdet fortsætter i normal drift, men de resterende enheder broker må bære en større belastning.
- En utilsigtet afslutning af en af enhederne broker stopper ikke eller gør klyngen utilgængelig. Arbejdet fortsætter i normal drift, men de resterende enheder broker må bære en større belastning.
- Uventet nedlukning af to mæglere i en klynge af tre mæglere med min.isr = 2 fører til, at klyngen ikke er tilgængelig for skrivning, men er tilgængelig for læsning. I tilfælde af at min.isr = 1, forbliver klyngen tilgængelig for både læsning og skrivning. Det skal dog bemærkes, at denne tilstand strider mod kravet om høj databeskyttelse.
- Uventet nedlukning af en af Zookeeper-serverne medfører ikke nedlukning eller utilgængelighed af klyngen. Arbejdet fortsætter som normalt.
- Uventet nedlukning af to Zookeeper-servere medfører, at klyngen bliver utilgængelig, indtil mindst én af Zookeeper-serverne er genoprettet. Denne påstand gælder for en Zookeeper-klynge bestående af 3 servere. Som følge heraf blev det besluttet at øge Zookeeper-klyngen til 5 servere for at øge fejltolerance.
Kafka som en service
Vi har konkluderet, at Kafka er en fremragende teknologi, der gør det muligt at løse den opgave, vi har fået (implementeringen af en meddelelsesmægler). Vi har dog besluttet at forbyde tjenesterne direkte at tilgå Kafka og har lukket den af bag ved data-bus. Hvorfor gjorde vi det? Der er faktisk flere grunde.
Data-bus tog alle opgaver relateret til integration med Kafka (implementering og konfiguration af forbrugere og producenter, overvågning, alarmering, logning, skalering osv.). På den måde foregår integrationen med meddelelsesmægleren så simpelt som muligt.
Data-bus gjorde det muligt at abstrahere fra et specifikt sprog eller bibliotek til at arbejde med Kafka.
Data-bus gav andre tjenester mulighed for at abstrahere fra lagringslaget. Måske ændrer vi på et tidspunkt Kafka til Pulsar, og ingen vil lægge mærke til det (alle tjenester kender kun API'et for data-bus).
Data-bus har påtaget sig valideringen af hændelsesskemaer.
Authentication er implementeret ved hjælp af data-bus.
Under dække af data-bus kan vi opdatere versioner af Kafka uden nedetid og uden at det bliver bemærket, og centralt styre konfigurationer af producenter, forbrugere, mæglere osv.
Data-bus gav mulighed for at tilføje nødvendige funktioner, som ikke findes i Kafka (såsom audit af emner, kontrol af anomalier i klyngen, oprettelse af DLQ osv.).
Data-bus muliggør centraliseret failover for alle tjenester.
I øjeblikket er det nok at tilføje et lille bibliotek til koden af din tjeneste for at begynde at sende events til message broker. Det er alt. Du får mulighed for at skrive, læse og skalere med en enkelt linje kode. Hele implementeringen er skjult for dig, kun nogle håndtag som batch-størrelse er synlige. Under motorhjelmen opsætter data-bus servicen det nødvendige antal instanser af producer og consumer i Kubernetes og giver dem den nødvendige konfiguration, men alt dette er gennemsigtigt for din service.
Selvfølgelig findes der ikke en sølvkugle, og denne tilgang har sine begrænsninger.
- Data-bus skal vedligeholdes af dine egne kræfter, i modsætning til tredjepartsbiblioteker.
- Data-bus øger antallet af interaktioner mellem tjenesterne og message broker, hvilket fører til nedsat ydeevne sammenlignet med ren Kafka.
- Det er ikke alt, der kan skjules for tjenesterne; vi ønsker ikke at duplikere funktionaliteten af KSQL eller Kafka Streams i data-bus, derfor er vi nogle gange nødt til at tillade, at tjenesterne kommunikerer direkte.
I vores tilfælde overgik fordelene ulemperne, og beslutningen om at adskille message broker som en særlig service har vist sig at være klog. I løbet af et år med drift har vi ikke haft alvorlige uheld eller problemer.
P.S. Tak til min kæreste, Ekaterina Obalaya, for de fede billeder til denne artikel. Hvis du kunne lide dem, vil der være endnu flere illustrationer.
Kilde: habr.com
