

Velkommen til dig, Habr!
Engang var vi de første til at introducere emnet og fortsætter dens udvikling. Især har emnet omkring interaktionen mellem Kafka og . En oversigt (og ganske forsigtig) om dette emne blev udgivet i bloggen fra Confluent tilbage i oktober sidste år af Gwen Shapiro. I dag vil vi gerne henlede din opmærksomhed på en mere aktuel artikel fra april af Johann Gyger, som, selvom han ikke undgik et spørgsmålstegn i titlen, betragter emnet mere konkret og supplerer teksten med interessante links. Undskyld, hvis vi har oversat "chaos monkey" frit!
Introduktion
Kubernetes er designet til at arbejde med belastninger, der ikke har en beholdning. Som regel er sådanne arbejdsbelastninger præsenteret i form af en mikrotjenestearkitektur, de er lette, nemme at skalere horisontalt, følger principperne for 12-faktor applikationer og tillader arbejde med automatisk afbrydere (circuit breakers) og chaos monkeys.
Kafka, derimod, fungerer i princippet som en distribueret database. Derfor skal du arbejde med tilstand, som er meget tungere end en mikrotjeneste. Kubernetes understøtter tilstande med persistent lagring, men som Kelsey Hightower påpeger i sine to tweets, skal man være forsigtig med dem:
Nogle mener, at hvis man implementerer Kubernetes på en belastning med persistent lagring, så bliver det til en fuldt administreret database, der kan konkurrere med RDS. Det er ikke korrekt. Måske, hvis man arbejder hårdt nok, tilføjer ekstra komponenter og inviterer et SRE-team, kan man få RDS til at fungere oven på Kubernetes.
Jeg anbefaler altid at udvise ekstrem forsigtighed, når man kører belastninger med persistent lagring på Kubernetes. De fleste af dem, der spørger, "kan jeg køre belastninger med persistent lagring på Kubernetes", har ikke tilstrækkelig erfaring med Kubernetes, og ofte heller ikke med den belastning, de spørger om.
Så, skal Kafka køre på Kubernetes? Det modsatte spørgsmål er: Vil Kafka fungere bedre uden Kubernetes? Derfor vil jeg i denne artikel fremhæve, hvordan Kafka og Kubernetes supplerer hinanden, samt hvilke faldgruber der kan opstå ved deres kombination.
Udførelsestid
Lad os tale om den grundlæggende ting - udførelsesmiljøet som sådan
Proces
Kafka-mæglere er effektive at arbejde med CPU. TLS kan tilføre nogle overhead. Klienter til Kafka kan dog belaste CPU'en yderligere, hvis de bruger kryptering, men det påvirker ikke mæglere.
Hukommelse
Kafka-mæglere kræver meget hukommelse. Størrelsen på JVM-haugen bør typisk begrænses til 4-5 GB, men du får også brug for meget systemhukommelse, da Kafka bruger side-cache meget aktivt. I Kubernetes skal du passende angive containerens ressourcegrænser og -anmodninger.
Datastore
Datastore i containere er ephemeralt - data går tabt ved genstart. For Kafka-data kan du bruge et volumen emptyDir, og effekten vil være den samme: dine mæglers data vil gå tabt efter afslutning. Dine beskeder kan stadig bevares på andre mæglere som replikaer. Derfor skal den fejlede mægler først replikere alle data efter genstart, og denne proces kan tage noget tid.
Derfor bør du bruge langsigtet datastore. Lad det være et ikke-lokalt langsigtet datastore med filsystemet XFS eller mere præcist ext4. Brug ikke NFS. Jeg advarer. NFS-versioner v3 eller v4 vil ikke fungere. Kort sagt, Kafka-mægleren vil stoppe, hvis den ikke kan slette datakataloget på grund af problemer med 'dumme omdøbninger', der er relevante for NFS. Hvis jeg ikke har overbevist dig indtil nu, læs denne artikel meget omhyggeligt . Datalagringen skal være ikke-lokal, så Kubernetes mere fleksibelt kan vælge en ny node efter genstart eller relokation.
Netværk
Som ligesom med de fleste distribuerede systemer afhænger ydeevnen af Kafka stærkt af, at netværksforsinkelsen er minimal, og båndbredden er maksimal. Forsøg ikke at placere alle brokere på samme node, da dette vil reducere tilgængeligheden. Hvis en Kubernetes-node fejler, vil hele Kafka-klusteret fejle. Spred heller ikke Kafka-klusteret over hele datacentre. Det samme gælder for Kubernetes-klusteret. Et godt kompromis i dette tilfælde er at vælge forskellige tilgængelighedszoner.
Konfiguration
Almindelige manifester
På Kubernetes-websitet er der om, hvordan man konfigurerer ZooKeeper ved hjælp af manifester. Da ZooKeeper er en del af Kafka, er det her, det er praktisk at begynde at blive bekendt med, hvilke koncepter Kubernetes der er anvendelige her. Når du forstår dette, kan du anvende de samme koncepter med Kafka-klusteret.
- Under: en pod er den mindste deployerbare enhed i Kubernetes. En pod indeholder din arbejdsbyrde, og selve pod'en svarer til en proces i dit kluster. En pod indeholder en eller flere containere. Hver ZooKeeper-server i ensemblet og hver broker i Kafka-klusteret vil køre i en separat pod.
- StatefulSet: StatefulSet er et Kubernetes-objekt, der arbejder med flere arbejdsbyrder, der har tilstande, og sådanne byrder kræver koordinering. StatefulSet giver garantier for rækkefølgen af pods og deres unikke identiteter.
- Headless-tjenester: Tjenester gør det muligt at frakoble pods fra klienter ved hjælp af et logisk navn. Kubernetes står i dette tilfælde for belastningsfordelingen. Men ved håndtering af arbejdsbyrder med tilstand, som med ZooKeeper og Kafka, skal klienterne udveksle informationer med en bestemt instans. Det er her, headless-tjenesterne kommer ind i billedet: i dette tilfælde vil klienten stadig have et logisk navn, men der vil ikke være behov for direkte at henvende sig til pod'en.
- Volume til langfristet opbevaring: sådanne volumes er nødvendige for at konfigurere ikke-lokal blok-lagring, som nævnt ovenfor.
På tilbyder et omfattende sæt manifester, der gør det nemt at komme i gang med Kafka på Kubernetes.
Helm-diagrammer
Helm er en pakkehåndterer til Kubernetes, som kan sammenlignes med pakkehåndtere til operativsystemer som yum, apt, Homebrew eller Chocolatey. Det gør det nemt at installere foruddefinerede softwarepakker, beskrevet i Helm-diagrammer. Et veludformet Helm-diagram forenkler den komplekse opgave: hvordan man korrekt konfigurerer alle parametre til brug af Kafka på Kubernetes. Der er flere Kafka-diagrammer: den officielle er , der er en fra , og en anden fra .
Operatører
Da Helm har visse ulemper, får et andet værktøj, Kubernetes-operatører, en stor popularitet. En operatør pakker ikke bare softwaren til Kubernetes, men giver også mulighed for at implementere og administrere denne software.
Listen over nævner to operatører for Kafka. En af dem er . Med Strimzi er det nemt at opsætte et Kafka-kluster på få minutter. Næsten ingen konfiguration er nødvendig, og operatøren tilbyder også nogle gode funktioner, som f.eks. point-to-point TLS-kryptering inden for klusteret. Confluent tilbyder også .
Ydeevne
Det er meget vigtigt at teste ydeevnen ved at udstyre den installerede Kafka-instans med kontrolpunkter. Disse tests hjælper med at opdage potentielle flaskehalse, før problemerne opstår. Heldigvis leverer Kafka allerede to værktøjer til ydeevnetestning: kafka-producer-perf-test.sh og kafka-consumer-perf-test.sh. Brug dem aktivt. Du kan sammenligne dine resultater med dem, der er beskrevet af Jay Kreps, eller henholde dig til af Amazon MSK fra Stéphane Maarek.
Operationer
Overvågning
Transparens i systemet er meget vigtigt – ellers forstår du ikke, hvad der sker i det. I dag findes der et solidt værktøjsæt, der muliggør overvågning baseret på metrics i cloud-native stil. To populære værktøjer til dette formål er Prometheus og Grafana. Prometheus kan indsamle metrics fra alle Java-processer (Kafka, Zookeeper, Kafka Connect) ved hjælp af en JMX-exportør – på den simpleste måde. Hvis man tilføjer cAdvisor-metrics, kan man få et mere komplet billede af, hvordan ressourcer bruges i Kubernetes.
Strimzi har et meget praktisk Grafana-dashboard eksempel til Kafka. Det visualiserer nøglemetrikker, såsom ureplicerede partitioner eller dem, der er offline. Alt er meget klart. Disse metrikker suppleres med oplysninger om ressourceforbrug og ydeevne samt stabilitetsindikatorer. På den måde får du grundlæggende overvågning af Kafka-klyngen helt gratis!
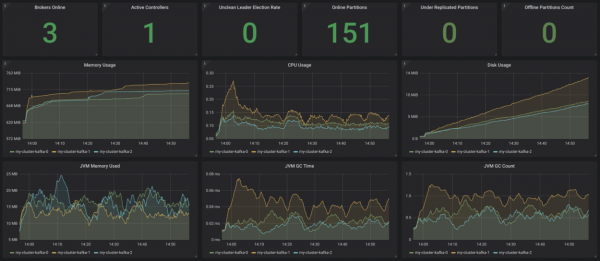
Kilde:
Det ville desuden være godt at supplere med klientmonitorering (metrikker for forbrugere og producenter) samt forsinkelsesovervågning (til dette findes der ) og ende-til-ende overvågning – brug .
Logføring
Logning er en anden ekstremt vigtig opgave. Sørg for, at alle containere i din Kafka-installation logger til stdout og stderr, og sørg også for, at din Kubernetes-klynge aggregerer alle logs i en central log-infrastruktur, såsom .
Tjek af tilstand
Kubernetes bruger livs- (liveness) og klarheds (readiness) probes til at tjekke, om dine pods fungerer korrekt. Hvis livstjekket mislykkes, stopper Kubernetes denne container og genstarter den automatisk, hvis genstartpolitikken er indstillet derefter. Hvis klarhedstjekket mislykkes, isolerer Kubernetes denne pod fra at håndtere anmodninger. På den måde kræves der ikke længere manuel indgriben i sådanne tilfælde, hvilket er et stort plus.
Udrulning af opdateringer
StatefulSets understøtter automatiske opdateringer: ved valg af strategien RollingUpdate vil hver Kafka-pod blive opdateret en ad gangen. På den måde kan nedetiden reduceres til nul.
Skalering
Skalering af Kafka-klyngen er en udfordring. Men i Kubernetes er det meget enkelt at skalere pods til et bestemt antal replikaer, hvilket betyder, at du deklarativt kan definere så mange Kafka-brokere, som du ønsker. Det sværeste i dette tilfælde er omfordeling af partitioner efter at have skaleret op eller før at skale ned. Igen vil Kubernetes hjælpe dig med denne opgave.
Administration
Opgaver relateret til administration af dit Kafka-klynge, specifikt oprettelse af emner og genfordeling af partitioner, kan udføres med de tilgængelige shell-scripts ved at åbne kommandolinjegrænsefladen i dine pods. Men denne løsning er ikke særlig elegant. Strimzi understøtter emnestyring med en anden operator. Her er der plads til forbedringer.
Backup og gendannelse
Nu vil tilgængeligheden af Kafka afhænge af tilgængeligheden af Kubernetes. Hvis din Kubernetes-kluster falder, vil dit Kafka-kluster i værste fald også falde. Som Murphy's lov siger, vil det helt sikkert ske, og du vil miste data. For at minimere denne risiko er det en god idé at have en solid backup-strategi. Du kan bruge MirrorMaker, en anden mulighed er at benytte S3 til dette, som beskrevet i denne fra Zalando.
Konklusion
Når du arbejder med små eller mellemstore Kafka-klynger, er det bestemt fornuftigt at bruge Kubernetes, da det giver ekstra fleksibilitet og forenkler arbejdet med operatører. Hvis du står over for meget strenge ikke-funktionelle krav angående forsinkelse og/eller båndbredde, kan det være bedre at overveje et andet deploymentsalternativ.
Kilde: habr.com
