

Amazon Web Services' netværk omfatter 69 zoner over hele verden i 22 regioner: USA, Europa, Asien, Afrika og Australien. Hver zone rummer op til 8 datacentre. Hvert datacenter har tusindvis eller hundrede tusinder af servere. Netværket er konstrueret, så alle usandsynlige scenarier for driftsforstyrrelser tages i betragtning. For eksempel er alle regioner isoleret fra hinanden, og tilgængelighedszonerne er adskilt med afstande på flere kilometer. Selv hvis der skæres i et kabel, vil systemet skifte til reservekanaler, og datatab vil være på niveau med en håndfuld datapakker. Om de andre principper, netværket er bygget på, og hvordan det fungerer, fortæller Vasily Pantiukhin.
Vasily Pantiukhin startede som Unix-administrator i .ru-virksomheder, har i 6 år arbejdet med store maskiner fra Sun Microsystem, og i 11 år har han prædiket datacentercentrerethed i verden i EMC. Han har naturligt udviklet sig til private clouds og har derefter bevæget sig ind i offentlige. Nu, som arkitekt i Amazon Web Services, hjælper han med tekniske råd til at leve og udvikle sig i AWS-miljøet.
I den foregående del af trilogien om strukturen i AWS dykkede Vasily ned i infrastrukturen af fysiske servere og databasestørrelse. Nitro-kort, et tilpasset hypervisor baseret på KVM, Amazon Aurora-databasen - alt dette kan findes i artiklen "". Læs for at dykke ind i konteksten, eller se af præsentationen.
I denne del vil fokus være på netværksskaleringsløsninger - et af de mest komplekse systemer i AWS. Udviklingen fra et fladt netværk til Virtual Private Cloud og dets opbygning, interne tjenester som Blackfoot og HyperPlane, problemet med støjende naboer, og til slut - netværkets omfang, backbone og fysiske kabler. Alt dette findes under katten.
Disclaimer: Alt hvad der står nedenfor er Vasily's personlige holdning og det kan være i uoverensstemmelse med Amazon Web Services' siddende position.
Netværksskaleringsløsninger
AWS-clouden blev lanceret i 2006. Dens netværk var temmelig primitivt - med en flad struktur. Området med private IP-adresser var delt blandt alle lejere af skyen. Når du lancerede en ny virtuel maskine, modtog du tilfældigt en tilgængelig IP-adresse fra dette område.
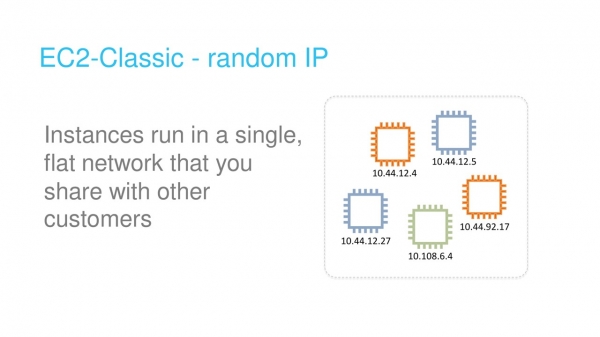
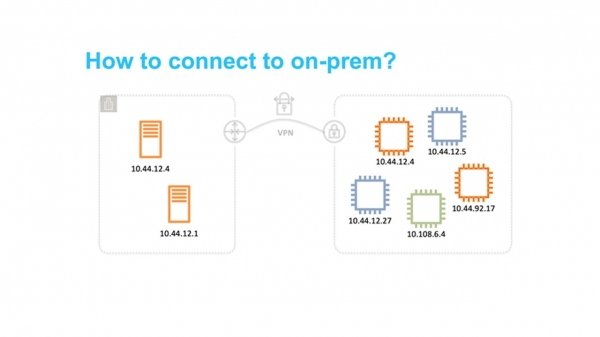
Denne tilgang var let at implementere, men begrænsede grundlæggende brugen af skyen. Især var det ret vanskeligt at udvikle hybride løsninger, der kombinerede private netværk på jorden og i AWS. Det mest almindelige problem lå i krydsningen af IP-adresseområder.
Virtuelt Privat Cloud
Skyen har vist sig at være efterspurgt. Det er tid til at overveje skalerbarhed og muligheden for at anvende den af millioner af lejere. Det flade netværk er blevet den største hindring. Derfor har vi overvejet, hvordan vi kan isolere brugere fra hinanden på netværksniveau, så de selv kan vælge IP-områder.
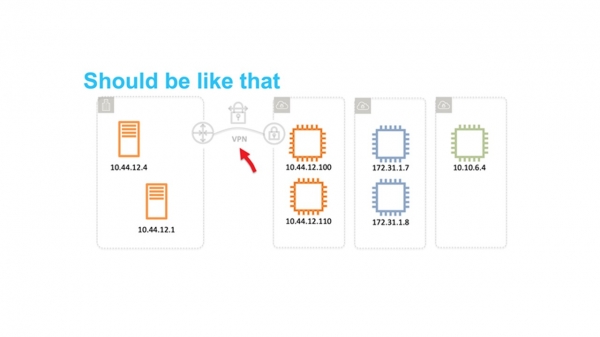
Hvad tænker du først på, når du overvejer netværksisolering? Selvfølgelig VLAN og VRF — Virtuel Routing og Forwarding.
Desværre har dette ikke fungeret. VLAN ID er kun 12 bit, hvilket giver os kun 4096 isolerede segmenter. Selv i de største switches kan man maksimalt bruge 1-2 tusinde VRF. Kombinationen af VRF og VLAN giver os kun et par millioner subnetværk. Dette er bestemt ikke tilstrækkeligt til millioner af lejere, hvor hver enkelt skal have mulighed for at bruge flere subnetværk.
Derudover har vi simpelthen ikke råd til at købe det nødvendige antal store bokse, for eksempel fra Cisco eller Juniper. Der er to grunde til dette: det er sindssygt dyrt, og vi ønsker ikke at blive afhængige af deres udviklings- og patchpolitikker.
Konklusionen er klar – vi må udvikle vores eget løsning.
I 2009 annoncerede vi VPC — Virtuelt Privat Cloud. Navnet har hængt ved, og nu bruger mange cloududbydere det også.
VPC – det er et virtuelt netværk SDN (Software Defined Network). Vi besluttede ikke at opfinde specielle protokoller på L2 og L3 niveauer. Netværket fungerer på standard Ethernet og IP. For at transmittere trafik over netværket indkapsles trafik fra virtuelle maskiner i indpakningen af vores eget protokol. Den angiver et ID, der tilhører VPC lejeren.
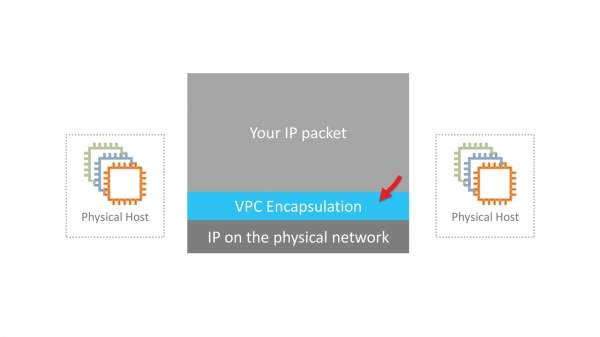
Det lyder enkelt. Men der er flere alvorlige tekniske udfordringer, der skal løses. For eksempel, hvor og hvordan man opbevarer data om kortlægningen af virtuelle MAC/IP-adresser, VPC ID og de tilsvarende fysiske MAC/IP. I skalaen af AWS er det en kæmpe tabel, der skal fungere med minimale forsinkelser under forespørgsler. Dette håndteres af kortlægningsservicen, som er distribueret tyndt over hele netværket.
I næste generations maskiner udføres indkapsling af Nitro-kort på hardware niveau. I ældre instanser er indkapsling og dekapsling programmeret.
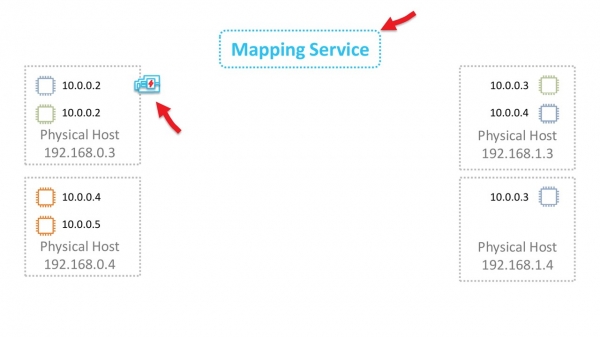
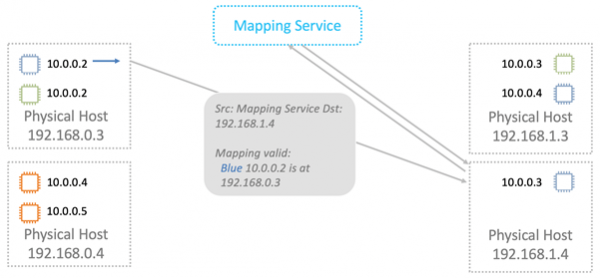
Lad os se, hvordan det fungerer i store træk. Vi starter med L2-niveauet. Antag, at vi har en virtuel maskine med IP 10.0.0.2 på en fysisk server 192.168.0.3. Den sender data til den virtuelle maskine 10.0.0.3, som er placeret på 192.168.1.4. Der dannes en ARP-forespørgsel, som når det netværk Nitro-kortet. For enkelhedens skyld antager vi, at begge virtuelle maskiner lever i det samme 'blå' VPC.
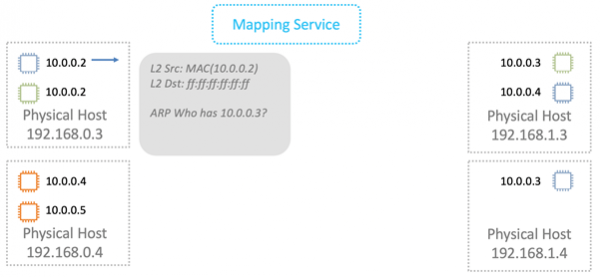
Kortet erstatter kildeadressen med sin egen og videresender ARP-rammen til kortlægningstjenesten.
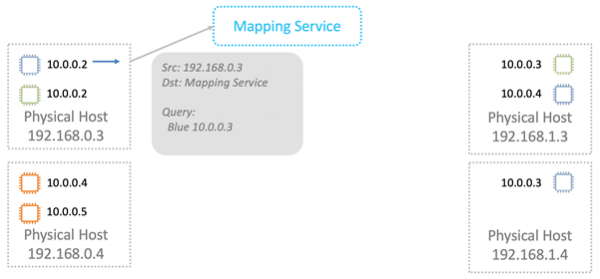
Kortlægningstjenesten returnerer de oplysninger, der er nødvendige for at sende over det fysiske L2-netværk.
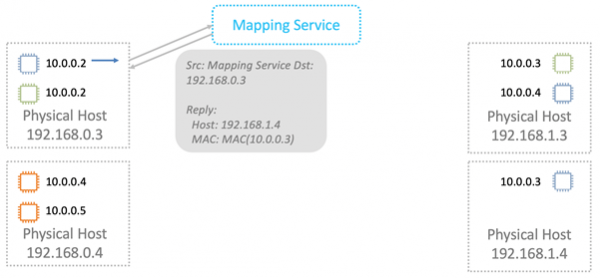
Nitro-kortet erstatter MAC-adressen i det fysiske netværk med adressen i VPC i ARP-svaret.
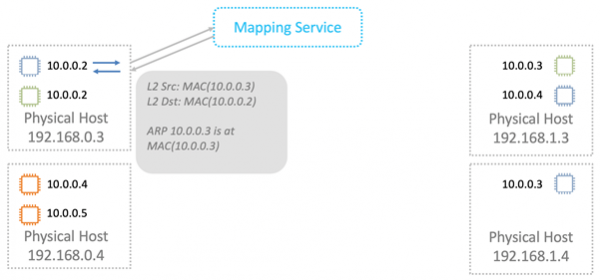
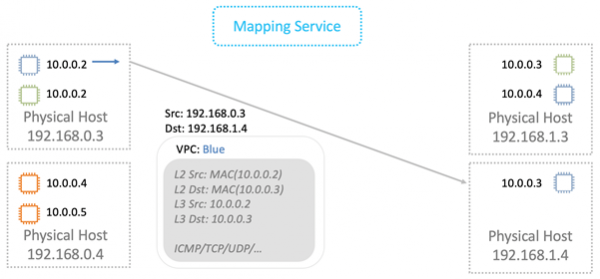
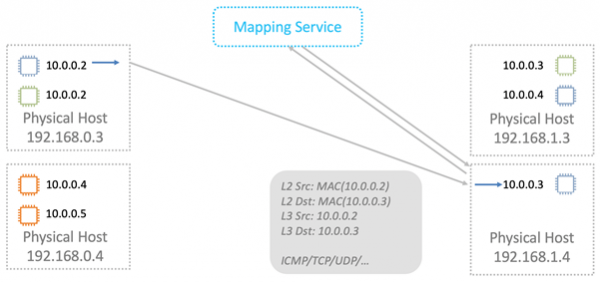
Ved dataoverførsel indkapsler vi de logiske MAC- og IP-adresser i en VPC-indpakning. Alt dette sendes over det fysiske netværk ved hjælp af de relevante IP Nitro-kort fra både kilde og destination.
Den fysiske maskine, som pakken er beregnet til, foretager en kontrol. Dette er nødvendigt for at forhindre adresseforfalskning. Maskinen sender en speciel forespørgsel til kortlægningstjenesten og spørger: "Fra den fysiske maskine 192.168.0.3 har jeg modtaget en pakke, der er beregnet til 10.0.0.3 i det 'blå' VPC. Er den legitim?"
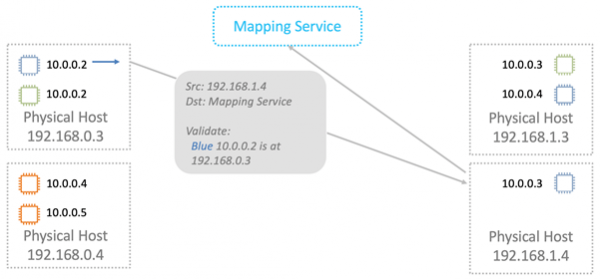
Kortlægningstjenesten tjekker sin ressourceplaceringstabel og tillader eller forbyder pakken at passere. I alle nye instanser er der indbygget ekstra validering i Nitro-kortene. Dette kan ikke omgås selv teoretisk. Derfor vil spoofing til ressourcer i et andet VPC ikke lykkes.
Derefter sendes dataene til den virtuelle maskine, de er beregnet til.
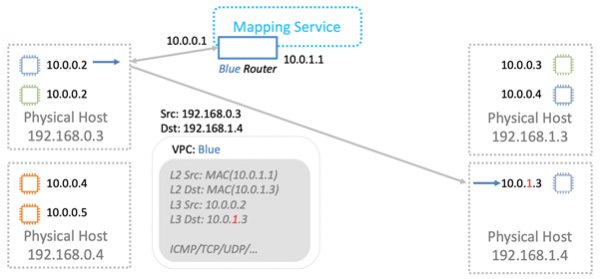
Kortlægningstjenesten fungerer også som en logisk router til overførsel af data mellem virtuelle maskiner i forskellige subnetværk. Der er alt enkelt konceptuelt, jeg vil ikke gå i detaljer.
Det viser sig, at serverne henvender sig til kortlægningstjenesten ved overførsel af hver pakke. Hvordan kan vi håndtere de uundgåelige forsinkelser? Ved at cache, selvfølgelig.
Det gode ved det er, at det ikke er nødvendigt at cache hele den store tabel. De virtuelle maskiner på den fysiske server kommer fra et relativt lille antal VPC'er. Caching skal kun ske for disse VPC'er. Dataoverførsel til andre VPC'er i standardkonfigurationen er stadig ikke legitim. Hvis der bruges funktioner som VPC-peering, vil oplysninger om de relevante VPC'er også blive indlæst i cachen.
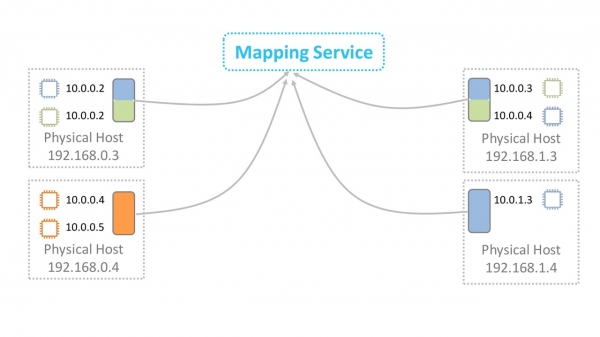
Vi har nu forstået dataoverførsel i VPC.
Blackfoot
Hvordan håndterer man situationer, hvor trafik skal sendes ud, for eksempel til internettet eller via VPN? Her hjælper Blackfoot — den interne service AWS. Den er udviklet af vores sydafrikanske team. Derfor er tjenesten opkaldt efter pingvinen, der lever i Sydafrika.
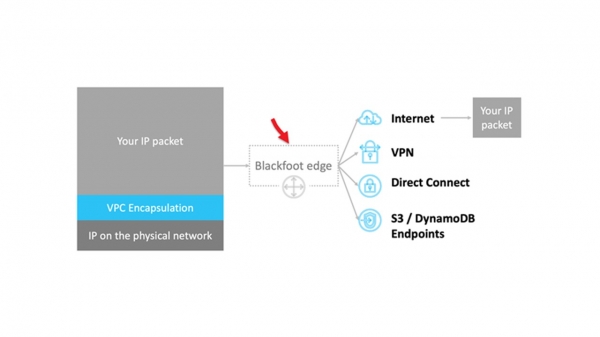
Blackfoot dekapslerer trafikken og gør hvad der er nødvendigt med den. Dataene sendes på internettet som de er.
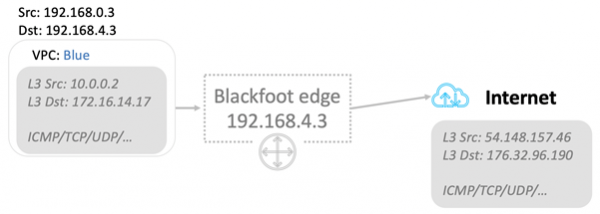
Data dekapsles og pakkes igen ind i en IPsec-wrapper ved brug af VPN.
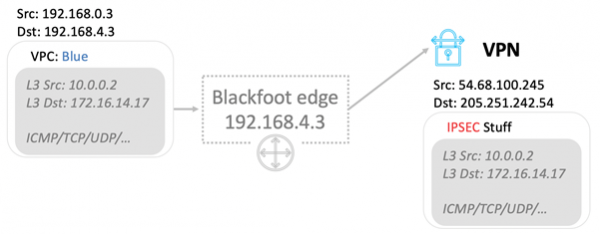
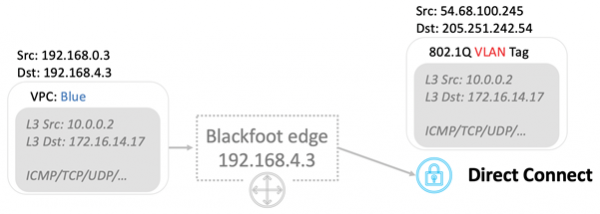
Ved brug af Direct Connect tagges trafikken og sendes til den relevante VLAN.
HyperPlane
Dette er en intern tjeneste til trafikstyring. Mange netværkstjenester kræver kontrol af strømmen af data. For eksempel, ved brug af NAT, skal trafikstyringen sikre, at hver klynge "IP: destinationsport" svarer til en unik udgående port. I tilfælde af belastningsfordeler NLB — Network Load Balancer, skal data strømmen altid ledes til den samme målvært. Security Groups er en tilstandbevarende firewall. Den overvåger indgående trafik og åbner implicit porter for den udgående strøm af pakker.
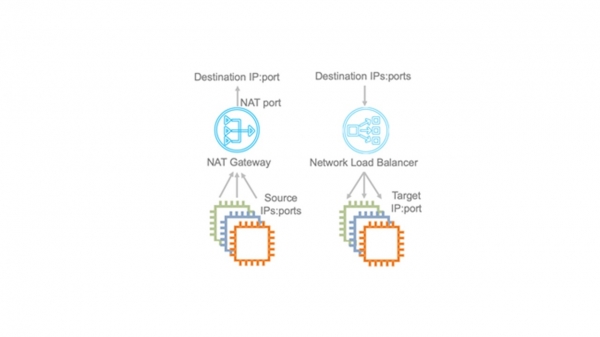
I AWS-miljøet er kravene til overførselstid ekstremt høje. Derfor HyperPlane er kritisk for netværkets samlede funktionalitet.
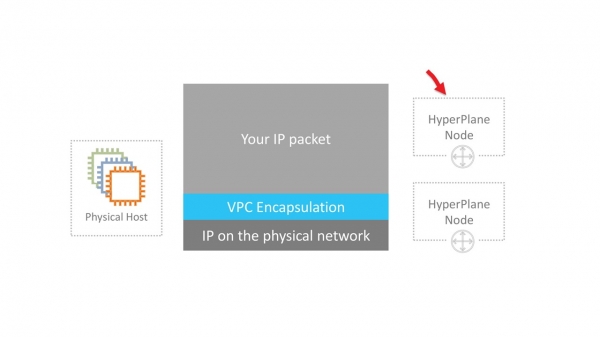
Hyperplane er bygget på EC2 virtuelle maskiner. Her er der ikke nogen magi, kun snedighed. Snedigheden ligger i, at det er virtuelle maskiner med meget RAM. Transaktionerne udføres udelukkende i hukommelsen. Dette muliggør latenser på kun ti mikrosekunder. Arbejde med disk ville dræbe al ydeevne.
Hyperplane er et distribueret system bestående af en kæmpe mængde af sådanne EC2-maskiner. Hver virtuel maskine har en båndbredde på 5 GB/s. På tværs af hele det regionale netværk betyder dette vanvittige terabits af båndbredde og muliggør behandling af millioner af forbindelser pr. sekund.
HyperPlane arbejder kun med strømme. VPC-kapsling af pakker er helt gennemsigtig for den. Eventuel sårbarhed i denne interne tjeneste vil ikke kunne bryde VPC-isoleringen. Sikring varetages af de lavere niveauer.
Noisy neighbor
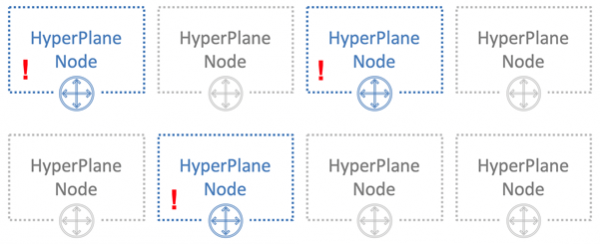
Der er også et problem med det støjende nabo — noisy neighbor. Lad os antage, at vi har 8 noder. Disse noder behandler strømmen fra alle brugere i skyen. Alt ser godt ud, og belastningen skal fordeles jævnt over alle noder. Noderne er meget kraftige, og det er svært at overbelaste dem.
Men vi bygger vores arkitektur med selv de usandsynlige scenarier i mente.
En lav sandsynlighed betyder ikke umulighed.
Vi kan forestille os en situation, hvor en eller flere brugere genererer en for stor belastning. Alle HyperPlane noder er involveret i behandlingen af denne belastning, og andre brugere kan potentiel opleve en form for nedsat ydeevne. Dette underminerer konceptet om skyer, hvor lejere ikke kan påvirke hinanden.
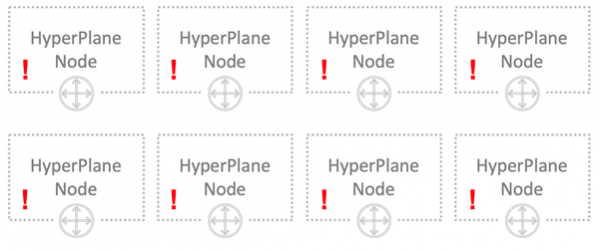
Hvordan løser vi problemet med
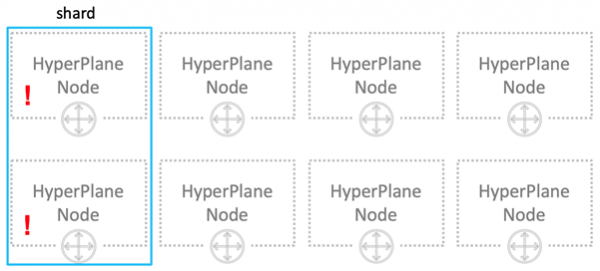
Lad os gøre det anderledes. Hver bruger får kun tildelt 3 noder.
Tricket er at tildele noder til forskellige brugere tilfældigt. På billedet nedenfor krydser den blå bruger noder med en af de to andre brugere - den grønne og den orange.
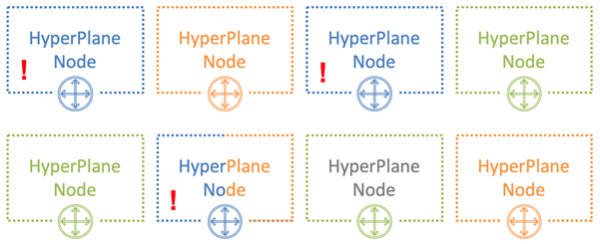
Med 8 noder og 3 brugere er sandsynligheden for, at den støjende nabo krydser med en af brugerne, 54%. Den blå bruger vil med den sandsynlighed påvirke andre lejere. Dette vil dog kun være en del af deres samlede belastning. I vores eksempel vil denne indflydelse kun være mærkbar for en tredjedel af alle brugere. Det er allerede et godt resultat.
Antallet af brugere, der krydser hinanden
Sandsynlighed i procent
0
18%
1
54%
2
26%
3
2%
Lad os nærme os situationen realistisk - lad os tage 100 noder og 5 brugere på 5 noder. I dette tilfælde vil ingen af noderne krydse hinanden med en sandsynlighed på 77%.
Antallet af brugere, der krydser hinanden
Sandsynlighed i procent
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
I en virkelig situation, med et stort antal HyperPlane noder og brugere, er den potentielle indflydelse fra den støjende nabo på andre brugere minimal. Denne metode kaldes shuffle sharding — . Den minimerer den negative effekt af noder, der fejler.Der er bygget mange tjenester på HyperPlane: Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
Netværkets skala
Netværkets skala
Lad os tale om omfanget af selve netværket. Fra oktober 2019 tilbyder AWS sine tjenester i 22 regioner, og der er planlagt yderligere 9.
- Hver region indeholder flere tilgængelighedszoner - Availability Zone. I alt er der 69 verden over.
- Hver AZ består af datacentre. Der er højst 8 af dem.
- I datacentrene findes et enormt antal servere, nogle steder op til 300.000.
Lad os nu samle alt dette, multiplicere og få et imponerende tal, som viser omfanget af Amazon Cloud.
Mellem tilgængelighedszonerne og datacentrene er der mange optiske kabler. I en af vores største regioner er der kun for forbindelse mellem AZ og kommunikationscentre til andre regioner (Transit Centers) lagt 388 kanaler. I alt giver det vanvittige 5000 Tbps.
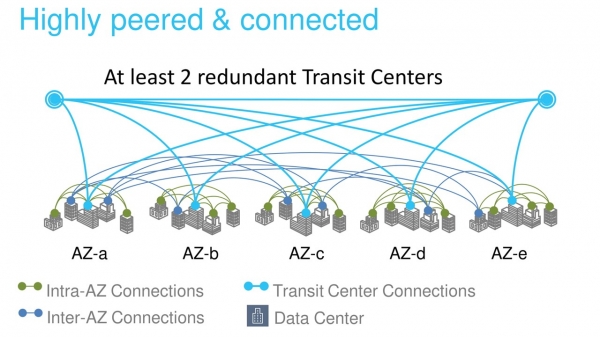
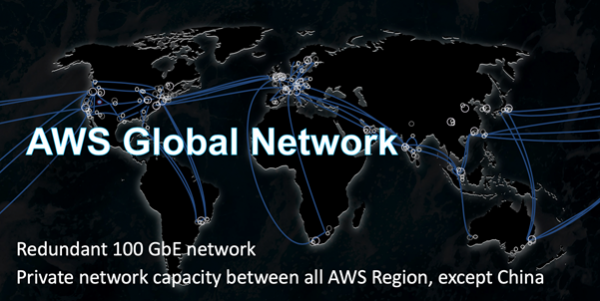
AWS-backbone er bygget specielt til skyen og optimeret til at arbejde med den. Vi bygger det på kanaler 100 Gbps. Vi har fuld kontrol over dem, undtagen i regionerne i Kina. Trafikken deles ikke med belastninger fra andre virksomheder.
Selvfølgelig er vi ikke den eneste cloud-udbyder med et privat backbone-netværk. Flere og flere store virksomheder vælger denne vej. Dette bekræftes af uafhængige forskere, for eksempel fra .
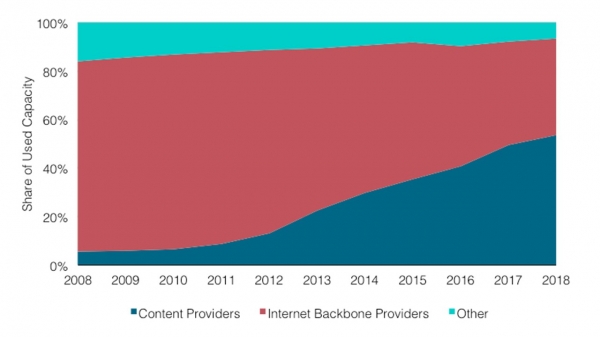
På grafen kan man se, at andelen af indholdsudbydere og cloud-udbydere vokser. På grund af dette falder andelen af internettrafik fra backbone-udbydere konstant.
Jeg vil forklare, hvorfor dette sker. Tidligere var de fleste webtjenester tilgængelige og blev forbrugt direkte fra internettet. Nu er flere og flere servere placeret i skyen og er tilgængelige via CDN — Content Distribution Network. For at få adgang til ressourcen går brugeren gennem internettet kun til den nærmeste CDN PoP - Point of Presence. Ofte er dette et sted i nærheden. Derefter forlader det det offentlige internet og flyver over Atlanterhavet via privat backbone og når direkte ressourcen.
Det er interessant at tænke på, hvordan internettet vil ændre sig om 10 år, hvis denne tendens fortsætter?
Fysiske kanaler
Forskere har endnu ikke fundet ud af, hvordan man kan øge lysets hastighed i universet, men de har gjort betydelige fremskridt i metoder til at overføre det gennem fiberkabler. I øjeblikket bruger vi kabler med 6912 fiber. Dette hjælper med at optimere omkostningerne ved deres installation betydeligt.
I nogle regioner er vi nødt til at bruge specielle kabler. For eksempel i regionen Sydney bruger vi kabler med en speciel belægning mod termitter.
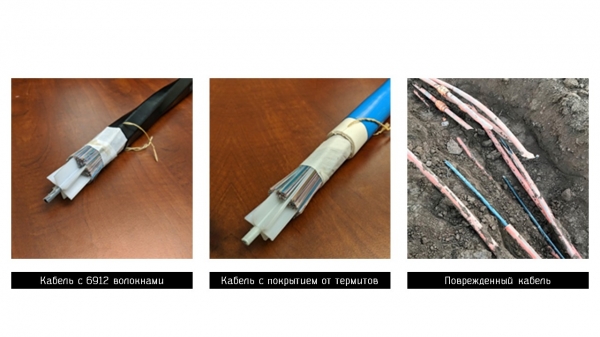
Ingen er beskyttet mod uheld, og nogle gange bliver vores kanaler beskadiget. På billedet til højre ses optiske kabler i en af de amerikanske regioner, som blev revet over af byggefirmaer. Som følge af ulykken gik der kun 13 datapakker tabt, hvilket er fantastisk. Igen – kun 13! Systemet skiftede bogstaveligt talt øjeblikkeligt til reservedele – skalaen fungerer.
Vi har hurtig gennemgået nogle af Amazons cloud-tjenester og -teknologier. Jeg håber, at du i det mindste har fået et indtryk af omfanget af de opgaver, vores ingeniører står over for. Personligt synes jeg, det er meget spændende.
Dette er den afsluttende del i trilogien af Vasily Pantyukhin om AWS's arkitektur. I del beskrives optimering af servere og skaleringsdatabase, og i den – serverless-funktioner og Firecracker.
På I november vil Vasily Pantyukhin dele nye detaljer om Amazons design. Han vil tale om årsagerne til fejl og design af distribuerede systemer i Amazon. Den 24. oktober er der stadig mulighed for en billet til en god pris, og betale senere. Vi ser frem til at se dig på HighLoad++, kom forbi og lad os snakke!
Kilde: habr.com
