

Hej, Habr! Lige nu er der åbent for tilmelding til et nyt hold af kurset hos OTUS. I forklaringen af kursusstarten har vi traditionelt forberedt en oversættelse af spændende materiale til dig.
Hver dag besøger over hundrede millioner mennesker Twitter for at finde ud af, hvad der sker i verden, og diskutere det. Hver tweet og enhver anden brugerhandling genererer et event, der er tilgængeligt for intern dataanalyse i Twitter. Hundredvis af medarbejdere analyserer og visualiserer disse data, og at forbedre deres oplevelse er en hovedprioritet for Twitter Data Platform.
Vi mener, at brugere med en bred vifte af tekniske færdigheder bør have mulighed for at finde data og få adgang til velfungerende analyse- og visualiseringsværktøjer baseret på SQL. Dette ville give en helt ny gruppe af brugere med mindre teknisk baggrund, herunder dataanalytikere og produktmanagere, mulighed for at udtrække indsigt fra data og derved hjælpe dem med bedre at forstå og udnytte mulighederne hos Twitter. På den måde demokratiserer vi dataanalyse i Twitter.
Efterhånden som vi forbedrer vores værktøjer og muligheder for intern dataanalyse, har vi set forbedringer i Twitter-tjenesten. Der er dog stadig plads til vækst. De nuværende værktøjer, såsom Scalding, kræver programmeringserfaring. SQL-baserede analyseværktøjer som Presto og Vertica har problemer med skalerbarhed. Vi har også en udfordring med distribution af data på tværs af flere systemer uden konstant adgang til dem.
I sidste år offentliggjorde vi , hvor vi flytter dele af vores til Google Cloud Platform (GCP). Vi har konkluderet, at Google Cloud-værktøjer kan støtte os i vores bestræbelser på at demokratisere analyse, visualisering og maskinlæring i Twitter:
- : et datalager med en SQL-motor baseret på , som er kendt for sin hurtighed, enkelhed og evne til at håndtere .
- et værktøj til visualisering af big data med samarbejdsfunktioner ligesom i Google Docs.
I denne artikel vil du lære om vores erfaring med disse værktøjer: hvad vi har gjort, hvad vi har lært, og hvad vi vil gøre næste gang. Nu vil vi fokusere på batch- og interaktiv analyse. Realtidsanalyse vil vi diskutere i den næste artikel.
Historien om datalagre i Twitter
Før vi dykker ned i BigQuery, er det værd at opsummere historien om datalagre på Twitter. I 2011 blev dataanalyse på Twitter udført med Vertica og Hadoop. Til at skabe MapReduce arbejdede vi med Hadoop ved hjælp af Pig. I 2012 skiftede vi fra Pig til Scalding, som havde et Scala API med fordele såsom muligheden for at skabe komplekse pipelines og enkle tests. Ikke desto mindre var dette en stejl læringskurve for mange dataanalytikere og produktchefer, der følte sig mere komfortable med at arbejde med SQL. Omkring 2016 begyndte vi at bruge Presto som SQL-grænseflade til Hadoop-data. Spark tilbød en Python-grænseflade, som gør det til et godt valg til ad hoc dataforskning og maskinlæring.
Siden 2018 har vi brugt følgende værktøjer til dataanalyse og visualisering:
- Scalding til produktions-pipelines
- Scalding og Spark til ad hoc dataanalyse og maskinlæring
- Vertica og Presto til ad hoc og interaktiv SQL-analyse
- Druid til lille interaktiv, udforskende og lav-latens adgang til tidsseriemetrikker
- Tableau, Zeppelin og Pivot til datavisualisering
Vi har fundet ud af, at selvom disse værktøjer tilbyder meget kraftfulde muligheder, har vi haft vanskeligheder med at implementere tilgængeligheden af disse muligheder for en bredere målgruppe på Twitter. Ved at udvide vores platform med Google Cloud fokuserer vi på at forenkle vores analysetools for hele Twitter.
BigQuery datalager fra Google
Flere teams på Twitter har allerede integreret BigQuery i nogle af deres produktions-pipelines. Ved at bruge deres erfaring begyndte vi at vurdere mulighederne for BigQuery til alle brugsscenarier på Twitter. Vores mål var at tilbyde BigQuery til hele virksomheden samt at standardisere og vedligeholde det som en del af Data Platform-værktøjssættet. Dette var vanskeligt af flere grunde. Vi var nødt til at udvikle infrastrukturen til pålidelig håndtering af store datamængder, understøtte datahåndtering på virksomhedsniveau, sikre korrekt adgangskontrol og beskytte kundernes privatliv. Vi måtte også oprette systemer til ressourcedistribution, overvågning og fakturering, så teams kunne bruge BigQuery effektivt.
I november 2018 frigav vi alfa-versionen af BigQuery og Data Studio til hele virksomheden. Vi tilbød vores medarbejdere på Twitter nogle af vores mest anvendte tabeller med rensede persondata. Over 250 brugere fra forskellige teams, herunder ingeniør-, finans- og marketingafdelinger, anvendte BigQuery. For nylig udførte de cirka 8.000 forespørgsler, der behandlede omkring 100 PB om måneden, exklusive planlagte forespørgsler. Efter at have modtaget meget positive tilbagemeldinger besluttede vi at gå videre og tilbyde BigQuery som en primær ressource til datainteraktion i Twitter.
Her er diagrammet for den højniveau arkitektur af vores datalager Google BigQuery.
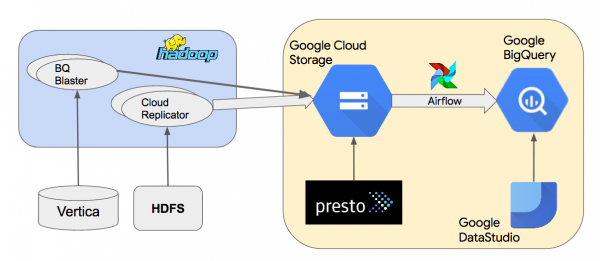
Vi kopierer data fra lokale Hadoop-klynger til Google Cloud Storage (GCS) ved hjælp af et internt værktøj, Cloud Replicator. Derefter bruger vi Apache Airflow til at oprette pipelines, der bruger “” til at indlæse data fra GCS til BigQuery. Vi bruger Presto til at forespørge datasæt i Parquet eller Thrift-LZO i GCS. BQ Blaster er et internt Scalding værktøj til at indlæse datasæt fra HDFS Vertica og Thrift-LZO til BigQuery.
I de følgende sektioner vil vi diskutere vores tilgang og viden om brugervenlighed, ydeevne, datastyring, systemets driftssikkerhed og omkostninger.
Brugervenlighed
Vi har opdaget, at det var let for brugerne at komme i gang med BigQuery, da det ikke krævede installation af software, og brugerne kunne få adgang til det via et intuitivt webgrænseflade. Alligevel måtte brugerne sætte sig ind i nogle funktioner i GCP og dets begreber, herunder ressourcer som projekter, datasæt og tabeller. Vi udviklede undervisningsmateriale og vejledninger for at hjælpe brugerne i gang. Med en grundlæggende forståelse blev det nemt for brugere at navigere i datasæt, se skemaer og tabeldata, udføre enkle forespørgsler og visualisere resultaterne i Data Studio.
Vores mål for dataindlæsning til BigQuery var at sikre en problemfri indlæsning af datasæt fra HDFS eller GCS med et enkelt klik. Vi overvejede (styrt Airflow), men kunne ikke bruge det på grund af vores sikkerhedsmodel "Domain Restricted Sharing" (se mere om dette i afsnittet "Data Management" nedenfor). Vi eksperimenterede med at bruge Google Data Transfer Service (DTS) til at organisere arbejdsbelastninger i BigQuery. Mens DTS hurtigt blev konfigureret, var det ikke fleksibelt nok til at opbygge pipelines med afhængigheder. Til vores alpha-version skabte vi vores egen Apache Airflow-miljø i GCE og forbereder det til drift og til at kunne understøtte flere datakilder, såsom Vertica.
For at transformere data til BigQuery opretter brugerne enkle SQL-datapipelines ved hjælp af planlagte forespørgsler. For komplekse flerstegs-pipelines med afhængigheder planlægger vi at bruge enten vores egen Airflow-infrastruktur eller Cloud Composer sammen med .
Ydeevne
BigQuery er designet til generelle SQL-forespørgsler, der behandler store mængder data. Det er ikke beregnet til forespørgsler med lav latens og høj gennemstrømning, som er nødvendige for transaktionelle databaser, eller til analyse af tidsserier med lav latens, implementeret . For interaktive analytiske forespørgsler forventer vores brugere en svartid på under et minut. Vi måtte designe brugen af BigQuery, så den kunne overholde disse forventninger. For at sikre en forudsigelig ydeevne for vores brugere brugte vi BigQuery's funktionalitet, der er tilgængelig for kunder på fast betaling, som gør det muligt for projekttere at reservere minimum slots til deres forespørgsler. BigQuery er en enhed for compute-kraft, der er nødvendig for at udføre SQL-forespørgsler.
Vi har analyseret over 800 forespørgsler, der behandler cirka 1 TB data hver, og fundet ud af, at den gennemsnitlige behandlingstid var 30 sekunder. Vi fandt også, at ydeevnen i høj grad afhænger af brugen af vores slot i forskellige projekter og opgaver. Vi måtte klart adskille vores produktions- og ad hoc slotreservater for at opretholde ydeevnen for produktionsscenarier og interaktiv analyse. Dette har haft en stor indflydelse på vores design til slotreservation og projekt hierarki.
Om datahåndtering, funktionalitet og omkostninger ved systemerne, skal vi tale i løbet af de kommende dage i den anden del af oversættelsen, men nu inviterer vi alle interesserede til , hvor du kan lære mere om kurset og stille spørgsmål til vores ekspert — Egor Mateshuk (Senior Data Engineer, MaximaTelecom).
Læs mere:
Kilde: habr.com
