

Hvis du arbejder med Kubernetes, er kubectl sandsynligvis et af de mest anvendte værktøjer for dig. Hver gang du bruger meget tid på at arbejde med et bestemt værktøj, er det værd at sætte sig ind i det og lære at bruge det effektivt.
Kommandoen oversatte Daniel Weibel's artikel, hvor du finder tips og tricks til effektivt at arbejde med kubectl. Den vil også hjælpe dig med at få en dybere forståelse af, hvordan Kubernetes fungerer.
Ifølge forfatteren er målet med artiklen at gøre dit daglige arbejde med Kubernetes både mere effektivt og mere behageligt!
Introduktion: Hvad er kubectl
Inden du lærer at bruge kubectl mere effektivt, skal du have en grundlæggende forståelse af, hvad det er, og hvordan det fungerer.
Set fra brugerens perspektiv er kubectl et styresystem, der gør det muligt at udføre operationer i Kubernetes.
Set fra et teknisk synspunkt er kubectl en Kubernetes API-klient.
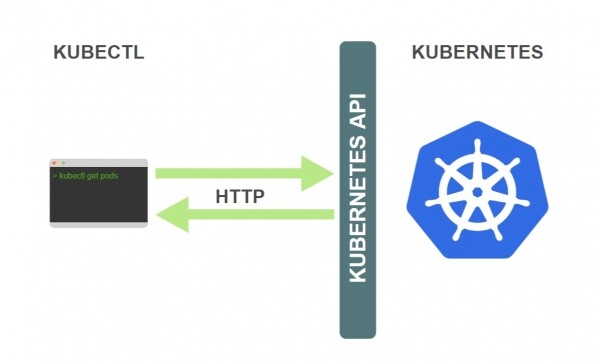
Kubernetes API er et HTTP REST API. Dette API er det faktiske brugergrænseflade for Kubernetes, som det hele styres gennem. Det betyder, at hver Kubernetes-operation præsenteres som en API-endepunkt og kan udføres ved at sende en HTTP-forespørgsel til det endepunkt.
Derfor er hovedopgaven for kubectl at udføre HTTP-anmodninger til Kubernetes API:
Kubernetes er et fuldt ressourceorienteret system. Det betyder, at det opretholder den interne tilstand af ressourcer, og alle Kubernetes-operationer er CRUD-operationer.
Du har fuld kontrol over Kubernetes ved at styre disse ressourcer, og Kubernetes finder ud af, hvad der skal gøres baseret på den aktuelle tilstand af ressourcerne. Af denne grund er henvisningen til Kubernetes API organiseret som en liste over ressourcetyper med tilknyttede operationer.
Lad os se på et eksempel.
Lad os sige, at du ønsker at oprette en ReplicaSet-ressource. For at gøre dette beskriver du ReplicaSet i en fil ved navn replicaset.yaml, og derefter kører du kommandoen:
$ kubectl create -f replicaset.yamlSom et resultat vil en ReplicaSet-ressource blive oprettet. Men hvad sker der bag kulisserne?
I Kubernetes er der en oprettelsesoperation for ReplicaSet. Ligesom enhver anden operation tilbydes den som et API-endepunkt. Det specifikke API-endepunkt for denne operation ser sådan ud:
POST /apis/apps/v1/namespaces/{namespace}/replicasetsAPI-endepunkterne for alle Kubernetes-operationer kan findes i (inklusive ). For an actual request to the endpoint, you must first add the API server URL to the endpoint paths listed in the API reference.
Therefore, when you execute the command mentioned above, kubectl sends an HTTP POST request to the aforementioned API endpoint. The definition of the ReplicaSet that you specified in the file replicaset.yaml, is passed in the body of the request.
This is how kubectl works for all commands that interact with the Kubernetes cluster. In all these cases, kubectl simply sends HTTP requests to the corresponding Kubernetes API endpoints.
Note that you can manage Kubernetes entirely with a utility like curl, manually sending HTTP requests to the Kubernetes API. Kubectl just simplifies the use of the Kubernetes API.
This is the basics of what kubectl is and how it works. But there is more about the Kubernetes API that every kubectl user should know. Let's briefly dive into the inner workings of Kubernetes.
The inner workings of Kubernetes
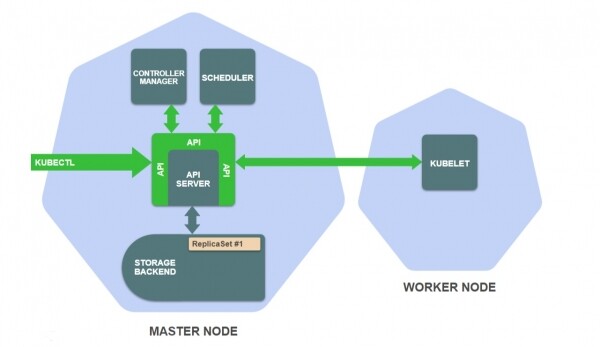
Kubernetes consists of a set of independent components that operate as separate processes on the cluster nodes. Some components run on master nodes, while others run on worker nodes, with each component performing its specific task.
Here are the most important components on the master nodes:
- Lagring — stores resource definitions ().
- API server — provides the API and manages the storage.
- Controller manager — ensures that resource statuses match specifications.
- Scheduler — schedules pods on worker nodes.
And here is one of the most important components on the worker nodes:
- usageNanoCores — manages the launching of containers on the worker node.
To understand how these components work together, let’s consider an example.
Suppose you just executed kubectl create -f replicaset.yaml, after which kubectl made an HTTP POST request to the (passing the definition of the ReplicaSet resource).
What happens in the cluster?
- After execution,
kubectl create -f replicaset.yamlthe API server saves your ReplicaSet resource definition to the storage:
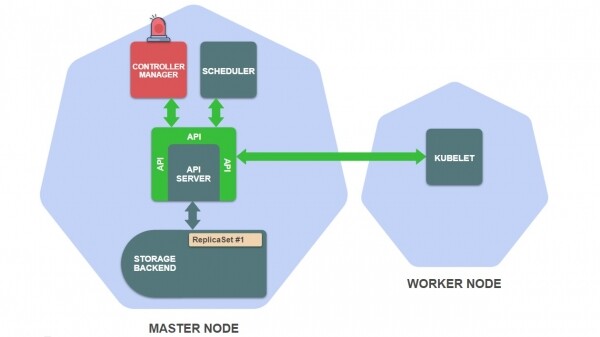
- Next, the ReplicaSet controller is activated in the controller manager, which handles the creation, updating, and deleting of ReplicaSet resources:

- The ReplicaSet controller creates a pod definition for each ReplicaSet replica (according to the pod template in the ReplicaSet definition) and saves them to the storage:

- Planlæggeren, der overvåger pods, som endnu ikke er tildelt nogen arbejdsnode, starter.

- Planlæggeren vælger en passende arbejdsnode til hver pod og tilføjer denne information til pod-definitionen i lageret.
- På arbejdsnode, som en pod er tildelt, startes Kubelet, der overvåger pods, der er tildelt denne node.

- Kubelet læser pod-definitionen fra lageret og giver kommandoer til container runtime, såsom Docker, om at starte containere på noden.

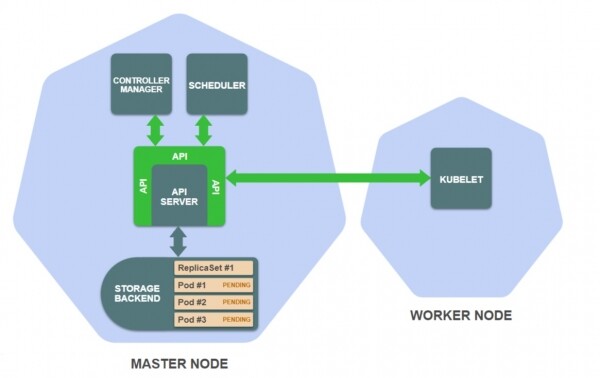
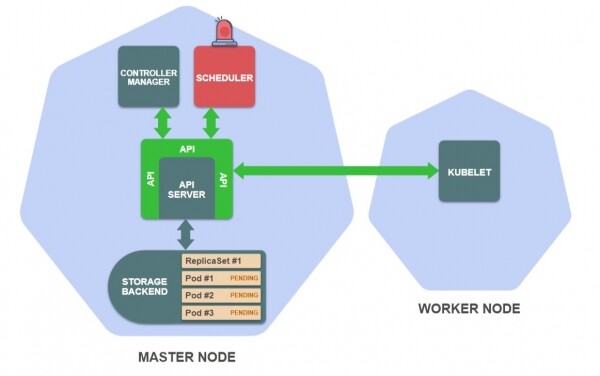
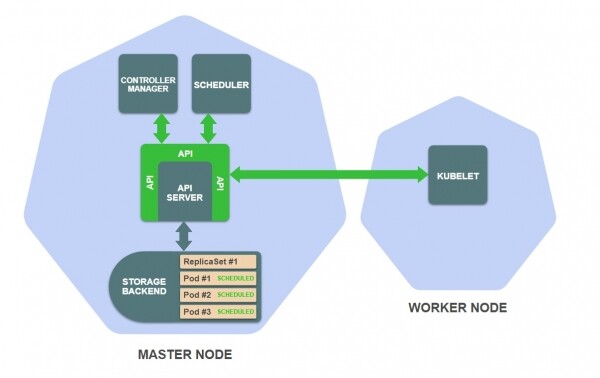
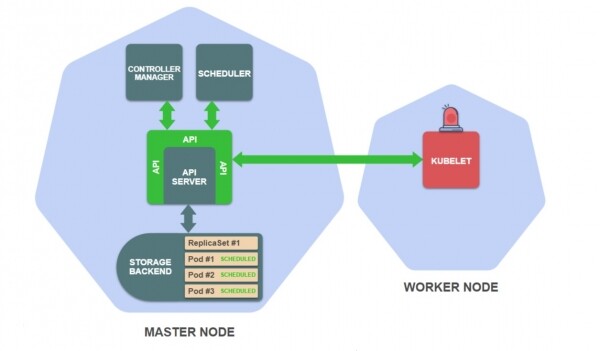
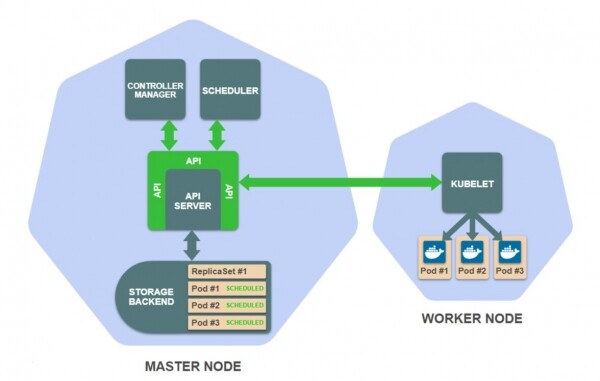
Her er en tekstversion af denne beskrivelse.
Et API-anmodning til endpoint for oprettelse af ReplicaSet håndteres af API-serveren. API-serveren godkender anmodningen og gemmer definitionen af ressource ReplicaSet i lageret.
Denne hændelse starter ReplicaSet-controlleren, som er en underproces af controller-manageren. ReplicaSet-controlleren holder øje med oprettelse, opdatering og sletning af ReplicaSet-ressourcer i lageret og modtager en meddelelse om hændelsen, når dette sker.
Opgaven for ReplicaSet-controlleren er at sikre, at der findes det nødvendige antal pods for ReplicaSet. I vores eksempel findes der endnu ingen pods, så ReplicaSet-controlleren opretter disse pod-definitioner (i henhold til pod-skabelonen i definitionen af ReplicaSet) og gemmer dem i lageret.
Oprettelse af nye pods starter planlæggeren, som overvåger pod-definitioner, der endnu ikke er planlagt til arbejdsnoder. Planlæggeren vælger en passende arbejdsnode til hver pod og opdaterer pod-definitioner i lageret.
Bemærk, at indtil dette punkt er der ikke blevet udført nogen kode for arbejdsbelastningen i klyngen. Alt, hvad der er blevet gjort indtil nu, — er oprettelse og opdatering af ressourcer i lageret på hovednoden.
Den sidste hændelse starter Kubelet, som overvåger pods, der er planlagt til deres arbejdsnoder. Kubelet på arbejdsnoden, som dine pods for ReplicaSet er installeret på, skal instruere container runtime, såsom Docker, til at downloade de nødvendige containerbilleder og starte dem.
På dette tidspunkt er dit ReplicaSet-app endelig startet!
API’ens rolle i Kubernetes
Som du så i det tidligere eksempel, overvåger Kubernetes-komponenter (med undtagelse af API-serveren og lageret) ændringer i ressourcerne i lageret og ændrer ressourcedataene i lageret.
Selvfølgelig interagerer disse komponenter ikke direkte med lageret, men kun gennem Kubernetes API.
Lad os overveje følgende eksempler:
- ReplicaSet-controlleren bruger API-endepunktet med parameteren
watchfor at overvåge ændringer i resources ReplicaSet. - ReplicaSet-controlleren bruger API-endepunktet (oprette pod) for at skabe pods.
- Planlæggeren bruger API-endepunktet (ændre pod) for at opdatere pods med information om den valgte arbejdsknude.
Som du kan se, er det den samme API, som kubectl henvender sig til. At bruge den samme API til at arbejde med interne komponenter og eksterne brugere er et grundlæggende designprincip for Kubernetes.
Nu kan vi opsummere, hvordan Kubernetes fungerer:
- Lageret gemmer tilstanden, det vil sige Kubernetes-resurser.
- API-serveren giver et interface til lageret i form af Kubernetes API.
- Alle andre komponenter og brugere af Kubernetes læser, overvåger og manipulerer tilstanden (ressourcerne) i Kubernetes gennem API'en.
At kende disse koncepter vil hjælpe med bedre at forstå kubectl og maksimere dets anvendelse.
Lad os nu se på en række specifikke tips og tricks, der kan forbedre din brug af kubectl.
1. Hurtigere input med kommandoudvidelse
En af de mest nyttige, men ofte oversete metoder til at øge effektiviteten med kubectl er kommandoudvidelse.
Kommandoudvidelse muliggør automatisk udfyldning af dele af kubectl-kommandoer ved hjælp af Tab-tasten. Dette fungerer for underkommandoer, muligheder og argumenter, herunder komplekse som ressource-navne.
Se hvordan kommandoudvidelse fungerer i kubectl:
Kommandoudvidelse fungerer for Bash og Zsh shell.
indeholder detaljerede instruktioner til opsætning af autoudvidelse, men vi vil her give et kort resumé.
Hvordan kommandoudvidelse fungerer
Kommandoudvidelse er en shell-funktion, der fungerer via et udvidelsesscript. Udvidelsesscriptet er et shell-script, som definerer udvidelsesadfærden for en bestemt kommando.
Kubectl genererer automatisk og udskriver udvidelsesscripts for Bash og Zsh ved hjælp af følgende kommandoer:
$ kubectl completion bashEller:
$ kubectl completion zshTeoretisk set er det tilstrækkeligt at tilslutte output fra disse kommandoer til den relevante kommandoshell, så kubectl kan udvide kommandoerne.
I praksis adskiller forbindelsesmetoden sig for Bash (inklusive forskelle mellem Linux og MacOS) og Zsh. Nedenfor vil vi se på alle disse muligheder.
Bash på Linux
Bash-udvidelsesscriptet afhænger af pakken bash-completion, så det er nødvendigt først at installere det:
$ sudo apt-get install bash-completionEller:
$ yum install bash-completionDu kan teste, om pakken er korrekt installeret med følgende kommando:
$ type _init_completion Hvis der vises kode til shell-funktionen, er bash-completion korrekt installeret. Hvis kommandoen giver fejlmeddelelsen "Ikke fundet", skal du tilføje følgende linje til din fil ~ / .bashrc:
$ source /usr/share/bash-completion/bash_completion Om denne linje skal tilføjes til filen ~ / .bashrc eller ej afhænger af den pakkeadministrator, du har brugt til at installere bash-completion. For APT er det nødvendigt, for YUM er det ikke.
Efter installationen af bash-completion skal du konfigurere alt, så kubectl-udvidelsesscriptet er aktivt i alle shell-sessioner.
En måde at gøre dette på er at tilføje følgende linje til filen ~ / .bashrc:
source <(kubectl completion bash) En anden måde er at tilføje kubectl-udvidelsesscriptet til kataloget /etc/bash_completion.d (opret det, hvis det ikke eksisterer):
$ kubectl completion bash > /etc/bash_completion.d/kubectl Alle udvidelsesscripts i katalogen /etc/bash_completion.d aktiveres automatisk i bash-completion.
Begge muligheder er lige anvendelige.
Efter genstart af kommandolinjen vil autoudførelse af kubectl-kommandoer fungere.
Bash på MacOS
På MacOS er opsætningen en smule mere kompliceret. Problemet er, at MacOS som standard bruger Bash version 3.2, og autoudførelserne for kubectl kræver en version af Bash, der ikke er lavere end 4.1, og fungerer ikke på Bash 3.2.
Brugen af den forældede version af Bash i MacOS skyldes licensproblemer. Bash version 4 distribueres under GPLv3-licensen, som Apple ikke understøtter.
For at konfigurere autoudførelse af kubectl i MacOS skal du installere en nyere version af Bash. Du kan også installere den opdaterede Bash som din standard kommando-shell, hvilket vil forhindre mange problemer i fremtiden. Det er ikke svært; detaljerne er angivet i artiklen "».
Før du fortsætter, skal du sikre dig, at du bruger en nyere version af Bash (kontroller output bash --version).
Autoudførelsesscriptet i Bash afhænger af projektet , så det er nødvendigt først at installere det.
Du kan installere bash-completion ved hjælp af :
$ brew install bash-completion@2 Her @2 angiver bash-completion version 2. Autoudfyldning af kubectl kræver bash-completion v2, og bash-completion v2 kræver Bash version minimum 4.1.
Output fra kommandoen brew-install indeholder en sektion Caveats, hvor det er angivet, at du skal tilføje til filen ~/ .bash_profile:
export BASH_COMPLETION_COMPAT_DIR=/usr/local/etc/bash_completion.d
[[ -r "/usr/local/etc/profile.d/bash_completion.sh" ]] && .
"/usr/local/etc/profile.d/bash_completion.sh"
Men jeg anbefaler at tilføje disse linjer ikke i ~/ .bash_profile, og der sendes noget til den, vil flytning af denne task til sektionen ~\/ .bashrc. I så fald vil autoudfyldningen være tilgængelig ikke kun i den primære, men også i underliggende kommandoskaller.
Efter genstart af kommandoskallen kan du kontrollere installationskorrekthed ved hjælp af følgende kommando:
$ type _init_completionHvis du ser shell-funktionen i outputtet, så er alt sat op korrekt.
Nu skal du sørge for, at autoudfyldningen af kubectl er aktiveret i alle sessioner.
En måde at gøre dette på er at tilføje følgende linje til din ~\/ .bashrc:
source <(kubectl completion bash) Anden metode er at tilføje autoudfyldningsscriptet til mappen /usr/local/etc/bash_completion.d:
$ kubectl completion bash
>/usr/local/etc/bash_completion.d/kubectl
Denne metode vil kun fungere, hvis du har installeret bash-completion ved hjælp af Homebrew. I så fald indlæser bash-completion alle scripts fra denne mappe.
Hvis du har installeret , er det ikke nødvendigt at udføre det forrige trin, da autoudfyldningsscriptet automatisk vil blive placeret i mappen /usr/local/etc/bash_completion.d under installationen. I så fald vil autoudfyldningen af kubectl begynde at fungere, så snart du installerer bash-completion.
Som et resultat er alle disse muligheder ækvivalente.
Zsh
Autoudfyldningsscripts til Zsh kræver ingen afhængigheder. Alt hvad du skal gøre, er at aktivere dem ved indlæsning af kommandoskallen.
Du kan gøre dette ved at tilføje linjen til din ~/ .zshrc file:
source <(kubectl completion zsh) Hvis du fik en fejl not found: compdef efter genstart af din shell, skal du aktivere den indbyggede funktion compdef. Den kan aktiveres ved at tilføje i starten af din fil ~/ .zshrc følgende:
autoload -Uz compinit
compinit
2. Hurtig gennemgang af ressource-specifikationer
Når du opretter YAML-resursedefinitioner, skal du vide felterne og deres værdier for disse ressourcer. Et sted at finde denne information er i API-håndbogen, som indeholder fulde specifikationer for alle ressourcer.
Men det er besværligt at skifte til webbrowseren hver gang, du skal søge efter noget. Derfor giver kubectl en kommando kubectl explain, som viser specifikationerne for alle ressourcer direkte i din terminal.
Kommandoformatet er følgende:
$ kubectl explain resource[.field]...Holdet vil vise specifikationen for den ønskede ressource eller felt. Den viste information er identisk med den, der findes i API-guiden.
By default kubectl explain viser kun første niveau af feltindlejring.
Se hvordan det ser ud .
Hele træet kan vises ved at tilføje muligheden --recursive:
$ kubectl explain deployment.spec --recursiveHvis du ikke præcist ved, hvilke ressourcer der er nødvendige, kan du vise dem alle med følgende kommando:
$ kubectl api-resources Denne kommando viser navne på ressourcer i flertalsform, for eksempel deployments i stedet for deployment. Den viser også det korte navn, for eksempel deploy, for de ressourcer som har det. Bekymr dig ikke om disse forskelle. Alle disse navneformer er ækvivalente for kubectl. Det vil sige, at du kan bruge dem alle til kubectl explain.
Alle nedenstående kommandoer er ækvivalente:
$ kubectl explain deployments.spec
# eller
$ kubectl explain deployment.spec
# eller
$ kubectl explain deploy.spec
3. Brug brugerdefineret outputformat for kolonner
Som standard er outputformatet for kommandoen kubectl get:
$ kubectl get pods
NAVN                     KLAR    STATUS    GENSTARTS  ALDER
engine-544b6b6467-22qr6   1/1     Kørende     0       78d
engine-544b6b6467-lw5t8   1/1     Kørende     0       78d
engine-544b6b6467-tvgmg   1/1     Kørende     0       78d
web-ui-6db964458-8pdw4    1/1     Kørende     0       78d
Dette format er praktisk, men indeholder et begrænset antal informationer. I forhold til det fulde ressortformat vises der kun et par felter.
I dette tilfælde kan du bruge brugerdefineret outputformat for kolonner. Det gør det muligt at definere, hvilke data der skal vises. Du kan udskrive ethvert ressourcefelt i en separat kolonne.
Brugen af brugerdefineret format bestemmes med følgende muligheder:
-o custom-columns=:[,:]... Du kan definere hver outputkolonne med et par <jsonpath> — udtrykket, der definerer ressourcefeltet.
Lad os se et enkelt eksempel:
$ kubectl get pods -o custom-columns='NAVN:metadata.name'

NAVN
engine-544b6b6467-22qr6
engine-544b6b6467-lw5t8
engine-544b6b6467-tvgmg
web-ui-6db964458-8pdw4
Outputtet indeholder én kolonne med pod-navne.
Udtrykket i optionen vælger pod-navne fra feltet metadata.name. Dette skyldes, at pod-navnet defineres i det underliggende felt name i feltet metadata i beskrivelsen af ressourcen for pod'en. Du kan læse mere i eller indtaste kommandoen kubectl explain pod.metadata.name.
Antag at du vil tilføje en ekstra kolonne til output, som for eksempel viser, hvilken node hver pod kører på. For at gøre dette kan du blot tilføje den relevante kolonnenspecifikation i indstillingen for brugerdefinerede kolonner:
$ kubectl get pods
  -o custom-columns='NAME:metadata.name,NODE:spec.nodeName'

NAME                       NODE
engine-544b6b6467-22qr6    ip-10-0-80-67.ec2.internal
engine-544b6b6467-lw5t8    ip-10-0-36-80.ec2.internal
engine-544b6b6467-tvgmg    ip-10-0-118-34.ec2.internal
web-ui-6db964458-8pdw4     ip-10-0-118-34.ec2.internal
Udsagnet vælger navnet på noden fra spec.nodeName — når en pod tildeles til en node, skrives dens navn ind i feltet spec.nodeName ressourcespecifikationen for pod'en. Yderligere information kan ses i outputtet af kubectl explain pod.spec.nodeName.
Bemærk, at Kubernetes resource-felter er case-sensitive.
Du kan se ethvert resource-felt i form af en kolonne. Gennemgå blot resource-specifikationen og prøv dig frem med enhver felter, du ønsker.
Men lad os først se nærmere på feltsvalgsudtryk.
JSONPath-udtryk
Udtryk til valg af resource-felter er baseret på .
JSONPath er et sprog til at udtrække data fra JSON-dokumenter. At vælge et enkelt felt er den mest grundlæggende brug af JSONPath. Det har meget , herunder vælgere, filtre og så videre.
Kubectl explain understøtter et begrænset antal JSONPath-funktioner. Nedenfor er mulighederne og eksempler på deres anvendelse:
# Выбрать все элементы списка
$ kubectl get pods -o custom-columns='DATA:spec.containers[*].image'
# Выбрать специфический элемент списка
$ kubectl get pods -o custom-columns='DATA:spec.containers[0].image'
# Выбрать элементы списка, попадающие под фильтр
$ kubectl get pods -o custom-columns='DATA:spec.containers[?(@.image!="nginx")].image'
# Выбрать все поля по указанному пути, независимо от их имени
$ kubectl get pods -o custom-columns='DATA:metadata.*'
# Выбрать все поля с указанным именем, вне зависимости от их расположения
$ kubectl get pods -o custom-columns='DATA:..image'
Operatøren [] har en særlig betydning. Mange Kubernetes resource-felter er lister, og denne operator gør det muligt at vælge elementer fra disse lister. Det bruges ofte med et wildcard som [*] for at vælge alle elementer i listen.
Eksempler på anvendelse
Mulighederne for at bruge brugerdefineret kolonne-outputformat er ubegrænsede, da du kan vise ethvert felt eller enhver kombination af felter fra ressourcen i output. Her er nogle anvendelseseksempler, men tøv ikke med at udforske dem selv og finde nyttige anvendelser for dig.
- Visning af containerbilleder for pods:
$ kubectl get pods
  -o custom-columns='NAME:metadata.name,IMAGES:spec.containers[*].image'

NAME                        IMAGES
engine-544b6b6467-22qr6     rabbitmq:3.7.8-management,nginx
engine-544b6b6467-lw5t8     rabbitmq:3.7.8-management,nginx
engine-544b6b6467-tvgmg     rabbitmq:3.7.8-management,nginx
web-ui-6db964458-8pdw4      wordpress
Denne kommando viser navnene på containerbillederne for hver pod.
Husk, at der kan være flere containere under, så billednavnene vil blive vist på én linje adskilt med komma.
- Visning af tilgængelighedszoner for noder:
$ kubectl get nodes
  -o
custom-columns='NAME:metadata.name,ZONE:metadata.labels.failure-domain.beta.kubernetes.io/zone'

NAME                          ZONE
ip-10-0-118-34.ec2.internal   us-east-1b
ip-10-0-36-80.ec2.internal    us-east-1a
ip-10-0-80-67.ec2.internal    us-east-1b
Denne kommando er praktisk, hvis din klynge er hostet i en offentlig sky. Den viser tilgængelighedszonen for hver node.
En tilgængelighedszone er et skybegreb, der begrænser replikationsområdet til en geografisk region.
Tilgængelighedszoner for hver node hentes gennem en specifik etikette — . Hvis klyngen kører i en offentlig sky, oprettes denne etikette automatisk og fyldes med navne på tilgængelighedszoner for hver node.
Etiketter er ikke en del af specifikationen af Kubernetes-ressourcer, så du finder ikke information om dem i . Men de kan ses (som enhver anden etiket), hvis du anmoder om oplysninger om noder i YAML- eller JSON-format:
$ kubectl get nodes -o yaml
# eller
$ kubectl get nodes -o json
Dette er en fremragende måde at lære mere om ressourcer på, ud over at studere ressource-specifikationerne.
4. Let skift mellem klynger og navnerum
Når kubectl foretager en forespørgsel til Kubernetes API, læser den først kubeconfig-filen for at hente alle nødvendige parametre til forbindelsen.
Som standard er kubeconfig-filen ~/.kube/config. Normalt oprettes eller opdateres denne fil med en særlig kommando.
Når du arbejder med flere klynger, indeholder din kubeconfig-fil forbindelsesparametre til alle disse klynger. Du har brug for en måde at angive til kubectl, hvilken specifik klynge du arbejder med.
Inden for klyngen kan du oprette flere navnerum — en slags virtuel klynge inden for den fysiske klynge. Kubectl bestemmer, hvilket navnerum der skal bruges, også ud fra kubeconfig-filen. Det betyder, at du også har brug for en måde at angive til kubectl, hvilket navnerum der skal arbejdes med.
I dette kapitel vil vi forklare, hvordan dette fungerer, og hvordan du opnår effektiv drift.
Bemærk, at du kan have flere kubeconfig-filer angivet i miljøvariablen KUBECONFIG. I så fald vil alle disse filer blive sammenflettet til én samlet konfiguration under kørsel. Du kan også ændre den standard kubeconfig-fil, der anvendes, ved at køre kubectl med parameteren --kubeconfig. Se .
Kubeconfig-filer
Lad os se, hvad kubeconfig-filen indeholder:
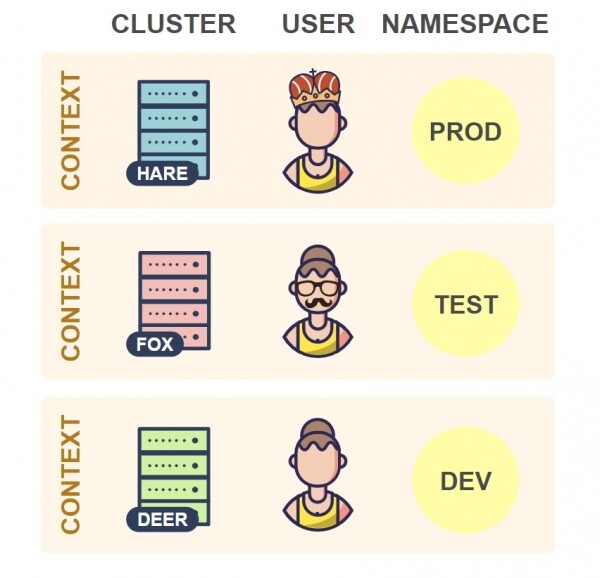
Som du kan se, indeholder kubeconfig-filen et sæt kontekster. En kontekst består af tre elementer:
- Cluster — URL til API-serveren for klyngen.
- User — autentificeringsoplysninger for brugeren i klyngen.
- Namespace — navnerum, der anvendes ved tilslutning til klyngen.
I praksis anvender man ofte en kontekst pr. klynge i sin kubeconfig-fil. Du kan dog have flere kontekster for en klynge, der adskiller sig efter bruger eller navnerum. En sådan konfiguration med flere kontekster forekommer sjældent, så der er normalt en entydig sammenhæng mellem klynger og kontekster.
På ethvert tidspunkt er en af konteksterne den aktuelle:
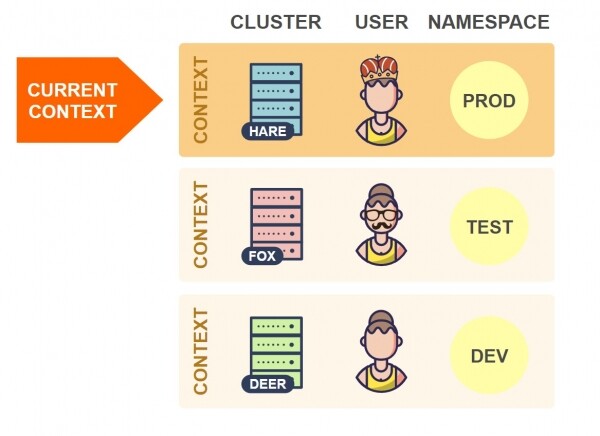
Når kubectl læser konfigurationsfilen, tages der altid information fra den aktuelle kontekst. I eksemplet ovenfor vil kubectl oprette forbindelse til klyngen Hare.
For at skifte til en anden klynge skal du ændre den aktuelle kontekst i kubeconfig-filen:
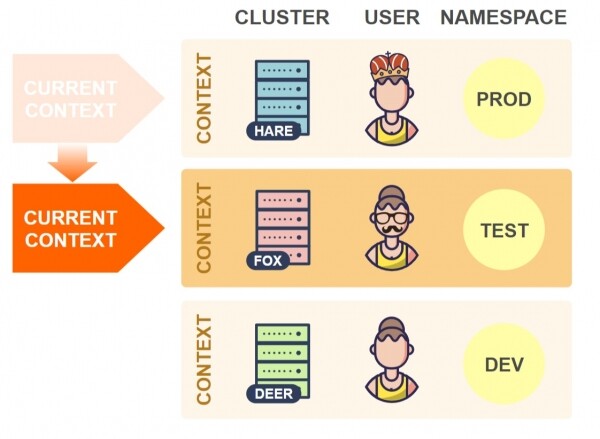
Nu vil kubectl oprette forbindelse til klyngen Fox.
For at skifte til et andet navnerum i den samme klynge, skal du ændre værdien for elementet namespace for den aktuelle kontekst:
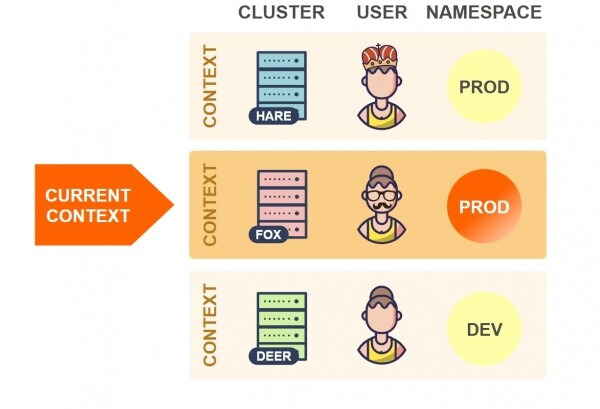
I det ovenstående eksempel vil kubectl bruge navnerummet Prod i klyngen Fox (det tidligere indstillede navnerum var Test).
Bemærk, at kubectl også tilbyder parametre --cluster, --user, --namespace og --context, som gør det muligt at overskrive individuelle elementer og den aktuelle kontekst, uanset hvad der er angivet i kubeconfig-filen. Se kubectl options.
Teoretisk set kan du manuelt ændre parametrene i kubeconfig-filen. Men det er ikke praktisk. For at forenkle disse operationer findes der forskellige værktøjer, der giver mulighed for at ændre parametrene automatisk.
Brug kubectx
Et meget populært værktøj til at skifte mellem klynger og navnerum.
Værktøjet tilbyder kommandoerne kubectx og kubens for at ændre den aktuelle kontekst og navnerum henholdsvis.
Som nævnt tidligere betyder ændring af den aktuelle kontekst at ændre clusteret, hvis du kun har én kontekst pr. cluster.
Her er et eksempel på udførelsen af disse kommandoer:
I bund og grund redigerer disse kommandoer blot kubeconfig-filen, som beskrevet ovenfor.
For at installere kubectx, følg instruktionerne på
Begge kommandoer understøtter autoudfyldelse af navne for kontekster og navnerum, så du ikke behøver at indtaste dem helt. Instruktioner til opsætning af autoudfyldelse .
En anden nyttig funktion kubectx Baggrunden indeholder tekstur af siden og illustrationer, og dens opløsning er lavere end maskens. Baggrunden gemmes tabsløst for opfattelse med en opløsning på 100 dpi. . Den fungerer sammen med værktøjet , som skal installeres separat. Installation af fzf gør interaktiv tilstand tilgængelig i kubectx. I interaktiv tilstand kan du vælge kontekst og navnerum gennem et interaktivt søgeinterface leveret af fzf.
Brug af shell-aliasser
Du har ikke brug for separate værktøjer til at ændre den aktuelle kontekst og navnerum, fordi kubectl også tilbyder kommandoer til dette. Så kommandoen kubectl config tilbyder underkommandoer til at redigere kubeconfig-filer.
Her er nogle af dem:
kubectl config get-contexts: viser alle kontekster;kubectl config current-context: får den aktuelle kontekst;kubectl config use-context: ændrer den aktuelle kontekst;kubectl config set-context: ændrer kontekstelementet.
Men det er ikke særlig praktisk at bruge disse kommandoer direkte, fordi de er lange. Du kan lave shell-aliasser for dem, som er nemme at udføre.
Jeg har oprettet et sæt aliasser baseret på disse kommandoer, som tilbyder funktionalitet svarende til kubectx. Her kan du se dem i aktion:
Bemærk, at aliasserne bruger fzf til at levere et interaktivt søgeinterface (som i den interaktive tilstand kubectx). Det betyder, at du skal , for at bruge disse aliasser.
Her er definitionerne af aliasserne:
# Получить текущий контекст
alias krc='kubectl config current-context'
# Список всех контекстов
alias klc='kubectl config get-contexts -o name | sed "s/^/  /;|^  $(krc)$|s/ /*/"'
# Изменить текущий контекст
alias kcc='kubectl config use-context "$(klc | fzf -e | sed "s/^..//")"'

# Получить текущее пространство имен
alias krn='kubectl config get-contexts --no-headers "$(krc)" | awk "{print $5}" | sed "s/^$/default/"'
# Список всех пространств имен
alias kln='kubectl get -o name ns | sed "s|^.*/|  |;|^  $(krn)$|s/ /*/"'
# Изменить текущее пространство имен
alias kcn='kubectl config set-context --current --namespace "$(kln | fzf -e | sed "s/^..//")"'
For at installere disse aliasser skal du tilføje de givne definitioner til din fil ~\/ .bashrc eller ~/ .zshrc og genstarte dit shell.
Brug af plugins
Kubectl tillader indlæsning af plugins, der kører ligesom de primære kommandoer. Du kan for eksempel installere en plugin kubectl-foo og køre den ved at udføre kommandoen kubectl foo.
Det ville være praktisk at skifte kontekst og navnerum på denne måde, for eksempel ved at køre kubectl ctx for at skifte konteksten og kubectl ns for at skifte navnerummet.
Jeg har skrevet to plugins, der gør dette:
Plugin'ernes funktionalitet er baseret på aliaser fra det foregående afsnit.
Her er, hvordan de fungerer:
Bemærk, at plugins bruger fzf til at give et interaktivt grænseflade til fri søgning (som i interaktiv tilstand med kubectx). Dette betyder, at du skal, for at bruge disse aliasser.
For at installere plugins skal du downloade shell-scripts med navnene og til en hvilken som helst katalog i din PATH-variabel og gøre dem eksekverbare, for eksempel ved hjælp af chmod +x. Umiddelbart efter dette kan du bruge kubectl ctx og kubectl ns.
5. Forkortet indtastning med autoaliaser
Shell-aliaser er en god måde at fremskynde indtastningen på. Projektet indeholder omkring 800 forkortelser for de grundlæggende kubectl-kommandoer.
Du undrer dig måske — hvordan kan jeg huske 800 aliaser? Men du behøver ikke at huske dem alle, da de er bygget efter et simpelt mønster, som er beskrevet nedenfor:
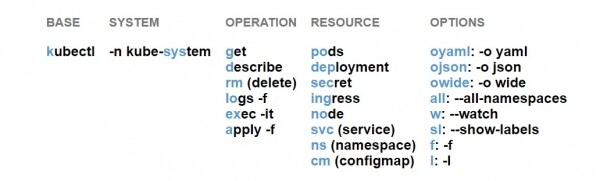
For eksempel:
- kgpooyaml — kubectl get pods oyaml
- ksysgsvcw — kubectl -n kube-system get svc w
- ksysrmcm — kubectl -n kube-system rm cm
- kgdepallsl — kubectl get deployment all sl
Som du kan se, består aliaser af komponenter, hvor hver repræsenterer et bestemt element i kubectl-kommandoen. Hver alias kan have én komponent til grundkommandoen, operationen og ressourcen samt flere komponenter til parametrene. Du 'fylder' blot disse komponenter fra venstre mod højre i henhold til det ovenfor nævnte mønster.
Den aktuelle detaljerede skema findes på . Der kan du også finde.
For eksempel er alias kgpooyamlall lig med kommandoen kubectl get pods -o yaml --all-namespaces.
Den relative rækkefølge af muligheder er ikke vigtig: kommandoen kgpooyamlall er lig med kommandoen kgpoalloyaml.
Du kan ikke bruge alle komponenter som aliaser. For eksempel k, kg, klo, ksys, kgpo kan også bruges. Desuden kan du kombinere aliaser og almindelige kommandoer eller valgmuligheder i kommandolinjen:
For eksempel:
- I stedet for
kubectl proxykan skrives somk proxy. - I stedet for
kubectl get roleskan skrives somkg roles(der eksisterer i øjeblikket ikke et alias for ressourcen Roles). - For at få data for en bestemt pod kan du bruge kommandoen
kgpo my-pod — kubectl get pod my-pod.
Vær opmærksom på, at nogle aliaser kræver et argument i kommandolinjen. For eksempel er aliaset kgpol betyder kubectl get pods -l. Muligheden -l kræver et argument – et etiketspecifikation. Hvis du bruger et alias, ser det ud som kgpol app=ui.
Fordi nogle aliaser kræver argumenter, skal aliaserne a, f og l bruges sidst.
Generelt, så snart du mestrer dette mønster, kan du intuitivt udlede aliaser fra de kommandoer, du ønsker at udføre, og spare meget tid på indtastningen.
Installation
For at installere kubectl-aliases skal du downloade filen fra GitHub og inkludere den i filen ~\/ .bashrc eller ~/ .zshrc:
source ~\/ .kubectl_aliasesAutomatisk fuldførelse
Som vi allerede har nævnt, tilføjer du ofte ekstra ord til aliaset i kommandolinjen. For eksempel:
$ kgpooyaml test-pod-d4b77b989Hvis du bruger automatisk fuldførelse af kubectl-kommandoen, har du sandsynligvis brugt automatisk fuldførelse til ting som ressourcenavne. Men kan dette gøres, når der bruges aliaser?
Dette er et meget vigtigt spørgsmål, fordi hvis automatisk fuldførelse ikke fungerer, går du glip af nogle af fordelene ved aliaser.
Svaret afhænger af, hvilken kommandolinje du bruger:
- For Zsh fungerer automatisk fuldførelse for aliaser «out of the box».
- For Bash er der desværre nogle trin, der er nødvendige for at få automatisk fuldførelse til at fungere.
Aktivering af automatisk fuldførelse for aliaser i Bash
Problemet med Bash er, at det forsøger at fuldføre (hver gang du trykker på Tab) et alias og ikke den kommando, som aliaset henviser til (som Zsh gør). Da du ikke har fuldender til alle 800 aliaser, fungerer automatisk fuldførelse ikke.
Projekt giver en generel løsning på dette problem. Den tilslutter sig mekanismen for fuldførelse for aliaser, fuldender intern aliaset til en kommando og returnerer forslag til fuldførelse for den fuldendte kommando. Dette betyder, at fuldførelsen for aliaset opfører sig nøjagtigt som for den fulde kommando.
Derefter vil jeg først forklare, hvordan man installerer complete-alias og derefter hvordan man konfigurerer det til at aktivere fuldførelse for alle kubectl-aliaser.
Installation af complete-alias
Først og fremmest afhænger complete-alias af . Derfor skal du sørge for, at bash-completion er installeret, inden du installerer complete-alias. Instruktioner til installation er givet tidligere for Linux og MacOS.
Vigtig bemærkning til brugere af MacOS: ligesom skriptet til automatisk fuldførelse af kubectl, fungerer complete-alias ikke med Bash 3.2, som standard bruges i MacOS. Især afhænger complete-alias af bash-completion v2 (brew install bash-completion@2), som kræver mindst Bash 4.1. Det betyder, at for at bruge complete-alias på MacOS skal du installere en nyere version af Bash.
Du skal downloade scriptet af og inkludere det i din fil ~\/ .bashrc:
source ~/bash_completion.shEfter genstart af kommandolinjen vil complete-alias være helt installeret.
Aktivering af autoudfyldning for kubectl-aliaser
Teknisk set giver complete-alias en shells funktion _complete_alias. Denne funktion tjekker aliaset og returnerer autoudfyldningsforslag til alias-kommandoen.
For at binde funktionen til et bestemt alias skal du bruge den indbyggede Bash-mekanisme , for at indstille _complete_alias som en alias autoudfyldningsfunktion.
Som eksempel tager vi aliaset k, der repræsenterer kommandoen kubectl. For at indstille _complete_alias som autoudfyldningsfunktionen for dette alias skal du køre følgende kommando:
$ complete -F _complete_alias k Resultatet af dette er, at hver gang du autoudfylder aliaset k, kaldes funktionen _complete_alias, som tjekker aliaset og returnerer autoudfyldningsforslagene til kommandoen kubectl.
Som et andet eksempel lad os tage aliaset kg, som repræsenterer kubectl get:
$ complete -F _complete_alias kg På samme måde som i det tidligere eksempel, når du autoudfylder kg, får du de samme autoudfyldningsforslag, som du ville få for kubectl get.
Bemærk, at complete-alias kan bruges til ethvert alias i dit system.
Derfor, for at aktivere autoudfyldning for alle kubectl-aliaser, skal du køre den nævnte kommando for hver af dem. Det følgende fragment gør netop dette, forudsat at du har installeret kubectl-aliases i ~/ .kubectl-aliases:
for _a in $(sed '/^alias /!d;s/^alias //;s/=.*$//' ~/ .kubectl_aliases);
do
  complete -F _complete_alias "$_a"
done
Denne kodebit skal placeres i din ~\/ .bashrc, genstart kommandolinjen, og autoudfyldning vil være tilgængelig for alle 800 kubectl-aliaser.
6. Udvidelse af kubectl med plugins
Startende med , understøtter kubectl , som tillader udvidelse af dets funktioner med yderligere kommandoer.
Hvis du er bekendt med , er kubectl-plugins bygget på samme princip.
I dette kapitel vil vi forklare, hvordan man installerer plugins, hvor man finder dem, og hvordan man opretter sine egne plugins.
Installation af plugins
Kubectl-plugins distribueres som enkle eksekverbare filer med et navn af typen kubectl-x. Præfikset kubectl- er obligatorisk, efterfulgt af den nye kubectl-underkommando, som gør det muligt at kalde pluginet.
For eksempel vil pluginet hello blive distribueret som en fil med navnet kubectl-hello.
For at installere pluginet skal du kopiere filen kubectl-x til en hvilken som helst mappe i din PATH-variabel og gøre den eksekverbar, for eksempel ved hjælp af chmod +x. Umiddelbart efter dette kan du kalde pluginet med kubectl x.
Du kan bruge følgende kommando til at vise listen over alle plugins, der i øjeblikket er installeret på dit system:
$ kubectl plugin listDenne kommando viser også advarsler, hvis du har flere plugins med de samme navne, eller hvis der er en plugin-fil, der ikke er eksekverbar.
Søgning og installation af plugins med Krew
Kubectl-plugins er egnede til deling eller genbrug ligesom softwarepakker. Men hvor kan man finde plugins, som andre har delt?
er rettet mod at give en ensartet løsning til deling, søgning, installation og administration af kubectl-plugins. Projektet kalder sig selv "pakkehåndtering til kubectl-plugins" (Krew er ligesom ).
Krew er en liste over kubectl-plugins, som du kan vælge og installere. Krew er også et plugin til kubectl.
Det betyder, at installationen af Krew fungerer stort set som installationen af ethvert andet kubectl-plugin. Du kan finde detaljerede instruktioner på .
De vigtigste Krew-kommandoer:
# Поиск в списке плагинов
$ kubectl krew search [<query>]
# Посмотреть информацию о плагине
$ kubectl krew info <plugin>
# Установить плагин
$ kubectl krew install <plugin>
# Обновить все плагины до последней версии
$ kubectl krew upgrade
# Посмотреть все плагины, установленные через Krew
$ kubectl krew list
# Деинсталлировать плагин
$ kubectl krew remove <plugin>
Bemærk, at installationen af plugins med Krew ikke forhindrer installationen af plugins på den standardmåde, der er beskrevet ovenfor.
Bemærk, at kommandoen kubectl krew list viser kun de plugins, der er installeret ved hjælp af Krew, mens kommandoen kubectl plugin list oplister alle plugins, det vil sige dem installeret ved hjælp af Krew, og dem installeret på andre måder.
Søgning efter plugins andre steder
Krew er et ungt projekt, og i øjeblikket har det kun omkring 30 plugins. Hvis du ikke kan finde det, du har brug for, kan du finde plugins andre steder, for eksempel på GitHub.
Jeg anbefaler at kigge i sektionen GitHub . Der finder du flere dusin tilgængelige plugins, som er værd at se nærmere på.
Skrive dine egne plugins
Du kan selv — det er ikke svært. Du skal oprette en eksekverbar fil, der gør det, du har brug for, og navngive den som kubectl-x og installere den som beskrevet ovenfor.
Filen kan være et bash-script, et python-script eller et kompilere go-program — det er ligegyldigt. Det eneste krav er, at den skal kunne køres direkte i operativsystemet.
Lad os oprette et eksempelplugin lige nu. I det forrige afsnit brugte du kommandoen kubectl til at udskrive en liste over containere for hver pod. Det er let at forvandle denne kommando til et plugin, som du kan kalde, for eksempel med kubectl img.
Opret en fil kubectl-img med følgende indhold:
#!/bin/bash
kubectl get pods -o custom-columns='NAME:metadata.name,IMAGES:spec.containers[*].image'
Nu skal du gøre filen eksekverbar ved hjælp af chmod +x kubectl-img og flytte den til en hvilken som helst mappe i din PATH. Så snart du gør dette, kan du bruge pluginet. kubectl img.
Som nævnt kan kubectl plugins skrives på ethvert programmeringssprog eller scriptsprog. Hvis du bruger shell scripts, er fordelene, at du nemt kan kalde kubectl fra pluginet. Men du kan skrive mere komplekse plugins på rigtige programmeringssprog ved at bruge . Hvis du bruger Go, kan du også bruge , som er designet specifikt til at skrive kubectl plugins.
Hvordan man deler sine plugins
Hvis du mener, at dine plugins kan være nyttige for andre, så tøv ikke med at dele dem på GitHub. Husk at tilføje dem til emnet .
Du kan også anmode om at få tilføjet dit plugin til . Der er instruktioner om, hvordan man gør dette, i .
Automatisk fuldførelse af kommandoer
I øjeblikket understøtter plugins ikke autocompletion. Det vil sige, du skal indtaste det fulde navn på pluginet og de fulde navne på argumenterne.
I GitHub-repositoriet for kubectl er der en . Så det er muligt, at denne funktion vil blive implementeret i fremtiden.
Held og lykke!!!
Andre artikler om emnet:
- .
- .
- .
Kilde: habr.com
