

Hello, Habr!
I dag vil jeg gerne fortælle om vores erfaring med automatisering af backup af store datalagre i Nextcloud i forskellige konfigurationer. Jeg arbejder som CTO hos "Molniya AK", hvor vi beskæftiger os med konfigurationsstyring af IT-systemer, og vi bruger Nextcloud til datalagring. Det inkluderer også en distribueret struktur med redundans.
Problemerne opstår på grund af de særlige kendetegn ved installationerne, da der er mange data. Versionsstyringen, som Nextcloud tilbyder, backup, subjektive årsager og andet skaber mange dubletter.
Background
Ved administration af Nextcloud opstår der skarpt behov for at organisere en effektiv backup, som absolut skal krypteres, da dataene er værdifulde.
Vi tilbyder muligheder for at opbevare backup enten hos os eller hos kunden på deres separate maskiner uden for Nextcloud, hvilket kræver en fleksibel og automatiseret tilgang til administration.
Der er mange kunder, og de har alle forskellige konfigurationer, og alle har deres egne platforme og særlige forhold. Her fungerer den standardmetode, hvor hele platformen tilhører dig, og backups foretages fra cron, dårligt.
Lad os først se på de indledende data. Vi har brug for:
- Skalerbarhed med hensyn til én node eller flere. For større installationer bruger vi minio som lagringsløsning.
- At få information om problemer med udførelsen af backup.
- Backup skal opbevares hos kunderne og/eller hos os.
- At kunne håndtere problemer hurtigt og nemt.
- Kunder og installationer adskiller sig meget fra hinanden - det er umuligt at opnå ensartethed.
- Gendannelseshastigheden skal være minimal i to scenarier: fuld gendannelse (katastrofe) og en mappe - slettet ved en fejl.
- Funktionen til deduplication er obligatorisk.
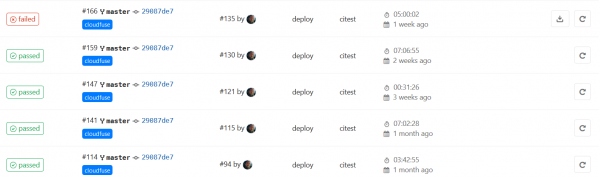
For at tackle opgaven med backupstyring har vi integreret GitLab. Mere om det senere.
Vi er selvfølgelig ikke de første, der løser en sådan opgave, men vi mener, at vores praktiske og erfarne tilgang kan være interessant, og vi er klar til at dele den.
Da vores virksomhed praktiserer en open source-politik, søgte vi netop efter en løsning med åben kildekode. Vi deler også vores udviklinger og offentliggør dem. På GitHub findes der for eksempel , som vi installerer hos kunderne, og som forbedrer databeskyttelsen i tilfælde af utilsigtet eller bevidst sletning.
Backupværktøjer
Vi begyndte at lede efter løsninger med valg af et backup-værktøj.
Normalt fungerer tar + gzip dårligt - data duplikeres. Inkrementet indeholder ofte meget få ændringer, og en stor del af dataene i én fil gentages.
Der er et andet problem - redundans i det distribuerede datalager. Vi bruger minio, og dens data er principielt redundante. Enten skal backup laves via selve minio - hvilket belaster det og kræver brug af alle lag mellem filsystemet, og ikke mindre vigtigt, der er en risiko for at glemme en del af buckets og metadata. Eller også skal vi bruge deduplikation.
Der findes deduplikeringsbackup-værktøjer i open source (der var artikel ) og vores finalister blev og . Om vores sammenligning af de to applikationer nedenfor, men lad os først beskrive, hvordan vi organiserede hele ordningen.
Styring af oprettelse af sikkerhedskopier
Borg og Restic er gode, men ingen af produkterne har et centraliseret styringssystem. Til styrings- og kontrolformål valgte vi et værktøj, som allerede er implementeret hos os, uden hvilket vi ikke forestiller os vores arbejde, inklusive automatisering - det er den velkendte CI/CD - GitLab.
Idéen er som følger: På hver node, der gemmer data i Nextcloud, installeres gitlab-runner. Runneren kører et script efter tidsplanen, der overvåger backup-processen, og det starter Borg eller Restic.
Hvad fik vi? Feedback fra udførelsen, praktisk kontrol med ændringer, detaljer i tilfælde af fejl.
Her er har vi lagt eksempler på scriptet til forskellige opgaver, og vi har til sidst tilpasset det til backup af ikke kun Nextcloud, men også mange andre tjenester. Der ligger også planlæggeren, hvis man ikke gider at konfigurere det manuelt (og det gider vi ikke), samt .gitlab-ci.yml.
I GitLab API'et er der endnu ikke mulighed for at ændre CI/CD timeout, og den er ret kort. Den skal øges, lad os sige til 1d.
Heldigvis kan GitLab starte ikke kun ved commit, men også efter tidsplan, det er præcis det, vi har brug for.
Nu om wrapper-scriptet.
Vi satte følgende krav til dette script:
- Det skal kunne køre både som runner og manuelt fra konsollen med samme funktionalitet.
- Der skal være fejlbehandlere:
- returkode.
- søge efter en streng i loggen. For eksempel kan en fejl for os være en meddelelse, som programmet ikke anser for fatal.
- Timeout-håndtering. Udførelsestiden skal være rimelig.
- Vi har brug for en meget detaljeret log. Men kun i tilfælde af fejl.
- Der udføres også en række tests inden starten.
- Små forbedringer for bekvemmelighed, som vi fandt nyttige i supportprocessen:
- Start og afslutning logges i systemloggen på den lokale maskine. Det hjælper med at knytte systemfejl til backupens arbejde.
- En del af fejlloggen, når der er nogen, udskriver til stdout, hele loggen skrives til en separat fil. Det er praktisk at kigge direkte i CI og vurdere fejlen, hvis den er triviel.
- Tilstande for debugging.
Den fulde log gemmes som artefakt i GitLab, hvis der ikke er nogen fejl, så slettes loggen. Vi skriver scriptet i bash.
Vi er glade for at overveje eventuelle forslag og kommentarer til open source — velkommen.
Hvordan fungerer det
På den backupede node startes en runner med bash-executoren. I planlæggeren startes en job CI/CD i et særligt repository. Runneren kører et script som en universel wrapper til sådanne opgaver, hvor der foretages valideringskontroller af backup-repositoriets gyldighed, monteringspunkter og alt hvad vi ønsker, hvorefter backup udføres og gammelt renses. Den færdige backup sendes til S3.
Vi arbejder efter denne ordning — det er en ekstern udbyder AWS eller en russisk analog (det er hurtigere, og data forbliver i Rusland). Eller vi opsætter en separat minio-klynge for kunden på deres plads til disse formål. Vi gør det normalt af sikkerhedsmæssige årsager, når kunden helt ikke ønsker, at data forlader deres domaine.
Vi valgte ikke at bruge funktionen til at sende backup via ssh. Det øger ikke sikkerheden, og netværksmulighederne for S3-udbyderen er meget højere end vores ssh-maskine.
For at beskytte mod hackere på den lokale maskine — da de kan slette data på S3, er det absolut nødvendigt at aktivere versionering.
Backup-løsningen krypterer altid backupen.
Borg har en tilstand uden kryptering ingen, men vi anbefaler kraftigt ikke at aktivere det. I denne tilstand vil der ikke være kryptering, og der beregnes ikke checksum for dataene, der skrives, hvilket betyder, at integritet kun kan kontrolleres indirekte, via indeks.
Ved et separat scheduler udføres kontrol af backuper for integritet af indekser og indhold. Kontrollen foregår langsomt og længe, derfor kører vi den separat en gang om måneden. Den kan tage flere dage.
Readme på russisk
Vigtigste funktioner
forberedforberedelsetestcheckkontrol af klarhedhovedkommandohoved kommandoforcepostscripten funktion, der udføres ved afslutningen eller ved fejl. Bruges til at afmontere partitionen.
Service funktioner
cleanupvi registrerer fejl eller sletter logfilen.checklogvi parser loggen for indholdet af fejlsiden.retexit handler.checktimeouttjek for timeout.
Miljø
VERBOSE=1udskriver fejl til skærmen med det samme (stdout).SAVELOGSONSUCCES=1gemmer log ved succes.INIT_REPO_IF_NOT_EXIST=1Opretter et repository, hvis det ikke eksisterer. Som standard er det deaktiveret.TIMEOUTmaksimal tid til den primære operation. Du kan indstille det som 'm', 'h' eller 'd' til slut.
Tilstand for opbevaring af gamle kopier. Som standard:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Variabler i scriptet
ERROR_STRING— streng til kontrol i loggen for fejl.EXTRACT_ERROR_STRING— udtryk for at vise strengen, hvis der er en fejl.KILL_TIMEOUT_SIGNAL— signal for at dræbe, hvis der er timeout.TAIL— hvor mange strenge med fejl der vises på skærmen.COLORMSG— farven på meddelelserne (standard gul).
Det script, der kaldes wordpress, har noget betinget navngivning; dens funktion er, at den også tager backup af mysql-databasen. Det betyder, at det kan bruges til engangsinstallationer af Nexcloud, hvor man også kan tage backup af databasen. Bekvemmeligheden ligger ikke kun i, at alt er samlet ét sted, men også at indholdet i databasen er tæt på indholdet af filerne, da tidsforskellen er minimal.
Restic vs Borg
Sammenligninger mellem Borg og Restic findes blandt andet , og vi havde ikke til hensigt at lave bare endnu en, men vores egen. Det var vigtigt for os, hvordan det ville se ud med vores data, med vores specifikationer. Vi præsenterer dem.
Vores valgkriterier, udover de allerede nævnte (deduplisering, hurtig gendannelse osv.):
- Modstandsdygtighed over for ufuldstændigt arbejde. Tjek for kill -9.
- Størrelse på disken.
- Krav til ressourcer (CPU, hukommelse).
- Størrelse på de gemte blobs.
- Arbejder med S3.
- Integritetstjek.
Til test brugte vi en klient med rigtige data og en samlet størrelse på 1,6TB.
Betingelser.
Borg kan ikke direkte arbejde med S3, og vi monterede den som en fuse-disk gennem . Restic sendte til S3 selv.
Goofys fungerer meget hurtigt og godt, og der er et , som yderligere fremskynder arbejdet. Den er i beta-stadiet, og vi må indrømme, at den faldt med datatab under testene (andre). Men bekvemmeligheden ligger i, at selve backupproceduren ikke kræver meget læsning, men hovedsageligt skrivning, derfor bruger vi cachen kun under integritetstjek.
For at reducere netværksindflydelsen benyttede vi den lokale udbyder — Yandex Cloud.
Resultaterne af testningen af sammenligningen.
- Kill -9 med efterfølgende genstart, begge er gennemført med succes.
- Plads på disken. Borg kan komprimere, så resultaterne er forventede.
Backuper
Størrelse
Borg
562Gb
Restic
628Gb
- Ved CPU
Borg bruger lidt ressourcer alene, med standardkomprimering, men det skal vurderes sammen med goofys-processen. Sammenlignet bruger de omkring 1,2 kerner på den samme test-virtuelle maskine. - Hukommelse. Restic bruger cirka 0,5Gb, Borg omkring 200Mb. Men det er alt sammen ubetydeligt sammenlignet med systemets filcache. Så det er ønskeligt at tildele mere hukommelse.
- Forskellen i størrelsen på blobberne viste sig at være markant.
Backuper
Størrelse
Borg
omkring 500Mb
Restic
omkring 5Mb
- Samarbejdet med S3 fra Restic fungerer glimrende. Borgs arbejde gennem goofys rejser ingen spørgsmål, men det er bemærket, at det er ønskeligt at udføre umount efter backupen for at nulstille cachen fuldstændigt. S3's funktion er, at ufuldstændigt downloadede chunks aldrig vil blive sendt til bucket, og derfor fører ufuldstændigt uploadede data til store skader.
- Integritetskontrollen fungerer godt i begge tilfælde, men hastigheden adskiller sig betydeligt.
Restic – 3,5 timer.
Borg, med en filcache på 100Gb SSD – 5 timer. Omtrent det samme resultat i hastighed, hvis dataene ligger på en lokal disk.
Borg læser direkte fra S3 uden cache 33 timer. Uhyre lang tid.
I det store og hele kan Borg komprimere og har større blobs — hvilket gør opbevaring og GET/PUT-operationer i S3 billigere. Men man må betale for en mere kompleks og langsom kontrol. Hvad angår gendannelseshastigheden, så bemærkede vi ikke forskel. Efterfølgende backuper (efter den første) tager lidt længere tid for Restic, men ikke mærkbart.
Størrelsen på fællesskabet spillede også en rolle i valget.
Og vi valgte Borg.
Et par ord om komprimering
Borg har en fremragende ny komprimeringsalgoritme i sit arsenal — zstd. Komprimeringskvaliteten er ikke dårligere end gzip, men betydeligt hurtigere. Og den er sammenlignelig i hastighed med standard lz4.
For eksempel komprimeres en dump af MySQL-databasen cirka to gange bedre end lz4 ved samme hastighed. Men erfaringer med reelle data viser, at der er en meget lille forskel i komprimeringsgraden for Nextcloud-noder.
Borg har en bonuskomprimeringsfunktion — hvis en fil har høj entropi, anvendes komprimering slet ikke, hvilket øger hastigheden. Det aktiveres med en indstilling ved oprettelse af
-C auto,zstd
for zstd-algoritmen
Så med denne indstilling har vi i sammenligning med standardkomprimering opnået
560Gb og 562Gb henholdsvis. Data fra eksemplet ovenfor, husk, uden komprimering giver 628Gb. Resultatet med 2Gb forskel overraskede os lidt, men vi besluttede at vælge alligevel auto,zstd.
Metode til kontrol af backup
Via planlæggeren startes en virtuel maskine direkte hos udbyderen eller hos kunden, hvilket markant reducerer netværksbelastningen. I det mindste er det billigere end at starte det op selv og sende trafik.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https://storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/
borg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
På samme måde tjekker vi filer med antivirus (post factum). Brugerne uploader forskellige filer til Nextcloud, og ikke alle har antivirus. At checke ved upload tager for meget tid og hæmmer forretningen.
Skalérbarhed opnås ved at køre runners på forskellige noder med forskellige tags.
I vores overvågning samles statusser for back-ups gennem GitLab API i ét vindue, og ved behov opdages problemer let og kan også let lokaliseres.
Konklusion
Som resultat ved vi med sikkerhed, at vi laver back-ups, at vores back-ups er valide, og at problemer, der opstår med dem, tager lidt tid at løse på niveauet for vagthavende administrator. Back-ups optager virkelig lidt plads sammenlignet med tar.gz eller Bacula.
Kilde: habr.com
