

Vi har udviklet et design til datacenter-netværk, der muliggør implementering af compute-klynger med mere end 100.000 servere og en peak bisection bandwidth på over ét petabyte per sekund.
I Dmitry Afanasyevs præsentation vil du lære om de grundlæggende principper bag det nye design, de skalerbare topologier, de problemer der opstår, løsningerne på disse, samt karakteristika ved routing og skalerbarhed af forwarding plane-funktioner i moderne netværksenheder i "tæt forbundne" topologier med et stort antal ECMP-ruter. Derudover giver Dmitry en kort gennemgang af ekstern forbindelse, det fysiske lag, kablingsystemet og metoder til yderligere at øge kapaciteten.
— God eftermiddag, alle sammen! Mit navn er Dmitry Afanasyev, jeg er netværksarkitekt hos Yandex, og jeg arbejder primært med design af datacentre.
Min præsentation vil handle om det opdaterede datacenter-netværk hos Yandex. Det er i høj grad en evolution af det design, vi havde, men der er også nogle nye elementer. Det er en oversigtspresentation, da vi skulle inkludere en del information på kort tid. Vi starter med valget af logisk topologi. Derefter vil der være en oversigt over kontrolplanet og problemer med skalerbarheden i dataplanet, og vi ser på, hvad der skal ske på det fysiske niveau og kigger på nogle karakteristika ved enhederne. Vi berører også Gør det samme i datacentret med MPLS, som vi talte om for noget tid siden.
Så hvad er Yandex set fra synspunktet af belastninger og tjenester? Yandex er en typisk hyperscaler. Set fra brugernes perspektiv handler det primært om behandling af brugerhenvendelser. Der er også forskellige streamingtjenester og datalevering, da vi også har storage-tjenester. Tættere på backend er der infrastrukturbelastninger og tjenester, såsom distribuerede objektlagre, datareplication og naturligvis persistente køer. En af de primære typer belastninger er MapReduce og lignende systemer, streamingbehandling, machine learning osv.
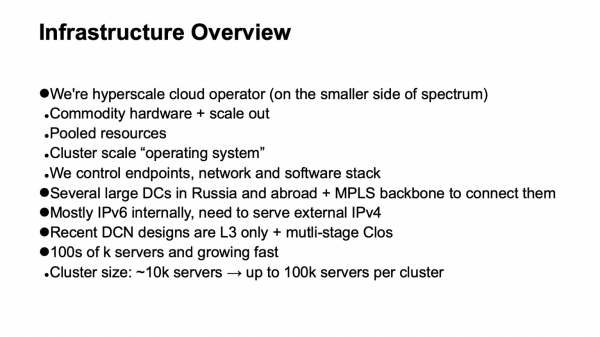
Hvordan er infrastrukturen bygget op, som alt dette sker på? Igen, vi er en ganske typisk hyperscaler, selvom vi måske ligger en smule tættere på den side af spektret, hvor de mindre hyperscalere befinder sig. Men vi har alle egenskaberne. Vi bruger commodity hardware og horisontal skalerbarhed overalt, hvor det er muligt. Vi har en fuld integration af ressourcepulje: vi arbejder ikke med separate maskiner eller racks, men kombinerer dem i en stor pulje af udskiftelige ressourcer med nogle ekstra tjenester, der håndterer planlægning og allokering, og vi arbejder med hele denne pulje.
Så opstår det næste niveau - operativsystemet på kluster-niveau. Det er meget vigtigt, at vi fuldstændig kontrollerer stakken af teknologier, der anvendes. Vi kontrollerer endepunkterne (hosts), netværket og softwarestakken.
Vi har flere store datacentre i Rusland og abroad. De forbindes af et backbone, der bruger MPLS-teknologi. Vores interne infrastruktur er praktisk talt fuldstændig bygget på IPv6, men da vi stadig skal betjene ekstern trafik, der i høj grad kommer via IPv4, skal vi finde en måde at levere forespørgsler, der kommer via IPv4, til frontend-servere- og selvfølgelig også tilgå den eksterne IPv4-internet — for eksempel til indeksering.
De seneste iterationer af datacenter netværksdesign anvender flerlags Clos-topologier, og de bruger kun L3. Vi gik væk fra L2 for et stykke tid siden og har brugt et lettelsens suk. Endelig inkluderer vores infrastruktur hundreder af tusinder af computermaskiner (servere). Den største størrelse på et kluster var for et stykke tid siden omkring 10.000 servere. Dette skyldes i høj grad, hvordan de specifikke operativsystemer på klusterniveau, planlæggere, ressourceallokering osv. kan arbejde. Da der skete fremskridt på siden af infrastruktursoftwaren, er målet nu at have en størrelse på omkring 100.000 servere i et enkelt computermiljø, og vi står over for udfordringen — at kunne bygge netværksfabrikker, der muliggør effektiv ressourcepulje i et sådant kluster.
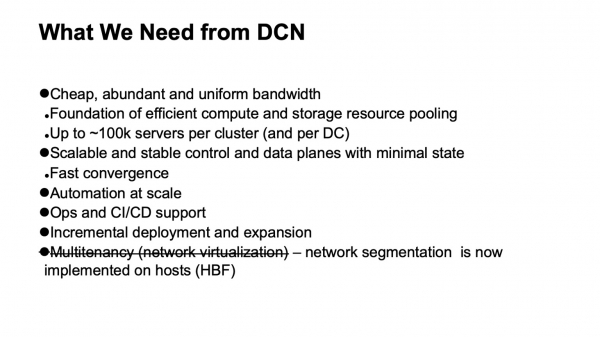
Hvad ønsker vi fra netværket i datacenteret? Først og fremmest - meget billig og tilstrækkeligt ensartet distribueret båndbredde. Fordi netværket er det fundament, vi kan bruge til at pulje ressourcer. Den nye målestørrelse er omkring 100.000 servere i et enkelt cluster.
Vi ønsker selvfølgelig også en skalerbar og stabil kontrolplane, for på så stor infrastructure opstår der ofte en del hovedpine selv fra tilfældige hændelser, og vi ønsker ikke, at kontrolplanen også skal give os hovedpine. Samtidig ønsker vi at minimere tilstanden i den. Jo mindre tilstand, desto bedre og mere stabilt fungerer alt, og det er lettere at diagnosticere.
Selvfølgelig har vi brug for automatisering, for manuelt at administrere sådan en infrastruktur er umuligt, og det har ikke været muligt i et stykke tid. Vi har brug for så vidt muligt støtte til driftsaktiviteter og CI/CD-support, i det omfang det kan sikres.
Ved sådanne størrelser af datacentre og clustre er behovet for at støtte inkrementel implementering og udvidelse uden serviceafbrydelse blevet meget presserende. Hvis der på clustre med tusinde maskiner, måske tættere på ti tusinde maskiner, stadig er muligt at udrulle dem som én operation - dvs. vi planlægger at udvide infrastrukturen, og flere tusinde maskiner tilføjes som én operation, så opstår et cluster på næsten hundrede tusinde maskiner ikke pludseligt; det bygges over tid. Og det er ønskeligt, at alt det, der allerede er udtrukket, den infrastruktur, der er blevet implementeret, forbliver tilgængelig i hele denne periode.
Og et krav, som vi havde og har opgivet: det er støtte til multitenancy, dvs. virtualisering eller segmentering af netværket. Nu har vi ikke behov for at gøre dette på niveau med netværksfabrikken, fordi segmenteringen er flyttet til værterne, hvilket har lettet vores skalering. Takket være IPv6 og det store adresseområde har vi ikke behøvet at bruge duplikerede adresser i den interne infrastruktur; alle adresser var allerede unikke. Og fordi vi har flyttet filtrering og segmentering af netværket til værterne, behøver vi ikke at skabe nogen virtuelle netværksenheder i datacenterets netværk.
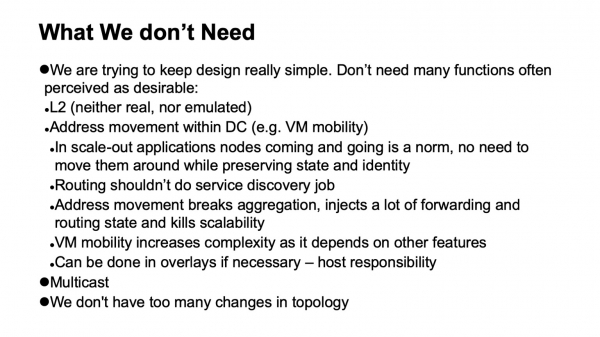
En meget vigtig ting er, hvad vi ikke har brug for. Hvis nogle funktioner kan fjernes fra netværket, letter det livet betydeligt og udvider som regel valget af tilgængeligt udstyr og software, samt forenkler diagnosticeringen.
Så hvad er det, vi ikke har brug for, som vi har kunnet give afkald på, ikke altid med glæde i det øjeblik, det skete, men med stor lettelse, når processen var afsluttet?
Først og fremmest, afskaffelsen af L2. Vi har ikke brug for L2, hverken den virkelige eller den emulerede. Det anvendes ikke i væsentlig grad, fordi vi kontrollerer stakken af applikationer. Vore applikationer skaleres horisontalt, de arbejder med L3 adressering, og de bekymrer sig ikke meget om, at en enkelt instans er nede, de ruller bare en ny ud, den behøver ikke at køre på den gamle adresse, fordi der er et separat lag for service discovery og overvågning af maskinerne i klyngen. Vi overfører ikke denne opgave til netværket. Nettets opgave er at levere pakker fra punkt A til punkt B.
Derudover har vi ikke situationer, hvor adresser bevæger sig inden for nettet, og som skal spores. I mange design er dette som regel nødvendigt for at støtte VM-mobilitet. Vi bruger ikke mobilitet af virtuelle maskiner i den interne infrastruktur af store Yandex, og vi mener, at selv hvis det gøres, ikke bør det ske med netværksstøtte. Hvis det virkelig er nødvendigt, skal det gøres på værtsniveau, og man skal placere adresser, som kan migrere, i overlays for ikke at berøre og indføre for mange dynamiske ændringer i systemet af ruteoplysning i selve underlaget (transportnetværket).
En anden teknologi, vi ikke bruger, er multicast. Jeg kan gerne forklare, hvorfor til interesserede. Det letter livet betydeligt, fordi hvis nogen har arbejdet med det og set, hvordan control plane for multicast ser ud - i alle installationer bortset fra de simpleste, er det en stor hovedpine. Og desuden er det svært at finde en godt fungerende åben implementering, for eksempel.
Og endelig designer vi vores netværk, så der ikke sker for mange ændringer. Vi kan regne med, at strømmen af eksterne begivenheder i rutningssystemet er lille.
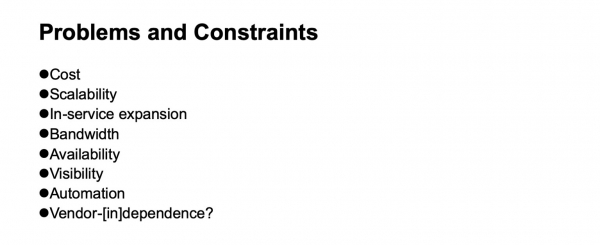
Hvilke problemer opstår, og hvilke begrænsninger skal vi tage højde for, når vi udvikler et datacenter-netværk? Omkostninger, selvfølgelig. Skalerbarhed, det niveau, vi ønsker at vokse til. Behovet for udvidelse uden at stoppe tjenesten. Båndbredde, tilgængelighed. Synligheden af, hvad der sker i netværket, for overvågningssystemer, for operationelle teams. Understøttelse af automatisering — igen, så meget som muligt, da forskellige opgaver kan løses på forskellige niveauer, herunder ved at indføre ekstra lag. Og ikke-[i muligheden]-afhængighed af leverandører. Selvom det i forskellige historiske perioder, afhængigt af hvilket perspektiv man ser fra, har været lettere eller sværere at opnå denne uafhængighed. Hvis vi ser på området for netværksenheders chips, har man indtil for nylig kun meget betinget kunnet tale om uafhængighed fra leverandører, hvis vi også ønskede chips med høj båndbredde.
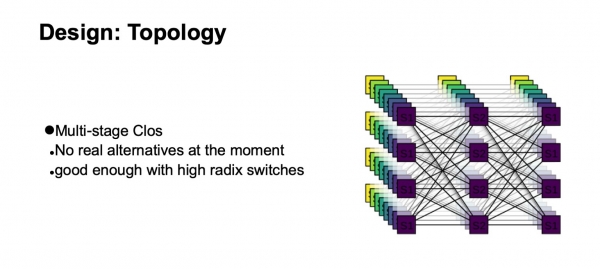
Hvilken logisk topologi vil vi bygge vores netværk i? Det vil være en flerlags Clos. Faktisk er der i øjeblikket ingen reelle alternativer. Og Clos-topologien er ret god, selv når man sammenligner den med forskellige avancerede topologier, der mere nu er i sfæren af akademisk interesse, hvis vi har switcher med stort radix.
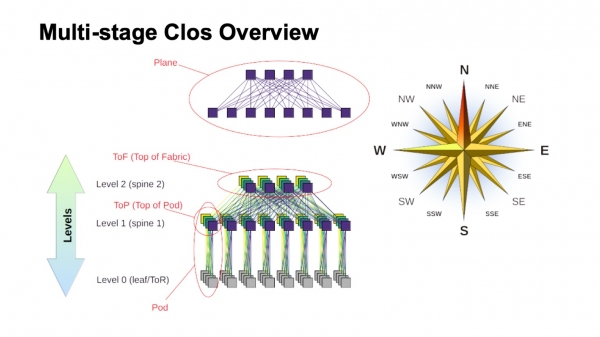
Hvordan er en flerlags Clos-netværk omtrent opbygget, og hvordan kaldes de forskellige elementer i det? Først og fremmest vindrose, for at orientere os om, hvor nord, syd, øst og vest er. Netværk af denne type bygges normalt af dem, der har meget stor trafik øst-vest. Hvad angår de øvrige elementer, er der øverst en virtuel switch, der er samlet af mindre switcher. Dette er hovedideen i den rekursive opbygning af Clos-netværk. Vi tager elementer med en eller anden radix og forbinder dem, så det, der kommer ud, kan betragtes som en switch med en større radix. Hvis der er behov for endnu mere, kan proceduren gentages.
I tilfælde som med to-niveau Clos, hvor man klart kan udpege de komponenter, der på mit diagram er vertikale, kaldes de plan. Hvis vi byggede en Clos med tre niveauer af spine-switches (alle, der ikke er grænse- og ikke ToR-switches og som kun bruges til transit), ville planerne se mere komplekse ud; to-niveau ser sådan ud. Blokken af ToR- eller leaf-switches og de tilknyttede første niveau spine-switches kalder vi Pod. Spine-switchene på spine-1 niveauet øverst i Pod er toppen af Pod. Switchene, der er placeret øverst i hele fabricen, udgør det øverste lag af fabricen, Top of fabric.
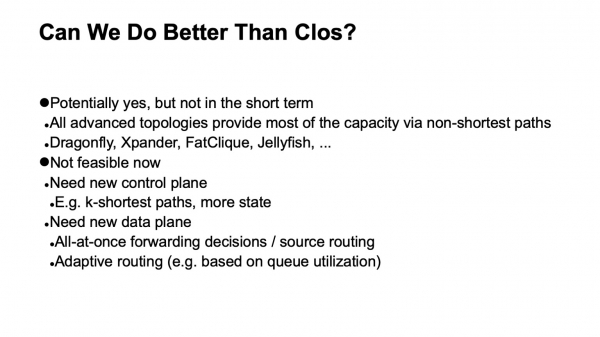
Selvfølgelig opstår spørgsmålet: Clos-netværk er blevet bygget i et stykke tid, og selve ideen stammer fra den klassiske telekommunikation, TDM-netværk. Måske er der kommet noget bedre, måske kan man gøre det bedre på en anden måde? Både ja og nej. Teoretisk set ja, men i praksis er der ikke noget på kort sigt. Fordi der er et vist antal interessante topologier, hvoraf nogle endda anvendes i produktionen, for eksempel bruges Dragonfly i HPC-applikationer; der er også interessante topologier som Xpander, FatClique, Jellyfish. Hvis man kigger på rapporter fra konferencer som SIGCOMM eller NSDI på det seneste, kan man opdage et ret stort antal arbejder om alternative topologier, der har bedre egenskaber (den ene eller den anden) end Clos.
Men alle disse topologier har én interessant egenskab. Den forhindrer deres implementering i datacentre, som vi forsøger at bygge på commodity hardware, og som koster rimelige penge. I alle disse alternative topologier er en stor del af båndbredden desværre ikke tilgængelig over de korteste ruter. Derfor mister vi straks muligheden for at bruge den traditionelle control plane.
Teoretisk set er løsningen på problemet kendt. Det er for eksempel modifikationer af link state med brug af k-shortest path, men igen findes der ikke sådanne protokoller, der er implementeret i produktionen og bredt tilgængelige på udstyret.
Desuden, da størstedelen af kapaciteten ikke er tilgængelig via de korteste veje, skal vi modificere ikke kun control plane, så det vælger alle disse veje (og for resten er det et betydeligt større ansvar for control plane). Vi skal også modificere forwarding plane, og som regel kræves der mindst to yderligere funktioner. Det er muligheden for at træffe alle beslutninger om forwarding af pakker på én gang, for eksempel på værten. Faktisk er det source routing, nogle gange omtales dette i litteraturen om interconnection networks som all-at-once forwarding decisions. Og så er der adaptive routing — det er allerede en funktion, vi har brug for i netværkselementerne, som handler om at vælge det næste hop baseret på information om den laveste belastning af køen. Som eksempel er der muligheden for andre varianter.
Således er retningen interessant, men desværre kan vi ikke anvende det lige nu.
Okay, vi stoppede ved den logiske Clos-topologi. Hvordan vil vi skalere den? Lad os se på, hvordan den er struktureret, og hvad vi kan gøre.
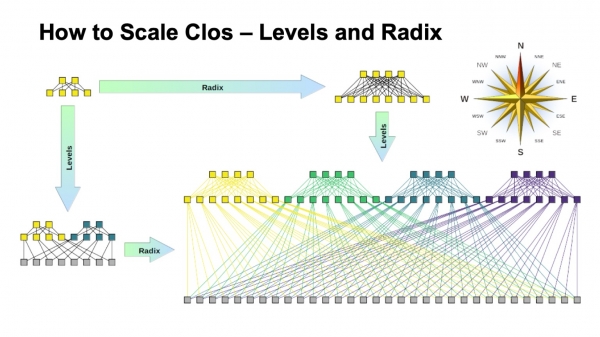
I Clos-netværket er der to hovedparametre, som vi kan variere for at opnå forskellige resultater: radix af elementerne og antallet af niveauer i netværket. Jeg har skematisk vist, hvordan begge påvirker størrelsen. Ideelt kombinerer vi begge dele.
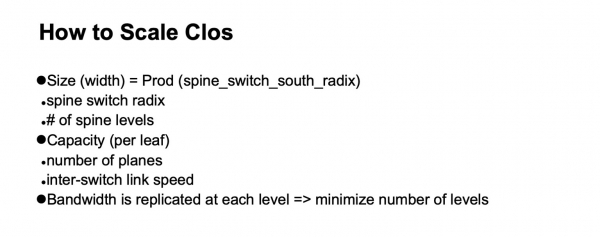
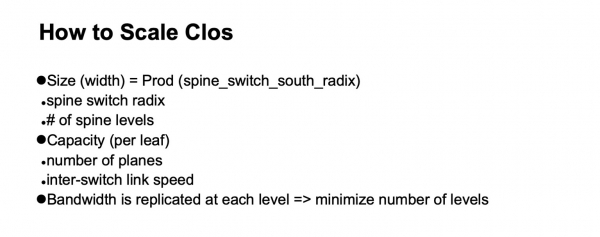
Det kan ses, at den endelige bredde af Clos-netværket er produktet af alle niveauerne af spine-switches i den sydlige radix, og hvor mange links vi har nedad, hvordan det forgrener sig. Sådan skalerer vi netværksstørrelsen.
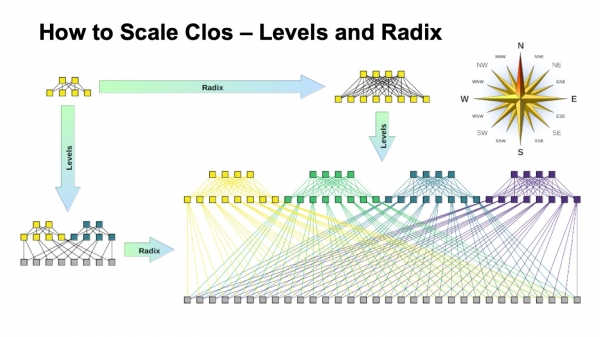
Hvad angår kapaciteten, især på ToR-switches, er der to skaleringsmuligheder. Enten kan vi, ved at bevare den samlede topologi, bruge hurtigere links, eller vi kan tilføje flere planer.
Hvis vi ser på den udfoldede version af Clos-netværket (i nederste højre hjørne) og vender tilbage til dette billede med Clos-netværket nedenfor...
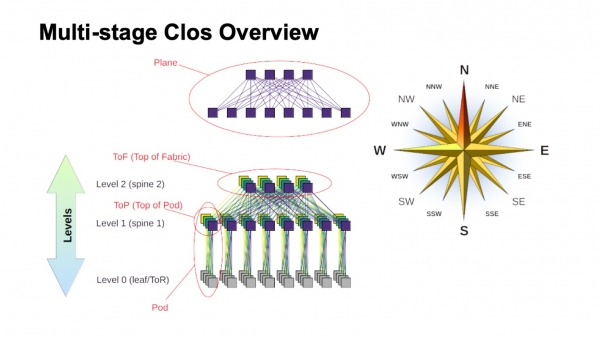
... så er det præcis den samme topologi, men på dette dias er den komprimeret mere kompakt, og fabriksplanerne er lagt oven på hinanden. Det er det samme.
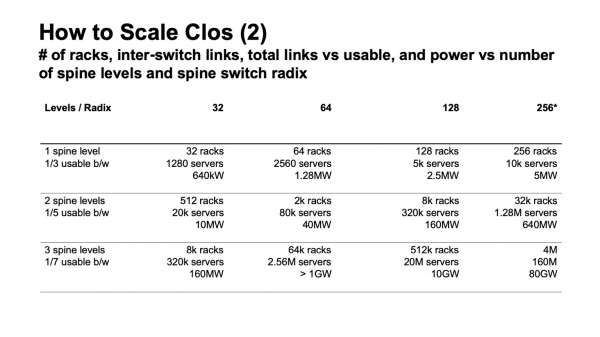
Hvordan ser skaleringsprocessen for Clos-netværket ud i tal? Her viser jeg data om den maksimale bredde, som netværket kan få, hvor mange racks, ToR-switches eller leaf-switches, hvis de ikke er i racks, vi kan få afhængigt af, hvilken radix af switches der bruges for spine-niveauerne, og hvor mange niveauer vi bruger.
Her er angivet, hvor mange racks vi kan have, hvor mange servere der er, og omtrent hvor meget det hele kan forbruge ud fra en beregning på 20 kW pr. rack. Tidligere nævnte jeg, at vi sigter efter en clusterstørrelse på omkring 100.000 servere.
Det er tydeligt, at der i hele denne konstruktion er to og et halvt interessante varianter. Der er en mulighed med to lag spine-switches og 64-ports switches, som er lidt mangelfuld. Derefter er der fremragende muligheder for 128-ports (med radix 128) spine-switches med to niveauer, eller switches med radix 32 med tre niveauer. I alle tilfælde, hvor der er større radix og flere niveauer, kan man lave et meget stort netværk, men hvis man ser på det forventede forbrug, er der typisk gigawatt. Man kan trække kabler, men så meget elektricitet får vi næppe på ét sted. Hvis man ser på statistikken, findes der i de offentlige data om datacentre – der er meget få datacentre med en designkapacitet over 150 MW. Det, der er større, er typisk datacenterkampuser, flere store datacentre, der ligger ret tæt på hinanden.
Der er også en vigtig parameter. Hvis du ser på den venstre kolonne, er der angivet usable bandwidth. Det er ikke svært at bemærke, at i et Clos-netværk går en betydelig del af portene til at forbinde switches med hinanden. Usable bandwidth, den nyttige båndbredde, er det, der kan gives ud til serverne. Selvfølgelig taler jeg om de hypotetiske porte og netop båndbredden. Typisk er linkene inden for netværket hurtigere end linkene mod serverne, men for hver enhed båndbredde, så meget som vi kan sende ud til vores serverudstyr, påløber der stadig en vis båndbredde inden for selve netværket. Og jo flere niveauer vi laver, jo større bliver de specifikke omkostninger til at levere denne båndbredde ud.
Desuden er selv denne ekstra båndbredde ikke helt ens. Så længe spænderne er korte, kan vi bruge noget som DAC (direct attach copper, det vil sige twinax-kabler), eller multimode-optik, som stadig er rimeligt prisvenlig. Når vi går over til længere spændinger — som typisk er single mode optik, stiger omkostningerne til denne ekstra båndbredde betydeligt.
Og igen, når vi vender tilbage til det forrige slide, hvis vi opretter et Clos-netværk uden genunderskrift, er det ikke svært at se på diagrammet, se hvordan netværket er opbygget - ved at tilføje hvert niveau af spine-swits, gentager vi hele den båndbredde, der var forneden. Plus niveauet - plus hele den samme båndbredde, endnu så meget som der var på det forrige niveau, porte på switchene, yderligere så mange transceivere. Så antallet af niveauer af spine-swits er meget ønskeligt at minimere.
Baseret på dette billede kan vi se, at vi virkelig ønsker at bygge på noget som switches med radix 128.
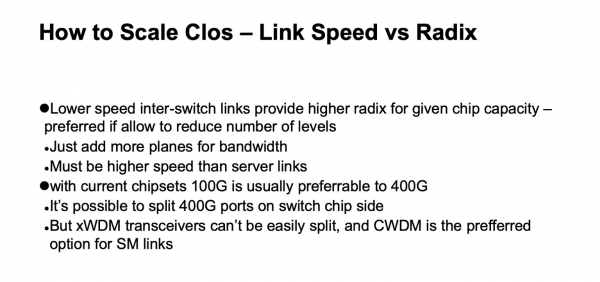
Her er stort set det samme som jeg lige har forklaret, dette slide er mere til senere overvejelse.
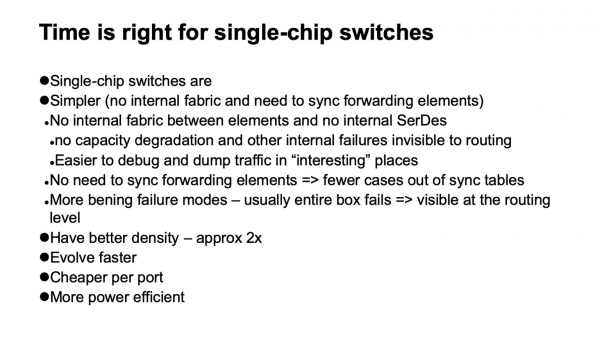
Hvad er der af muligheder, hvad kan vi vælge som disse switcher? En meget behagelig nyhed for os er, at sådanne netværk endelig kan bygges på en-chips switches. Og det er virkelig godt, de har mange behagelige egenskaber. For eksempel har de næsten ikke noget internt design. Det betyder, at de er lettere at bryde. De går i stykker, hvad ellers, men de går, heldigvis, i stykker helt. I modulære enheder er der et stort antal fejl (meget uheldige), når det set fra nabosiden og kontrolplanet tilsyneladende fungerer, men for eksempel har en del af fabrikken svigtet, og det fungerer ikke med fuld kapacitet. Og trafikken balanceres baseret på, at den er fuldstændig funktionel, og vi kan få overbelastning.
Eller for eksempel opstår der problemer med backplane, fordi der også er høje hastigheds SerDes inde i den modulære enhed - det er virkelig komplekst indeni. Eller det synkroniserer eller synkroniserer ikke tabellerne mellem forwarding elementerne. Generelt indeholder enhver højtydende modulær enhed, der består af mange elementer, som regel stadig den samme Clos-netværk, men som er meget svær at diagnosticere. Ofte er det endda svært for selve leverandøren at diagnosticere.
Og det har et stort antal fejlscenarier, hvor enheden degraderer, men ikke falder helt ud af topologien. Da vi har et stort netværk, der aktivt bruger load balancing mellem identiske elementer, er netværket meget regelmæssigt, hvilket betyder, at én rute, hvor alt fungerer, ikke adskiller sig fra en anden rute. Det er mere fordelagtigt for os bare at miste nogle enheder i topologien, end at komme ud for situationer, hvor nogle af dem tilsyneladende fungerer, men ikke helt gør.
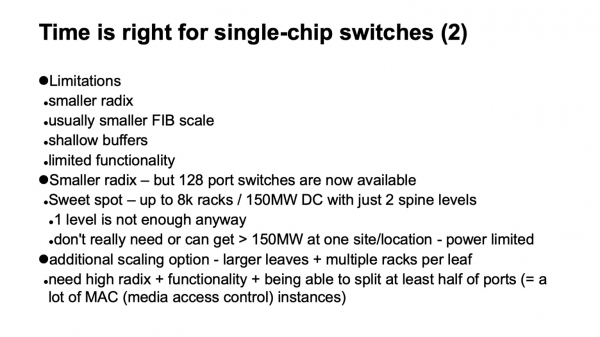
Den næste behagelige egenskab ved single-chip enheder er, at de udvikler sig bedre, hurtigere. De har som regel også en bedre kapacitet. Hvis vi ser på de store samlede konstruktioner, vi har, er kapaciteten pr. rack-enhed med de samme porte næsten dobbelt så god som hos modulære enheder. Enheder bygget omkring én chip bliver mærkbart billigere end modulære, og de forbruger mindre energi.
Men naturligvis er der også ulemper. For det første har de næsten altid en mindre radix end modulære enheder. Hvis vi kan få en enhed bygget omkring én chip til 128 porte, kan vi nu uden særlige problemer få modulære enheder til flere hundrede porte.
Det betyder en mærkbart mindre størrelse af forwarding-tabeller og generelt alt, der vedrører skalerbarheden af data plan. Overfladiske buffere. Og generelt en ret begrænset funktionalitet. Men det viser sig, at hvis man kender disse begrænsninger og tager sig af dem i tide, så er det ikke så skræmmende. At radix er mindre er ikke længere et problem med de nye enheder med en radix på 128, vi kan nu bygge i to lag af spine. Og mindre end to kan vi alligevel ikke bygge noget interessant med. Med ét niveau får man meget små klynger. Selv vores tidligere designs og krav oversteg dem stadig.
Hvis løsningen er på grænsen et sted, er der stadig en måde at skalere op på. Da det nederste niveau, hvor serverne forbinder, er ToR-switches eller leaf-switches, behøver vi ikke at tilslutte en enkelt rack til dem. Så hvis beslutningen mangler i to gange kapacitet, kan man overveje at bruge en switch med et større radix på bundeniveauet og tilslutte to til tre racks til en switch. Dette er også en mulighed, der har sine omkostninger, men som fungerer godt og kan være en god løsning, når man har brug for at fordoble størrelsen.
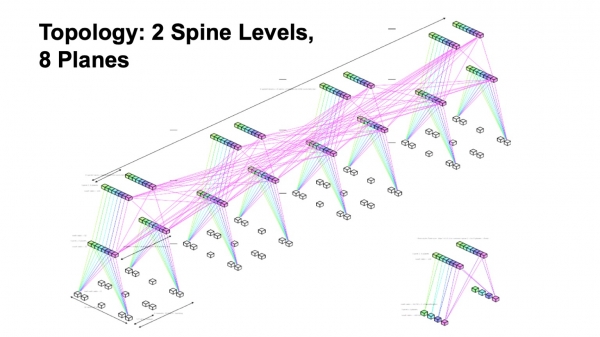
Sammenfattende bygger vi efter en topologi med to niveauer af spine-switches og otte lag af fabrikken.
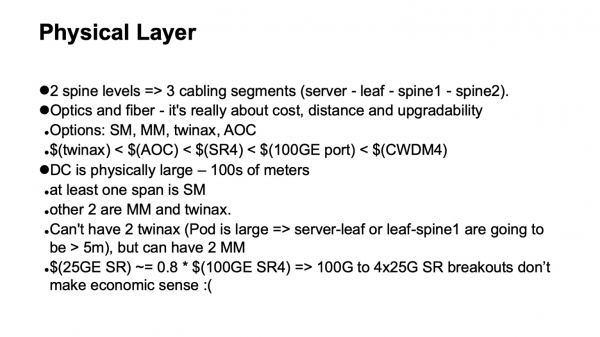
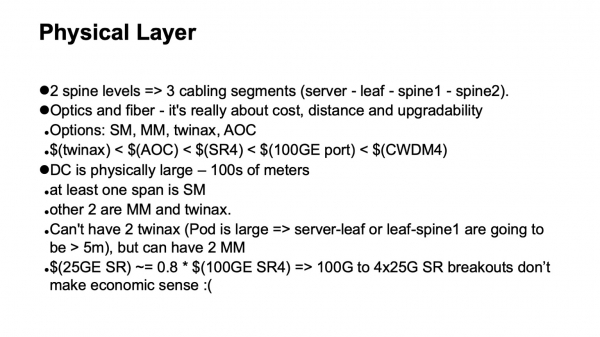
Hvad vil der ske med fysikken? Meget enkle beregninger. Hvis vi har to niveauer af spine-switches, så har vi i alt tre niveauer af switches, og vi forventer, at netværket har tre kabelsegmente: fra serverne til leaf-switches, til spine 1, til spine 2. De muligheder, vi kan bruge, er twinax, multimode, og single mode. Her skal man tage højde for, hvilken båndbredde der er tilgængelig, hvad omkostningerne vil være, de fysiske dimensioner, hvor langt vi kan strække kablerne, og hvordan vi vil opgradere.
Når det kommer til omkostninger, kan alt opstilles i en rækkefølge. Twinax er mærkbart billigere end aktiv optik, billigere end multimode transceivere, når man ser på afstanden fra enden, og lidt billigere end en 100-gigabit switchport. Og det, bemærk, er billigere end single mode optik, fordi der på strækninger, hvor single mode er nødvendigt, giver det mening at bruge CWDM i datacentre af forskellige grunde; det er ikke særlig bekvemt at arbejde med parallel single mode (PSM), da det kræver meget store fibrepakker, og hvis man holder sig til disse teknologier, får man omtrent denne prisstruktur.
En anden bemærkning: desværre fungerer det ikke så godt at bruge opdelte 100 til 4x25 multimode porte. På grund af SFP28-transceiverens konstruktionsspecifikationer er den ikke meget billigere end QSFP28 ved 100 Gbit. Og denne opdeling fungerer ikke godt for multimode.
En anden begrænsning er, at vores datacentre fysisk bliver store på grund af størrelsen af de beregningsmæssige klynger og antallet af servere. Dette betyder, at vi skal lave mindst ét stræk med singlemode. Igen, på grund af den fysiske størrelse af pods er det ikke muligt at håndtere to stræk med twinax-kabler (kobberkabler).
Resultatet er, at hvis vi optimerer efter pris og tager geometrien af denne konstruktion i betragtning, får vi ét stræk med twinax, ét stræk med multimode og ét stræk med singlemode ved brug af CWDM. Dette tager mulige opgraderingsveje i betragtning.
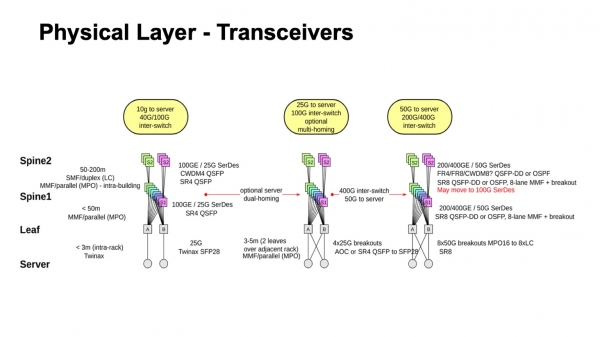
Det ser cirka således ud: hvad der har været for nylig, hvor vi bevæger os hen, og hvad der er muligt. Det er klart, mindst hvordan vi kan bevæge os mod 50-gigabit SerDes, både for multimode og for singlemode. Desuden, hvis vi ser på, hvad der er i singlemode-transceivere nu og i perspektivet for 400G, er der ofte tilfælde, hvor selv når 50G SerDes ankommer på den elektriske side, kan der gå 100 Gbps per bane ind i fiberoptikken. Derfor er det helt muligt, at i stedet for et skift til 50, vil vi se et skift til 100-gigabit SerDes og 100 Gbps per bane, fordi mange leverandører forventer, at de vil være tilgængelige ret snart. Perioden, hvor 50G SerDes var de hurtigste, ser ikke ud til at være særlig lang, fordi de første 100G SerDes allerede skulle rulles ud næste år. Og efter et stykke tid vil de måske koste rimelige penge.
En anden nuance ved valget af teknologi. I princippet kan vi allerede nu anvende 400- eller 200-gigabit porte ved brug af 50G SerDes. Men det viser sig, at der ikke er meget mening i dette, fordi som jeg nævnte tidligere, ønsker vi en tilstrækkelig stor radix på switchene, inden for rimelighedens grænser. Vi ønsker 128. Og hvis vores chipkapacitet er begrænset og vi øger hastigheden på forbindelsen, falder radix naturligt, der er ingen mirakler.
Og vi kan øge den samlede kapacitet ved at tilføje flere planer, og der er ikke særlige omkostninger, man kan tilføje antallet af planer. Hvis vi mister radix, skal vi indføre et ekstra lag, så med de nuværende omstændigheder og den maksimalt tilgængelige kapacitet pr. chip viser det sig, at det er mere effektivt at bruge 100-gigabit porte, fordi de giver os mulighed for at opnå en større radix.
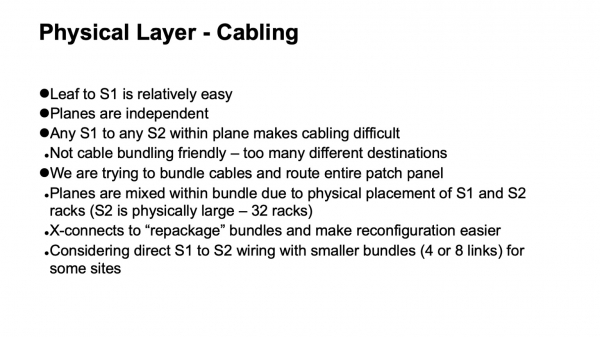
Det næste spørgsmål er, hvordan fysikken er organiseret, men allerede fra perspektivet af kabelinfrastrukturen. Det viser sig, at den er organiseret på en ret sjov måde. Kablerne mellem leaf-switchene og de første niveau spine-switches — der er ikke så mange forbindelser, alt bygger relativt enkelt. Men hvis vi tager en enkelt plan, hvad der sker indeni — der skal alle de første niveau spine-switches forbindes med alle de andre niveau spine-switches.
Derudover er der som regel nogle ønsker til, hvordan det skal se ud inde i datacentret. For eksempel ønskede vi meget at samle kablerne i bundter og trække dem således, at et høj densitet patch panel går helt ind i et andet patch panel, så der ikke er et kaos af længder. Vi lykkedes med at løse denne opgave. Hvis man ser på den logiske topologi, kan man se, at planerne er uafhængige, hver plan kan bygges for sig selv. Men når vi tilføjer sådan en bundling og ønsker at trække et helt patch panel ind i et andet patch panel, er vi nødt til at blande forskellige planer inden for et bundt og indføre en mellemstruktur i form af optiske cross-connects for at ompakke dem fra, hvordan de blev samlet på et segment, til hvordan de vil blive samlet på et andet segment. Takket være dette får vi en behagelig funktion: al den komplekse switching forbliver inden for rackene. Når der skal flettes noget meget meget, "udrulle planerne", som det nogle gange kaldes i Clos-netværk, er alt dette koncentreret inden for et enkelt rack. Vi har ikke meget opsplittede, lige ned til individuelle links, switching mellem rackene.
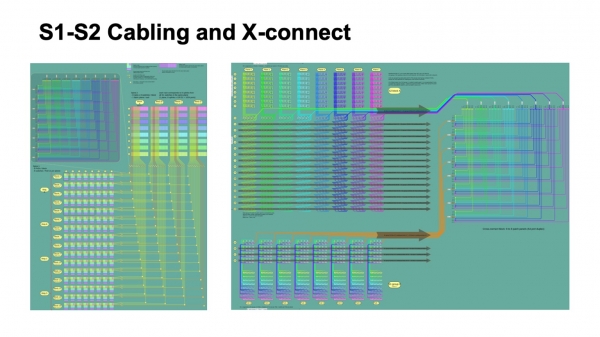
Sådan ser det ud fra den logiske organisering af kabelinfrastrukturen. På billedet til venstre repræsenterer de farverige blokke blokke af første niveau spine-switches, otte stykker hver, og de fire bundter af kabler, der går fra dem og krydser med bundterne, der kommer fra spine-2-switches.
De små firkanter angiver kryds. Øverst til venstre er der en fremvisning af hvert sådan kryds, som faktisk er en modul krydsforbindelse 512 til 512 porte, der genpakker kabler således, at de kommer ind i et enkelt rack, hvor kun én plane er spine-2. Til højre er fremvisningen af dette billede lidt mere detaljeret i forhold til flere Pods på niveau spine-1, og hvordan det pakkes i kryds, samt hvordan det kommer til niveau spine-2.
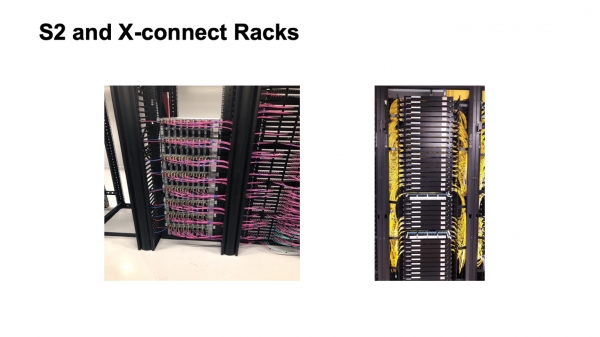
Sådan ser det ud. Et endnu ikke helt samlet spine-2 rack (til venstre) og krydsforbindelsesracket. Desværre er der ikke meget at se der. Hele denne konstruktion udbygges lige nu i et af vores store datacentre, som er i udvidelse. Dette er et arbejde under udførelse, det vil se bedre ud, og vil være bedre fyldt.
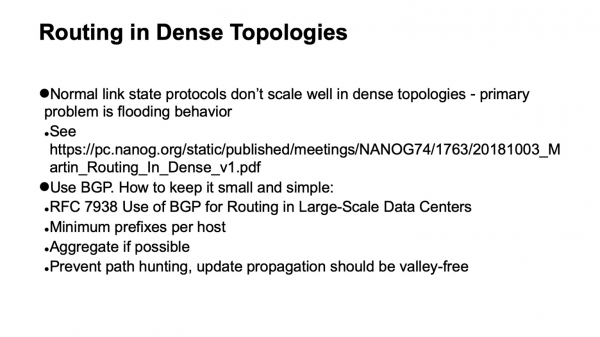
Et vigtigt spørgsmål: vi har valgt en logisk topologi, bygget fysikken. Hvad vil der ske med control plane? Det er godt kendt fra driftsoplevelser, at der er et antal præsentationer, der påpeger, at link state-protokoller er gode, og de er behagelige at arbejde med, men desværre skalerer de dårligt i en tæt forbundet topologi. Og der er en grundlæggende faktor, der hindrer dette - det er, hvordan flooding fungerer i link state-protokoller. Hvis man blot tager flooding algoritmen og ser på, hvordan vores netværk er konstrueret, er det tydeligt, at der vil være en meget stor fanout på hvert trin, og det vil simpelthen overbelaste control plane med opdateringer. Specifikt sådanne topologier med den traditionelle flooding-algoritme i link state-protokoller klarer sig meget dårligt.
Valget er at bruge BGP. Hvordan man korrekt forbereder det, er beskrevet i RFC 7938 om brugen af BGP i store datacentre. De grundlæggende ideer er enkle: minimalt antal præfikser pr. vært og generelt minimalt antal præfikser i netværket, bruge aggregering, hvis det er muligt, og undertrykke path hunting. Vi ønsker en meget omhyggelig, meget kontrolleret spredning af opdateringer, det, der kaldes valley free. Vi ønsker, at opdateringer, når de bevæger sig gennem netværket, kun skal udfoldes én gang. Hvis de oprinder nedenunder, bevæger de sig opad og udfolder sig ikke mere end én gang. Der må ikke være zigzag. Zigzag er meget skadeligt.
For this, we use a relatively simple scheme to utilize the basic BGP mechanisms. That is, we use eBGP operating on link local, and the autonomous systems are assigned as follows: an autonomous system on the ToR, an autonomous system for the entire block of spine-1 switches of one Pod, and a shared autonomous system for the entire Top of Fabric. It is not difficult to see and verify that even the normal behavior of BGP gives us the propagation of updates that we desire.
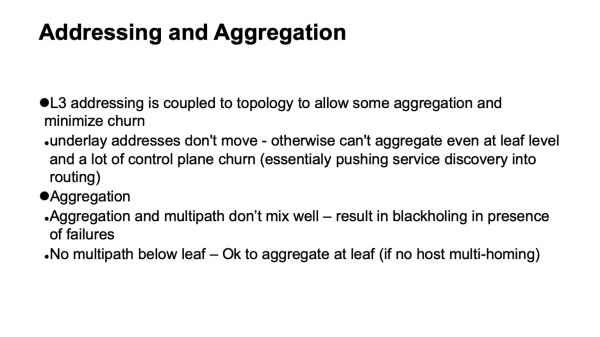
Naturally, we have to design the addressing and address aggregation so that it is compatible with how routing is structured, ensuring the stability of the control plane. L3 addressing in the transport is tied to the topology, because without it, aggregation cannot be achieved; individual addresses will sneak into the routing system. One more thing is that aggregation unfortunately does not mix well with multi-path, because when we have multi-path and aggregation, everything is fine when the entire network is operational and there are no failures. Unfortunately, as soon as failures occur in the network and the symmetry of the topology is lost, we can get to the point from which the aggregate was announced, from which we cannot proceed to where we need to go. Therefore, it is best to aggregate where there is no further multi-path, in our case this is the ToR switches.
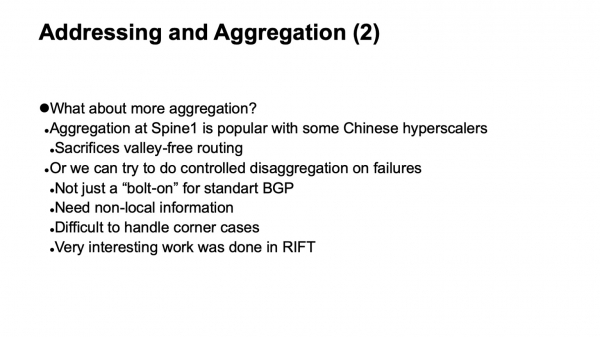
In fact, aggregation is possible, but carefully. If we can manage controlled de-aggregation in the event of failures in the network. But this is quite a challenging task; we even estimated whether it can be done, whether additional automation can be attached, and finite state machines that will correctly trigger BGP to achieve the desired behavior. Unfortunately, handling corner cases is very non-obvious and difficult, and attaching external equipment to BGP does not solve this issue well.
Very interesting work has been done in this regard within the RIFT protocol, which will be discussed in the next presentation.
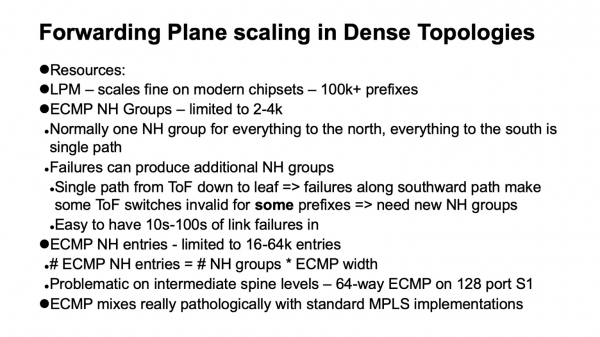
Another important aspect is how data planes scale in dense topologies where we have a large number of alternative paths. Here, several additional data structures are used: ECMP groups, which in turn describe groups of Next Hop.
I et normalt fungerende netværk, uden fejl, når vi bevæger os opad i Clos-topologi, er det tilstrækkeligt at bruge kun én gruppe, fordi alt, der ikke er lokalt, beskrives af defaulten, og vi kan gå opad. Når vi bevæger os nedad mod syd, er alle stierne ikke ECMP, det er single path-stier. Alt er godt. Problemet og en særprægethed ved den klassiske Clos-topologi er, at hvis vi ser på toppen af fabrikken, har ethvert element én vej til ethvert element dernede. Hvis der opstår fejl langs denne vej, bliver dette specifikke element øverst i fabrikken ugyldigt for de præfikser, der ligger bag den brudte vej. Men for de øvrige er det gyldigt, og vi er nødt til at bryde ECMP-grupperne og indføre en ny status.
Hvordan ser skalerbarheden i data plane ud på moderne enheder? Hvis vi laver LPM (longest prefix match), fungerer det hele ganske godt, over 100.000 præfikser. Hvis vi taler om Next Hop-grupper, er det dog værre, 2-4 tusinde. Hvis vi taler om en tabel, der indeholder beskrivelsen af Next Hops (eller adjacencies), er det et sted mellem 16.000 og 64.000. Og det kan blive et problem. Her kommer vi til en interessant afstikker: hvad skete der med MPLS i datacentre? Generelt ville vi gerne have det gjort.
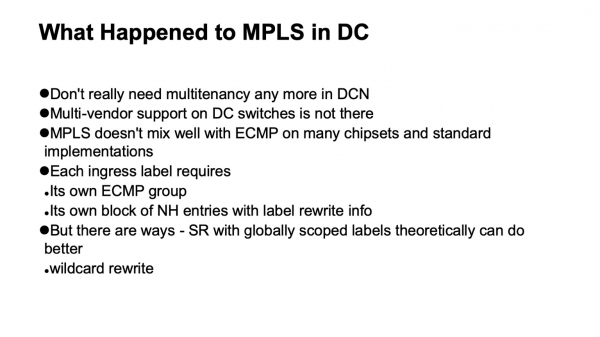
To ting skete. Vi lavede mikrosementering på værterne, så vi havde ikke brug for at gøre det i netværket. Det var ikke særlig godt med støtte fra forskellige leverandører, især ikke med åbne implementeringer på white boxes med MPLS. Desuden, MPLS, i det mindste dens traditionelle implementeringer, passer desværre meget dårligt sammen med ECMP. Og det er grunden til det.
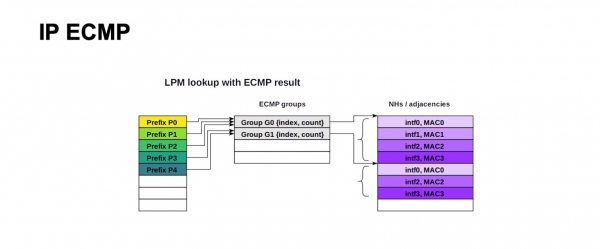
Sådan ser strukturen af ECMP-forwarding for IP ud. Et stort antal præfikser kan bruge den samme gruppe og den samme blok Next Hops (eller adjacencies, som det kan kaldes forskelligt i forskellige dokumenter for forskellige enheder). Pointen er, at det beskrives som den udgående port og hvilken MAC-adresse, der skal omskrives for at komme til den rigtige Next Hop. For IP ser det ganske enkelt ud, man kan bruge et meget stort antal præfikser på den samme gruppe, den samme blok Next Hops.
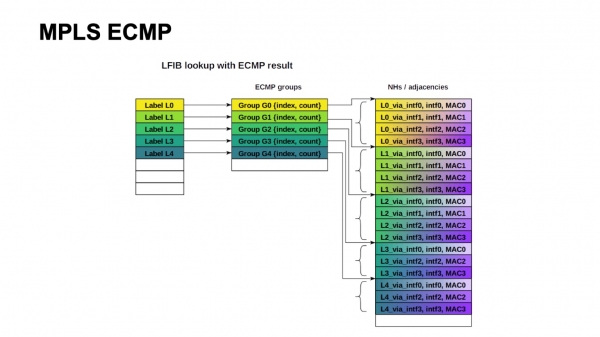
Den klassiske MPLS-arkitektur indebærer — afhængigt af den udgående grænseflade kan etiketten omskrives til forskellige værdier. Derfor skal vi holde en gruppe og en blok Next Hops for hver indgående etikette. Og dette skalerer desværre ikke.
Det er ikke svært at se, at vi i vores konstruktion havde brug for omkring 4000 ToR-switches, med en maksimal bredde på 64 ECMP-veje, hvis vi bevæger os fra spine-1 til spine-2. Vi kan knap nok presse os ind i én ECMP-gruppe tabel, hvis kun én præfiks fra ToR går ud, og vi kan overhovedet ikke presse os ind i Next Hops-tabellen.
Alt er ikke håbløst, fordi arkitekturer som Segment Routing indebærer globale mærker. Formelt set kunne man igen samle alle disse Next Hops blokke. Det kræver en operation som wildcard: at tage et mærke og omskrive det til det samme uden et konkret værdifuldt. Men desværre er det ikke særlig til stede i de tilgængelige implementeringer.
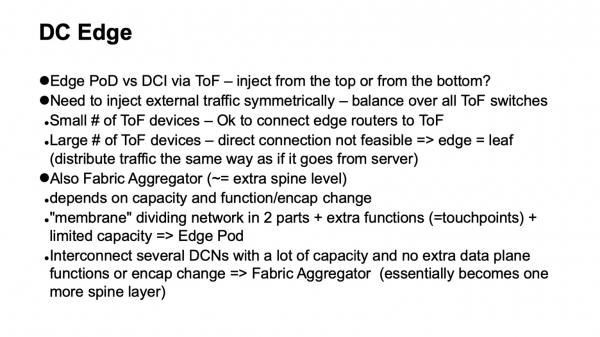
Og endelig skal vi bringe ekstern trafik ind i datacentret. Hvordan gør vi det? Tidligere blev trafikken indført i Clos-netværk ovenfra. Det vil sige, der var grænseroutere, der blev tilsluttet alle enheder på toppen af fabric. Denne løsning fungerer helt fint i små og mellemstore størrelser. Desværre, for at bringe trafik ind på en symmetrisk måde til hele netværket, skal man komme til alle elementer på toppen af fabric samtidig, og når de bliver mere end hundrede, viser det sig, at vi har brug for en stor radix også på grænserouterne. Generelt koster det penge, fordi grænserouterne er mere funktionelle, portene på dem vil være dyrere, og det resulterer i en ikke særlig pæn konstruktion.
En anden mulighed er at føre sådan trafik ind fra bunden. Det er ikke svært at overbevise sig om, at Clos-topologien er bygget på en sådan måde, at trafik, der kommer ind fra bunden, dvs. fra ToR, fordeles jævnt på niveauerne til hele Top of fabric over to iterationer og belaster hele netværket. Derfor indfører vi en særlig type Pod, Edge Pod, der sikrer ekstern forbindelse.
Der er endnu en mulighed. For eksempel gør Facebook dette. Det kalder de Fabric Aggregator eller HGRID. Der indføres et ekstra spine-niveau for at forbinde flere datacentre. En sådan konstruktion er mulig, hvis vi ikke har yderligere funktioner eller ændringer i indkapslingen på forbindelserne. Hvis der er det, så er der ekstra touchpoints, hvilket gør det kompliceret. Som regel opstår der flere funktioner og en slags membran, der adskiller forskellige dele af datacentret. Det er ikke værd at gøre en sådan membran stor, men hvis den er nødvendig af en eller anden grund, så er det fornuftigt at overveje at flytte den, gøre den så bred som muligt og flytte den til værterne. Dette gøres for eksempel af mange cloud-operatører. De har overlays, som begynder med værter.
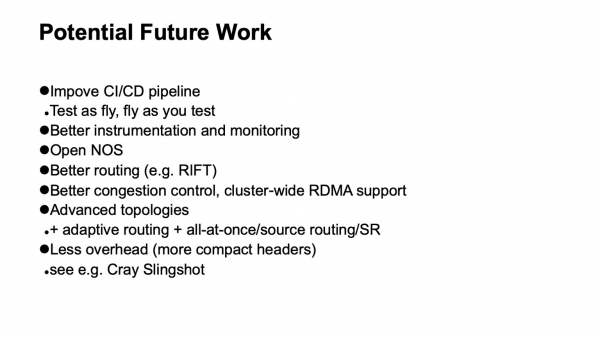
Hvilke udviklingsmuligheder ser vi? Først og fremmest forbedring af CI/CD-pipeline-supporten. Vi ønsker at flyve, som vi tester, og at teste, som vi flyver. Det lykkes ikke så godt, fordi infrastrukturen er stor, og det er umuligt at duplikere den til testformål. Vi skal forstå, hvordan vi kan integrere testelementer i den arbejdende infrastruktur uden at få den til at falde.
Bedre instrumentering og bedre overvågning er sjældent overflødige. Det hele handler om balance mellem indsats og udbytte. Hvis det kan tilføjes med rimelige ressourcer — så er det meget godt.
Åbne operativsystemer til netværksenheder. De bedste protokoller og de bedste routingsystemer, for eksempel RIFT. Der er også behov for forskning i anvendelsen af de bedste metoder til congestion control, og muligvis indførelse af, i det mindste på nogle punkter, støtte for RDMA inden for klyngen.
Hvis man ser på det i et længere perspektiv, er der behov for avancerede topologier og muligvis netværk, der bruger mindre overhead. Blandt de nyeste ting er der for nylig blevet publiceret oplysninger om fabriksteknologi til HPC Cray Slingshot, som er baseret på commodity Ethernet, men med muligheden for at bruge betydeligt kortere overskrifter. Som resultat heraf mindskes overhead.
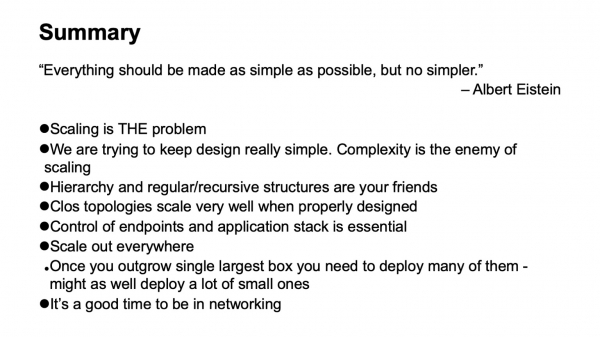
Alt skal gøres så enkelt som muligt, men ikke simplere. Kompleksitet er en fjende af skalerbarhed. Enkelhed og regelmæssige strukturer er vores venner. Hvis det er muligt at skalere ud et sted — så gør det. Generelt er det spændende at arbejde med netværksteknologier nu. Der sker mange interessante ting. Tak.
Kilde: habr.com
