

Hej, Habr! I de sidste par måneder har vi været i en meget interessant situation, og jeg vil gerne dele vores historie om skalering af infrastrukturen. I denne periode er SberMarket vokset fire gange i antal ordrer og har lanceret servicen i 17 nye byer. Den eksplosive vækst i efterspørgslen efter levering af dagligvarer har krævet, at vi skalerer infrastrukturen. Læs om de mest interessante og nyttige konklusioner nedenfor.
Mit navn er Dima Bobylev, jeg er teknisk direktør for SberMarket. Da det er det første indlæg i vores blog, vil jeg sige et par ord om mig selv og virksomheden. Sidste efterår deltog jeg i konkurrencen om unge ledere i Runet. Til konkurrencen om hvordan vi i SberMarket ser på den interne kultur og tilgangen til udviklingen af servicen. Selvom jeg ikke vandt konkurrencen, så formulerede jeg de grundlæggende principper for udviklingen af IT-økosystemet.
Når man leder et team, er det vigtigt at forstå og finde balancen mellem, hvad der er nødvendigt for forretningen, og behovene hos hver enkelt udvikler. I øjeblikket vokser SberMarket 13 gange år for år, og dette påvirker produktet, da det kræver konstant at øge mængderne og udviklingstempoet. På trods af dette afsætter vi tilstrækkelig tid til udviklerne til foranalyse og kvalitetskodning. Den etablerede tilgang hjælper ikke kun i skabelsen af et fungerende produkt, men også i dets videre skalering og udvikling. Som resultat af denne vækst er SberMarket allerede blevet en leder blandt tjenester til levering af dagligvarer: vi leverer dagligt omkring 18.000 ordrer om dagen, selvom der i begyndelsen af februar var omkring 3500.
En gang bad en kunde SberMarket-kureren om at levere dagligvarer til ham kontaktløst - direkte på balkonen.
Men lad os komme til sagen. I de seneste par måneder har vi aktivt arbejdet på at skalere vores virksomheds infrastruktur. Behovet for dette skyldtes både eksterne og interne faktorer. Samtidig med udvidelsen af kundebasen er antallet af tilknyttede butikker steget fra 90 i starten af året til mere end 200 i midten af maj. Vi forberedte os selvfølgelig ved at reservere den grundlæggende infrastruktur og regnede også med muligheden for både vertikal og horisontal skalering af alle virtuelle maskiner placeret i Yandex's cloud. Men erfaringen viste, at alt, hvad der kan gå galt, vil gå galt. Og i dag vil jeg dele nogle af de mest interessante situationer, der opstod i løbet af disse uger. Jeg håber, at vores erfaringer vil være nyttige for dig.
Slave er i fuld beredskab
Allerede før pandemiens begyndelse oplevede vi en stigning i forespørgslerne på vores backend-servere. Tendensen til at bestille produkter med hjemlevering begyndte at tage fart, og med indførelsen af de første selv-isoleringsforanstaltninger i forbindelse med COVID-19, voksede belastningen dramatisk i løbet af dagen. Der opstod et behov for hurtigt at aflaste master-serverne i den primære database og overføre en del af læseforespørgslerne til slave-replikaservere.
Vi forberedte os på dette skridt i god tid, og for at kunne foretage et sådant manøvrer var der allerede sat 2 slave-servere i drift. Disse servere blev primært brugt til batch-opgaver med generering af informationsfeeds til datadelingspartnere. Disse processer skabte unødig belastning og blev helt berettiget flyttet "uden for boksen" et par måneder tidligere.
Da der fandt replikation sted på Slave, overholdt vi konceptet om, at applikationerne kun kunne arbejde med dem i read only-tilstand. Disaster Recovery Planen forudså, at i tilfælde af en katastrofe kunne vi blot montere Slave på pladsen for Master og omdirigere alle skrive- og læseforespørgsler til Slave. Men vi ønskede også at bruge replikaterne til analytiske behov, så serverne blev ikke helt overført til read only-status, og hver vært havde sit eget sæt brugere, hvoraf nogle havde skriveadgang til at gemme mellemresultaterne af beregningerne.
Indtil et bestemt niveau af belastning havde vi nok kapacitet i både læsning og skrivning ved behandling af http-forespørgsler. I midten af marts, lige da Sbermarket besluttede at gå helt over til remote arbejde, begyndte vi at opleve en markant stigning i RPS. Flere og flere af vores kunder gik i selvisolering eller arbejdede hjemmefra, hvilket påvirkede belastningsniveauerne.
Ydelsen fra "master" blev ikke længere tilstrækkelig, så vi begyndte at flytte nogle af de tungeste læseforespørgsler til en replika. For at transparent styre forespørgsler til skrivning til master og læsning til slave, brugte vi ruby gem "". Vi oprettede en speciel bruger med suffikset _readonly uden skriveadgang. Men på grund af en fejl i konfigurationen af en af værterne, blev nogle skrivespørgsler sendt til slave-serveren i navnet på en bruger, der havde de relevante rettigheder.
Problemet viste sig ikke straks, da den øgede belastning fik slaverne til at hænge efter. Datainkonsistens blev opdaget om morgenen, da slaverne ikke havde "indhentet" master efter natlige importer. Vi tilskrev dette den høje belastning på selve tjenesten og importen forbundet med opstarten af nye butikker. Men at levere data med flere timers forsinkelse var uacceptabelt, og vi omdirigerede processerne til den anden analytiske slave, da den havde større ressourcer og ikke var belastet af læseforespørgsler (hvorfor vi også forklarede for os selv, at der ikke var lag i replikationen).fleste afDa vi fandt frem til årsagerne til "udvidelsen" af hoved-slaven, var den analytiske allerede ude af drift af samme årsag. På trods af at vi havde to ekstra servere, som vi planlagde at flytte belastningen til i tilfælde af masterfejl, viste det sig, at der i kritiske øjeblikke ikke var nogen.
Men da vi ikke kun lavede dump af databasen (gendannelsen på det tidspunkt tog omkring 5 timer), men også snapshot af master-serveren, lykkedes det at starte replikationen inden for 2 timer. Dog ventede vi efter dette på at nødvendiggøre replikationsloggen i en længere periode (fordi processen kører i en enkelttråd, men det er en helt anden historie).
Men da vi ikke kun lavede en dump af databasen (gendannelsen tog omkring 5 timer på det tidspunkt), men også en snapshot af master-serveren, lykkedes det at starte replikatet inden for 2 timer. Dog ventede der os derefter en langvarig rulling af replikationsloggen (fordi processen kører i en enkelttrådet tilstand, men det er en helt anden historie).
Output: Efter en sådan hændelse blev det klart, at vi skulle opgive praksis med at begrænse skrivning for brugere og erklære hele serveren som readonly. Med denne tilgang kan vi være sikre på, at replikaerne vil være tilgængelige på kritiske tidspunkter.
Optimering af selv én tung forespørgsel kan "bringe databasen tilbage til livet".
Selvom vi konstant opdaterer kataloget på hjemmesiden, havde de forespørgsler, vi sendte til slave-serverne, en lille forsinkelse i forhold til master. Den tid, det tog at opdage og løse problemet med de "pludselig ude af drift" slaver, var længere end den "psykologiske grænse" (i mellemtiden kunne der være blevet opdateret priser, og kunderne ville have set forældede data), og vi blev nødt til at omdirigere alle forespørgsler til den primære databaser server. Som følge heraf kørte hjemmesiden langsomt... men den kørte i det mindste. Og mens slaverne blev genoprettet, havde vi ikke andet valg end at optimere.
Mens slave-serverne blev genoprettet, trak minutterne sig langsomt, master forblev overbelastet, og vi kastede alle kræfter ind på at optimere aktive opgaver i henhold til "Pareto-reglen": vi valgte de top-forespørgsler, der gav den største del af belastningen, og begyndte tuning. Dette blev gjort direkte "on the fly".
En interessant effekt var, at en overbelastet MySQL reagerer selv på ubetydelige forbedringer i processerne. Optimering af et par forespørgsler, som kun gav 5 % af den samlede belastning, viste allerede en mærkbar lettelse af CPU'en. Som følge heraf lykkedes det os at sikre et acceptabelt ressourceoverskud til Master's arbejde med databasen og få den nødvendige tid til at genoprette replikaerne.
Output: Selv en lille optimering gør det muligt at "overleve" ved overbelastning i flere timer. Det var præcis, hvad vi havde brug for under genoprettelsesprocessen for serverne med replikaer. Forresten vil vi diskutere den tekniske del af optimering af forespørgsler i et af de kommende indlæg. Så husk at abonnere på vores blog, hvis det kan være nyttigt for dig.
Organiser overvågning af partner-tjenesternes funktionalitet.
Vi håndterer kundeordrer, og derfor interagerer vores tjenester konstant med tredjeparts-API'er - det er gateways til at sende SMS'er, betalingsplatforme, routing-systemer, geokodere, FNS-tjenester og mange andre systemer. Og da belastningen begyndte at stige hurtigt, begyndte vi at støde på begrænsningerne fra API'erne hos vores partner-tjenester, som vi ikke tidligere havde tænkt på.
Uventede overskridelser af kvoterne for partnerskaber kan føre til nedetid for din egen service. Mange API'er blokerer kunder, der overskrider grænserne, og i nogle tilfælde kan et overskud af forespørgsler overbelaste produktionen hos partneren.
For eksempel, da antallet af leveringer voksede, kunne de tilknyttede tjenester ikke håndtere distributionen og rutebestemmelsen. Resultatet blev, at ordrer blev afgivet, men tjenesten, der skabte ruten, ikke fungerede. Det skal siges, at vores logistikere gjorde det næsten umulige under disse forhold, og et klart samarbejde i teamet hjalp med at kompensere for de midlertidige fejl i tjenesterne. Men en så høj mængde forespørgsler kan ikke behandles manuelt konstant, og efter et stykke tid ville vi have stået over for en uacceptabel kløft mellem ordrer og deres opfyldelse.
Der blev truffet en række organisatoriske foranstaltninger, og et velfungerende team hjalp os med at vinde tid, mens vi indgik nye aftaler og ventede på modernisering af tjenesterne fra visse partnere. Der findes også andre API'er, der imponerer med høj udholdenhed og urimelige takster ved høj trafik. For eksempel brugte vi i starten et velkendt kort-API til at bestemme leveringsadressen. Men i slutningen af måneden modtog vi en regning på næsten 2 millioner rubler. Derefter besluttede vi hurtigt at erstatte det. Jeg vil ikke lave reklame, men jeg vil sige, at vores omkostninger blev betydeligt reduceret.
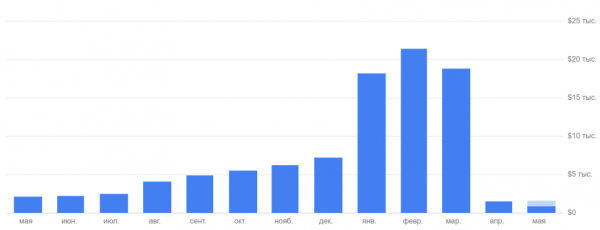
Output: Det er nødvendigt at overvåge driftbetingelserne for alle partnerskaber og have dem i mente. Selv hvis det i dag synes, at de er "med stor margen", betyder det ikke, at de i morgen ikke kan blive en hindring for væksten. Og selvfølgelig er det bedre at forhandle om finansielle betingelser for de øgede forespørgsler til tjenesten på forhånd.
Nogle gange viser det sig, at “” (c) ikke hjælper
Vi kender til "flaskehalse" i den primære database eller på applikationsservere, men ved skalering kan problemerne vise sig der, hvor man mindst forventer dem. Til fuldtekst søgning på vores hjemmeside bruger vi Apache Solr. Med stigende belastning bemærkede vi en nedgang i svartiden, og serverens CPU-belastning nåede op på 100%. Hvad kan være enklere — vi giver Solr-containeren flere ressourcer.
I stedet for det forventede løft i ydeevnen, "døde" serveren bare. Den blev straks belastet op til 100% og svarede endnu langsommere. Oprindeligt havde vi 2 kerner og 2 GB RAM. Vi besluttede at gøre det, som normalt hjælper — vi gav serveren 8 kerner og 32 GB. Alt blev meget værre (hvordan og hvorfor, vil vi fortælle i et separat indlæg).
Efter et par dage havde vi forstået detaljerne i spørgsmålet og opnået optimal ydeevne med 8 kerner og 32 GB RAM. Denne konfiguration gør det muligt stadig at fortsætte med at øge belastningen, hvilket er meget vigtigt, fordi væksten ikke kun sker i antallet af kunder, men også i antallet af tilsluttede butikker — inden for 2 måneder er deres antal fordoblet.
Output: Standardmetoder som "tilføj mere hardware" virker ikke altid. Så ved skalering af enhver service er det vigtigt at forstå, hvordan den bruger ressourcer, og på forhånd teste dens ydeevne under nye forhold.
Stateless — nøglen til enkel horisontal skalering
Generelt følger vores team den kendte tilgang: tjenester skal være stateless og uafhængige af kørselmiljøet. Dette gjorde det muligt for os at håndtere væksten i belastningen med simpel horisontal skalering. Men vi havde én undtagelse i servicen – en behandler for lange baggrundsopgaver. Den håndterede afsendelse af e-mails og sms'er, behandling af events, generering af feeds, import af priser og lagre samt behandlingen af billeder. Det viste sig, at den var afhængig af lokal filopbevaring og kun eksisterede i ét eksemplar.
Da antallet af opgaver i behandlingskøen steg (hvilket naturligt skete med stigningen i antallet af bestillinger), blev værtens ydeevne, hvor både behandlingssystemet og filopbevaringen var placeret, en begrænsende faktor. Dette resulterede i, at opdateringen af sortimentet og priserne, samt udsendelsen af notifikationer til brugerne, stoppede, og mange andre kritiske funktioner sad fast i køen. Ops-teamet migrerede hurtigt filopbevaringen til en S3-lignende netværkslagring, hvilket gjorde det muligt for os at finde flere kraftfulde maskiner til at skalere baggrundsbehandleren.
Output: Reglen om Stateless skal overholdes for alle komponenter uden undtagelse, selvom det virker som om 'her vil vi bestemt ikke støde ind i problemer'. Det er bedre at bruge lidt tid på korrekt organisering af arbejdet for alle systemer, end hastigt at gen skrive koden og reparere en tjeneste, der oplever overbelastning.
7 principper for intensiv vækst
På trods af tilgængeligheden af ekstra kapaciteter, løb vi ind i flere forhindringer under væksten. I denne periode er antallet af bestillinger steget med mere end 4 gange. Vi leverer nu over 17.000 bestillinger om dagen i 62 byer og planlægger at udvide geografien endnu mere — i første halvår af 2020 forventes starten af en tjeneste over hele Rusland. For at kunne håndtere den voksende belastning, med hensyn til de allerede gjorde erfaringer, har vi formuleret 7 grundprincipper for at arbejde under konstant vækst:
- Incident Management. Vi har oprettet et board i Jira, hvor hver hændelse afspejles i form af en ticket. Dette vil hjælpe med effektivt at prioritere og udføre opgaver relateret til hændelsen. I bund og grund er det ikke skræmmende at lave fejl — det skræmmer at lave de samme fejl to gange. I de tilfælde, hvor hændelser gentager sig, før vi kan rette årsagen, skal der være en handlingsinstruktion klar, da det er vigtigt at reagere lynhurtigt under høj belastning.
- Overvågning kræves for alle elementer i infrastrukturen uden undtagelse. Netop takket være det kunne vi forudsige belastningsvæksten og korrekt vælge 'flaskehalse' til prioritering af afhjælpning. Sandsynligvis vil alt, hvad du ikke havde tænkt på, gå i stykker eller begynde at hænge ved høj belastning. Derfor er det bedst at oprette nye alarmer straks efter de første hændelser for at overvåge og forudse dem.
- Korrekte alarmer er helt nødvendige ved pludselige belastningsstigninger. For det første skal de informere om, hvad der præcist er gået i stykker. For det andet, der må ikke være for mange alarmer, da en overflod af ikke-kritiske alarmer fører til, at alle meddelelser ignoreres helt.
- Applikationer skal være stateless. Vi har konstateret, at der ikke bør være undtagelser fra denne regel. Der er brug for fuld uafhængighed fra køremiljøet. Til dette kan du gemme delte data i en database eller f.eks. direkte i S3. Og endnu bedre at følge reglerne. Under en pludselig stigning i belastningen er der ikke tid til at optimere koden, og man må håndtere belastningen ved direkte at øge beregningsressourcerne og implementere horisontal skalerings.
- Kvoter og ydeevne fra eksterne tjenester. Ved hurtig vækst kan problemet ikke kun opstå i din infrastruktur, men også i den eksterne tjeneste. Det mest frustrerende er, når det sker ikke på grund af en fejl, men på grund af nåede kvoter eller grænser. Så eksterne tjenester skal kunne skalere lige så godt som dig selv.
- Opdel processer og køer. Det hjælper meget, når der opstår flaskehalse på en af gatewayene. Vi ville ikke have oplevet forsinkelser i datatransmissionen, hvis fyldte SMS-udsendelseskøer ikke havde forstyrret udvekslingen af meddelelser mellem informationssystemerne. Og det ville være lettere at øge antallet af arbejdere, hvis de arbejdede separat.
- Finansielle realiteter. Når datastreams eksploderer, er der ikke tid til at tænke på takster og abonnementer. Men de skal huskes, især hvis du er en lille virksomhed. En stor regning kan komme fra ejeren af enhver API, samt din hostingudbyder. Så det er vigtigt at læse kontrakterne grundigt.
Konklusion
Ikke uden tab, men vi har overvundet denne fase, og i dag stræber vi efter at følge alle de fundne principper, mens hver maskine har mulighed for nemt at øge ydeevnen med op til 4 gange for at håndtere uventede situationer.
I de kommende indlæg vil vi dele vores erfaring med at undersøge fald i ydeevne i Apache Solr, samt tale om optimering af forespørgsler og hvordan samarbejdet med skattemyndighederne hjælper virksomheden med at spare penge. Tilmeld dig vores blog for ikke at gå glip af noget, og fortæl os i kommentarerne, om du har oplevet lignende problemer under stigninger i trafik.
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Har du oplevet forsinkelse/nedbrud af tjenesten ved pludselig stigning i belastningen på grund af:
55,6%Manglende mulighed for hurtigt at tilføje beregningsressourcer10
16,7%Begrænsninger fra hostingudbyderens infrastruktur3
33,3%Begrænsninger fra tredjeparts API'er6
27,8%Overtrædelse af principles stateless i dine applikationer5
88,9%Suboptimalitet i koden for egne tjenester16
18 brugere har stemt. 6 brugere har undladt at stemme.
Kilde: habr.com
