

I dag kræves høj tilgængelighed af tjenester altid og overalt, ikke kun i store dyre projekter. Midlertidigt utilgængelige hjemmesider med beskeden "Undskyld, der udføres vedligeholdelse" ses stadig, men vækker som regel blot et medfølende smil. Når vi tilføjer liv i skyerne, hvor det kun kræver et API-kald at starte en ekstra server, og vi ikke behøver at bekymre os om "hardwarens" drift, er der ikke længere nogen undskyldning for, hvorfor kritiske systemer ikke er bygget pålideligt med klyngeteknologi og redundans.
Vi vil fortælle om de løsninger, vi overvejede for at sikre pålideligheden af databaser i vores tjenester, og hvad vi kom frem til. Derudover en demo med vidtrækkende konklusioner.
Legacy i arkitekturen for høj tilgængelighed
Dette bliver endnu tydeligere i forhold til udviklingen af forskellige open source-systemer. Gamle løsninger var tvunget til at tilføje teknologier for høj tilgængelighed i takt med den stigende efterspørgsel. Og kvaliteten var forskellig. Løsninger i den nye generation har høj tilgængelighed som grundlag for deres arkitektur. For eksempel positionerer MongoDB klyngen som den primære anvendelse. Klyngen skaleres horisontalt, hvilket er en stærk konkurrencefordel ved denne DBMS.
Lad os vende tilbage til PostgreSQL. Dette er et af de ældste og mest populære open source-projekter, hvis første udgivelse var i 1995. Projektteamet anså i lang tid ikke høj tilgængelighed for et spørgsmål, der skulle tackles fra systemets side. Derfor blev replikationsteknologien til at skabe datakopier først indbygget i version 8.2 i 2006, men den var filbaseret (log shipping). I 2010 kom der stream-replikation i version 9.0, og denne er grundlaget for at skabe en række forskellige klynger. Dette overrasker faktisk folk, der kender til PostgreSQL efter Enterprise SQL eller moderne NoSQL — en standardløsning fra fællesskabet er blot et par master-replica med synkron eller asynkron replikation. Her udføres master-switching manuelt, og spørgsmålet om klient-switching foreslås også at løses på egen hånd.
Hvordan vi besluttede os for at lave en pålidelig PostgreSQL, og hvad vi valgte til dette
Ikke desto mindre ville PostgreSQL ikke have opnået sin popularitet, hvis det ikke var for det enorme antal projekter og værktøjer, der hjælper med at opbygge en failover-løsning, der ikke kræver konstant opmærksomhed. I skyen (MCS) har der været tilgængelige enkeltstående PostgreSQL-servere og par med asynkron replikering siden starten af DBaaS.
Naturligvis ønskede vi at gøre livet lettere for alle og gøre en sådan installation af PostgreSQL tilgængelig, som kunne fungere som grundlag for højtilgængelige tjenester, som ikke krævede konstant overvågning, så man ikke skulle vågne op om natten for at udføre en failover. I dette segment findes der både gamle, velafprøvede løsninger samt en generation af nye værktøjer, der bruger de nyeste innovationer.
I dag handler spørgsmålet om høj tilgængelighed ikke om redundans (det er givet), men om konsensus — algoritmen til ledervalg (Leader election). Oftest opstår store nedbrud ikke på grund af mangel på servere, men på grund af problemer med konsensus: der blev ikke valgt en ny leder, der opstod to ledere i forskellige datacentre osv. Et eksempel er nedbruddet i Githubs MySQL-klynge — de skrev .
Den matematiske baggrund i dette spørgsmål er meget alvorlig. På den ene side er der , som lægger teoretiske begrænsninger på mulighederne for at bygg højtilgængeligheds-løsninger, og på den anden side er der matematisk beviste algoritmer til bestemmelse af konsensus, som og . På denne baggrund findes der ret populære DCS (decentraliserede konsensus-systemer) — Zookeeper, etcd, Consul. Derfor, hvis beslutningssystemet arbejder på en eller anden algoritme, der er skrevet selv, bør man være yderst forsigtig med det. Efter at have analyseret et stort antal systemer har vi valgt Patroni — et open source-system, der primært udvikles af Zalando.
Som et lyrisk sidespring vil jeg nævne, at vi også overvejede multi-master løsninger, altså klynger, der kan skaleres horisontalt til skrivning. Men af to hovedårsager besluttede vi ikke at lave en sådan klynge. For det første har sådanne løsninger en høj kompleksitet og dermed flere sårbare punkter. Det vil være svært at lave en stabil løsning for alle tilfælde. For det andet slutter PostgreSQL med at være ren (native); nogle funktioner vil ikke være tilgængelige, og nogle applikationer kan opleve skjulte fejl under drift.
Patroni
Så hvordan fungerer Patroni? Udviklerne opfandt ikke hjulet igen, men valgte at bruge et af de afprøvede DCS-løsninger som grundlag. Alle spørgsmål vedrørende synkronisering af konfigurationer, valg af leder og quorum overlades til det. Vi valgte at bruge etcd til dette.
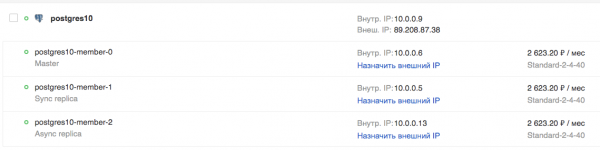
Dernæst sørger Patroni for korrekt anvendelse af alle indstillinger på PostgreSQL og konfigurationer til replikering samt udførelse af kommandoer til switchover og failover (dvs. både planlagt og uplanlagt skift af master). Specifikt i MCS-cloud kan der oprettes en klynge bestående af en master, en synkron replik og en eller flere asynkrone replikker. Tilstedeværelsen af en synkron replik sikrer dataintegritet på mindst 2 servere, og netop denne replik vil være den primære "kandidat til master".
Da etcd implementeres på de samme servere, anbefales det at have 3 eller 5 servere for at opnå den optimale quorumværdi. En sådan klynge kan skaleres horisontalt til læsning (en skala på skrivning har jeg nævnt ovenfor). Det skal bemærkes, at asynkrone replikker har en tendens til at være forsinkede, især ved høje belastninger.
Brugen af sådanne replikker til læsning (hot standby) er berettiget til rapporterings- eller analyseopgaver og aflaster master-serveren.
Hvis du ønsker at oprette en sådan klynge selv, skal du:
- forberede 3 eller flere servere, konfigurere IP-adressering og firewallregler imellem dem;
- installere pakker til tjenesterne etcd, Patroni, PostgreSQL;
- konfigurere etcd klyngen;
- konfigurere patroni-tjenesten til at arbejde med PostgreSQL.
Det vil sige, at det samlede antal konfigurationsfiler, der skal sammensættes korrekt, er omtrent ti, og der må ikke være fejl. Det vil bestemt være nyttigt at bruge et configuration management tool, såsom Ansible. Derudover mangler der stadig en højtilgængelig TCP-load balancer. At lave en sådan er et særskilt arbejde.
For dem, der har brug for et færdigt cluster, men ikke ønsker at rode med det hele, har vi gjort livet lettere ved at lave et færdigt cluster på Patroni i vores sky, som kan testet gratis. Udover selve clustret har vi lavet:
- TCP-load balancer; den angiver altid den aktuelle master, synkrone eller asynkrone replikaer, afhængigt af de forskellige porte;
- API til at skifte den aktive master på Patroni.
De kan tilsluttes både gennem MCS-skyen API og webkonsollen.
Demo
For at teste mulighederne for PostgreSQL-clusteret i MCS-skyen, lad os se, hvordan en live-applikation vil opføre sig under problemer med databasen.
Her præsenteres koden til en applikation, der vil logge kunstige hændelser og rapportere om dem på skærmen. I tilfælde af fejl vil den rapportere dette og fortsætte sit arbejde i en cyklus, indtil vi stopper den med Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Connection opened to", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Logged a value, overall count: {}".format(record[0]))
    except Exception as error:
        print ("Error while connecting to PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Connection closed")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Caught error:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("exit")
Applikationen kræver PostgreSQL for at fungere. Lad os oprette et cluster i MCS-skyen ved hjælp af API. I en almindelig terminal, hvor OS_TOKEN-variablen indeholder tokenet til adgang til API'et (kan opnås med kommandoen openstack token issue), indtaster vi følgende kommandoer:
Vi opretter clustret:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
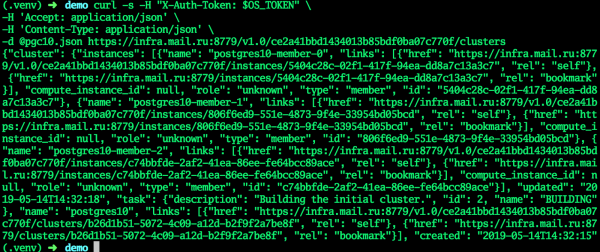
Når klyngen skifter til status ACTIVE, vil alle felter få aktuelle værdier — klyngen er klar.
I GUI:
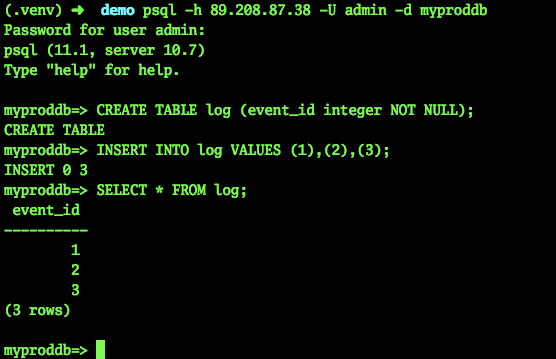
Lad os prøve at forbinde og oprette en tabel:
psql -h 89.208.87.38 -U admin -d myproddb
Password for user admin:
psql (11.1, server 10.7)
Type "help" for help.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rows)

myproddb=>
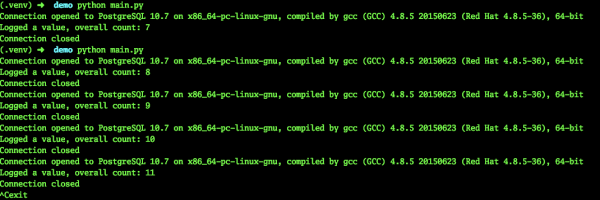
I applikationen angiver vi de aktuelle indstillinger for forbindelse til PostgreSQL. Vi angiver adresse til TCP-loadbalancer, så behovet for manuel skift til master-adressen bortfalder. Lad os starte den. Som vi kan se, bliver begivenhederne registreret i databasen.
Planlagt skift af master
Lad os nu teste vores applikations funktionalitet under det planlagte skift af master:
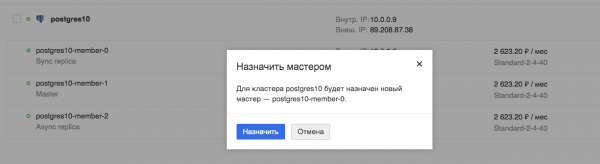
Vi overvåger applikationen. Vi kan se, at applikationens funktionalitet faktisk bliver afbrudt, men det varer kun et par sekunder, i dette specifikke tilfælde maksimalt 9.
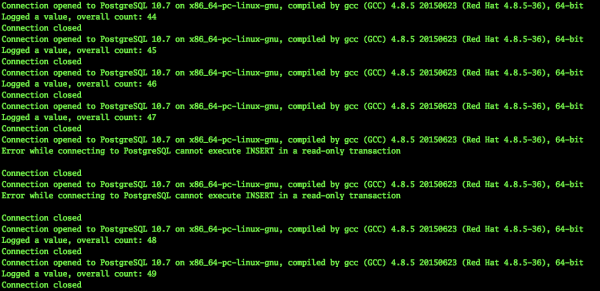
Nedbrud af maskine
Lad os nu prøve at simulere nedbrud af den virtuelle maskine, som aktuelt er master. Man kunne blot slukke den virtuelle maskine via Horizon-grænsefladen, men det vil være en normal shutdown. Et sådant skift vil blive håndteret af alle tjenester, herunder Patroni.
Vi har dog brug for et uventet nedbrud. Derfor bad jeg vores administratorer om at slukke for den virtuelle maskine — den aktuelle master — på en usædvanlig måde til testformål.
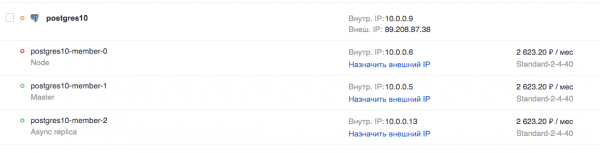
I mellemtiden fortsatte vores applikation med at køre. Naturligvis kan et sådant nødskift af masteren ikke ske ubemærket.
2019-03-29 10:45:56.071234
Forbindelse åbnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilering af gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Registreret en værdi, samlet antal: 453
Forbindelse lukket
2019-03-29 10:45:59.205463
Forbindelse åbnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilering af gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Registreret en værdi, samlet antal: 454

Forbindelse lukket
2019-03-29 10:46:02.661440
Fejl ved forbindelse til PostgreSQL-server; forbindelsen blev lukket uventet
        Dette betyder sandsynligvis, at serveren blev afsluttet unormalt
        før eller mens den behandlede anmodningen.

Oprettet fejl:
 lokal variabel 'connection' refereret før tildeling
……………………………………………………….. - her er et antal fejl
2019-03-29 10:46:30.930445
Fejl ved forbindelse til PostgreSQL-server; forbindelsen blev lukket uventet
        Dette betyder sandsynligvis, at serveren blev afsluttet unormalt
        før eller mens den behandlede anmodningen.

Oprettet fejl:
 lokal variabel 'connection' refereret før tildeling
2019-03-29 10:46:31.954399
Forbindelse åbnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilering af gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Registreret en værdi, samlet antal: 455
Forbindelse lukket
2019-03-29 10:46:35.409800
Forbindelse åbnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilering af gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Registreret en værdi, samlet antal: 456
Forbindelse lukket
^Cexit
Som det fremgår, kunne applikationen fortsætte sit arbejde på mindre end 30 sekunder. Ja, et antal brugere af tjenesten vil muligvis bemærke problemerne. Men dette er en alvorlig serverfejl, som ikke sker så ofte. Desuden ville en person (administrator) næppe have kunne reagere så hurtigt, medmindre han sad klar ved konsollen med et skiftende script.
Output
Jeg mener, at sådan en klynge giver enorme fordele for administratorer. I realiteten vil alvorlige fejl og nedbrud af database-servere ikke være synlige for applikationen og dermed for brugeren. Man skal ikke haste med at reparere noget eller skifte til midlertidige konfigurationer, servere osv. Og hvis en sådan løsning anvendes i form af en færdig tjeneste i skyen, vil man ikke skulle bruge tid på at forberede den. Man kan i stedet beskæftige sig med noget mere interessant.
Kilde: habr.com
