

Mit navn er Pavel Parhomenko, jeg er ML-udvikler. I denne artikel vil jeg gerne fortælle om, hvordan Yandex.Zen-service fungerer, og dele de tekniske forbedringer, hvis implementering har gjort det muligt at øge kvaliteten af anbefalingerne. I dette indlæg vil du lære, hvordan man på bare få millisekunder finder de mest relevante dokumenter blandt millioner af dokumenter; hvordan man udfører en kontinuerlig decomposition af en stor matrix (bestående af millioner af kolonner og titusinder af millioner rækker), så nye dokumenter får deres vektor på under ti minutter; hvordan man genbruger matrixdekompositionen bruger-artikel for at opnå en god vektorpræsentation for video.
Vores anbefalingsdatabase indeholder millioner af dokumenter i forskellige formater: tekstartikler, der er oprettet på vores platform og hentet fra eksterne websteder, videoer, fortællinger og korte indlæg. Udviklingen af en sådan service er forbundet med et stort antal tekniske udfordringer. Her er nogle af dem:
- Opdele computingopgaver: alle tunge operationer skal udføres offline, mens hurtige anvendelser af modeller kun skal finde sted i realtid, så vi kan svare inden for 100-200 ms.
- Hurtigt tage højde for brugerens handlinger. For dette er det nødvendigt, at alle begivenheder straks leveres til anbefaleren og påvirker resultaterne af modellerne.
- Gøre nyhedsfeedet sådan, at det hurtigt tilpasser sig nye brugeres adfærd. Nyligt ankomne til systemet skal føle, at deres feedback påvirker anbefalingerne.
- Hurtigt forstå, hvem man skal anbefale en ny artikel til.
- Reagere hurtigt på den konstante strøm af nyt indhold. Ti tusinde artikler offentliggøres hver dag, og mange af dem har en begrænset levetid (lad os sige, nyheder). Dette adskiller dem fra film, musik og andet indhold, der lever længe og er dyrt at producere.
- Overføre viden fra ét domæne til et andet. Hvis der i anbefalingssystemet er trænede modeller for tekstartikler, og vi tilføjer video, kan vi genbruge eksisterende modeller, så indhold af den nye type rangeres bedre.
Jeg vil fortælle, hvordan vi løste disse opgaver.
Udvælgelse af kandidater
Hvordan kan man på få millisekunder reducere et stort antal dokumenter tusindfold, uden væsentligt at forringe rangeringen?
Lad os antage, at vi har trænet mange ML-modeller, genereret funktioner baseret på dem, og trænet endnu en model, der rangerer dokumenter for brugeren. Alt ville være godt, men man kan ikke bare beregne alle funktionerne for alle dokumenter i realtid, hvis der er millioner af disse dokumenter, og anbefalinger skal laves på 100-200 ms. Opgaven er at vælge et underområde fra millioner, som vil blive rangeret for brugeren. Dette trin kaldes normalt kandidatudvælgelse. Der stilles flere krav til det. For det første skal udvælgelsen ske meget hurtigt, så der er mest muligt tid til selve rangeringen. For det andet, ved kraftigt at reducere antallet af dokumenter til rangering, skal vi maksimalt bevare de relevante dokumenter for brugeren.
Vores princip for kandidatudvælgelse har udviklet sig over tid, og i øjeblikket er vi nået til et flertrins-system:
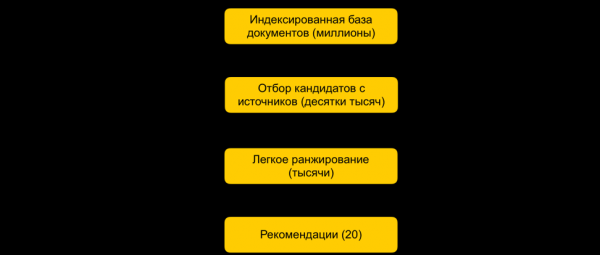
Først opdeles alle dokumenter i grupper, og fra hver gruppe vælges de mest populære dokumenter. Grupperne kan være websteder, emner eller klynger. For hver bruger vælges de grupper, der passer bedst til deres historie, og herfra vælges de bedste dokumenter. Vi bruger også en kNN-indeks til at finde de dokumenter, der mest ligner brugeren, i realtid. Der findes flere metoder til at opbygge kNN-indeks, hos os fungerer den bedst (Hierarchical Navigable Small World graphs). Dette er en hierarkisk model, der gør det muligt at finde N nærmeste vektorer for brugeren fra en millionbase på få millisekunder. Forud for dette indekserer vi offline hele vores dokumentbase. Da søgning i indekset fungerer ret hurtigt, kan man ved at have flere kraftige embeddings lave flere indekser (én for hver embedding) og tilgå hver af dem i realtid.
Vi har titusindvis af dokumenter til hver bruger. Det er stadig mange at tælle alle egenskaber, så på dette tidspunkt anvender vi en let rangering - en forenklet model af tung rangering med færre egenskaber. Opgaven er at forudsige, hvilke dokumenter der vil være i toppen hos den tunge model. Dokumenter med den højeste forudsigelse vil blive brugt i den tunge model, dvs. på det sidste rangeringstrin. Denne tilgang gør det muligt at reducere mængden af dokumenter, der overvejes for brugeren, fra millioner til tusinder på blot nogle få millisekunder.
ALS-trin i runtime
Hvordan tager man højde for brugerens feedback straks efter et klik?
En vigtig faktor i anbefalinger er responstiden på brugerfeedback. Dette er især vigtigt for nye brugere: når en person først begynder at bruge anbefalingssystemet, får han en upersonlig strøm af forskellige tematiske dokumenter. Så snart han foretager sit første klik, skal dette straks tages i betragtning, og systemet skal tilpasse sig hans interesser. Hvis man beregner alle faktorer offline, vil hurtig respons fra systemet blive umulig på grund af forsinkelser. Derfor er det nødvendigt at behandle brugerens handlinger i realtid. Til disse formål bruger vi ALS-trinnet i runtime til at opbygge en vektorrepræsentation af brugeren.
Antag, at vi har en vektorrepræsentation for alle dokumenter. For eksempel kan vi offline opbygge indlejringer baseret på tekstindholdet i artiklen ved hjælp af ELMo, BERT eller andre maskinlæringsmodeller. Hvordan kan vi få brugerens vektorrepræsentation i det samme rum baseret på deres interaktion i systemet?
Den generelle metode til dannelse og nedbrydning af brugerdokumentmatrixenLad os sige, at vi har m brugere og n dokumenter. For nogle brugere kender vi deres forhold til nogle dokumenter. Så kan denne information repræsenteres i en matrix m x n: rækkerne svarer til brugerne, og kolonnerne svarer til dokumenterne. Da de fleste dokumenter aldrig er blevet set af en person, vil størstedelen af matrixens celler forblive tomme, mens andre vil være udfyldt. For hver hændelse (like, dislike, klik) i matrixt er der foreskrevet en bestemt værdi - men lad os overveje en forenklet model, hvor et like svarer til 1, og et dislike til -1.
Lad os opdele matrixen i to: P (m x d) og Q (d x n), hvor d er dimensionen af den vektormæssige repræsentation (normalt et lille tal). Så vil hver objekt have en d-dimensionel vektor (brugerens række i matrixen P, dokumentets kolonne i matrixen Q). Disse vektorer vil være indlejringerne af de tilsvarende objekter. For at forudsige, om et dokument vil blive bestemt som værende godt af brugeren, kan vi blot multiplicere deres indlejringer.
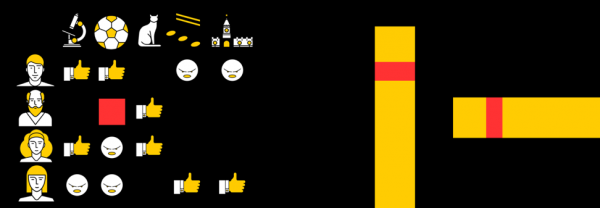
En mulig metode til matrixopdeling er ALS (Alternating Least Squares). Vi vil optimere den følgende tabfunktion:

Her er rui interaktionen mellem bruger u og dokument i, qi er dokument i's vektor, pu er bruger u's vektor.
Så den optimale vektor for brugeren (givet de faste dokumentvektorer) findes analytisk ved at løse den relevante lineære regression.
Dette kaldes "ALS-trinnet". Selve ALS-algoritmen består i, at vi skiftevis fastsætter en af matrixerne (brugere og artikler) og opdaterer den anden, og finder den optimale løsning.
Heldigvis er det en ret hurtig operation at finde brugerens vektorrepræsentation, som kan udføres ved runtime ved hjælp af vektorinstruktioner. Dette trick tillader os med det samme at tage højde for brugerens feedback i rangeringen. Den samme indlejring kan også bruges i kNN-indekset for at forbedre udvælgelsen af kandidater.
Fordelt kollaborativ filtrering
Hvordan laver man inkrementel distribueret matrixfaktorisering og hurtigt finder den vektormæssige repræsentation af nye artikler?
Indhold er ikke den eneste kilde til signaler for anbefalinger. En anden vigtig kilde er samarbejdsinformation. Gode indikatorer for rangering kan traditionelt opnås ved at nedbryde bruger-dokument-matricen. Men når vi forsøgte at udføre en sådan nedbrydning, stødte vi på problemer:
1. Vi har millioner af dokumenter og titusinder af millioner af brugere. Matricen kan ikke opbevares på én enkelt maskine, og nedbrydningen vil være meget langvarig.
2. Størstedelen af indholdet i systemet har en kort levetid: dokumenter er kun relevante i et par timer. Derfor er det nødvendigt at opbygge deres vektoriske repræsentation så hurtigt som muligt.
3. Hvis man laver nedbrydningen lige efter dokumentets offentliggørelse, vil det ikke nå at blive vurderet af et tilstrækkeligt antal brugere. Derfor vil dens vektoriske repræsentation højst sandsynligt ikke være særlig god.
4. Hvis en bruger har givet et like eller dislike, vil vi ikke kunne tage dette i betragtning i nedbrydningen med det samme.
For at løse de nævnte problemer har vi implementeret en distribueret nedbrydning af bruger-dokument-matricen med hyppige inkrementelle opdateringer. Hvordan fungerer det præcist?
Antag, at vi har et cluster af N maskiner (N tælles i hundreder), og vi ønsker at udføre en distribueret nedbrydning af matricen, som ikke kan opbevares på én maskine. Spørgsmålet er, hvordan vi udfører denne nedbrydning, så der på den ene side er tilstrækkeligt med data på hver maskine, og på den anden side at beregningerne forbliver uafhængige?
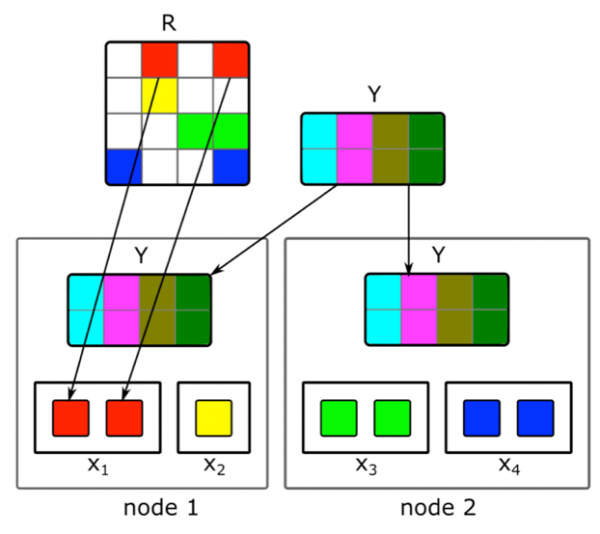
Vi vil bruge den beskrevne ALS-nedbrydningsalgoritme. Lad os se på, hvordan vi distribuerer én ALS-trin - de øvrige trin vil være lignende. Antag, at vi har den dokumentmatrix fastlagt, og vi ønsker at opbygge brugermatricen. For at gøre dette opdelar vi den i N dele efter rækkerne, hver del vil indeholde omtrent det samme antal rækker. Vi sender ikke-tomme celler af de tilsvarende rækker til hver maskine samt dokumentembedding matricen (i sin helhed). Da dens størrelse ikke er særlig stor, og bruger-dokument matricen normalt er meget sparsom, vil disse data kunne opbevares på en almindelig maskine.
Denne metode kan gentages i flere epoker indtil modelkonvergens, ved skiftevis at ændre den faste matrix. Men selv da kan matrixfaktoriseringen tage flere timer. Og det løser ikke problemet med, at vi hurtigt skal generere embedding af nye dokumenter og opdatere embeddingene af de dokumenter, som havde lidt information under modeltræningen.
Vi blev hjulpet af implementeringen af en hurtig inkrementel opdatering af modellen. Lad os antage, at vi har en nuværende trænet model. Siden dens træning er der kommet nye artikler, som vores brugere har interageret med, samt artikler som under træningen havde lidt interaktioner. For hurtigt at generere embedding af sådanne artikler bruger vi brugerembeddingene, der blev opnået under den første store træning af modellen, og udfører et ALS-trin for at beregne dokumentmatrixen med en fast bruger-matrix. Dette gør det muligt at få embedding ret hurtigt - inden for få minutter efter offentliggørelsen af dokumentet - og ofte opdatere embedding af friske dokumenter.
For at anbefalingerne straks tager højde for menneskelige handlinger, bruger vi ikke bruger-embedding opnået offline i runtime. I stedet udfører vi et ALS-trin og får den aktuelle brugervektor.
Overførsel til et andet domæne
Hvordan kan man bruge feedback fra brugere af tekstartikler til at opbygge en vektorisk repræsentation af video?
Oprindeligt anbefalede vi kun tekstartikler, så mange af vores algoritmer er skræddersyet til denne type indhold. Men ved tilsætning af indhold af en anden type stødte vi på behovet for at tilpasse modellerne. Hvordan løste vi denne opgave i forbindelse med video? En mulighed er at gentræne alle modeller fra bunden. Men det tager tid, desuden er nogle af algoritmerne krævende, hvad angår størrelsen af træningsdatasættet, som endnu ikke er tilstrækkeligt for det nye indholds type i de første øjeblikke af dets liv på tjenesten.
Vi tog en anden tilgang og genbrugt tekstmodeller til video. I skabelsen af vektorrepræsentationer for video hjalp den samme ALS-trick os. Vi tog brugerens vektorrepræsentation baseret på tekstartikler og udførte et ALS-træk ved at bruge videoafspilningsdata. Sådan fik vi nemt vektorrepræsentationen for video. Og i runtime beregner vi blot nærheden mellem brugerens vektor, der er opnået på baggrund af tekstartikler, og videoens vektor.
Konklusion
Udviklingen af kernen i det realtidsanbefalingssystem er forbundet med mange opgaver. Det er nødvendigt hurtigt at behandle data og anvende ML-metoder for effektivt at udnytte disse data; opbygge komplekse distribuerede systemer, der kan behandle brugerens signaler og nye indholdsenheder på kort tid; og mange andre opgaver.
I det nuværende system, hvis enhed jeg har beskrevet, vokser kvaliteten af anbefalinger for brugeren i takt med deres aktivitet og opholdstid i tjenesten. Men naturligvis ligger den største udfordring her: systemet har svært ved straks at forstå en persons interesser, som har haft lidt interaktion med indholdet. Forbedring af anbefalinger til nye brugere er vores nøgleopgave. Vi vil fortsætte med at optimere algoritmerne, så relevant indhold hurtigere når brugerens feed, mens irrelevant indhold ikke vises.
Kilde: habr.com
