

Mit navn er Anton Baderin. Jeg arbejder i Center for Høj Teknologi og beskæftiger mig med systemadministration. For en måned siden afsluttede vores virksomhed vores konference, hvor vi delte vores erfaringer med IT-samfundet i vores by. Jeg talte om overvågning af webapplikationer. Materialet var tiltænkt junior og middle niveau, der ikke har opbygget denne proces fra bunden.
Grundstenen i enhver overvågningssystem er løsningen af forretningsproblemer. Overvågning for overvågningens skyld er ikke interessant for nogen. Hvad ønsker virksomheden? At alt fungerer hurtigt og uden fejl. Virksomheden ønsker proaktivitet, så vi selv opdager problemer i serviceydelsen og hurtigst muligt løser dem. Det er i grunden de opgaver, jeg har arbejdet med det sidste år på et af vores kunders projekter.
Om projektet
Projektet er et af de største loyalitetsprogrammer i landet. Vi hjælper detailhandlere med at øge salgsfrekvensen ved hjælp af diverse marketingværktøjer som bonuskort. Samlet set er projektet sammensat af 14 applikationer, der kører på ti servere.
Ved gennemførelsen af interviews har jeg flere gange bemærket, at administratorer ikke altid griber overvågningen af webapplikationer korrekt an: mange stopper stadig ved operationelle systemmetrikker og overvåger sjældent serviceydelser.
I mit tilfælde byggede kundens overvågningssystem tidligere på Icinga. Det løste ikke de ovennævnte opgaver. Ofte informerede kunden os selv om problemer, og vi manglede ofte bare data til at finde årsagen.
Desuden var der en klar forståelse af det meningsløse i dens fremtidige udvikling. Jeg tror, dem der kender Icinga, vil forstå mig. Så vi besluttede at redesigne overvågningssystemet for webapplikationer i projektet helt.
Prometheus
Vi valgte Prometheus baseret på tre hovedfaktorer:
- Et stort antal tilgængelige metrikker. I vores tilfælde er der 60.000. Selvfølgelig skal det nævnes, at størstedelen af dem ikke bruges (sandsynligvis omkring 95%). På den anden side er de alle relativt billige. For os er det en anden ekstrem i forhold til det tidligere anvendte Icinga. I den var det en særlig udfordring at tilføje metrikker: de eksisterende var dyre at erhverve (man skal bare se på koden til enhver plugin). Ethvert plugin var et script skrevet i Bash eller Python, hvis kørsel ikke er billig med hensyn til ressourcer.
- Dette system forbruger relativt få ressourcer. Alle vores metrikker kræver 600 MB RAM, 15% af en kerne og et par dusin IOPS. Selvfølgelig skal vi køre metric eksportører, men de er alle skrevet i Go og er heller ikke sultne. Jeg tror ikke, det er et problem i moderne forhold.
- Giver mulighed for overgang til Kubernetes. I betragtning af kundens planer er valget indlysende.
ELK
Tidligere indsamlede og behandlede vi ikke logs. Ulemperne er klare for alle. Vi valgte ELK, da vi allerede havde erfaring med dette system. Vi opbevarer kun applikationslogs der. De vigtigste kriterier var fuldtekst-søgning og hastighed.
Clickhouse
Oprindeligt faldt valget på InfluxDB. Vi var klar over nødvendigheden af at indsamle logs fra Nginx, statistik fra pg_stat_statements og opbevaring af historiske data fra Prometheus. Influx var ikke tilfredsstillende, da det periodisk begyndte at forbruge store mængder hukommelse og faldt. Desuden ønskede vi at gruppere forespørgsler efter remote_addr, men gruppéringen i denne DB var kun baseret på tags. Tags er dyre (hukommelse), og deres antal er begrænset.
Vi begyndte vores søgning forfra. Vi havde brug for et analysemiljø med et minimalt ressourceforbrug, helst med data komprimering på disken.
Clickhouse opfylder alle disse krav, og vi har aldrig fortrudt vores valg. Vi skriver ikke store mængder data til det (antallet af indsatser er kun omkring fem tusinde pr. minut).
NewRelic
NewRelic har historisk været med os, da det var kundens valg. Vi bruger det som APM.
Zabbix
Vi bruger Zabbix udelukkende til at overvåge Black Box af forskellige API'er.
Bestemmelse af tilgang til overvågning
Vi ønskede at dekomponere opgaven og dermed systematisere tilgangen til overvågning.
Jeg har opdelt vores system i følgende niveauer:
- "hardware" og VMS;
- operativsystem;
- systemtjenester, softwarestak;
- applikation;
- forretningslogik.
Fordelene ved denne tilgang er:
- Vi ved, hvem der er ansvarlig for driften af hvert niveau, og baseret på det kan vi sende alarmer;
- Vi kan bruge strukturen til at undertrykke alarmer - det ville være underligt at sende en alarm om en utilgængelig database, når den virtuelle maskine som helhed er utilgængelig.
Da vores opgave er at identificere fejl i systemet, skal vi for hvert niveau fremhæve et sæt målinger, som det er vigtigt at holde øje med, når vi skriver alarmregler. Lad os nu se på niveauerne "VMS", "Operativsystem" og "Systemtjenester, softwarestak."
Virtuelle maskiner
Hosting tildeler os processor, disk, hukommelse og netværk. Og vi har haft problemer med de to første. Så målinger:
CPU stolen time - når du køber en virtuel maskine på Amazon (f.eks. t2.micro), skal du forstå, at du ikke får et helt kerne af processoren, men blot en kvote af dens tid. Og når du udtømmer det, vil de begynde at tage processorkraft fra dig.
Denne måling gør det muligt at overvåge sådanne situationer og træffe beslutninger. For eksempel, om det er nødvendigt at vælge en kraftigere plan eller adskille behandling af baggrundsopgaver og API-anmodninger. server.
IOPS + CPU iowait time - af en eller anden grund er mange cloud-hostingtjenester skyld i, at de ikke leverer tilstrækkelige IOPS. Desuden er en graf med lave IOPS ikke et argument for dem. Derfor bør man samle data om CPU iowait. Med dette par grafikker - lave IOPS og høj ind-data ventetid - kan man allerede begynde at tale med hostingen og løse problemet.
Operativsystem
Målinger fra operativsystemet:
- mængden af tilgængelig hukommelse i %;
- aktivitet af swap-brug: vmstat swapin, swapout;
- mængden af tilgængelige inode og ledig plads på filsystemet i %
- gennemsnitlig belastning;
- antal forbindelser i tilstand tw;
- fyldning af conntrack-tabellen;
- kvaliteten af netværksarbejde kan overvåges via værktøjet ss, med pakken iproute2 - få RTT-forbindelsesmålingen fra dens output og gruppere efter dest-port.
Også på niveauet for operativsystemet har vi en entitet som processer. Det er vigtigt at fremhæve et sæt processer i systemet, som spiller en vigtig rolle i dets drift. Hvis du f.eks. har flere pgpool, er det nødvendigt at indsamle oplysninger om hver af dem.
Sættet af målinger er følgende:
- CPU;
- Hukommelse — primært RAM;
- IO — gerne i IOPS;
- FileFd — åbne og grænseværdier;
- Betydelige sidefejl — således kan du forstå, hvilken proces der bytter.
Vi har hele overvågningen implementeret i Docker, og vi bruger Cadvisor til at samle metrics-data. På de andre maskiner anvender vi process-exporter.
Systemtjenester, softwarestack
Hver applikation har sine specifikationer, og det er svært at udpege et bestemt sæt målinger.
Et universelt sæt er:
- forespørgselsrate;
- antal fejl;
- latens;
- mætning.
De mest markante eksempler på denne niveau af overvågning hos os er — Nginx og PostgreSQL.
Den mest belastede tjeneste i vores system er databasen. Tidligere oplevede vi ofte problemer med at finde ud af, hvad databasen beskæftigede sig med.
Vi så høj belastning på diskene, men slow logs viste ikke meget. Dette problem løste vi med pg_stat_statements, et view, hvor statiske data om forespørgsler samles.
Det er alt, hvad en administrator har brug for.
Vi bygger grafer over aktive læse- og skriveforespørgsler:
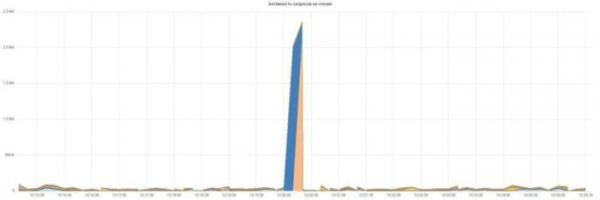
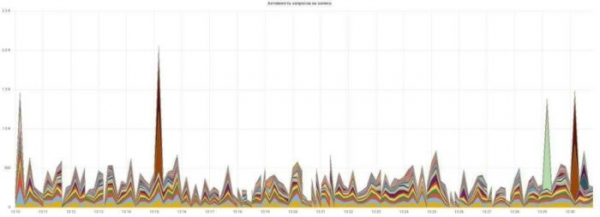
Alt er simpelt og klart; hver forespørgsel har sin egen farve.
Et ikke mindre markant eksempel er Nginx-logs. Det er ikke overraskende, at få parser dem eller nævner dem på listen over nødvendigheder. Standardformatet er ikke særlig informativt og skal udvides.
Personligt har jeg tilføjet request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Vi bygger grafer over svartider og antal fejl:
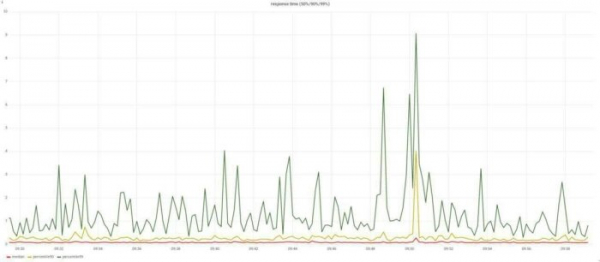
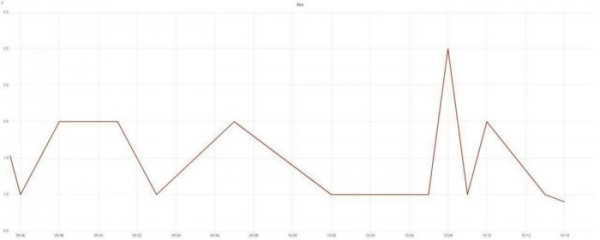
Vi bygger grafer over svartider og antal fejl. Kan du huske? Jeg talte om forretningsopgaver? For hurtigt og uden fejl? Vi har allerede besvaret disse spørgsmål med to grafer. Og ud fra dem kan vi allerede kontakte de on-duty administratorer.
Men der er stadig et problem — at sikre hurtig afhjælpning af årsagen til hændelsen.
Hændelseshåndtering
Hele processen fra identifikation til løsning kan opdeles i flere trin:
- identifikation af problemet;
- underretning af den on-duty administrator;
- reaktion på hændelsen;
- afhjælpning af årsager.
Det er vigtigt, at vi gør dette så hurtigt som muligt. Og hvis vi ikke kan spare tid i faserne af problemet og underretningen — det vil tage to minutter, uanset hvad, så er de efterfølgende faser et stort område for forbedringer.
Lad os bare forestille os, at telefonen ringer hos vagtmanden. Hvad vil han gøre? Søge svar på spørgsmålene — hvad er gået galt, hvor er det sket, hvordan skal man reagere? Sådan besvarer vi disse spørgsmål:
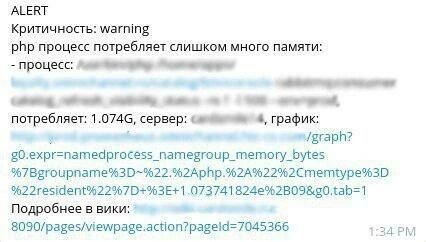
Vi inkluderer blot al denne information i teksten til meddelelsen og giver et link til en side på wikis, som beskriver, hvordan man reagerer på dette problem, hvordan man løser det og eskalerer det.
Jeg har stadig ikke sagt noget om applikationsniveauet og forretningslogikken. Desværre er der i vores applikationer endnu ikke implementeret en metrics indsamling. Den eneste kilde til overhovedet nogen information fra disse niveauer er logs.
Et par punkter.
For det første skal du skrive strukturerede logs. Undgå at inkludere konteksten i tekstbeskeden. Det gør det sværere at gruppere og analysere dem. Logstash kræver meget tid for at normalisere alt dette.
For det andet skal du korrekt bruge severity-niveauer. Hver sprog har sin egen standard. Personligt skelner jeg mellem fire niveauer:
- ingen fejl;
- fejl fra klientens side;
- fejl fra vores side, vi har ikke tab, ingen risici;
- fejl fra vores side, vi taber penge.
Sammenfattende. Man bør stræbe efter at opbygge overvågning ud fra forretningslogikken. Man skal forsøge at overvåge selve applikationen og operere med metrics som antal salg, antal nye brugerregistreringer, antal aktive brugere lige nu og så videre.
Hvis hele din forretning er én knap i browseren, er det nødvendigt at overvåge, om den bliver trykket, om den fungerer korrekt. Alt andet er uvigtigt.
Hvis du ikke har dette, kan du forsøge at indhente det i applikationslogs, Nginx-logs og så videre, som vi har gjort. Du skal være så tæt på applikationen som muligt.
Metrics fra operativsystemet er selvfølgelig vigtige, men de interesserer ikke forretningen, vi får ikke betalt for dem.
Kilde: habr.com
